
Oracle 分析函数的使用
Oracle 分析函数的使用Oracle 分析函数使用介绍分析函数是oracle816引入的一个全新的概念,为我们分析数据提供了一种简单高效的处理方式.在分析函数出现以前,我们必须使用自联查询,子查询或者内联视图,甚至复杂的存储过程实现的语句,现在只要一条简单的sql语句就可以实现了,而且在执行效率方面也有相当大的提高.下面我将针对分析函数做一些具体的说明.今天我主要给大家介绍一下以下几个函数的使用方法1. 自动汇总函数rollup,cube,2. rank 函数, rank,dense_rank,row_number3. lag,lead函数4. sum,avg,的移动增加,移动平均数5. ratio_to_report报表处理函数6. first,last取基数的分析函数基础数据Code: [Copy to clipboard]06:34:23 SQL> select * from t;BILL_MONTH AREA_CODE NET_TYPE LOCAL_FARE--------------- ---------- ---------- --------------200405 5761 G 7393344.04200405 5761 J 5667089.85200405 5762 G 6315075.96200405 5762 J 6328716.15200405 5763 G 8861742.59200405 5763 J 7788036.32200405 5764 G 6028670.45200405 5764 J 6459121.49200405 5765 G 13156065.77200405 5765 J 11901671.70200406 5761 G 7614587.96200406 5761 J 5704343.05200406 5762 G 6556992.60200406 5762 J 6238068.05200406 5763 G 9130055.46200406 5763 J 7990460.25200406 5764 G 6387706.01200406 5764 J 6907481.66200406 5765 G 13562968.81200406 5765 J 12495492.50200407 5761 G 7987050.65200407 5761 J 5723215.28200407 5762 G 6833096.68200407 5762 J 6391201.44200407 5763 G 9410815.91200407 5763 J 8076677.41200407 5764 G 6456433.23200407 5764 J 6987660.53200407 5765 G 14000101.20200407 5765 J 12301780.20200408 5761 G 8085170.84200408 5761 J 6050611.37200408 5762 G 6854584.22200408 5762 J 6521884.50200408 5763 G 9468707.65200408 5763 J 8460049.43200408 5764 G 6587559.23BILL_MONTH AREA_CODE NET_TYPE LOCAL_FARE --------------- ---------- ---------- --------------200408 5764 J 7342135.86200408 5765 G 14450586.63200408 5765 J 12680052.3840 rows selected.Elapsed: 00:00:00.001. 使用rollup函数的介绍Quote:下面是直接使用普通sql语句求出各地区的汇总数据的例子06:41:36 SQL> set autot on06:43:36 SQL> select area_code,sum(local_fare) local_fare06:43:50 2 from t06:43:51 3 group by area_code06:43:57 4 union all06:44:00 5 select '合计' area_code,sum(local_fare) local_fare06:44:06 6 from t06:44:08 7 /AREA_CODE LOCAL_FARE---------- --------------5761 54225413.045762 52039619.605763 69186545.025764 53156768.465765 104548719.19合计 333157065.316 rows selected.Elapsed: 00:00:00.03Execution Plan----------------------------------------------------------0 SELECT STATEMENT Optimizer=ALL_ROWS (Cost=7 Card=1310 Bytes=24884)1 0 UNION-ALL2 1 SORT (GROUP BY) (Cost=5 Card=1309 Bytes=24871)3 2 TABLE ACCESS (FULL) OF 'T' (Cost=2 Card=1309Bytes=24871)4 1 SORT (AGGREGATE)5 4 TABLE ACCESS (FULL) OF 'T' (Cost=2 Card=1309Bytes=17017)Statistics----------------------------------------------------------0 recursive calls0 db block gets6 consistent gets0 physical reads0 redo size561 bytes sent via SQL*Net to client503 bytes received via SQL*Net from client2 SQL*Net roundtrips to/from client1 sorts (memory)0 sorts (disk)6 rows processed下面是使用分析函数rollup得出的汇总数据的例子06:44:09 SQL> select nvl(area_code,'合计') area_code,sum(local_fare) local_fare06:45:26 2 from t06:45:30 3 group by rollup(nvl(area_code,'合计'))06:45:50 4 /AREA_CODE LOCAL_FARE---------- --------------5761 54225413.045762 52039619.605763 69186545.025764 53156768.465765 104548719.19333157065.316 rows selected.Elapsed: 00:00:00.00Execution Plan----------------------------------------------------------0 SELECT STATEMENT Optimizer=ALL_ROWS (Cost=5 Card=1309Bytes=24871)1 0 SORT (GROUP BY ROLLUP) (Cost=5 Card=1309 Bytes=24871)2 1 TABLE ACCESS (FULL) OF 'T' (Cost=2 Card=1309Bytes=24871)Statistics----------------------------------------------------------0 recursive calls0 db block gets4 consistent gets0 physical reads0 redo size557 bytes sent via SQL*Net to client503 bytes received via SQL*Net from client2 SQL*Net roundtrips to/from client1 sorts (memory)0 sorts (disk)6 rows processed从上面的例子我们不难看出使用rollup函数,系统的sql语句更加简单,耗用的资源更少,从6个consistent gets降到4个consistent gets,如果基表很大的话,结果就可想而知了.1. 使用cube函数的介绍Quote:为了介绍cube函数我们再来看看另外一个使用rollup的例子06:53:00 SQL> select area_code,bill_month,sum(local_fare) local_fare06:53:37 2 from t06:53:38 3 group by rollup(area_code,bill_month)06:53:49 4 /---------- --------------- --------------5761 200405 13060433.895761 200406 13318931.015761 200407 13710265.935761 200408 14135782.215761 54225413.045762 200405 12643792.115762 200406 12795060.655762 200407 13224298.125762 200408 13376468.725762 52039619.605763 200405 16649778.915763 200406 17120515.715763 200407 17487493.325763 200408 17928757.085763 69186545.025764 200405 12487791.945764 200406 13295187.675764 200407 13444093.765764 200408 13929695.095764 53156768.465765 200405 25057737.475765 200406 26058461.315765 200407 26301881.405765 200408 27130639.015765 104548719.19333157065.3126 rows selected.Elapsed: 00:00:00.00系统只是根据rollup的第一个参数area_code对结果集的数据做了汇总处理,而没有对bill_month做汇总分析处理,cube函数就是为了这个而设计的.下面,让我们看看使用cube函数的结果06:58:02 SQL> select area_code,bill_month,sum(local_fare) local_fare 06:58:30 2 from t06:58:32 3 group by cube(area_code,bill_month)06:58:42 4 order by area_code,bill_month nulls last06:58:57 5 /---------- --------------- --------------5761 200405 13060.435761 200406 13318.935761 200407 13710.275761 200408 14135.785761 54225.415762 200405 12643.795762 200406 12795.065762 200407 13224.305762 200408 13376.475762 52039.625763 200405 16649.785763 200406 17120.525763 200407 17487.495763 200408 17928.765763 69186.545764 200405 12487.795764 200406 13295.195764 200407 13444.095764 200408 13929.695764 53156.775765 200405 25057.745765 200406 26058.465765 200407 26301.885765 200408 27130.645765 104548.72200405 79899.53200406 82588.15200407 84168.03200408 86501.34333157.0530 rows selected.Elapsed: 00:00:00.01可以看到,在cube函数的输出结果比使用rollup多出了几行统计数据.这就是cube函数根据bill_month做的汇总统计结果1 rollup 和cube函数的再深入Quote:从上面的结果中我们很容易发现,每个统计数据所对应的行都会出现null,我们如何来区分到底是根据那个字段做的汇总呢,这时候,oracle的grouping函数就粉墨登场了.如果当前的汇总记录是利用该字段得出的,grouping函数就会返回1,否则返回01 select decode(grouping(area_code),1,'all area',to_char(area_code)) area_code,2 decode(grouping(bill_month),1,'all month',bill_month) bill_month,3 sum(local_fare) local_fare4 from t5 group by cube(area_code,bill_month)6* order by area_code,bill_month nulls last07:07:29 SQL> /AREA_CODE BILL_MONTH LOCAL_FARE---------- --------------- --------------5761 200405 13060.435761 200406 13318.935761 200407 13710.275761 200408 14135.785761 all month 54225.415762 200405 12643.795762 200406 12795.065762 200407 13224.305762 200408 13376.475762 all month 52039.625763 200405 16649.785763 200406 17120.525763 200407 17487.495763 200408 17928.765763 all month 69186.545764 200405 12487.795764 200406 13295.195764 200407 13444.095764 200408 13929.695764 all month 53156.775765 200405 25057.745765 200406 26058.465765 200407 26301.885765 200408 27130.645765 all month 104548.72all area 200405 79899.53all area 200406 82588.15all area 200407 84168.03all area 200408 86501.34all area all month 333157.0530 rows selected.Elapsed: 00:00:00.0107:07:31 SQL>可以看到,所有的空值现在都根据grouping函数做出了很好的区分,这样利用rollup,cube和grouping函数,我们做数据统计的时候就可以轻松很多了.2. rank函数的介绍介绍完rollup和cube函数的使用,下面我们来看看rank系列函数的使用方法.问题2.我想查出这几个月份中各个地区的总话费的排名.Quote:为了将rank,dense_rank,row_number函数的差别显示出来,我们对已有的基础数据做一些修改,将5763的数据改成与5761的数据相同.1 update t t1 set local_fare = (2 select local_fare from t t23 where t1.bill_month = t2.bill_month4 and _type = _type5 and t2.area_code = '5761'6* ) where area_code = '5763'07:19:18 SQL> /8 rows updated.Elapsed: 00:00:00.01我们先使用rank函数来计算各个地区的话费排名.07:34:19 SQL> select area_code,sum(local_fare) local_fare,07:35:25 2 rank() over (order by sum(local_fare) desc) fare_rank07:35:44 3 from t07:35:45 4 group by area_codee07:35:50 507:35:52 SQL> select area_code,sum(local_fare) local_fare,07:36:02 2 rank() over (order by sum(local_fare) desc) fare_rank07:36:20 3 from t07:36:21 4 group by area_code07:36:25 5 /AREA_CODE LOCAL_FARE FARE_RANK---------- -------------- ----------5765 104548.72 15761 54225.41 25763 54225.41 25764 53156.77 45762 52039.62 5Elapsed: 00:00:00.01我们可以看到红色标注的地方出现了,跳位,排名3没有出现下面我们再看看dense_rank查询的结果.07:36:26 SQL> select area_code,sum(local_fare) local_fare,07:39:16 2 dense_rank() over (order by sum(local_fare) desc ) fare_rank 07:39:39 3 from t07:39:42 4 group by area_code07:39:46 5 /AREA_CODE LOCAL_FARE FARE_RANK---------- -------------- ----------5765 104548.72 15761 54225.41 25763 54225.41 25764 53156.77 3 这是这里出现了第三名5762 52039.62 4Elapsed: 00:00:00.00在这个例子中,出现了一个第三名,这就是rank和dense_rank的差别,rank如果出现两个相同的数据,那么后面的数据就会直接跳过这个排名,而dense_rank则不会,差别更大的是,row_number哪怕是两个数据完全相同,排名也会不一样,这个特性在我们想找出对应没个条件的唯一记录的时候又很大用处1 select area_code,sum(local_fare) local_fare,2 row_number() over (order by sum(local_fare) desc ) fare_rank3 from t4* group by area_code07:44:50 SQL> /AREA_CODE LOCAL_FARE FARE_RANK---------- -------------- ----------5765 104548.72 15761 54225.41 25763 54225.41 35764 53156.77 45762 52039.62 5在row_nubmer函数中,我们发现,哪怕sum(local_fare)完全相同,我们还是得到了不一样排名,我们可以利用这个特性剔除数据库中的重复记录.这个帖子中的几个例子是为了说明这三个函数的基本用法的. 下个帖子我们将详细介绍他们的一些用法.2. rank函数的介绍a. 取出数据库中最后入网的n个用户select user_id,tele_num,user_name,user_status,create_datefrom (select user_id,tele_num,user_name,user_status,create_date,rank() over (order by create_date desc) add_rankfrom user_info)where add_rank <= :n;b.根据object_name删除数据库中的重复记录create table t as select obj#,name from sys.obj$;再insert into t1 select * from t1 数次.delete from t1 where rowid in (select row_id from (select rowid row_id,row_number() over (partition by obj# order by rowid ) rn ) where rn <> 1);c. 取出各地区的话费收入在各个月份排名.SQL> select bill_month,area_code,sum(local_fare) local_fare,2 rank() over (partition by bill_month order by sum(local_fare) desc) area_rank3 from t4 group by bill_month,area_code5 /BILL_MONTH AREA_CODE LOCAL_FARE AREA_RANK--------------- --------------- -------------- ----------200405 5765 25057.74 1200405 5761 13060.43 2200405 5763 13060.43 2200405 5762 12643.79 4200405 5764 12487.79 5200406 5765 26058.46 1200406 5761 13318.93 2200406 5763 13318.93 2200406 5764 13295.19 4200406 5762 12795.06 5200407 5765 26301.88 1200407 5761 13710.27 2200407 5763 13710.27 2200407 5764 13444.09 4200407 5762 13224.30 5200408 5765 27130.64 1200408 5761 14135.78 2200408 5763 14135.78 2200408 5764 13929.69 4200408 5762 13376.47 520 rows selected.SQL>3. lag和lead函数介绍取出每个月的上个月和下个月的话费总额1 select area_code,bill_month, local_fare cur_local_fare,2 lag(local_fare,2,0) over (partition by area_code order by bill_month ) pre_local_fare,3 lag(local_fare,1,0) over (partition by area_code order by bill_month ) last_local_fare,4 lead(local_fare,1,0) over (partition by area_code order by bill_month )next_local_fare,5 lead(local_fare,2,0) over (partition by area_code order by bill_month )post_local_fare6 from (7 select area_code,bill_month,sum(local_fare) local_fare8 from t9 group by area_code,bill_month10* )SQL> /AREA_CODE BILL_MONTH CUR_LOCAL_FARE PRE_LOCAL_FARELAST_LOCAL_FARE NEXT_LOCAL_FARE POST_LOCAL_FARE--------- ---------- -------------- -------------- --------------- --------------- ---------------5761 200405 13060.433 0 0 13318.93 13710 .2655761 200406 13318.93 0 13060.433 13710.265 14 135.7815761 200407 13710.265 13060.433 13318.93 14135.7815761 200408 14135.781 13318.93 13710.265 05762 200405 12643.791 0 0 12795.06 13224 .2975762 200406 12795.06 0 12643.791 13224.297 13 376.4685762 200407 13224.297 12643.791 12795.06 13376.4685762 200408 13376.468 12795.06 13224.297 05763 200405 13060.433 0 0 13318.93 13710 .2655763 200406 13318.93 0 13060.433 13710.265 14 135.7815763 200407 13710.265 13060.433 13318.93 14135.7815763 200408 14135.781 13318.93 13710.265 05764 200405 12487.791 0 0 13295.187 1344 4.0935764 200406 13295.187 0 12487.791 13444.093 1 3929.6945764 200407 13444.093 12487.791 13295.187 13929.6945764 200408 13929.694 13295.187 13444.093 05765 200405 25057.736 0 0 26058.46 26301 .8815765 200406 26058.46 0 25057.736 26301.881 27 130.6385765 200407 26301.881 25057.736 26058.46 27130.6385765 200408 27130.638 26058.46 26301.881 020 rows selected.利用lag和lead函数,我们可以在同一行中显示前n行的数据,也可以显示后n行的数据.4. sum,avg,max,min移动计算数据介绍计算出各个连续3个月的通话费用的平均数1 select area_code,bill_month, local_fare,2 sum(local_fare)3 over ( partition by area_code4 order by to_number(bill_month)5 range between 1 preceding and 1 following ) "3month_sum",6 avg(local_fare)7 over ( partition by area_code8 order by to_number(bill_month)9 range between 1 preceding and 1 following ) "3month_avg",10 max(local_fare)11 over ( partition by area_code12 order by to_number(bill_month)13 range between 1 preceding and 1 following ) "3month_max",14 min(local_fare)15 over ( partition by area_code16 order by to_number(bill_month)17 range between 1 preceding and 1 following ) "3month_min"18 from (19 select area_code,bill_month,sum(local_fare) local_fare20 from t21 group by area_code,bill_month22* )SQL> /AREA_CODE BILL_MONTH LOCAL_FARE 3month_sum 3month_avg3month_max 3month_min--------- ---------- ---------------- ---------- ---------- ---------- ----------5761 200405 13060.433 26379.363 13189.6815 13318.93 13060.433 5761 200406 13318.930 40089.628 13363.2093 13710.265 13060.433 5761 200407 13710.265 41164.976 13721.6587 14135.781 13318.93 40089.628 = 13060.433 + 13318.930 + 13710.26513363.2093 = (13060.433 + 13318.930 + 13710.265) / 313710.265 = max(13060.433 + 13318.930 + 13710.265)13060.433 = min(13060.433 + 13318.930 + 13710.265)5761 200408 14135.781 27846.046 13923.023 14135.781 13710.265 5762 200405 12643.791 25438.851 12719.4255 12795.06 12643.791 5762 200406 12795.060 38663.148 12887.716 13224.297 12643.791 5762 200407 13224.297 39395.825 13131.9417 13376.468 12795.06 5762 200408 13376.468 26600.765 13300.3825 13376.468 13224.297 5763 200405 13060.433 26379.363 13189.6815 13318.93 13060.433 5763 200406 13318.930 40089.628 13363.2093 13710.265 13060.433 5763 200407 13710.265 41164.976 13721.6587 14135.781 13318.935763 200408 14135.781 27846.046 13923.023 14135.781 13710.265 5764 200405 12487.791 25782.978 12891.489 13295.187 12487.791 5764 200406 13295.187 39227.071 13075.6903 13444.093 12487.791 5764 200407 13444.093 40668.974 13556.3247 13929.694 13295.187 5764 200408 13929.694 27373.787 13686.8935 13929.694 13444.093 5765 200405 25057.736 51116.196 25558.098 26058.46 25057.736 5765 200406 26058.460 77418.077 25806.0257 26301.881 25057.736 5765 200407 26301.881 79490.979 26496.993 27130.638 26058.46 5765 200408 27130.638 53432.519 26716.2595 27130.638 26301.88120 rows selected.5. ratio_to_report函数的介绍Quote:1 select bill_month,area_code,sum(local_fare) local_fare,2 ratio_to_report(sum(local_fare)) over3 ( partition by bill_month ) area_pct4 from t5* group by bill_month,area_codeSQL> break on bill_month skip 1SQL> compute sum of local_fare on bill_monthSQL> compute sum of area_pct on bill_monthSQL> /BILL_MONTH AREA_CODE LOCAL_FARE AREA_PCT---------- --------- ---------------- ----------200405 5761 13060.433 .1711492795762 12643.791 .1656894315763 13060.433 .1711492795764 12487.791 .1636451435765 25057.736 .328366866********** ---------------- ----------sum 76310.184 1200406 5761 13318.930 .1690507725762 12795.060 .1624015425763 13318.930 .1690507725764 13295.187 .1687494145765 26058.460 .330747499********** ---------------- ----------sum 78786.567 1200407 5761 13710.265 .1705451975762 13224.297 .1645001275763 13710.265 .1705451975764 13444.093 .1672342215765 26301.881 .327175257********** ---------------- ----------sum 80390.801 1200408 5761 14135.781 .1709111475762 13376.468 .1617305395763 14135.781 .1709111475764 13929.694 .1684194165765 27130.638 .328027751********** ---------------- ----------sum 82708.362 120 rows selected.6 first,last函数使用介绍Quote:取出每月通话费最高和最低的两个用户.1 select bill_month,area_code,sum(local_fare) local_fare,2 first_value(area_code)3 over (order by sum(local_fare) desc4 rows unbounded preceding) firstval,5 first_value(area_code)6 over (order by sum(local_fare) asc7 rows unbounded preceding) lastval8 from t9 group by bill_month,area_code10* order by bill_monthSQL> /BILL_MONTH AREA_CODE LOCAL_FARE FIRSTVAL LASTVAL ---------- --------- ---------------- --------------- ---------------200405 5764 12487.791 5765 5764200405 5762 12643.791 5765 5764200405 5761 13060.433 5765 5764200405 5765 25057.736 5765 5764200405 5763 13060.433 5765 5764200406 5762 12795.060 5765 5764200406 5763 13318.930 5765 5764200406 5764 13295.187 **** ****200406 5765 26058.460 5765 5764200406 5761 13318.930 5765 5764200407 5762 13224.297 5765 5764200407 5765 26301.881 5765 5764200407 5761 13710.265 5765 5764200407 5763 13710.265 5765 5764200407 5764 13444.093 5765 5764200408 5762 13376.468 5765 5764200408 5764 13929.694 5765 5764200408 5761 14135.781 5765 5764200408 5765 27130.638 5765 5764200408 5763 14135.781 5765 576420 rows selected.。
ORACLE_分析函数大全

ORACLE_分析函数大全Oracle分析函数是一种高级SQL函数,它可以在查询中实现一系列复杂的分析操作。
这些函数可以帮助我们在数据库中执行各种数据分析和报表生成任务。
本文将介绍Oracle数据库中的一些常用分析函数。
1.ROW_NUMBER函数:该函数为查询结果中的每一行分配一个唯一的数字。
可以用它对结果进行排序或分组。
例如,可以使用ROW_NUMBER函数在结果集中为每个员工计算唯一的编号。
2.RANK和DENSE_RANK函数:这两个函数用于计算结果集中每个行的排名。
RANK函数返回相同值的行具有相同的排名,并且下一个排名值将被跳过。
DENSE_RANK函数类似,但是下一个排名值不会被跳过。
G和LEAD函数:LAG函数返回结果集中指定列的前一个(上一个)行的值,而LEAD函数返回后一个(下一个)行的值。
这些函数通常用于计算增长率或发现趋势。
4.FIRST和LAST函数:这两个函数用于返回结果集中分组的第一个和最后一个行的值。
可以与GROUPBY子句一起使用。
5.CUME_DIST函数:该函数用于计算给定值的累积分布。
它返回值的累积分布在结果集中的位置(百分比)。
6.PERCENT_RANK函数:该函数用于计算结果集中每个行的百分位数排名。
它返回值的百分位数排名(0到1之间的小数)。
7. NTILE函数:该函数用于将结果集分成指定数量的桶(Bucket),并为每个行分配一个桶号。
通常用于将数据分组为更小的块。
8.LISTAGG函数:该函数将指定列的值连接成一个字符串,并使用指定的分隔符分隔每个值。
可以用它将多个值合并在一起形成一个字符串。
9.AVG、SUM、COUNT和MAX/MIN函数:这些是常见的聚合函数,可以在分析函数中使用。
它们用于计算结果集中的平均值、总和、计数和最大/最小值。
以上只是Oracle数据库中的一些常用分析函数。
还有其他一些分析函数,如PERCENTILE_CONT、PERCENTILE_DISC等可以用于更高级的分析计算。
Oracle分析函数用法详解

Oracle分析函数Oracle分析函数实际上操作对象是查询出的数据集,也就是说不需二次查询数据库,实际上就是oracle实现了一些我们自身需要编码实现的统计功能,对于简化开发工作量有很大的帮助,特别在开发第三方报表软件时是非常有帮助的。
Oracle从8.1.6开始提供分析函数。
一、基本语法oracle分析函数的语法:function_name(arg1,arg2,...)over(<partition-clause> <order-by-clause ><windowing clause>)说明:1.partition-clause 数据记录集分组2.order-by-clause 数据记录集排序3.windowing clause 功能非常强大、比较复杂,定义分析函数在操作行的集合。
有三种开窗方式: range、row、specifying。
二、常用分析函数1. avg(distinct|all expression) 计算组内平均值,distinct 可去除组内重复数据select deptno,empno,sal,avg(sal) over (partition by deptno) avg_sal from t;DEPTNO EMPNO SAL AVG_SAL---------- ---------- ---------- ----------10 7782 2450 2916.666677839 5000 2916.666677934 1300 2916.6666720 7566 2975 21757902 3000 21757876 1100 21757369 800 21757788 3000 217530 7521 1250 1566.666677844 1500 1566.666677499 1600 1566.666677900 950 1566.666677698 2850 1566.666677654 1250 1566.666672.count(<distinct><*><expression>) 对组内数据进行计数3.rank() 和dense_rank()dense_rank()根据 order by 子句表达式的值,从查询返回的每一行,计算和其他行的相对位置,序号从 1 开始,有重复值时序号不跳号。
ORACLE中的ROW_NUMBEROVER分析函数的用法

ORACLE中的ROW_NUMBEROVER分析函数的用法ROW_NUMBER(OVER(是ORACLE数据库中的一个分析函数,用来为结果集中的每一行分配一个唯一的序号。
ROW_NUMBER(OVER(的语法是:ROW_NUMBER( OVER ( [ PARTITION BY expr1 [, expr2, ...] ]ORDER BY clause )其中,PARTITIONBY子句可选,用来指定分区依据的列或表达式;ORDERBY子句用来指定排序的列或表达式。
ROW_NUMBER(OVER(常用在查询结果需要进行分页或者进行排序后获取前几行的场景中。
以下是ROW_NUMBER(OVER(的用法示例:示例1:查询员工表中每个部门的员工数,并按照员工数降序排序。
SELECT department_id, count(*) as employee_count,ROW_NUMBER( OVER (ORDER BY count(*) DESC) as rankFROM employeesGROUP BY department_idORDER BY count(*) DESC;在这个示例中,ROW_NUMBER(OVER(函数根据部门中的员工数进行降序排序,并为每个部门分配一个唯一的序号。
示例2:查询员工表中每个部门的员工数,并按照员工数降序排序,并且只返回前三名。
SELECT department_id, count(*) as employee_count,ROW_NUMBER( OVER (ORDER BY count(*) DESC) as rankFROM employeesGROUP BY department_idWHERE rank <= 3ORDER BY count(*) DESC;在这个示例中,ROW_NUMBER(OVER(函数的结果用于限制查询结果只返回前三名。
示例3:查询员工表中每个部门的员工信息,并按照部门和薪水进行排序。
oracle累积求和分析函数sumover的使用

oracle累积求和分析函数sumover的使⽤oracle sum()over函数的使⽤over不能单独使⽤,要和分析函数:rank(),dense_rank(),row_number()等⼀起使⽤。
over函数的参数:over(partition by columnname1 order by columnname2)含义,按columname1指定的字段进⾏分组排序,或者说按字段columnname1的值进⾏分组排序。
例如:employees表中,有两个部门的记录:department_id =10和20select department_id,rank() over(partition by department_id order by salary) from employees 就是指在部门10中进⾏薪⽔的排名,在部门20中进⾏薪⽔排名。
如果是partition by org_id,则是在整个公司内进⾏排名。
-------------------------------sum(...) over ... 的使⽤根据over(...)条件的不同使⽤ sum(sal) over (order by ename)... 查询员⼯的薪⽔“连续”求和;注意over (order by ename)如果没有order by ⼦句,求和就不是“连续”的,把所有的值加到⼀起作为⼀个值。
体会⼀下不同之处:SQL> select deptno,ename,sal,2 sum(sal) over (order by ename) 连续求和,3 sum(sal) over () 总和, -- 此处sum(sal) over () 等同于sum(sal)4 100*round(sal/sum(sal) over (),4) "份额(%)"5 from emp6 / DEPTNO ENAME SAL 连续求和总和份额(%)---------- ---------- ---------- ---------- ---------- ----------20 ADAMS 1100 1100 29025 3.7930 ALLEN 1600 2700 29025 5.5130 BLAKE 2850 5550 29025 9.8210 CLARK 2450 8000 29025 8.4420 FORD 3000 11000 29025 10.3430 JAMES 950 11950 29025 3.2720 JONES 2975 14925 29025 10.2510 KING 5000 19925 29025 17.2330 MARTIN 1250 21175 29025 4.3110 MILLER 1300 22475 29025 4.4820 SCOTT 3000 25475 29025 10.3420 SMITH 800 26275 29025 2.7630 TURNER 1500 27775 29025 5.1730 WARD 1250 29025 29025 4.31使⽤⼦分区查出各部门薪⽔连续的总和。
Oracle分析函数使用总结
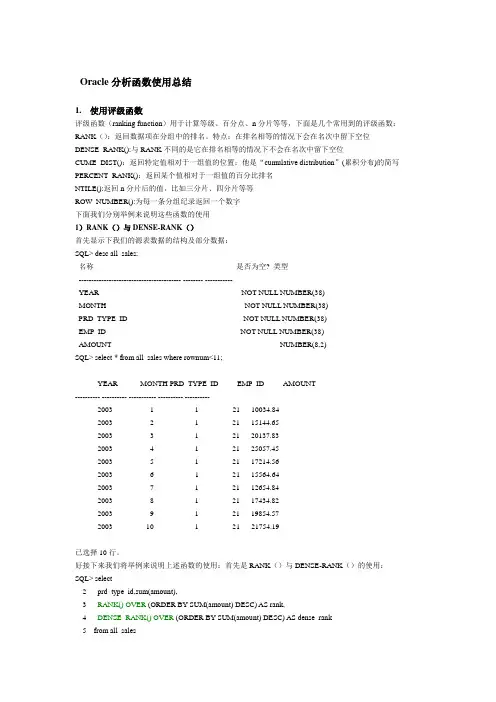
Oracle分析函数使用总结1.使用评级函数评级函数(ranking function)用于计算等级、百分点、n分片等等,下面是几个常用到的评级函数:RANK():返回数据项在分组中的排名。
特点:在排名相等的情况下会在名次中留下空位DENSE_RANK():与RANK不同的是它在排名相等的情况下不会在名次中留下空位CUME_DIST():返回特定值相对于一组值的位置:他是“cumulative distribution”(累积分布)的简写PERCENT_RANK():返回某个值相对于一组值的百分比排名NTILE():返回n分片后的值,比如三分片、四分片等等ROW_NUMBER():为每一条分组纪录返回一个数字下面我们分别举例来说明这些函数的使用1)RANK()与DENSE-RANK()首先显示下我们的源表数据的结构及部分数据:SQL> desc all_sales;名称是否为空? 类型----------------------------------------- -------- -----------YEAR NOT NULL NUMBER(38)MONTH NOT NULL NUMBER(38)PRD_TYPE_ID NOT NULL NUMBER(38)EMP_ID NOT NULL NUMBER(38)AMOUNT NUMBER(8,2)SQL> select * from all_sales where rownum<11;YEAR MONTH PRD_TYPE_ID EMP_ID AMOUNT---------- ---------- ----------- ---------- ----------2003 1 1 21 10034.842003 2 1 21 15144.652003 3 1 21 20137.832003 4 1 21 25057.452003 5 1 21 17214.562003 6 1 21 15564.642003 7 1 21 12654.842003 8 1 21 17434.822003 9 1 21 19854.572003 10 1 21 21754.19已选择10行。
oracle max over partition by用法

oracle max over partition by用法全文共四篇示例,供读者参考第一篇示例:Oracle数据库是一种关系数据库管理系统,提供了丰富的功能和语法来处理数据。
在处理数据的时候,我们经常需要使用分析函数来进行复杂的计算和分析,max over partition by是一种常用的功能之一。
本文将介绍max over partition by的用法以及它在实际应用中的作用。
在Oracle数据库中,max over partition by是一种分析函数,它可以在一组数据中查找指定列的最大值,并返回结果。
它的语法如下:```max(column) over (partition by column_name)```column是要查找最大值的列,而column_name则是根据哪个列进行分区。
通过在max后面加上over partition by关键字,我们可以在指定的分区内查找最大值。
举个例子来说明max over partition by的用法:假设有一个销售订单表orders,包含了订单号(order_id)、商品编号(product_id)和销售额(amount)三个字段,我们现在想要查找每个商品的销售额最大值。
我们可以使用max over partition by来实现:```select order_id, product_id, amount,max(amount) over (partition by product_id) asmax_amountfrom orders```在实际应用中,max over partition by有很多用途。
我们可以使用它来查找每个员工的最高工资、每个部门的最大利润等等。
通过对数据进行分区并利用分析函数,我们可以更方便地对数据进行深入分析和计算。
除了max over partition by之外,Oracle还提供了其他一些强大的分析函数,如min over partition by、sum over partition by等等,它们都可以帮助我们更加高效地处理复杂的数据分析任务。
oraclelag函数用法
oraclelag函数用法Lag函数是Oracle数据库中的一个分析函数,用于获取指定列的前一个记录的值。
Lag函数可以在查询结果中返回前一行的值,以便与当前行的值进行比较和计算。
Lag函数的一般语法如下:LAG (column, offset, default)OVER (PARTITION BY partition_col ORDER BY order_col)其中,column是指定的列名,offset是偏移量,表示要返回的前一行的偏移量,默认为1,即返回前一行的值。
default是可选的默认值,用于指定当无前一行时返回的值。
PARTITION BY子句是可选的,用于对查询结果进行分组,类似于GROUP BY子句。
ORDER BY子句用于按照指定的列对查询结果进行排序。
Lag函数的使用场景非常多,可以用于计算各种数据间的差异,分析序列数据的变化趋势,或者在查询结果中获取前一行的值等。
下面将通过一些示例来详细说明Lag函数的用法。
1.计算当前行与前一行的差值假设有一个订单表,其中包含订单号、订单金额和订单日期等列。
我们可以使用Lag函数计算当前订单金额与前一订单金额的差值,以便分析订单金额的变化情况。
SELECT order_number, order_amount,order_amount - LAG(order_amount, 1, 0) OVER (ORDER BYorder_number) AS diffFROM order_table;在以上示例中,LAG函数用于获取前一行的订单金额,然后与当前行的订单金额进行相减,得到订单金额的变化量。
第一个参数为订单金额列,第二个参数为偏移量1表示获取前一行的值,第三个参数为默认值0,表示当无前一行时返回0。
2.获取前一行的值Lag函数还可以用于在查询结果中获取前一行的值,以便与当前行的值进行比较和计算。
SELECT id, value, LAG(value, 1, 0) OVER (ORDER BY id) ASprev_valueFROM table_name;在以上示例中,LAG函数用于获取前一行的value值,然后将其作为列名为prev_value的新列添加到查询结果中。
Oracle分析函数-排序排列(rank、dense_rank、row_number、ntile)
Oracle分析函数-排序排列(rank、dense_rank、row_number、ntile)(1)rank函数返回⼀个唯⼀的值,除⾮遇到相同的数据时,此时所有相同数据的排名是⼀样的,同时会在最后⼀条相同记录和下⼀条不同记录的排名之间空出排名。
(2)dense_rank函数返回⼀个唯⼀的值,除⾮当碰到相同数据时,此时所有相同数据的排名都是⼀样的。
(3)row_number函数返回⼀个唯⼀的值,当碰到相同数据时,排名按照记录集中记录的顺序依次递增。
(4)ntile是要把查询得到的结果平均分为⼏组,如果不平均则分给第⼀组。
例如:create table s_score( s_id number(6),score number(4,2));insert into s_score values(001,98);insert into s_score values(002,66.5);insert into s_score values(003,99);insert into s_score values(004,98);insert into s_score values(005,98);insert into s_score values(006,80);selects_id,score,rank() over(order by score desc) rank --按照成绩排名,纯排名,dense_rank() over(order by score desc) dense_rank --按照成绩排名,相同成绩排名⼀致,row_number() over(order by score desc) row_number --按照成绩依次排名,ntile(3) over (order by score desc) group_s --按照分数划分成绩梯队from s_score;排名/排序的时候,有时候,我们会想到利⽤伪列row_num,利⽤row_num确实可以解决某些场景下的问题(但是相对也⽐较复杂),⽽且有些场景下的问题却很难解决。
Oracle之分析函数
Oracle之分析函数⼀、分析函数 1、分析函数 分析函数是Oracle专门⽤于解决复杂报表统计需求的功能强⼤的函数,它可以在数据中进⾏分组然后计算基于组的某种统计值,并且每⼀组的每⼀⾏都可以返回⼀个统计值。
2、分析函数和聚合函数的区别 普通的聚合函数⽤group by分组,每个分组返回⼀个统计值,⽽分析函数采⽤partition by分组,并且每组每⾏都可以返回⼀个统计值。
3、分析函数的形式 分析函数带有⼀个开窗函数over(),包含分析⼦句。
分析⼦句⼜由下⾯三部分组成: partition by :分组⼦句,表⽰分析函数的计算范围,不同的组互不相⼲; ORDER BY:排序⼦句,表⽰分组后,组内的排序⽅式; ROWS/RANGE:窗⼝⼦句,是在分组(PARTITION BY)后,组内的⼦分组(也称窗⼝),此时分析函数的计算范围窗⼝,⽽不是PARTITON。
窗⼝有两种,ROWS和RANGE; 使⽤形式如下:OVER(PARTITION BY xxx PORDER BY yyy ROWS BETWEEN rowStart AND rowEnd) 注:窗⼝⼦句在这⾥我只说rows⽅式的窗⼝,range⽅式和滑动窗⼝也不提。
⼆、OVER() 函数 1、sql 查询语句的 order by 和 OVER() 函数中的 ORDER BY 的执⾏顺序 分析函数是在整个sql查询结束后(sql语句中的order by的执⾏⽐较特殊)再进⾏的操作, 也就是说sql语句中的order by也会影响分析函数的执⾏结果: [1] 两者⼀致:如果sql语句中的order by满⾜分析函数分析时要求的排序,那么sql语句中的排序将先执⾏,分析函数在分析时就不必再排序; [2] 两者不⼀致:如果sql语句中的order by不满⾜分析函数分析时要求的排序,那么sql语句中的排序将最后在分析函数分析结束后执⾏排序。
2、分析函数中的分组/排序/窗⼝分析函数包含三个分析⼦句:分组(partition by),排序(order by),窗⼝(rows/range)窗⼝就是分析函数分析时要处理的数据范围,就拿sum来说,它是sum窗⼝中的记录⽽不是整个分组中的记录,因此我们在想得到某个栏位的累计值时,我们需要把窗⼝指定到该分组中的第⼀⾏数据到当前⾏, 如果你指定该窗⼝从该分组中的第⼀⾏到最后⼀⾏,那么该组中的每⼀个sum值都会⼀样,即整个组的总和。
oracle中over函数用法
oracle中over函数用法(实用版)目录1.Oracle 中 over 函数的概述2.over 函数的基本语法与参数3.over 函数的使用场景与实例4.over 函数与其他分析函数的配合使用5.总结正文一、Oracle 中 over 函数的概述Oracle 中的 over 函数是一种分析函数,用于对查询结果进行分区和排序。
它可以让我们在查询成绩时,按照不同的条件对数据进行汇总和分析,从而得到更加精确和具体的结果。
二、over 函数的基本语法与参数over 函数的基本语法如下:```over(partition, by, expr2, order, by, expr3)```其中,各个参数的含义如下:- partition:用于对结果进行分区的条件,可以是一个表分区或者一个列;- by:指定分区的顺序,可以是升序(ASC)或降序(DESC);- expr2:指定分区内的排序条件,可以是一个列或者一个表达式;- order:指定排序的顺序,可以是升序(ASC)或降序(DESC);- by:指定排序的列名;- expr3:可选参数,用于指定在每个分区内需要计算的聚合函数,如 sum、avg、count 等。
三、over 函数的使用场景与实例over 函数通常与 rownumber()、rank() 和 denserank、lag() 和lead() 等分析函数配合使用,以实现更加复杂的查询需求。
以下是一些常见的使用场景与实例:1.按照班级统计每个班级的总分和平均分:```select over(partition, by, t.class) sum(t.score) astotal_score, over(partition, by, t.class) avg(t.score) as average_scorefrom tscore t, ts_student swhere t.student_id = s.idorder by s.class;```2.按照时间分区,统计每个时间段内的总销售额:```select to_char(order_date, "YYYY-MM-DD") as sales_date, over(partition, by, to_char(order_date, "YYYY-MM-DD"))sum(sales_amount) as total_salesfrom salesorder by order_date;```3.计算每个学生的成绩排名:```select student_id, over(partition, by, rank()) rank_score from (select student_id, score, rownumber() over(order by score) as rankfrom exams) t;```四、over 函数与其他分析函数的配合使用over 函数可以与其他分析函数相互配合,以实现更加复杂的数据分析需求。