
fork函数
fork函数
在linux中,只有一个函数可以创建子进程:fork。
#include <sys/types.h>
#include <unistd.h>
pid_t fork(void);
由f o r k创建的新进程被称为子进程(child process)。
该函数被调用一次,但返回两次。
两次返回的区别是子进程的返回值是0,而父进程的返回值则是新子进程的进程I D。
将子进程I D返回给父进程的理由是:因为一个进程的子进程可以多于一个,所以没有一个函数使一个进程可以获得其所有子进程的进程I D。
f o r k使子进程得到返回值0的理由是:一个进程只会有一个父进程,所以子进程总是可以调用g e t p p i d以获得其父进程的进程I D (进程ID 0总是由交换进程使用,所以一个子进程的进程I D不可能为0 )。
子进程和父进程共享很多资源,除了打开文件之外,很多父进程的其他性质也由子进程继承:
• 实际用户I D、实际组I D、有效用户I D、有效组I D。
• 添加组I D。
• 进程组I D。
• 对话期I D。
• 控制终端。
• 设置-用户- I D标志和设置-组- I D标志。
• 当前工作目录。
• 根目录。
• 文件方式创建屏蔽字。
• 信号屏蔽和排列。
• 对任一打开文件描述符的在执行时关闭标志。
• 环境。
• 连接的共享存储段。
• 资源限制。
父、子进程之间的区别是:
• fork的返回值。
• 进程I D。
• 不同的父进程I D。
• 子进程的t m s _ u t i m e , t m s _ s t i m e , t m s _ c u t i m e以及t m s _ u s t
i m e设置为0。
• 父进程设置的锁,子进程不继承。
• 子进程的未决告警被清除。
• 子进程的未决信号集设置为空集。
使f o r k失败的两个主要原因是:( a )系统中已经有了太多的进程(通常意味着某个方面出了问题),或者( b )该实际用户I D的进程总数超过了系统限制。
回忆表2 - 7,其中C H I L D _ M A X规定了每个实际用户I D在任一时刻可具有的最大进程数。
f o r k有两种用法:
(1) 一个父进程希望复制自己,使父、子进程同时执行不同的代码段。
这在
网络服务进程中是常见的——父进程等待委托者的服务请求。
当这种请求到达时,父进程调用f o r k,使子进程处理此请求。
父进程则继续等待下一个服务请求。
(2) 一个进程要执行一个不同的程序。
这对s h e l l是常见的情况。
在这种情
况下,子进程在从f o r k返回后立即调用e x e c。
我们从一个例子程序中可以看到fork函数的作用,子进程与父进程之间的资源共享。
getpid
getpid(取得进程识别码)
相关函数: fork,kill,getpid
表头文件: #include<unistd.h>
定义函数: pid_t getpid(void);
函数说明:
getpid()用来取得目前进程的进程识别码,许多程序利用取到的
此值来建立临时文件,以避免临时文件相同带来的问题。
返回值:目前进程的进程识别码
范例:
#include<unistd.h>
main()
{
printf(“pid=%d\n”,getpid());
}
执行:
pid=1494。
fork函数实例

fork函数实例fork函数是操作系统中一个非常重要的函数,它的作用是创建一个新的进程。
在本文中,我们将详细介绍fork函数的使用方法和原理。
一、fork函数的使用方法在C语言中,fork函数的原型如下:```c#include <sys/types.h>#include <unistd.h>pid_t fork(void);```调用fork函数会创建一个新的进程,这个新进程是调用进程的一个副本。
新进程与调用进程几乎完全相同,包括代码、数据和打开的文件等。
fork函数的返回值有以下三种情况:- 若返回值为-1,表示fork函数调用失败,新进程创建失败;- 若返回值为0,表示当前进程为新创建的子进程;- 若返回值大于0,表示当前进程为父进程,返回值为子进程的进程ID。
我们可以根据fork函数的返回值来判断当前进程是父进程还是子进程,并相应地对它们进行不同的处理。
下面是一个简单的示例代码:```c#include <stdio.h>#include <unistd.h>int main() {pid_t pid = fork();if (pid < 0) {printf("fork error");} else if (pid == 0) {printf("This is child process. PID: %d\n", getpid());} else {printf("This is parent process. PID: %d, Child PID: %d\n", getpid(), pid);}return 0;}```运行上述代码,可以看到输出结果中会有两行信息,分别表示父进程和子进程的相关信息。
二、fork函数的原理fork函数的原理是通过创建一个与当前进程几乎完全相同的新进程来实现的。
fork函数超详解及其用法
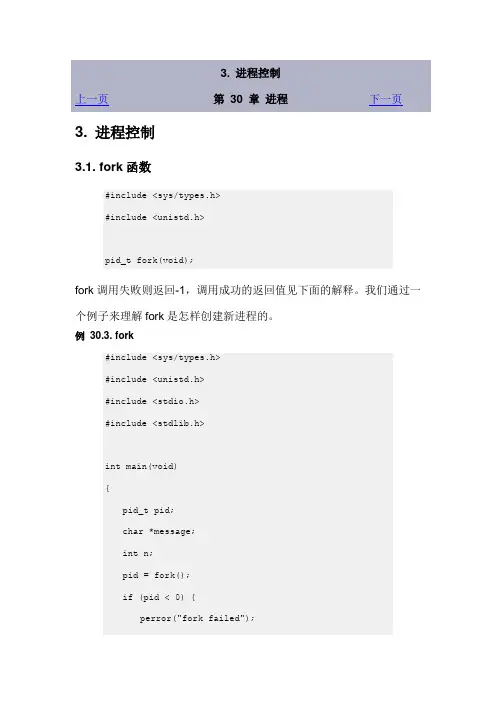
3. 进程控制上一页第30 章进程下一页3. 进程控制3.1. fork函数#include <sys/types.h>#include <unistd.h>pid_t fork(void);fork调用失败则返回-1,调用成功的返回值见下面的解释。
我们通过一个例子来理解fork是怎样创建新进程的。
例30.3. fork#include <sys/types.h>#include <unistd.h>#include <stdio.h>#include <stdlib.h>int main(void){pid_t pid;char *message;int n;pid = fork();if (pid < 0) {perror("fork failed");exit(1);}if (pid == 0) {message = "This is the child\n"; n = 6;} else {message = "This is the parent\n"; n = 3;}for(; n > 0; n--) {printf(message);sleep(1);}return 0;}$ ./a.outThis is the childThis is the parentThis is the childThis is the parentThis is the childThis is the parentThis is the child$ This is the childThis is the child这个程序的运行过程如下图所示。
图30.4. fork父进程初始化。
父进程调用fork,这是一个系统调用,因此进入内核。
内核根据父进程复制出一个子进程,父进程和子进程的PCB信息相同,用户态代码和数据也相同。
fork函数
父进程
父进程
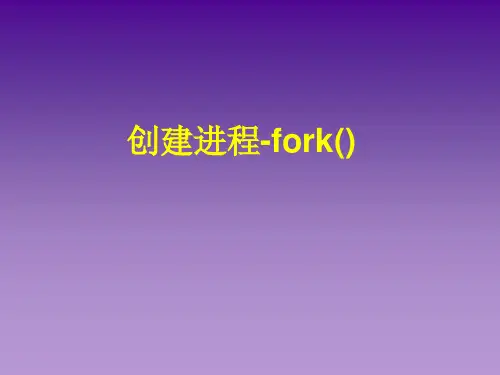
#include <sys/types.h> main() 执 { 行 pid_t val; printf(“PID…); 分裂 val=fork(); if(val!=0) printf(“parent…”); else printf(“child…); }
main( ) { pid_t val; printf(“PID…); val=fork(); if(val!=0) printf(“parent…”); else printf(“child…); }
运行结果1 global=5,vari=4;
global=4,vari=5;
运行结果2
global=4,vari=5; global=5,vari=4
分析:子进程和父进程的数据段、堆栈段不同。子进程执 行语句“global++,vari—”时,只是对自己的数据段 进行了修改,并未影响到父进程的数据段,
exec()—执行一个文件的调用
子进程如何执行一个新的程序文本?
通过exec()调用族,加载新的程序文本
通过一个系统调用exec,子进程可以拥有自己的可 执行代码。即exec用一个新进程覆盖调用进程。 它的参数包括新进程对应的文件和命令行参数。成 功调用时,不再返回;否则,返回出错原因。 六种exec调用格式:各种调用的区别在于参数的处 理方法不同,常用的格式有:
void main(void) { printf(“Hello \n”); fork(); printf(“Bye \n”); }
运行结果 Hello Bye Bye
fork()调用例子(2)
#include<stdio.h> #Include<sys/types.h> #include<unistd.h> void main(void){ if (fork()==0) printf(“In the CHILD process\n”); else printf(“In the PARENT process\n”); }
进程控制之fork函数
进程控制之fork函数⼀个现有进程可以调⽤fork函数创建⼀个新进程。
#include <unistd.h>pid_t fork( void );返回值:⼦进程中返回0,⽗进程中返回⼦进程ID,出错返回-1由fork创建的新进程被称为⼦进程(child process)。
fork函数被调⽤⼀次,但返回两次。
两次返回的唯⼀区别是⼦进程的返回值是0,⽽⽗进程的返回值则是新⼦进程的进程ID。
将⼦进程ID返回给⽗进程的理由是:因为⼀个进程的⼦进程可以有多个,并且没有⼀个函数使⼀个进程可以获得其所有⼦进程的进程ID。
fork使⼦进程得到返回值0的理由是:⼀个进程只会有⼀个⽗进程,所以⼦进程总是可以调⽤getppid以获得其⽗进程的进程ID(进程ID 0总是由内核交换进程使⽤,所以⼀个⼦进程的进程ID不可能为0)。
⼦进程和⽗进程继续执⾏fork调⽤之后的指令。
⼦进程是⽗进程的副本。
例如,⼦进程获得⽗进程的数据空间、堆和栈的副本。
注意,这是⼦进程所拥有的副本。
⽗、⼦进程并不共享这些存储空间部分。
⽗、⼦进程共享正⽂段(text,代码段)。
由于在fork之后经常跟随着exec,所以现在的很多实现并不执⾏⼀个⽗进程数据段、栈和堆的完全复制。
作为替代,使⽤了写时复制(Copy-On-Write,COW)技术。
这些区域由⽗、⼦进程共享,⽽且内核将它们的访问权限改变为只读的。
如果⽗、⼦进程中的任⼀个试图修改这些区域,则内核只为修改区域的那块内存制作⼀个副本,通常是虚拟存储器系统中的⼀“页”。
Linux 2.4.22提供了另⼀种新进程创建函数——clone(2)系统调⽤。
这是⼀种fork的泛型,它允许调⽤者控制哪些部分由⽗、⼦进程共享。
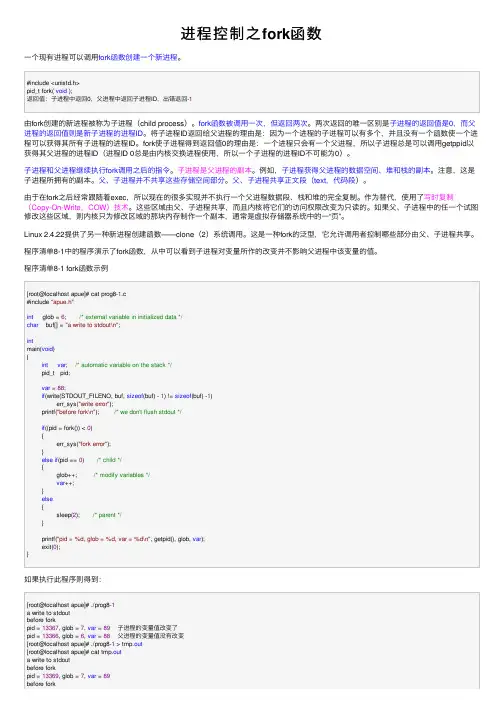
程序清单8-1中的程序演⽰了fork函数,从中可以看到⼦进程对变量所作的改变并不影响⽗进程中该变量的值。
程序清单8-1 fork函数⽰例[root@localhost apue]# cat prog8-1.c#include "apue.h"int glob = 6; /* external variable in initialized data */char buf[] = "a write to stdout\n";intmain(void){int var; /* automatic variable on the stack */pid_t pid;var = 88;if(write(STDOUT_FILENO, buf, sizeof(buf) - 1) != sizeof(buf) -1)err_sys("write error");printf("before fork\n"); /* we don't flush stdout */if((pid = fork()) < 0){err_sys("fork error");}else if(pid == 0) /* child */{glob++; /* modify variables */var++;}else{sleep(2); /* parent */}printf("pid = %d, glob = %d, var = %d\n", getpid(), glob, var);exit(0);}如果执⾏此程序则得到:[root@localhost apue]# ./prog8-1a write to stdoutbefore forkpid = 13367, glob = 7, var = 89⼦进程的变量值改变了pid = 13366, glob = 6, var = 88⽗进程的变量值没有改变[root@localhost apue]# ./prog8-1 > tmp.out[root@localhost apue]# cat tmp.outa write to stdoutbefore forkpid = 13369, glob = 7, var = 89before forkpid = 13368, glob = 6, var = 88⼀般来说,在fork之后是⽗进程先执⾏还是⼦进程先执⾏是不确定的。
新手如何理解fork函数_华清远见
对全部高中资料试卷电气设备,在安装过程中以及安装结束后进行高中资料试卷调整试验;通电检查所有设备高中资料电试力卷保相护互装作置用调与试相技互术关,系电,力通根保1据过护生管高产线中工敷资艺设料高技试中术卷资0配不料置仅试技可卷术以要是解求指决,机吊对组顶电在层气进配设行置备继不进电规行保范空护高载高中与中资带资料负料试荷试卷下卷问高总题中体2资2配,料置而试时且卷,可调需保控要障试在各验最类;大管对限路设度习备内题进来到行确位调保。整机在使组管其高路在中敷正资设常料过工试程况卷中下安,与全要过,加度并强工且看作尽护下可关都能于可地管以缩路正小高常故中工障资作高料;中试对资卷于料连继试接电卷管保破口护坏处进范理行围高整,中核或资对者料定对试值某卷,些弯审异扁核常度与高固校中定对资盒图料位纸试置,卷.编保工写护况复层进杂防行设腐自备跨动与接处装地理置线,高弯尤中曲其资半要料径避试标免卷高错调等误试,高方要中案求资,技料编术试写5交、卷重底电保要。气护设管设装备线备置4高敷、调动中设电试作资技气高,料术课中并3试、中件资且卷管包中料拒试路含调试绝验敷线试卷动方设槽技作案技、术,以术管来及架避系等免统多不启项必动方要方式高案,中;为资对解料整决试套高卷启中突动语然过文停程电机中气。高课因中件此资中,料管电试壁力卷薄高电、中气接资设口料备不试进严卷行等保调问护试题装工,置作合调并理试且利技进用术行管,过线要关敷求运设电行技力高术保中。护资线装料缆置试敷做卷设到技原准术则确指:灵导在活。分。对线对于盒于调处差试,动过当保程不护中同装高电置中压高资回中料路资试交料卷叉试技时卷术,调问应试题采技,用术作金是为属指调隔发试板电人进机员行一,隔变需开压要处器在理组事;在前同发掌一生握线内图槽部纸内 故资,障料强时、电,设回需备路要制须进造同行厂时外家切部出断电具习源高题高中电中资源资料,料试线试卷缆卷试敷切验设除报完从告毕而与,采相要用关进高技行中术检资资查料料和试,检卷并测主且处要了理保解。护现装场置设。备高中资料试卷布置情况与有关高中资料试卷电气系统接线等情况,然后根据规范与规程规定,制定设备调试高中资料试卷方案。
fork函数详解
fork函数详解1.函数原型:```c#include <sys/types.h>#include <unistd.h>pid_t fork(void);```在父进程中,fork函数返回新创建的子进程的PID;在子进程中,fork函数返回0。
如果fork函数调用失败,则返回-12.函数功能:fork函数将调用它的进程(父进程)复制一份,并创建一个新的进程(子进程)。
这两个进程几乎是完全相同的,只有PID不同。
父进程中的所有资源(内存、文件描述符等)都会被复制到子进程中,子进程开始执行的位置是从fork函数返回的点开始的。
3.函数用法:fork函数的用法非常简单。
在程序中调用fork函数时,会创建一个新的子进程。
之后,父进程和子进程会并行执行,但是它们执行的顺序是不确定的。
父进程和子进程中的代码是完全独立的,它们可以有不同的数据,走不同的分支,执行不同的操作。
4.函数执行结果:- 如果fork函数返回值大于0,说明调用成功且处于父进程中。
此时返回的值就是新创建的子进程的PID。
- 如果fork函数返回值等于0,说明处于子进程中。
- 如果fork函数返回值小于0,说明调用失败。
5.函数使用注意事项:- fork函数并不是真正的复制,而是通过写时复制(copy-on-write)技术进行优化。
在fork函数调用时,父进程和子进程共享相同的物理内存块,只有在其中一个进程试图修改内存时才会进行复制。
- fork函数会复制父进程的打开文件描述符。
但是,需要注意的是,父进程和子进程会共享文件的偏移量,读写文件时应该注意这个问题。
- fork函数之后,子进程会继承父进程的信号处理程序和文件锁,并且会共享父进程的信号处理程序和文件锁状态。
6.参数类型:- pid_t:是进程的ID,它是一个无符号整数类型,被定义在sys/types.h中。
7.函数调用示例:```c#include <stdio.h>#include <unistd.h>int main(void)pid_t pid;int x = 1;pid = fork(;if (pid == 0)printf("Child process: x = %d\n", ++x);} elseprintf("Parent process: x = %d\n", --x);}```上述示例中,首先声明了一个pid_t类型的变量pid和一个整型变量x。
对fork函数的理解
对fork函数的理解前言:对于刚刚接触Unix/Linux操作系统,在Linux下编写多进程的人来说,fork 是最难理解的概念之一:它执行一次却返回两个值。
因此,本文着重从以下几个方面来使初学者加深对fork函数的理解和应用:fork函数的机制与特性、fork 函数的两次返回和父子进程的执行顺序介绍、关键字:fork函数、返回值、父进程、子进程正文:一、fork函数的机制与特性1 #include<stdio.h>2 #include<unistd.h>3 #include<stdlib.h>45 int main(void)6 {7 pid_t pid;8 if ((pid = fork()) == 00) {9 getchar();10 exit(0);11 }12 getchar ();13}14父进程成功的调用fork(8行)后将会产生一个子进程。
此时会有两个问题:1、子进程的代码从哪里来?2、子进程首次被OS调用时,执行的第一条代码是哪条代码?子进程的代码是父进程代码的一个完全相同拷贝。
事实上不仅仅是text 段,子进程中的全部进程空间都是(包括:text/data/bss/heap/commandline/envir onment)父进程空间的一个完全拷贝。
下一个问题是谁为子进程分配了内存空间?谁复制了父进程空间的内容到子空间?fork当仁不让。
事实上,fork 实现的源代码,由四部分组成:首先,为子进程分配内存空间;然后,将父进程空间的全部内容复制到分配给子进程的内存空间;接着在内核数据结构中创建并正确初始化子进程的PCB (包括两个重要信息:子进程pid,PC 的值=善后代码的第一条指令地址);最后是一段善后代码。
由于子进程的PCB已经产生,因此子进程可以被OS调度子进程首次被OS调度时,执行的第一条代码在fork 内部,不过从引用程序的角度来看,子进程首次被OS调度时,执行的第一条代码是从fork返回。
fork函数 用法
fork函数用法**标题:fork函数用法详解****一、概述**fork函数是Unix/Linux操作系统中常用的系统调用之一,它用于创建一个新的进程,并返回新进程的进程ID。
这个函数是在调用进程中创建新进程的基础,可以在当前进程的基础上,生成一个新的子进程,父进程和子进程之间可以共享一些数据,但是也必须考虑并发环境中的安全问题。
**二、函数原型**在Unix/Linux系统中,fork函数的基本原型为:intfork(void)。
这个函数会在调用它的进程中创建一个新的进程,并返回两个值:新创建的子进程的进程ID和父进程的进程ID。
如果返回值为-1,则表示fork函数调用失败。
**三、使用场景**fork函数主要用于创建一个新的进程,该进程继承了父进程的环境和状态。
在多线程或多进程编程中,fork函数可以帮助我们更好地管理并发环境中的资源。
例如,在父进程中创建一个新的子进程来执行一些特定的任务,子进程可以继承父进程的一些资源(如打开的文件描述符),而父进程则可以继续执行其他任务。
**四、注意事项**在使用fork函数时,需要注意以下几点:1. fork函数会创建一个新的进程,并返回两个值。
因此,需要确保在调用fork函数之前已经正确地分配了足够的内存空间来保存返回的两个值。
2. fork函数创建的新进程与原进程共享一些资源(如打开的文件描述符),但也需要注意并发环境中的安全问题。
例如,需要确保在子进程中关闭父进程打开的文件描述符,以避免资源泄漏。
3. 在子进程中执行一些操作时,需要考虑到父进程的状态和环境。
例如,如果父进程正在等待某个条件成立(如某个文件被修改),则需要考虑到子进程是否会改变这个条件。
4. fork函数在创建新进程时,会复制一部分父进程的内存空间到新的子进程中。
因此,如果父进程的内存空间非常大,则创建子进程所消耗的时间和内存也会相应增加。
**五、示例代码**下面是一个简单的示例代码,展示了fork函数的使用方法:```c#include <stdio.h>#include <unistd.h>#include <sys/types.h>int main() {pid_t pid; // 用于保存新创建的子进程的进程ID// 调用fork函数创建新进程pid = fork();// 判断fork函数是否成功if (pid < 0) {printf("Fork failed!\n");return 1;} else if (pid == 0) { // 子进程结束循环执行完毕后返回0,否则返回-1结束程序运行// 子进程代码段...while(1) { // 循环执行一些任务...} } else { // 父进程代码段...} // 父进程继续执行其他任务...}```六、总结**fork函数是Unix/Linux系统中的一个重要系统调用,用于在调用进程中创建一个新的子进程。
fork函数的2个返回值说明
fork简介:fork英文原意是“分岔,分支”的意思,而在操作系统中,乃是著名的Unix(或类Unix,如Linux,Minix)中用于创建子进程的系统调用。
【NOTE1】fork () 的作用是什么?换句话说,你用fork () 的目的是什么?――是为了产生一个新的进程,地球人都知道:)产生一个什么样的进程?――和你本来调用fork () 的那个进程基本一样的进程,其实就是你原来进程的副本;真的完全一样吗?――当然不能完全一样,你要两个除了pid 之外其它一模一样的进程干什么,就算memory 再多也不用这么摆谱吧?哪里不一样?――当然最重要的是fork () 之后执行的代码不一样,you know, i know :)怎么实现呢?――如果是Windows,它会让你在fork () 里面提供一大堆东西,指明这个那个什么的…… 我用的是unix 啊――所以很简单,unix 会让两个进程(不错,原来是一个,unix 替你复制了一个,现在有两个)在fork () 之后产生不同:返回值不同。
其中一个进程(使用新的pid)里面的fork () 返回零,这个进程就是“子进程”;而另一个进程(使用原来的pid)中的fork () 返回前面那个子进程的pid,他自己被称为“父进程”然后呢?――写代码的人又不笨,当然就根据返回值是否非零来判断了,现在我是在子进程里面呢,还是在父进程里面?在子进程里面就执行子进程该执行的代码,在父进程里面就执行父进程的代码……有铁杆windows fans 借此说明,windows 好啊,子进程用子进程的代码,父进程用父进程的,你unix 笨了吧,子进程包含父进程、子进程的代码,父进程包含父进程子进程的代码,岂不是多占用内存了吗?――据我所知,unix 代码段都是可重入代码,也就是说,进程复制,并不复制代码段,若干个进程共享同一代码段,增加的只是全局共享数据和对文件描述符的引用等,另外就是堆栈。
fork
2)vfork()系统调用除了能保证用户空间内存不会被复制之外,它与fork几乎是完全相同的.vfork存在的问题是它要求子进程立即调用exec,
而不用修改任何内存,这在真正实现的时候要困难的多,尤其是考虑到exec调用有可能失败.
./test
count= 1
count= 1
Segmentation fault (core dumped)
分析:
通过将fork()换成vfork(),由于vfork()是共享数据段,为什么结果不是2呢,答案是:
vfork保证子进程先运行,在它调用 exec 或 exit 之后父进程才可能被调度运行.如果在调用这两个函数之前子进程依赖于父进程的进一步动作,则会导致死锁.
示例代码:
#include <unistd.h>
#include <stdio.h>
int main(int argc, char ** argv )
{
int pid = fork();
if(pid == -1 )
{
// print("error!");
} else if( pid = =0 ) {
3)做最后的修改,在子进程执行时,调用_exit(),程序如下:
#include <unistd.h>
#include <stdio.h>
#include <sys/types.h>
int main(void)