
ORACLE_SQL性能优化(全)
不同调整产生相应性能收益
调整的角色
SQL语句优化是提高性能的重要 环节
开发人员不能只注重功能的实现,不
管性能如何
开发人员不能把Oracle当成一个黑盒
子,必须了解其结构、处理SQL和数 据的方法
必需遵守既定的开发规范
SQL语句优化的过程
定位有问题的语句 检查执行计划
检查执行过程中优化器的统计信息
什么叫做重编译问题
什么叫做重编译? 下面这个语句每执行一次就需要在SHARE POOL 硬解析一 次,一百万用户就是一百万次,消耗CPU和内存,如果业务 量大,很可能导致宕库…… 如果绑定变量,则只需要硬解析一次,重复调用即可 select * from dConMsg where contract_no = 32013484095139
共享游标:好处
1. 减少解析 2. 动态内存调整 3. 提高内存使用率
书写可共享的SQL
绑定变量和共享游标
ORACLE 优化器模式 概述
Oracle的优化器共有3种模式:RULE (基于规则)、COST (基于成本)、CHOOSE(基于选择)。 设置缺省的优化器的方法,是在启动参数文件中针对 OPTIMIZER_ MODE参数的各种声明进行选择,如RULE、COST、 CHOOSE、ALL_ ROWS、FIRST_ ROWS。当然也可以在SQL语 句级别或是会话级别对其进行覆盖。 为了使用基于成本的优化器(CBO,Cost—Based Optimizer), 必须经常运行analyze命令,以增加数据库中的对象统计信息 (object statistics)的准确性。 如果数据库的优化器模式设置为基于选择,那么实际的优化 器模式将和是否运行过analyze命令有关。如果数据表已经被 analyze过,优化器模式将自动切换成CBO,反之,数据库将采用 RULE形式的优化器。在缺省情况下,Oracle采用CHOOSE优化 器。为避免那些不必要的全表扫描,必须尽量避免使用 CHOOSE优化器,而直接采用基于规则或者基于成本的优化器。
绑定变量解决重编译问题
未使用绑定变量的语句 sprintf(sqlstr, "insert into scott.test1 (num1, num2) values (%d,%d)",n_var1, n_var2);
EXEC SQL EXECUTE IMMEDIATE :sqlstr ; EXEC SQL COMMIT;
使用绑定变量的语句 strcpy(sqlstr, "insert into test (num1, num2) values (:v1, :v2)"); EXEC SQL PREPARE sql_stmt FROM :sqlstr; EXEC SQL EXECUTE sql_stmt USING :n_var1, :n_var2; EXEC SQL COMMIT;
● 第一组 select pin,name from people where pin = :blk1.pin; select pin,name from people where pin =:blk1.pin; ●第二组 select pin,name from people where pin =:blk1.ot_jnd; select pin,name from people where pin = :blk1.ov_jnd;
SQL:
insert, update, delete, select; 主要关注的是select 关注的是:如何用最小的硬件资源消 耗、最少的响应时间定位数据位置
SQL优化的一般性原则
目标: 减少服务器资源消耗(主要是磁盘IO); 设计方面: 尽量依赖oracle的优化器,并为其提供条件; 合适的索引,索引的双重效应,列的选择性; 编码方面: 利用索引,避免大表FULL TABLE SCAN; 合理使用临时表; 避免写过于复杂的sql,不一定非要一个sql解决问题; 在不影响业务的前提下减小事务的粒度;
分析相关表的记录数、索引情况
改写SQL语句些SQL语句不具备优化的可能,需 要优化处理方式
什么是好的SQL语句?
尽量简单,模块化
易读、易维护
节省资源
内存 CPU 扫描的数据块要少 少排序
不造成死锁
SQL共享原理
ORACLE将执行过的SQL语句存放在内存的共享池 (shared buffer pool)中,可以被所有的数据库用户共享。 当你执行一个SQL语句(有时被称为一个游标)时, 如果它和之前的执行过的语句完全相同, ORACLE就能很快获得已经被解析的语句以及最好 的 执行路径. 这个功能大大地提高了 SQL的执行性能并节省了内存的使用。
SQL共享的三个条件
当前被执行的语句和共享池中的语句必须完全相同 (包括大小写、空格、换行等) 两个语句所指的对象必须完全相同 (同义词与表是 不同的对象) 两个SQL语句中必须使用相同的名字的绑定变量 (bind variables)
共享SQL语句
注意:
Oracle对两者采取的是一种严格匹配策略,要达成共享。SQL语句必 须完全相同(包括空格、换行等)。能够使用共享的语句必须满足三个 条件:
SQL语句的处理过程
共享SQL区域
Sql 处理过程
SQL PARSE与共享SQL语句
当一个Oracle实例接收一条sql后 1、Create a Cursor 创建游标 2、Parse the Statement 分析语句 3、Describe Results of a Query 描述查询的结果集 4、Define Output of a Query 定义查询的输出数据 5、Bind Any Variables 绑定变量 6、Parallelize the Statement 并行执行语句 7、Run the Statement 运行语句 8、Fetch Rows of a Query 取查询出来的行 9、Close the Cursor 关闭游标
访问数据表的方式
① 全表扫描 全表扫描就是顺序地访问表中每条记录。Oracle采用一次 读入多个数据块(database block)的方式优化全表扫描。
② 通过ROWID访问表 ROWID包含了表中记录的物理位置信息。可以采用基于 ROWID的访问方式情况提高访问表的效率。Oracle采用索 引实现了数据和存放数据的物理位置(ROWID)之间的联系 通常索引提供了快速访问ROWID的方法,因此那些基于索 引列的查询就可以得到性能的提高。
① 字符级的比较。 当前被执行的语句和共享池中的语句必须完全相同。 例如: SELECT * FROM ATABLE;和下面每一个SQL语句都不同: SELECT *from ATABLE Select * From Atable; ② 语句所指对象必须完全相同 即两条SQL语句操作的数据库对象必须同一。 ③语句中必须使用相同命名的绑定变量。如:第一组的两个SQL语句是相同 的,可以共享;而第二组中两个语句不同,即使在运行时赋予不同的绑定变 量以相同的值:
调优领域
调优领域:
1. 应用程序级调优: * SQL语句调优 * 管理变化调优
2. 实例级调优 * 内存 * 数据结构 * 实例配置
3. 操作系统交互 * I/O * SWAP * Parameters 本课程内容只讲解讨论应用程序级: Oracle SQL语句调优及管理变化调优
调整的方法
1. 调整业务功能 2. 调整数据设计 3. 调整流程设计 4. 调整SQL语句 5. 调整物理结构 6. 调整内存分配 7. 调整I/O 8. 调整内存竞争 9. 调整操作系统
SQL语句的处理过程
绑定(BIND): 1. 在语句中查找绑定变量 2. 赋值(或重新赋值)
SQL语句的处理过程
执行(EXECUTE): 1. 应用执行计划 2. 执行必要的I/O和排序操作 提取(FETCH): 1. 从查询结果中返回记录 2. 必要时进行排序 3. 使用ARRAY FETCH机制
SQL共享原理
为了不重复解析相同的SQL语句,在第一次解析之后, Oracle将SQL语句存放在内存中。这块位于系统全局区域 SGA(systemglobal area)的共享池(shared buffer poo1)中的 内存可以被所有的数据库用户共享。因此,当你执行一个 SQL 语句(有时被称为一个游标)时,如果它和之前执行过的语句完全 相同,Oracle就能很快获得已经被解析的语句以及最好的执行 方案。Oracle的这个功能大大地提高了SQL的执行性能并节省 了内存的使用。 可惜的是,Oracle只对简单的表提供高速缓冲 (cache bufferiIlg),这个功能并不适用于多表连接查询。数据 库管理员必须在启动参数文件中为这个区域设置合适的参数, 当这个内存区域越大,就可以保留更多的语句,当然被共享的 可能性也就越大了。当向Oracle提交一个SQL语句时,Oracle 会首先在这块内存中查找相同的语句。
绑定变量的注意事项
注意: 1、不要使用数据库级的变量绑定参数 cursor_sharing来强 制绑定,无论其值为 force 还是similar 2、有些带> < 的语句绑定变量后可能导致优化器无 法正确 使用索引
SQL语句的处理过程
SQL语句的四个处理阶段
SQL语句的处理过程
解析(PARSE): 1. 在共享池中查找SQL语句 2. 检查语法 3. 检查语义和相关的权限 4. 合并(MERGE)视图定义和子查询 5. 确定执行计划
为什么要bind variables?
字符级的比较: SELECT * FROM USER_FILES WHERE USER_NO = ‘10001234’; 与 SELECT * FROM USER_FILES WHERE USER_NO = ‘10004321’;
oracle优化方法总结
千里之行,始于足下。
oracle优化方法总结Oracle优化是提高数据库性能和响应能力的重要步骤。
本文总结了一些常见的Oracle优化方法。
1. 使用索引:索引是提高查询性能的主要方法。
通过在表中创建适当的索引,可以加快查询速度,并减少数据访问的开销。
但是要注意不要过度使用索引,因为过多的索引会增加写操作的开销。
2. 优化查询语句:查询语句的效率直接影响数据库的性能。
可以通过合理地编写查询语句来提高性能。
例如,使用JOIN来替代子查询,尽量避免使用通配符查询,使用LIMIT来限制结果集的大小等。
3. 优化表结构:表的设计和结构对数据库的性能也有很大的影响。
合理的表设计可以减少数据冗余和不必要的数据存储,提高查询速度。
例如,适当地使用主键、外键和约束,避免过多的数据类型和字段等。
4. 优化数据库参数设置:Oracle有很多参数可以用来调整数据库的性能。
根据具体的应用场景和需求,可以根据情况调整参数的值。
例如,调整SGA和PGA的大小,设置合适的缓冲区大小,调整日志写入方式等。
5. 使用分区表:当表的数据量很大时,可以考虑将表分成多个分区。
分区表可以加速查询和维护操作,提高数据库的性能。
可以按照时间、地域、业务等来进行分区。
6. 优化存储管理:Oracle提供了多种存储管理选项,如表空间和数据文件管理。
合理地分配存储空间和管理数据文件可以提高数据库的性能。
例如,定期清理无用的数据文件,使用自动扩展表空间等。
第1页/共2页锲而不舍,金石可镂。
7. 数据压缩:对于大量重复数据或者冷数据,可以考虑使用Oracle的数据压缩功能。
数据压缩可以减少磁盘空间的使用,提高IO性能。
8. 使用并行处理:对于大型计算或者批处理任务,可以考虑使用Oracle的并行处理功能。
并行处理可以将任务分成多个子任务,并行执行,提高处理能力和效率。
9. 数据库分区:对于大型数据库,可以考虑将数据库分成多个独立的分区。
数据库分区可以提高数据的并行处理能力,减少锁竞争和冲突,提高数据库的性能。
Oracle SQL语句优化技术分析
O a e S L 句的性 能问题 常常是 由于 rl Q 语 c 在索引设计和查询设计方面存在各种缺陷引起 的。 Q 优化的实质就是在结果正确的前提下 , SL 充份利用索引 , 减少表扫描的 I / O次数 , 尽量避 免表搜索的发生 。 其实 S L Q 的性能优 化是一个 复杂的过程 ,以上这些只是在应用层次 的一种 体现 , 深入研究还会涉及数据库层 的资源配置 、 网络层的流量控制 以及操作系统层 的总体设计 如 等等方面 , 已经超 出本文所要讨论 的范 围, 这些 S EC EL T FROM US ER LOG WHER 因此不在本文赘述 了。 E 总之 Oal S L语句 的 r e Q c USE N R AME ei ( L C U E _ A 不断总结 , 才 xs t S E T S R N ME 优化需要我们在生产 中不断学习 , E FROM T F W HE TY C D =05 ' S AF E R CI 能更为得心应手 的应用到工作中去。 O E ' 1 4 3 O N操作符 . N TI 2 此操作是 强列不推荐使用 的 , 因为它不能
的 ,因为索引是不索引空值的。使用 I N L SU 或 I O U ,r l会停止使用 索引而执 SN TN L Oa e c 行 全表扫描。 以考虑在设计表时 , 引列设 可 对索 置为 N T N L 。这样就可以用其他操作来取 O U L 代 判断 N L 的操作。 UL
_
b .同一功能 同一性能 不同写法 S QL的影 响。 如一个 S L在 A程序员写的为 slc S Q eetU— e a ,s d f m s fB程序员写 的为 s—  ̄nme e r t u o a e le s r n meu e i f m zj s ( e t u e a . s r d r h .a 带表所有 o st f 者的前缀 )c程序员写的为 Sl tu rn n, e c s_s e e e z u ser i f m Z J . A F ( 写表名 )D程序 d r HS T F 大 o S 员 写 的 为 Slc srnme sri f m e et e_a , e_d r u u o z SS A F 中间多 了空格 )以上 四个 S L在 Ⅲ . F( T Q OAL R C E分析整理之后产生的结果及执行的时
oracle之使用OracleDeveloper对SQL进行简单调优(二)
oracle 之使⽤OracleDeveloper 对SQL 进⾏简单调优(⼆)使⽤Oracle Developer 对SQL 进⾏简单进⾏简单调优调优Oracle Developer 是Oracle 提供的免费数据库连接⼯具,⾏内数据中⼼⽣产操作间默认使⽤该⼯具执⾏SQL ,如遇到现场需要对⽣产SQL 进⾏优化查询的需要熟悉Oracle Developer 的基本使⽤,本⽂结合Oracle Developer ⼯具展⽰如何查看SQL ,如果进⾏基本优化。
⼀、 Oracle Developer 和 Oracle 命令1. Oracle DeveloperSQL 解释Oracle Developer ⼯具⾥⾯的“解释”功能只针对当前的sql 进⾏了⼀个预估的资源消耗以及执⾏路径,参考数据是系统⾥存在的表统计信息。
结果显⽰与实际执⾏可能存在差异,且表的详细信息,在其它功能下显⽰更为详细。
SQL 优化指导Oracle Developer ⼯具⾥⾯的sql 优化指导功能,对要优化分析的sql 进⾏了真实的执⾏,该功能展⽰的结果,包含了部分解释功能的结果,也就是根据表⾥⾯的统计信息预估的执⾏计划;它⼀般还包含优化建议;另外还展⽰了该sql 的实际执⾏计划和并⾏执⾏时的sql 性能结果。
SQL 跟踪Oracle Developer ⼯具⾥⾯的sql 跟踪功能,对要优化分析的sql 进⾏了实际的执⾏,详细的展⽰了执⾏过程中对 索引 CPU 缓存IO 和块的改变情况,也列出了执⾏过程中涉及的数据量和资源消耗;此功能包含了sql 解释中的表统计信息。
2. Oracle 命令autotraceOracle 命令 autotrace 是分析sql 的真实执⾏计划,查看sql 执⾏效率的⼀个⽐较简单⼜⽅便的⼯具。
它实际上是对sql 实际执⾏过程信息的⼀个收集和信息统计。
set autotrace on 开启autotrace ,后⾯执⾏sql 语句会⾃动显⽰sql 执⾏结果和跟踪信息。
oracle sql 优化技巧
oracle sql 优化技巧(实用版3篇)目录(篇1)1.Oracle SQL 简介2.优化技巧2.1 减少访问数据库次数2.2 选择最有效率的表名顺序2.3 避免使用 SELECT2.4 利用 DECODE 函数2.5 设置 ARRAYSIZE 参数2.6 使用 TRUNCATE 替代 DELETE2.7 多使用 COMMIT 命令2.8 合理使用索引正文(篇1)Oracle SQL 是一款广泛应用于各类大、中、小微机环境的高效、可靠的关系数据库管理系统。
为了提高 Oracle SQL 的性能,本文将为您介绍一些优化技巧。
首先,减少访问数据库的次数是最基本的优化方法。
Oracle 在内部执行了许多工作,如解析 SQL 语句、估算索引的利用率、读数据块等,这些都会大量耗费 Oracle 数据库的运行。
因此,尽量减少访问数据库的次数,可以有效提高系统性能。
其次,选择最有效率的表名顺序也可以明显提升 Oracle 的性能。
Oracle 解析器是按照从右到左的顺序处理 FROM 子句中的表名,因此,合理安排表名顺序,可以减少解析时间,提高查询效率。
在执行 SELECT 子句时,应尽量避免使用,因为 Oracle 在解析的过程中,会将依次转换成列名,这是通过查询数据字典完成的,耗费时间较长。
DECODE 函数也是一个很好的优化工具,它可以避免重复扫描相同记录,或者重复连接相同的表,提高查询效率。
在 SQLPlus 和 SQLForms 以及 ProC 中,可以重新设置 ARRAYSIZE 参数。
该参数可以明显增加每次数据库访问时的检索数据量,从而提高系统性能。
建议将该参数设置为 200。
当需要删除数据时,尽量使用 TRUNCATE 语句替代 DELETE 语句。
执行 TRUNCATE 命令时,回滚段不会存放任何可被恢复的信息,所有数据不能被恢复。
因此,TRUNCATE 命令执行时间短,且资源消耗少。
在使用 Oracle 时,尽量多使用 COMMIT 命令。
Oracle培训之:sql优化--

13
在SQLPLUS 配置AUTOTRACE
AUTOTRACE 参数
SET AUTOTRACE OFF SET AUTOTRACE ON EXPLAIN SET AUTOTRACE ON STATISTICS SET AUTOTRACE ON SET AUTOTRACE TRACEONLY
解
释
不能获得AUTOTRACE报告. 这是默认的. 仅仅显示优化器执行计划的AUTOTRACE 报告 仅仅显示SQL语句执行的统计结果的 AUTOTRACE报告 包括上面两项内容的AUTOTRACE报告 与SET AUTOTRACE ON类似,所有的统计 和数据都在,但不可以打印
23
第五章:SQL重编译问题
SQL共享原理 SQL共享的三个条件 PROC程序的SQL共享 PROC程序中以下类型的语句不需进行变量 绑定 • PROC程序的CLIENT参数 • 存储过程的SQL共享 • SQL共享的数据库参数的利弊
24
• • • •
SQL共享原理
• ORACLE将执行过的SQL语句存放在内存 的共享池(shared buffer pool)中,可以被所 有的数据库用户共享 • 当你执行一个SQL语句(有时被称为一个游 标)时,如果它和之前的执行过的语句完全相 同, ORACLE就能很快获得已经被解析的语 句以及最好的 执行路径. 这个功能大大地提 高了SQL的执行性能并节省了内存的使用
查找原因的步骤(四)
• 是否为表和相关的索引搜集足够的统计数 据。对数据经常有增、删、改的表最好定 期对表和索引进行分析,可用SQL语句 “analyze table xxxx compute statistics for all indexes;”。ORACLE掌握了充分反映实 际的统计数据,才有可能做出正确的选择 • 索引列的选择性不高 (字段值重复率高)
优化SQL对ORACLE数据库性能的提高
3科技资讯科技资讯S I N &T NOLOGY I NFO RM TI ON 2008NO .28SC I EN CE &TECH NO LOG Y I N FOR M A TI O N 信息技术大多数情况下,系统运行缓慢不是由于所有部件都饱和引起的,而是由于系统中的某个部分限制了整体的性能,这部分称为瓶颈。
通常影响ORA CL E 数据库性能指标的三个瓶颈主要是:CP U 、内存、I /O 。
数据库性能的优化主要是or a c l e 数据库参数的调整、磁盘I /O 调整、应用程序S QL语句分析及设计、网络性能调整等。
本文主要通过优化S QL 语句来提高ORACL E 数据库的性能。
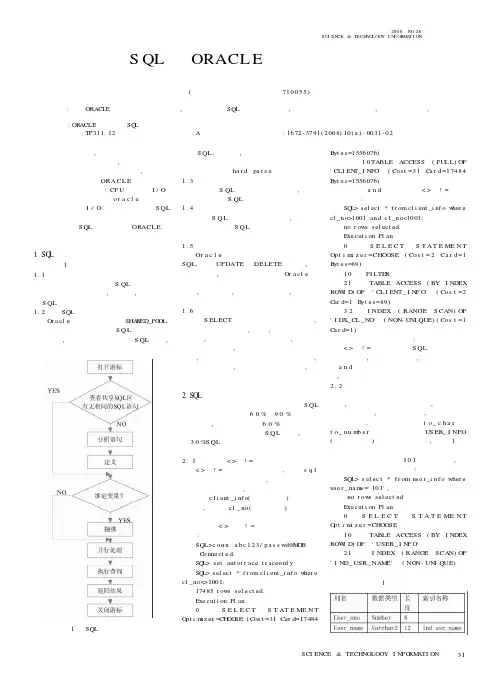
1SQ L 语句处理流程如图1所示。
1.1打开游标从上图可以看出处理S QL 语句的第一步就是要打开一个游标,事实上,一个完整的S QL 处理过程就是一个游标的生命周期。
1.2共享SQLOr a cl e 内存中有一个区叫SHA R ED _PO OL ,这个区的主要作用就是将S Q L 语句存放在这个区内,当客户发出一个新的S QL 语句,数据库引擎首先会到这个区查找是否有相同的S QL ,如果有,则避免了解析、分析索引、制定执行计划等一系列的动作。
如果没有则需要进行ha r d pa r s e 。
1.3绑定变量如果在S QL 中指定了绑定变量,需要在这个阶段给S QL 附上绑定变量的值。
1.4并行处理如果S Q L 需要进行并行处理,在这一阶段需要把整个S Q L 分割成多个并行的部分。
1.5执行查询Or a c l e 按照执行计划指定的方式执行SQL,执行UPDATE 和DE LE TE 语句时,必须将行锁定,以免其他用户修改。
Or a cl e 先从数据库缓冲区中寻找是否存在所要的数据块,如果存在,就直接读或修改,否则从物理文件中读到数据库缓冲区中。
1.6返回结果对S EL ECT 语句需要返回结果的语句,首先看是否需要排序,需要,则排序后返回给用户,然后根据内存的大小不同,可以一次取出一行数据,也可以一次取一组数据。
ora3_4
20
思考如下问题
• Pub(pubname,pub_key,…) • Book(pub_key,book_type,….)
要求统计每个出版社所出计算机类和小说 类的图书的总数
21
• Select pub_name publisher_name, sum(decode(book_type,'computer',1,0)) computer, sum(decode(book_type,'fiction',1,0)) fiction, from publisher p, book b where p.pub_key = b.pub_key group by pub_name
B、Sessions级别 通过SQL> ALTER SESSION SET OPTIMIZER_MODE=<Mode>;来设定。
6
• C、语句级别
这些需要用到Hint,比如: SQL> SELECT /*+ RULE */ erid, 2 , 3 b.depart_name 4 FROM tf_f_yhda a, 5 tf_f_depart b 6 WHERE erid=erid;
优化器的优化模式(Optermizer Mode)
• 优化模式包括Rule,Choose,First rows,All rows这四种方 式,也就是我们以上所提及的。如下解释一下: Rule:不用多说,即走基于规则的方式。 Choose:这是我们应观注的,默认的情况下Oracle用的便 是这种方式。指的是当一个表或或索引有统计信息,则 走CBO的方式,如果表或索引没统计信息,表又不是特别 的小,而且相应的列有索引时,那么就走索引,走RBO的 方式。 First Rows:它与Choose方式是类似的,所不同的是当一 个表有统计信息时,它将是以最快的方式返回查询的最 先的几行,从总体上减少了响应时间。 All Rows:也就是我们所说的Cost的方式,当一个表有统 计信息时,它将以最快的方式返回表的所有的行,从总体 上提高查询的吞吐量。没有统计信息则走基于规则的 方式。
确保Oracle数据库sql语句高效执行的优化总结(二)
【接确保Oracle数据库sql语句高效执行的优化总结(一)】2.4 10053和10046事件2.4.1 10053事件我们在查看一条SQL的执行计划的时候,只能看到CBO 最终告诉我们的执行计划结果,但是不知道CBO 是根据什么来做的。
如果遇到了执行计划失真,如:一个SQL语句,很明显oracle应该使用索引,但是执行计划却没有使用索引。
无法进行分析判断。
10053事件就提供了这样的功能。
它产生的trace文件提供了Oracle如何选择执行计划,为什么会得到这样的执行计划信息。
对于10053事件的trace文件,我们只能直接阅读原始的trace文件,不能使用tkprof工具来处理,tkprof工具只能用来处理sql_trace 和10046事件产生的trace文件。
10053事件有两个级别:Level2:2级是1级的一个子集,它包含以下内容:Column statisticsSingle Access PathsJoin CostsTable Joins ConsideredJoin Methods Considered (NL/MS/HA)Level1:1级比2级更详细,它包含2级的所有内容,在加如下内容:Parameters used by the optimizerIndex statistics启用10053事件:关闭10053事件:说明:(1)sqlplus中打开autotrace看到的执行计划实际上是用explain plan 命令得到的,explain plan 命令不会进行bind peeking。
应该通过v$sql_plan查看SQL的真实的执行计划。
(2)10053只对CBO有效,而且如果一个sql语句已经解析过,就不会产生新的trace信息。
2.4.2 10046事件10046 事件主要用来跟踪SQL语句,它并不是ORACLE 官方提供给用户的命令,在官方文档上也找不到事件的说明信息。
第09章Oracle的性能优化
9.2 SQL语句的优化
9.2.1 SQL语句的优化规则 9.2.2 SQL语句优化的具体方法
9.2.1 SQL语句的优化规则
(1)去掉不必要的大表、全表扫描。不必要的大表、全表 扫描会造成不必要的输入输出,而且还会拖垮整个数据库;
(2)检查优化索引的使用 这对于提高查询速度来说非常重 要;
(3)检查子查询,考虑SQL子查询是否可以用简单连接的 方式进行重新书写;
系统的服务器,可以使用sar –u命令查看CPU的使用率;NT 操作系统的服务器,可以使用NT的性能管理器来查看CPU 的使用率。
出现CPU资源不足的情况是很多的:SQL语句的重解析、 低效率的SQL语句、锁冲突都会引起CPU资源不足。
2.查看SQL语句的解析情况 (1)数据库管理员可以执行下述语句来查看SQL语句的解析 情况:
9.3 Oracle运行环境的优化
9.3.1 内存结构的调整 9.3.2 物理I/O的调整 9.3.3 CPU的优化调整 9.3.4 网络配置的优化 9.3.5 Oracle碎片整理 9.3.6 Oracle系统参数的调整
9.3.1 内存结构的调整
内存参数的调整主要是指Oracle数据库的系统全局区 (SGA)的调整。SGA主要由三部分构成:共享池、数 据缓冲区、日志缓冲区。
2.数据缓冲区 数据库管理员可以通过下述语句,来查看数据库数据缓冲区
的使用情况。
SELECT name, FROM v$sysstat WHERE name IN ('db block gets','consistent gets','physical reads');
根据查询出来的结果可以计算出数据缓冲区的使用命中率:
oracleSQL优化培训(精华整理)PPT课件
| 0 | SELECT STATEMENT |
| 1 | 26 | 4 (25)| 00:00:01 |
| 1 | SORT AGGREGATE |
| 1 | 26 |
|
|
| 2 | NESTED LOOPS |
| 1 | 26 | 4 (25)| 00:00:01 |
| 3 | VIEW
| VW_NSO_1 | 199 | 2587 | 2 (0)| 00:00:01 |
理解表的连接
HASH JOIN:1
---------------------------------------------------------
----------
| Id | Operation
开发人员应具备的优化能力
•能写好SQL,不犯低级错误。 •能创建高效索引。 •理解应用对表中数据的读取方式。 •理解索引对性能的重要意义。 •能理解常见的执行计划。 •可进行适当的调优。 •具备优化意识,开发中能兼顾性能。
SQL编写中的低级错误
• 对列进行运算 • 对列使用函数 • 数据类型不一致导致列发生隐式转化 • 使用*查询所有字段,包含了业务不需要的字段 • 进行不必要的排序 • union 可用 union all 替换 • 使用不必要的distinct
使用多少内存?消耗多少CPU? • 若SQL的执行效率不符合预期,有能力对其进行
优化吗?
执行计划
•执行计划:优化器制定的SQL的执行步骤。 •同一个SQL,可以有多个执行计划,要选取最优的那个。 •查询优化的目标:就是让优化器为SQL尽量生成最优的执行计划,使查 询的总开销(IO、CPU、网络传输等)最小。 •set autotrace、explain plan、dbms_xplan等。 •PL/SQL developer 中 使用F5快捷键