
门限向量自回归 matlab
门限向量自回归 matlab
门限向量自回归(TVAR)是一种时间序列模型,它结合了门限向量自回归(TAR)模型和向量自回归(VAR)模型的特点。
在MATLAB中,你可以使用一些工具箱来实现门限向量自回归模型的建模和分析。
首先,你可以使用MATLAB中的Time Series Toolbox来处理时间序列数据。
你可以使用该工具箱中的函数来加载数据、进行预处理、拟合模型和进行预测。
其次,MATLAB中的Econometrics Toolbox也提供了一些函数来处理向量自回归模型。
你可以使用这些函数来估计VAR模型的参数、进行模型诊断和进行预测。
对于门限向量自回归模型,你可能需要自己实现算法或者寻找第三方工具箱。
你可以在MATLAB的File Exchange中搜索是否有其他用户分享了相关的工具箱或者代码。
在实现TVAR模型时,你需要考虑模型的参数估计、模型的诊断和模型的预测等方面。
你可以参考相关的文献和教程,结合MATLAB
中的函数来完成这些任务。
总之,在MATLAB中实现门限向量自回归模型需要结合时间序列工具箱和计量经济工具箱的函数,可能需要自己实现算法或者寻找第三方工具箱的支持。
希望这些信息对你有所帮助。
matlab 多元回归 约束条件
matlab 多元回归约束条件
在MATLAB中进行多元回归分析时,有时候需要加入约束条件来
限制模型的参数或者变量之间的关系。
一种常见的约束条件是参数
之间的线性关系,也就是参数之间存在某种固定的比例关系。
另一
种常见的约束条件是变量之间的关系,比如变量之间的和为常数等。
在MATLAB中,可以使用一些内置的函数和工具箱来实现多元回归分
析中的约束条件。
对于参数之间的线性关系的约束条件,可以使用MATLAB中的fmincon函数来实现。
fmincon是一个用于求解带有约束条件的最优
化问题的函数,可以通过设置约束条件来限制参数之间的关系。
具
体来说,可以通过设置线性等式约束来实现参数之间的线性关系约束。
另外,如果需要对变量之间的关系进行约束,可以使用MATLAB
中的linprog函数来实现。
linprog是一个线性规划求解器,可以
用来求解线性约束条件下的最优化问题。
通过设置线性等式约束或
者线性不等式约束,可以限制变量之间的关系,比如限制它们的和
为常数等。
除了使用内置函数,MATLAB还有一些优化工具箱,比如Optimization Toolbox和Global Optimization Toolbox,这些工具箱提供了更多高级的优化算法和工具,可以更灵活地处理多元回归分析中的约束条件。
总的来说,在MATLAB中进行多元回归分析时,可以通过内置函数和工具箱来实现约束条件,包括参数之间的线性关系约束和变量之间的关系约束。
通过合理设置约束条件,可以更准确地建立多元回归模型,从而更好地分析和预测数据。
Matlab实现多元的回归实例
Matlab 实现多元回归实例(一)一般多元回归一般在生产实践和科学研究中,人们得到了参数(),,n x x x =⋅⋅⋅1和因变量y 的数据,需要求出关系式()y f x =,这时就可以用到回归分析的方法。
如果只考虑f 是线性函数的情形,当自变量只有一个时,即,(),,n x x x =⋅⋅⋅1中n =1时,称为一元线性回归,当自变量有多个时,即,(),,n x x x =⋅⋅⋅1中n ≥2时,称为多元线性回归。
进行线性回归时,有4个基本假定: ① 因变量与自变量之间存在线性关系; ② 残差是独立的; ③ 残差满足方差奇性; ④ 残差满足正态分布。
在Matlab 软件包中有一个做一般多元回归分析的命令regeress ,调用格式如下:[b, bint, r, rint, stats] = regress(y,X,alpha) 或者[b, bint, r, rint, stats] = regress(y,X) 此时,默认alpha = 0.05. 这里,y 是一个1n ⨯的列向量,X 是一个()1n m ⨯+的矩阵,其中第一列是全1向量(这一点对于回归来说很重要,这一个全1列向量对应回归方程的常数项),一般情况下,需要人工造一个全1列向量。
回归方程具有如下形式:011m m y x x λλλε=++⋅⋅⋅++其中,ε是残差。
在返回项[b,bint,r,rint,stats]中, ①01m b λλλ=⋅⋅⋅是回归方程的系数;②int b 是一个2m ⨯矩阵,它的第i 行表示i λ的(1-alpha)置信区间; ③r 是1n ⨯的残差列向量;④int r 是2n ⨯矩阵,它的第i 行表示第i 个残差i r 的(1-alpha)置信区间; 注释:残差与残差区间杠杆图,最好在0点线附近比较均匀的分布,而不呈现一定的规律性,如果是这样,就说明回归分析做得比较理想。
⑤ 一般的,stast 返回4个值:2R 值、F_检验值、阈值f ,与显著性概率相关的p 值(如果这个p 值不存在,则,只输出前3项)。
matlab回归(拟合)总结(一元、多元)
matlab 回归(拟合)总结前言1、学三条命令polyfit(x,y,n)---拟合成一元幂函数(一元多次) regress(y,x)----可以多元,nlinfit(x,y,’fun ’,beta0) (可用于任何类型的函数,任意多元函数,应用范围最主,最万能的)2、同一个问题,这三条命令都可以使用,但结果肯定是不同的,因为拟合的近似结果,没有唯一的标准的答案。
相当于咨询多个专家。
3、回归的操作步骤:根据图形(实际点),选配一条恰当的函数形式(类型)---需要数学理论与基础和经验。
(并写出该函数表达式的一般形式,含待定系数)------选用某条回归命令求出所有的待定系数。
所以可以说,回归就是求待定系数的过程(需确定函数的形式)一、回归命令一元多次拟合polyfit(x,y,n);一元回归polyfit;多元回归regress---nlinfit(非线性)二、多元回归分析对于多元线性回归模型(其实可以是非线性,它通用性极高): e x x y pp ++++=βββ 110设变量12,,,p x x x y 的n 组观测值为12(,,,)1,2,,i i ip i x x x y i n =记 ⎪⎪⎪⎪⎪⎭⎫⎝⎛=np n n p p x x x x x x x x x x 212222111211111,⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=n y y y y 21,则⎪⎪⎪⎪⎪⎭⎫⎝⎛=p ββββ 10 的估计值为排列方式与线性代数中的线性方程组相同(),拟合成多元函数---regress使用格式:左边用b=[b, bint, r, rint, stats]右边用=regress(y, x)或regress(y, x, alpha) ---命令中是先y 后x,---须构造好矩阵x(x 中的每列与目标函数的一项对应) ---并且x 要在最前面额外添加全1列/对应于常数项---y 必须是列向量---结果是从常数项开始---与polyfit 的不同。
向量自回归模型
诊断主要是对模型残差进行一系列检验, 如果诊断结果表明模型存在问题,需要
以判断模型是否充分拟合了数据,是否 对模型进行修正或重新设定,以确保模
存在异常值或违反模型假设的情况。常
型的准确性和可靠性。
见的诊断方法包括残差诊断、正态性检
验、异方差性检验等。
03
向量自回归模型的实现
向量自回归模型的编程语言实现
诊断与修正困难
向量自回归模型在诊断和修正模型中的问题时较为复杂,需要较高 的统计技巧和经验。
对数据要求高
向量自回归模型要求数据具有平稳性,对于非平稳数据需要进行差分 或其他处理,可能会影响模型的准确性和稳定性。
向量自回归模型的发展趋势与未来展望
改进估计方法
针对向量自回归模型参数过多的问题,未来研究可以探索更加有 效的参数估计方法,提高模型的泛化能力。
能够更好地捕捉时间序列数据的长期趋势和稳定性。
解释性强
02
向量自回归模型能够清晰地揭示多个变量之间的相互影响关系,
有助于理解经济现象之间的内在联系。
适用范围广
03
向量自回归模型适用于多种类型的数据,包括平稳和非平稳时
间序列数据。
向量自回归模型的缺点
参数过多
向量自回归模型需要估计的参数数量较多,容易产生过拟合问题, 导致模型泛化能力下降。
极端天气事件预测
通过向量自回归模型预测极端天气事件的发生, 如暴雨、洪涝、干旱等,有助于减轻灾害损失。
3
气候变化对生态系统的影响
利用向量自回归模型分析气候变化对生态系统的 影响,如植被分布、物种多样性和生态平衡等。
向量自回归模型在社会科学领域的应用
经济发展预测
通过分析历史经济发展数据,利用向量自回归模型预测未来经济 发展趋势,为政策制定提供依据。
matlab多元逻辑回归

在MATLAB中执行多元逻辑回归可以使用统计和机器学习工具箱中的`mnrfit`函数。
多元逻辑回归通常用于处理分类问题,其中目标变量是多类别的。
以下是执行多元逻辑回归的一般步骤:
1. 准备数据:首先,您需要准备包含特征(自变量)和目标(因变量)的数据。
确保数据已经被正确编码,特征和目标都是数值型或分类型变量。
2. 调用`mnrfit`函数:使用以下语法调用`mnrfit`函数进行多元逻辑回归:
```matlab
B = mnrfit(X, Y, 'model', 'logit');
```
其中:
- `X`是包含特征的矩阵,每一行代表一个观察样本,每一列代表一个特征。
- `Y`是包含目标变量的矩阵,每一行代表一个观察样本,每一列代表不同的类别。
3. 分析结果:`mnrfit`函数将返回一个包含回归系数的向量`B`,这些系数表示特征对于各个类别的影响。
您可以使用这些系数来进行预测和分类。
4. 预测:使用`mnrval`函数来进行预测。
例如:
```matlab
Yhat = mnrval(B, X_new);
```
其中`X_new`是包含新观察样本的特征的矩阵,`Yhat`将包含对新样本的预测。
请注意,这只是一个基本的多元逻辑回归示例。
根据您的数据和具体需求,您可能需要进一步处理数据、评估模型的性能和进行调优。
MATLAB还提供了丰富的工具和函数来支持数据分析和机器学习任务,您可以根据需要深入学习这些内容。
Matlab线性回归(拟合)
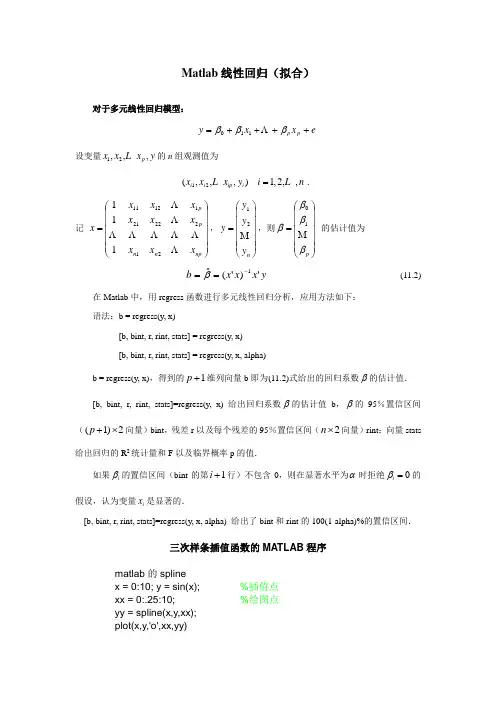
Matlab 线性回归(拟合)对于多元线性回归模型:e x x y p p ++++=βββΛ110设变量12,,,p x x x y L 的n 组观测值为12(,,,)1,2,,i i ip i x x x y i n =L L .记 ⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=np n n p p x x x x x x x x x x ΛΛΛΛΛΛΛΛ212222*********,⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=n y y y y M 21,则⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=p ββββM 10 的估计值为 y x x x b ')'(ˆ1-==β(11.2) 在Matlab 中,用regress 函数进行多元线性回归分析,应用方法如下:语法:b = regress(y, x)[b, bint, r, rint, stats] = regress(y, x)[b, bint, r, rint, stats] = regress(y, x, alpha)b = regress(y, x),得到的1+p 维列向量b 即为(11.2)式给出的回归系数β的估计值.[b, bint, r, rint, stats]=regress(y, x) 给出回归系数β的估计值b ,β的95%置信区间((1)2p +⨯向量)bint ,残差r 以及每个残差的95%置信区间(2⨯n 向量)rint ;向量stats 给出回归的R 2统计量和F 以及临界概率p 的值.如果i β的置信区间(bint 的第1i +行)不包含0,则在显著水平为α时拒绝0i β=的假设,认为变量i x 是显著的.[b, bint, r, rint, stats]=regress(y, x, alpha) 给出了bint 和rint 的100(1-alpha)%的置信区间.三次样条插值函数的MATLAB 程序matlab 的splinex = 0:10; y = sin(x); %插值点xx = 0:.25:10; %绘图点yy = spline(x,y,xx);plot(x,y,'o',xx,yy)非线性拟合非线性拟合可以用以下命令(同样适用于线形回归分析):1.beta = nlinfit(X,y,fun,beta0)X给定的自变量数据,Y给定的因变量数据,fun要拟合的函数模型(句柄函数或者内联函数形式),beta0函数模型中系数估计初值,beta返回拟合后的系数2.x = lsqcurvefit(fun,x0,xdata,ydata)fun要拟合的目标函数,x0目标函数中的系数估计初值,xdata自变量数据,ydata 函数值数据X拟合返回的系数(拟合结果)nlinfit格式:[beta,r,J]=nlinfit(x,y,’model’, beta0)Beta 估计出的回归系数r 残差J Jacobian矩阵x,y 输入数据x、y分别为n*m矩阵和n维列向量,对一元非线性回归,x为n维列向量。
利用Matlab进行线性回归分析
利用M a t l a b进行线性回归分析(总2页)--本页仅作为文档封面,使用时请直接删除即可----内页可以根据需求调整合适字体及大小--利用Matlab进行线性回归分析回归分析是处理两个及两个以上变量间线性依存关系的统计方法。
可以通过软件Matlab实现。
1.利用Matlab软件实现在Matlab中,可以直接调用命令实现回归分析,(1)[b,bint,r,rint,stats]=regress(y,x),其中b是回归方程中的参数估计值,bint是b的置信区间,r和rint分别表示残差及残差对应的置信区间。
stats包含三个数字,分别是相关系数,F统计量及对应的概率p值。
(2)recplot(r,rint)作残差分析图。
(3)rstool(x,y)一种交互式方式的句柄命令。
以下通过具体的例子来说明。
例现有多个样本的因变量和自变量的数据,下面我们利用Matlab,通过回归分析建立两者之间的回归方程。
% 一元回归分析x=[1097 1284 1502 1394 1303 1555 1917 2051 2111 2286 2311 2003 2435 2625 2948 3, 55 3372];%自变量序列数据y=[698 872 988 807 738 1025 1316 1539 1561 1765 1762 1960 1902 2013 2446 2736 2825];%因变量序列数据X=[ones(size(x')),x'],pause[b,bint,r,rint,stats]=regress(y',X,,pause%调用一元回归分析函数rcoplot(r,rint)%画出在置信度区间下误差分布。
% 多元回归分析% 输入各种自变量数据x1=[ 8 3 3 8 9 4 5 6 5 8 6 4 7]';x2=[31 55 67 50 38 71 30 56 42 73 60 44 50 39 55 7040 50 62 59]'; x3=[10 8 12 7 8 12 12 5 8 5 11 12 6 10 10 6 11 11 9 9]';x4=[8 6 9 16 15 17 8 10 4 16 7 12 6 4 4 14 6 8 13 11]';%输入因变量数据y=[ 160 155 195]';X=[ones(size(x1)),x1,x2,x3,x4];[b,bint,r,rint,stats]=regress(y,X)%回归分析Q=r'*rsigma=Q/18rcoplot(r,rint);%逐步回归X1=[x1,x2,x3,x4];stepwise(X1,y,[1,2,3])%逐步回归% X2=[ones(size(x1)),x2,x3];% X3=[ones(size(x1)),x1,x2,x3];% X4=[ones(size(x1)),x2,x3,x4];% [b1,b1int,r1,r1int,stats1]=regress(y,X2)% [b2,b2int,r2,r2int,stats2]=regress(y,X3);% [b3,b3int,r3,r3int,stats3]=regress(y,X4);。
matlab 逻辑回归多元
matlab 逻辑回归多元Matlab逻辑回归多元逻辑回归是一种常用的分类算法,在许多实际应用中得到广泛应用。
而多元逻辑回归则是逻辑回归的一种扩展,用于处理多个自变量的分类问题。
本文将以Matlab为工具,详细介绍多元逻辑回归的原理和实现步骤。
一、多元逻辑回归原理多元逻辑回归是逻辑回归的扩展,适用于有多个自变量的分类问题。
逻辑回归通过对输入特征的线性组合,然后经过一个非线性的sigmoid函数,将输出值转化为概率,进而进行分类。
多元逻辑回归的目标是找到最优的参数权重,使得分类结果最准确。
在多元逻辑回归中,我们需要先定义一个假设函数h(x),它将特征向量x 映射到预测的概率值。
假设函数的形式为:h_θ(x) = g(θ^Tx)其中,g(z)表示sigmoid函数,其形式为:g(z) = \frac{1}{1+e^{-z}}通过这个假设函数,我们可以得到样本x属于正例(1)的概率和负例(0)的概率分别为:P(y=1 x,θ) = h_θ(x)P(y=0 x,θ) = 1 - h_θ(x)多元逻辑回归的目标是最大化对数似然函数,即最大化所有样本的预测概率(或最小化其负对数)。
我们可以通过梯度下降或其他优化算法来求解最优的参数权重θ。
二、使用Matlab实现多元逻辑回归在Matlab中,可以使用统计和机器学习工具箱提供的函数来实现多元逻辑回归。
下面将一步一步介绍如何在Matlab中使用多元逻辑回归算法来解决分类问题。
# 1.数据准备首先,我们需要准备用于训练和测试的数据。
假设我们有一个包含多个特征的数据集,其中每个样本都有相应的标签(正例或负例)。
我们可以选择将数据拆分为训练集和测试集,通常采用70的数据用于训练,30的数据用于测试。
# 2.参数初始化接下来,我们需要初始化参数权重θ。
在多元逻辑回归中,θ是一个向量,长度为特征数量加1。
我们可以将所有θ初始化为0,或者随机初始化。
# 3.梯度下降求解在多元逻辑回归中,可以使用梯度下降算法来最小化损失函数。
在matlab中实现线性回归和logistic回归
在matlab中实现线性回归和logistic回归本⽂主要讲解在matlab中实现Linear Regression和Logistic Regression的代码,并不涉及公式推导。
具体的计算公式和推导,相关的机器学习⽂章和视频⼀⼤堆,推荐看Andrew NG的公开课。
⼀、线性回归(Linear Regression)⽅法⼀、利⽤公式 :function [ theta ] = linearReg()%线性回归。
X=[1 1;1 2;1 3;1 4]; %注意第⼀列全为1,即x0=1,第⼆列才为x1Y=[1.1;2.2;2.7;3.8];A=inv(X'*X);theta=A*X'*Y; %根据公式theta=(X'*X)^(-1)*X'*Y;end这种⽅法最简单,但是公式推导过程很复杂。
⽅法⼆:使⽤梯度下降法迭代function theta=linearRegression()% 梯度下降法寻找最合适的theta,使得J最⼩options=optimset('GradObj','on','MaxIter',100);inittheta=[1 1]';theta=fminunc(@costFunc,inittheta,options);end%%function [J,gradient]= costFunc(theta)%J为代价函数。
%y=theta(0)*x0+theta(1)*x1; 找出最好的theta来拟合曲线。
%使得J最⼩的theta就是最好的thetax=[1;2;3;4];y=[1.1;2.2;2.7;3.8];m=size(x,1);hypothesis=theta(1)+theta(2)*x;delta=hypothesis-y;J=sum(delta.^2)/(2*m);gradient(1)=sum(delta.*1)/m; %x0=1;gradient(2)=sum(delta.*x)/m;end这两种⽅法,都采⽤数据:x=[1;2;3;4];y=[1.1;2.2;2.7;3.8];当然,⽤的时候可以换成其它数据,两种⽅法得出的结果都是theta =0.30000.8600即可以学习到线性函数:Y=0.3000+0.8600*X;⼆、Logistic回归(Logistic Regression)⽅法⼀、利⽤matlab⾃带的函数glmfit() :function theta=logisticRegression()% logistic regression的参数theta,可以⽤matlab⾃带函数glmfit求出x = [0.0 0.1 0.7 1.0 1.1 1.3 1.4 1.7 2.1 2.2]';y = [0 0 1 0 0 0 1 1 1 1]';theta = glmfit(x, [y ones(10,1)], 'binomial', 'link', 'logit')end⽅法⼆:使⽤梯度下降法迭代function theta =logisticReg()% 梯度下降法寻找最合适的theta,使得代价函数J最⼩options=optimset('GradObj','on','MaxIter',100);inittheta=[0 0]';theta=fminunc(@costFunc,inittheta,options);end%%function [J,gradient] = costFunc(theta)x = [0.0 0.1 0.7 1.0 1.1 1.3 1.4 1.7 2.1 2.2]';y = [0 0 1 0 0 0 1 1 1 1]';m=size(x,1);tmp=theta(1)+theta(2)*x; %theta'xhypothesis=1./(1+exp(-tmp)); %logistic functiondelta=log(hypothesis+0.01).*y+(1-y).*log(1-hypothesis+0.01); %加上0.01是为了防⽌x为0 J=-sum(delta)/m;gradient(1)=sum(hypothesis-y)/m; %x0=1;gradient(2)=sum((hypothesis-y).*x)/m; %theta=theta-a*gradient; gradient=-J'(theta)end两种⽅法都使⽤数据:x = [0.0 0.1 0.7 1.0 1.1 1.3 1.4 1.7 2.1 2.2]';y = [0 0 1 0 0 0 1 1 1 1]';注意,Y的值只能取0和1两种。
matlab、lingo程序代码24-回归分析
回归分析MATLAB 工具箱一、多元线性回归多元线性回归:p p x x y βββ+++=...110 1、确定回归系数的点估计值: 命令为:b=regress(Y , X ) ①b 表示⎥⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎢⎣⎡=p b βββˆ...ˆˆ10②Y 表示⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡=n Y Y Y Y (2)1③X 表示⎥⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎢⎣⎡=np n n p p x x x x x xx x x X ...1..................1 (12)12222111211 2、求回归系数的点估计和区间估计、并检验回归模型:命令为:[b, bint,r,rint,stats]=regress(Y ,X,alpha) ①bint 表示回归系数的区间估计. ②r 表示残差. ③rint 表示置信区间. ④stats 表示用于检验回归模型的统计量,有三个数值:相关系数r 2、F 值、与F 对应的概率p.说明:相关系数2r 越接近1,说明回归方程越显著;)1,(1-->-k n k F F α时拒绝0H ,F 越大,说明回归方程越显著;与F 对应的概率p α<时拒绝H 0,回归模型成立. ⑤alpha 表示显著性水平(缺省时为0.05) 3、画出残差及其置信区间. 命令为:rcoplot(r,rint) 例1.如下程序. 解:(1)输入数据.x=[143 145 146 147 149 150 153 154 155 156 157 158 159 160 162 164]'; X=[ones(16,1) x];Y=[88 85 88 91 92 93 93 95 96 98 97 96 98 99 100 102]'; (2)回归分析及检验.[b,bint,r,rint,stats]=regress(Y ,X) b,bint,stats得结果:b = bint =-16.0730 -33.7071 1.5612 0.7194 0.6047 0.8340 stats =0.9282 180.9531 0.0000即7194.0ˆ,073.16ˆ10=-=ββ;0ˆβ的置信区间为[-33.7017,1.5612], 1ˆβ的置信区间为[0.6047,0.834]; r 2=0.9282, F=180.9531, p=0.0000,我们知道p<0.05就符合条件, 可知回归模型 y=-16.073+0.7194x 成立. (3)残差分析,作残差图. rcoplot(r,rint)从残差图可以看出,除第二个数据外,其余数据的残差离零点均较近,且残差的置信区间均包含零点,这说明回归模型 y=-16.073+0.7194x 能较好的符合原始数据,而第二个数据可视为异常点.(4)预测及作图.z=b(1)+b(2)*x plot(x,Y,'k+',x,z,'r')二、多项式回归 (一)一元多项式回归.1、一元多项式回归:1121...+-++++=m m m m a x a x a x a y(1)确定多项式系数的命令:[p,S]=polyfit(x,y,m)说明:x=(x 1,x 2,…,x n ),y=(y 1,y 2,…,y n );p=(a 1,a 2,…,a m+1)是多项式y=a 1x m +a 2x m-1+…+a m x+a m+1的系数;S 是一个矩阵,用来估计预测误差. (2)一元多项式回归命令:polytool(x,y,m) 2、预测和预测误差估计.(1)Y=polyval(p,x)求polyfit 所得的回归多项式在x 处的预测值Y ;(2)[Y,DELTA]=polyconf(p,x,S,alpha)求polyfit 所得的回归多项式在x 处的预测值Y 及预测值的显著性为1-alpha 的置信区间Y±DELTA ;alpha 缺省时为0.5.例 1. 观测物体降落的距离s 与时间t 的关系,得到数据如下表,求s. (关于t 的回归方程2解法一:直接作二次多项式回归. t=1/30:1/30:14/30;s=[11.86 15.67 20.60 26.69 33.71 41.93 51.13 61.49 72.90 85.44 99.08 113.77 129.54 146.48]; [p,S]=polyfit(t,s,2) 得回归模型为:1329.98896.652946.489ˆ2++=t t s解法二:化为多元线性回归. t=1/30:1/30:14/30;s=[11.86 15.67 20.60 26.69 33.71 41.93 51.13 61.49 72.90 85.44 99.08 113.77 129.54 146.48]; T=[ones(14,1) t' (t.^2)'];[b,bint,r,rint,stats]=regress(s',T); b,stats得回归模型为:22946.4898896.651329.9ˆt t s ++=预测及作图: Y=polyconf(p,t,S) plot(t,s,'k+',t,Y,'r')(二)多元二项式回归多元二项式回归命令:rstool(x,y,’model’, alpha )说明:x 表示n ⨯m 矩阵;Y 表示n 维列向量;alpha :显著性水平(缺省时为0.05);model 表示由下列4个模型中选择1个(用字符串输入,缺省时为线性模型):linear(线性):m m x x y βββ+++= 110purequadratic(纯二次):∑=++++=nj j jjm m x x x y 12110ββββinteraction(交叉):∑≤≠≤++++=mk j k j jkm m x x x x y 1110ββββquadratic(完全二次):∑≤≤++++=mk j k j jkm m x x x x y ,1110ββββ例1. 设某商品的需求量与消费者的平均收入、商品价格的统计数据如下,建立回归模型,预测平均收入为1000、价格为6时的商品需求量. 需求量 100 7580 70 50 65 90100 110 60 收入 1000 600 1200 500 300 400 13001100 1300 300解法一:选择纯二次模型,即2222211122110x x x x y βββββ++++=. 直接用多元二项式回归:x1=[1000 600 1200 500 300 400 1300 1100 1300 300]; x2=[5 7 6 6 8 7 5 4 3 9];y=[100 75 80 70 50 65 90 100 110 60]'; x=[x1' x2'];rstool(x,y,'purequadratic')在左边图形下方的方框中输入1000,右边图形下方的方框中输入6,则画面左边的“Predicted Y”下方的数据变为88.47981,即预测出平均收入为1000、价格为6时的商品需求量为88.4791. 在画面左下方的下拉式菜单中选”all”, 则beta 、rmse 和residuals 都传送到Matlab 工作区中. 在Matlab 工作区中输入命令:beta, rmse 得结果:beta =110.5313 0.1464 -26.5709 -0.0001 1.8475 rmse =4.5362故回归模型为:2221218475.10001.05709.261464.05313.110x x x x y +--+= 剩余标准差为4.5362, 说明此回归模型的显著性较好.解法二:将2222211122110x x x x y βββββ++++=化为多元线性回归: X=[ones(10,1) x1' x2' (x1.^2)' (x2.^2)']; [b,bint,r,rint,stats]=regress(y,X); b,stats结果为: b =110.5313 0.1464 -26.5709 -0.0001 1.8475 stats =0.9702 40.6656 0.0005三、非线性回归1、非线性回归:(1)确定回归系数的命令:[beta,r,J]=nlinfit(x,y,’model’, beta0)说明:beta 表示估计出的回归系数;r 表示残差;J 表示Jacobian 矩阵;x,y 表示输入数据x 、y 分别为矩阵和n 维列向量,对一元非线性回归,x 为n 维列向量;model 表示是事先用m-文件定义的非线性函数;beta0表示回归系数的初值. (2)非线性回归命令:nlintool(x,y,’model’, beta0,alpha) 2、预测和预测误差估计:[Y,DELTA]=nlpredci(’model’, x ,beta,r,J)表示nlinfit 或nlintool 所得的回归函数在x 处的预测值Y 及预测值的显著性为1-alpha 的置信区间Y±DELTA. 例1. 如下程序.解:(1)对将要拟合的非线性模型y=a x b e /,建立m-文件volum.m 如下:function yhat=volum(beta,x) yhat=beta(1)*exp(beta(2)./x); (2)输入数据: x=2:16;y=[6.42 8.20 9.58 9.5 9.7 10 9.93 9.99 10.49 10.59 10.60 10.80 10.60 10.90 10.76]; beta0=[8 2]'; (3)求回归系数:[beta,r ,J]=nlinfit(x',y','volum',beta0); beta (4)运行结果:beta =11.6036 -1.0641 即得回归模型为:xey 10641.16036.11-=(5)预测及作图:[YY ,delta]=nlpredci('volum',x',beta,r ,J); plot(x,y,'k+',x,YY,'r')四、逐步回归1、逐步回归的命令:stepwise(x,y,inmodel,alpha)说明:x 表示自变量数据,m n ⨯阶矩阵;y 表示因变量数据,1⨯n 阶矩阵;inmodel 表示矩阵的列数的指标,给出初始模型中包括的子集(缺省时设定为全部自变量);alpha 表示显著性水平(缺省时为0.5).2、运行stepwise 命令时产生三个图形窗口:Stepwise Plot,Stepwise Table,Stepwise History. 在Stepwise Plot 窗口,显示出各项的回归系数及其置信区间.(1)Stepwise Table 窗口中列出了一个统计表,包括回归系数及其置信区间,以及模型的统计量剩余标准差(RMSE)、相关系数(R-square)、F 值、与F 对应的概率P.例1. 水泥凝固时放出的热量y 与水泥中4种化学成分x1、x2、x3、 x4有关,今测得一组数据如下,试用逐步回归法确定一个线性模型.解:(1)数据输入:x1=[7 1 11 11 7 11 3 1 2 21 1 11 10]';x2=[26 29 56 31 52 55 71 31 54 47 40 66 68]';x3=[6 15 8 8 6 9 17 22 18 4 23 9 8]';x4=[60 52 20 47 33 22 6 44 22 26 34 12 12]';y=[78.5 74.3 104.3 87.6 95.9 109.2 102.7 72.5 93.1 115.9 83.8 113.3 109.4]'; x=[x1 x2 x3 x4];(2)逐步回归.①先在初始模型中取全部自变量:stepwise(x,y)得图Stepwise Plot 和表Stepwise Table.图Stepwise Plot中四条直线都是虚线,说明模型的显著性不好.从表Stepwise Table中看出变量x3和x4的显著性最差.②在图Stepwise Plot中点击直线3和直线4,移去变量x3和x4.移去变量x3和x4后模型具有显著性虽然剩余标准差(RMSE)没有太大的变化,但是统计量F的值明显增大,因此新的回归模型更好.(3)对变量y和x1、x2作线性回归.X=[ones(13,1) x1 x2];b=regress(y,X)得结果:b =52.57731.46830.6623故最终模型为:y=52.5773+1.4683x1+0.6623x2。