
lpc10原理和实现代码解析
在 matlab 中,也有 lpc 函数[a,g] = lpc(x,p)。其中,x 是输入序列,p 是阶数,a 是预测系数, g 是总预测误差。对于这些参数的理解,说明如下:
注意如下几点: ¾ 有效的参数是从 a(2)开始。a(1)默认为 1,是无用的; ¾ 上图中的 H 函数,和前面我们提到的 H 函数是不一致的。这个 H,是单纯线性预测的
* *packet: the encoded data; * * Return value: * int: the encoded data length; * */
整个程序应该比较简单,基本功能就是把 PCM 语音进行压缩,然后再解压缩为 PCM 语音, 最后对比一下效果。每次取出 2880 个 sample,进行处理,大概是 360ms 的数据。编码完成 后,再立即解码,并把解码的文件保存,用于对比音质效果。
p
e(n) = s(n) − ~s (n) = s(n) − ∑ ak s(n − k) k =1
p
∑ 对应的传递函数为: A(z) = 1 − ak z −k 。于是,LPC 的语音合成传递函数和误差传递函 k =1
数就走到一起去了: H (z) = G 。同时,e(n)也就成为了输入激励 Gu(n)。所以 A(z)也叫 A( z )
不能够覆盖到足以体现 pitch 周期的样本数量。也就是时域压缩,频域模糊。 ¾ 同时,LPC 传递函数的极点,其实就是频谱中的峰值点的体现。在阶数 p 的选择上,
和采样频率有关。人的语音基本上每 KHz 有 2 个极点(或一个复数极点)。这是 vocal tract 的贡献。这样,当采样频率为 Fs(KHz)时候,需要 Fs 个 pole 来表示语音频谱。另外, 还需要 3~4 个 pole 来表示源激励频谱和嘴巴辐射频谱,这样对于 10Khz 采样的语音,p 值为 13~14 个。对于 4KHz 语音的分析而言,通常需要显示的共振峰至少 4 个,也就是 说传递函数(或滤波器)的阶数至少 8 个。 ¾ 由于 LPC 传递函数没有零点,所以对频谱的波谷的模拟相对较差。
从 lpc10_encode_int 的处理来看,这个代码对输入有如下假设: ¾ 语音编码是 16 位编码。从对输入的归一化用 32768 就可以看出。16 位是 65536,考虑
正负效果,就是 32768。
3.1. analys 代码通读来自网上有很好的帮助,C 代码和 Matlab 都有,但是 matlab 说的详细些,并更好理解: C代码:/en/r/29046/HP100.C__html Matlab:/r/188813/analys.M__html 上面是两个例子。具体函数可以把函数名称替换就可以了。 Hcrypt.c: hcryptNewSalt:看起来和加密相关。对加密这一块目前还没有概念。其实可以先不 管。 VOX:语音激活检测。
下图是一段实际语音的残差信号。从中可以看出一些基本的周期性:
0.03 0.02 0.01
0 -0.01 -0.02 -0.03 -0.04
0
50
100
150
200
250
300
350
400
3. EnCode-lpc10
从/hawkvoice/上面,发现了一些语言codec的东西。下载下来居然能够编 译。于是想理解一下这些源码。代码量不大,但是几乎没有注释。真要命,也许我自己应该 添加注释。
M
∑ G(1 − bj z − j )
H(z) =
j =1 N
∑ 1 − ai z −i
i=1
理论上证明(我真的不知道如何证明的)如果分母的阶数够高,那么传递函数可以用全极点
函数表示:
∑ H (z) =
1−
G
N
ai z −i
=
G A( z )
i=1
通常我们都是取一小段语音来认为传递函数的参数 a(i)是不变的。问题是,这样的长度 N 到 底取多长? 一方面,N 越小,计算量也小,同时语音段的变化也越小。但是,如果期望用 lpc 的残差来 估算 pitch 周期的话,那么就意味着 N 至少要是 pitch 周期的若干倍才行。通常取 N 为 100~400 (10KHz 采样率)。
中间的数组有: ¾ 预加重 pebuf[540]。 ¾ 低通的数据 lpbuf,存放 696 个。为啥是 696 个?不明白。但是每次新的数据帧来的时
候,都是往前推 180 个数据。所以这里面其实存放了 4 个帧+156 个多的数据。为什么 lpbuf 要大些? ¾ Inverse Filtered speech (ivbuff)。总共 312 个字节。可是有效数据好像只有 131 个字节。 但每次来新数据的时候,原来 131 个数据都往前推 180 个位置。于是这样,好像最多是 存放了 2 帧的数据。否则,中间断开的垃圾数据就不好解释了。为什么 ivbuf 又要小些? 因为 ivbuff 中放的是 inverse filter 后的数据。而 inverse filter 的目的,是为了得到残差, 便于提取 pitch 周期。而为了这个目的,先对语音信号进行了 800Hz 的低通滤波,把高 频成分滤掉,这样原来的采样率 8K 或 10KHz 就没有意义了,完全可以降采样率后再 处理,减少计算量。ivbuf 是 312 个,因为 inverse filter 后 180 个值,而用于 ADMF 算 法时候,差值最大 156,而又只要计算 156 个点,所以 312 就够了。 ¾ Onset buffer。总共 10 个。当新数据来的时候,检查原来的 onset 是否已经被推出去。 并推到最前面去。 ¾ Voice decision buff,voibuf[8],存放了 4 帧的的 voice 判别数据,每帧分前后两部分。 ¾ VWin。是 voice 的判别窗口。物理含义还不是很明确。
HL_EXP int HL_APIENTRY hvdiPacketEncode /* Input Parameter:
* buflen: The length of input buffer; * *buffer: The input data sample; * paclen: The max output encoded data number; * *key, *state: the crypt paramter * * Output parameter:
对 analys 这个函数本身而言,它输入的是当前帧的语音数据。并且归一化到 1。 在 analys 代码中,相关的数据处理和数据结构如下: 输入数据:inbuf = &(st->inbuf[0]); 540 个 byte,共 3 帧数据;依照顺序存放。最新的放在最 后面。虽然输入的 speech 是-1~1 间的小数,但在进入这个 analys 程序时候,进行了放大, 目的是 speech 可以用 12 个 bit 来表示: inbuf[720 - LPC10_SAMPLES_PER_FRAME + i - 180] = speech[i] * 4096.f - bias;
Analys 的基本思路是: 用高通和预加重后的数据,来寻找 onset 的位置。Onset 的位置往后多加了 180 偏移,导致 后面使用要把此偏移去掉; 根据 onset 的位置来设置 vwin 的位置。Vwin 是用来干嘛的? 接下去是要来寻找 pitch 的周期。寻找 pitch 周期的方法是:用通过高通后的原始语音,再经 过低通,把 pitch 外的高频成分滤掉。然后用 ivfilt 进行反向滤波,找出残差信号。在对残差 信号进行 ADMF 算法,差值最大 156,最多算 156 个点,只需要 312 个值就够了。这样找 到 pitch 周期。注意:算法中 ivfilt 和 ADMF 算法并不是对当前帧进行处理,而是对历史上
对于一小段语音,可以认为传递函数的参数 a(i)是不变的。这样,语音就可以用这样一些参 数 a(i)和输入激励来表示。至于为什么用全极点,而不用包含零点的传递函数来预测?主要 是计算方便方面的原因。同时,极点可以代表语音频谱结构里面的峰值,也就是 formant 频 率,下面有解释。其实对于鼻音,他们在传递函数上体现为零点,所以全极点类型对这种语 音的代表是不完全的,尽管极点阶数高了,可以尽可能模拟零点。
理解到这来,LPC 合成语音已经没有问题了。就是找出预测系数,再用激励输入,就得到 输出语音了。可是,我们面对下一个问题:对于现成的语音,如何提取预测系数?
图解Windows 10平板电脑电路原理和维修
15 Windows 10二合一平板电脑电路分析
15.1 Windows 10二合一平板电脑硬 件组成
15.2 Windows 10二合一平板电脑架 构组成
15.3 Windows 10平板电脑的电源电 路
15.4 Windows 10平板电脑中的EC电 路和上电时序分析
15.5 Windows 10平板电脑CPU电路
4.2 CPU挂接/连 接的外部模块
4.3 CPU引脚信号 的说明
4.4 CPU的工作过 程
4.5 CPU电路的检 修
05
Part One
5 平板电脑的存储电路
5 平板电脑的存储电路
A
C
5.2 闪存 NAND电路
5.1 内存DDR 电路
5.3 串行闪存 电路
B
5.4 SSD固态 硬盘电路
D
01 5.1.1 DDR内存控
15.4.1 Windows 10平板电脑中的 EC电路
15.4.2 英特尔6、7、8、9系列芯 片组上电时序及信号解释
15 Windows 10二合一平板电脑电路分析
15.4 Windows 10平板电脑中的EC电路和上电时序分析
15 Windows 10二合一平板电脑电路分析
15.5.1 CPU供 电电路
制器
02 5.1.2 DDR内存的
内部结构
03 5.1.3 DDR电路连
接图
04
5.1.4 DDR芯片各 引脚符号说明及引
脚作用
05 5.1.5 DDR电路的
工作原理
5 平板电脑的存储电路
5.1 内存DDR电路
06 5.1.6 内存DDR电
路的检修
5.2.1 闪存控制器
LPC系列arm芯片
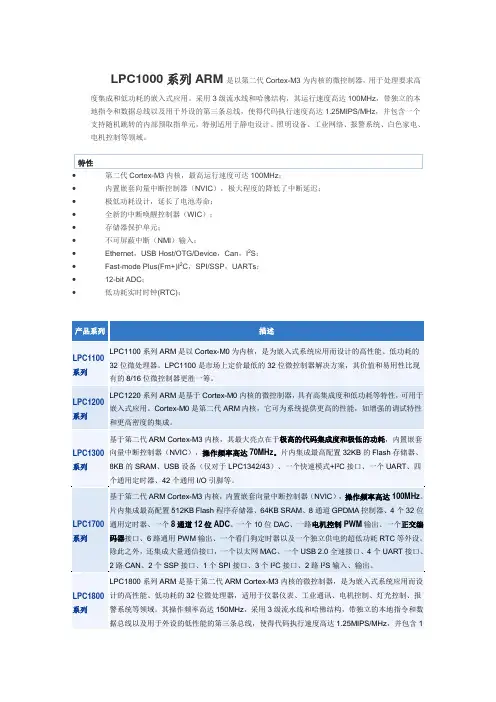
LPC1000系列ARM是以第二代Cortex-M3为内核的微控制器,用于处理要求高度集成和低功耗的嵌入式应用。
采用3级流水线和哈佛结构,其运行速度高达100MHz,带独立的本地指令和数据总线以及用于外设的第三条总线,使得代码执行速度高达1.25MIPS/MHz,并包含一个支持随机跳转的内部预取指单元,特别适用于静电设计、照明设备、工业网络、报警系统、白色家电、电机控制等领域。
特性•第二代Cortex-M3内核,最高运行速度可达100MHz;•内置嵌套向量中断控制器(NVIC),极大程度的降低了中断延迟;•极低功耗设计,延长了电池寿命;•全新的中断唤醒控制器(WIC);•存储器保护单元;•不可屏蔽中断(NMI)输入;•Ethernet,USB Host/OTG/Device,Can,I2S;•Fast-mode Plus(Fm+)I2C,SPI/SSP,UARTs;•12-bit ADC;•低功耗实时时钟(RTC);LPC1100L系列ARM采用Cortex-M0内核,是市场上定价最低的32位MCU解决方案,它的价值和易用性比现有的8位/16位微控制器更胜一筹。
LPC1100L系列ARM性能卓越、简单易用、功耗低,更重要的是,它能显著降低所有8位/16位应用的代码长度。
LPC1100L系列为那些寻求用可扩展ARM架构来执行整个产品开发过程的8位/16位用户提供无缝的整合需求。
这些MCU围绕着新的Cortex-M0架构建立,是开发以来最小巧、功耗最低且最有能效的ARM内核,为电池供电的消费类产品、智能电表、电机控制等应用提供理想的解决方案。
LPC1100L系列ARM每秒4500多万条指令的傲人性能让8位(每秒不到100万条指令)及16位(每秒300万到500万条指令)微控制器相形见绌;LPC1100L不仅能执行基本的控制任务,而且能进行复杂运算,即便最复杂的任务也能轻松应付。
执行效率的提高直接转化为能耗的降低,实现该性能水平的LPC1100L运行速度高达50MHz,其功耗也得到了很大程度的优化——仅需不到10mA的电流。
PLC的系统组成及其工作原理

PLC的系统组成CPU芯片1控制器、2运算器、3寄存器通过数据总线、地址总线、控制总线与存储器、输入/输出单元相连接按系统程序赋予的功能,系统程序、用户程序、用户数据先存入存储器,CPU按循环扫描方式执行用户程序CPU性能—1信息处理能力、2运算速度位数越高、性能越强(大多数位32位CPU)存储器1系统存储器2用户存储器1系统存储器(只读ROM非易失性)存放系统程序、由厂家烧制完成,系统程序包括三部分:系统管理程序、用户指令解释程序、标准程序模块与系统调用程序2用户存储器:(随机存取RAM、可擦除可编程的只读存储器EEPROM优点兼有)1、用户程序存储器存放编程语言编写的应用程序2、用户数据存储器存放用户程序中所使用器件的ON/OFF状态和数值、数据输入/输出单元1输入/输出接口电路、2输入/输出映像寄存器输入接口电路接收控制信号转化成CPU能够识别和处理的信号存入输入映像寄存器PLC运行时从输入映像寄存器中读取输入信息并结合其他元器件中的信息(从存储器中读取的系统程序、用户程序和用户数据,已经事先存入),按照循环扫描的方式执行用户程序(即依据用户程序进行计算),将有关输出的计算结果存入输出映像寄存器,(输出映像寄存器由输出点相对应的触发器组成)输出接口电路接收输出映像寄存器的信息并将其由弱电信号转化成强电信号输出,以驱动被控设备的执行元件输入接口电路光电耦合电路采用光信号耦合的电气隔离技术,防止干扰信号、高电压信号进入PLC,输出信号也不会反馈到输入端,光电耦合电路关键器件光耦合器,它由发光二极管和光电三极管组成输出接口电路0.5~2A、有3种类型:1、继电器输出型—交直流电、通断频率不能太高2、晶体管输出型—直流电、通断频率高(运动控制系统)3、晶闸管输出型—直流电、通断频率高(使用较少)PLC的所谓的输入/输出继电器就是由一些电子器件电路组成的有记忆功能的寄存器(映像寄存器),在外部提供了一对物理触点电源部分供电电压24Vdc、220Vac(内部的开关电源)还提供一定容量的24Vdc电源供外部的有源传感器使用黄天伟2013.04.10PLC的工作原理PLC工作过程1、上电处理(亦称内部处理)上电后对系统进行一次初始化:1、硬件初始化、2、I/O模块配置检查、3、停电保持范围设定4、系统通讯参数配置、5、其他初始化处理2、扫描过程1输入处理(输入传送、远程I/O)2通讯服务(亦称通讯处理:外设、CPU、总线服务)3更新时钟、特殊寄存器4执行程序(当CPU为RUN时)5输出处理(当CPU为RUN时)3、出错处理(亦称执行自诊断检查)确定PLC自身动作(CPU、电池电压、程序存储器、I/O和通讯等)是否正常(异常即可报警、致命错误CPU强制为STOP)概括而言,PLC是按集中输入、集中输出,周期性循环扫描的方式进行工作的,一直到关机。
lec10 控制台输入输出
• STRING在代码段里定义,取字符需要增加段跨越前缀“CS:
[BX]”,否则会到“DS: [BX]”处取字符,输出不确定的内容。
• 代码为0DH的字符称为“回车(Carriage Return, CR)”,把 光标移动到本行的第一个字符位置,
• 代码为0AH的字符称为“换行(Line Feed, LF)”,把光标移
源程序 …… 实现机制不同 INT n ……
…… ……
IRET
1.向显示器输出信息
向显示器输出信息有三种方法: • 通过DOS操作系统的服务程序(INT 21H)输出; • 通过“基本输入输出系统(BIOS)” 输出; • 把显示内容(ASCII代码)直接写入“显示存储器(Video
RAM,VRAM)”,由显示器接口电路转换输出。
LOOP ONE MOV INT CODE ENDS AX, 4C00H 21H
END
START
0AH号DOS功能调用
输入一行字符 ⑴ 功能调用号:AH=0AH ⑵ 入口参数:DS=输入缓冲区的段地址 DX=输入缓冲区的偏移地址 ⑶ 功能调用:INT 21H ⑷ 出口参数:缓冲区=输入的一行字符 第一字节:输入字符存放区的大小。 第二字节:实际输入的字符个数,不包括回车。 第三字节之后:输入字符存放区,存放输入的字符和回车。
MOV
MO02H装入AH寄存器
;调用21H号系统服务程序
DL, X ;变量X的值装入DL寄存器
[例3-10] 在显示器上输出文字“Hello !”
CODE SEGMENT ASSUME CS: CODE START:LEA BX, STRING MOV CX, 7 ONE: MOV DL, CS: [BX] ;取出一个字符的ASCII代码 MOV AH, 2 ;单个字符输出的功能号 INT 21H ;调用系统服务,输出一个字符 INC BX ;修改指针 LOOP ONE ;计数与循环控制 MOV AX, 4C00H INT 21H STRING DB “Hello !” CODE ENDS END START
电脑主板原理分析与维修技术
IEEE1394接口 : 同轴音频输出接口 : 同轴音频输入接口 : PCI-E插槽:
IDE插槽:
SATA插槽: 声卡芯片: 网卡芯片:
常见主板品牌:
华硕(ASUS)、 技嘉(GIGABYTE) 、精英(ECS)、 微星(MSI)、升技(ABIT)、 磐正(EPOX)、 双敏(UNIKA)、 映泰(BIOSTAR)、华擎(ASRock)、 硕泰克(SOLTEK)、 捷波(JETWAY) 、钻石(DFI)、青云(Albatron)、 奥兰治ORA 、承启(CHAINTECH)、 顶神(ASMART)、建基(AOpen) 、科迪亚(QDI) 、捷锐 、超微(Supermicro)、浩鑫(Shuttle) 、顶星(Topstar)、 佰钰、 昂达(ONDA) 、佰钰acorp(台湾)、富士康(FOXCONN)、 斯巴达克(SPARK)、 梅捷(SOYO)、艾崴(Iwill)、 小影霸、 七彩虹(colorful)、 天机、维博特、 信步、 创能(CUANON) 、三帝(DDD)、硕菁(soking)、 博登(xfx)、 微升(MIMSUN) 、数码通(PcDigicom)、倍嘉、 冠盟、盈通(YESTON)、 磐碁、隽星 、数码键、 冠誉、 翔升、联冠(LK)、 天朗 、华杰、 优俪、美达、 磐英(hasee) 、赛科、 铧基、先锋、 华鑫 、红苹果、 天擎、金字塔PYRAMID)、 奔迅(BENXUN)、 百时通(BESTCOM) 、钛硕、祥瑞 、科盟 、科脑、 普锐(Pretech)、众可 、祺祥 、众成、 杰微、万邦龙、 红船 、风速、 搏鹰、佰特、 艾美、 技星(ST STAr) 、昂迪 、新华盛、 威钻、 建邦、 天虹、奔驰、 技鑫、 泰安(TYAN)、 杰灵(ZILLION)、火龙王、 亚瑟伟业 、磐志、 卓越、奥美嘉(aomg)、 枫叶、 宏嘉、 追钰、首通(SOTIME) 、双捷、 思普、 阳光、跆基(Twkey)、 中硕 、大众、 中凌 、讯崴、 先冠 、亚帝伦 、拓嘉、台讯 、盛邦至尊、 宝捷亚特、 群升(PCQS)、铭世、 蓝天(LANTIAN) 、源兴、 新泰(SYNTAX)、华英、 红旗 、众星、 海讯(sunstar)、恒钛、 致铭(cthim) 、台众、 白鲨王(SHARKING)、 凌峰、 宇擎、 双硕、鑫驰 、速霸、 华佳 、宏迅、迪兰恒进、 慧星、 金凤凰(GPHOENIX)、 帝鲨(DESHARK)、PCCHIPS 、联强(Lemel)、 金正。
lpc1100系列单片机I2C学习笔记

I2C总线上可能存在以下两种类型的数据传输方式:1、由主发送器向从接收器传输数据。
主机发送的第一个字节是从机地址。
接下来是数据字节数。
从机每接收一个字节后返回一个应答位;2、由从发送器向主接收器传输数据。
由主机发送第一个字节(从机地址)。
然后从机返回一个应答位。
接下来是由从机发送数据字节到主机。
主机接收到所有字节(最后一个字节除外)后返回一个应答位。
接收到最后一个字节后,主机返回“非应答”位,主机设备产生所有的串行时钟脉冲及起始和停止条件。
以停止或重复起始条件结束传输。
由于重复起始条件也是下一次串行传输的开始,因此不释放I2C总线I2C 接口是字节导向型,有4个操作模式:主发送模式、主接收模式、从发送模式及从接收快速模式配置:快速模式Plus支持1Mbit/sec 的传输速率与NXP 半导体现在所提供的I2 C 产品通信。
要使用快速模式Plus,就必须正确配置IOCONFIG 寄存器块中的I2C管脚。
在快速模式Plus中,可选择的速率在400KHz 以上,高达1MHz。
时钟控制:I2C总线接口(PCLK_I2C)的时钟由系统时钟提供。
这个时钟可通过AHBCLKCTRL 寄存器的位5 来禁止,以节省功耗。
I2C的几个概念发送器:本次传送中发送数据(不包括地址和命令)到总线的器件;接收器:本次传送中从总线接收数据(不包括地址和命令)的器件;主机:初始化发送、产生时钟信号和终止发送的器件,可以是发送器或接收器。
主机通常是微控制器;从机:被主机寻址的器件,它可以是发送器或接收器。
I2C 总线是一个多主机的总线,即,总线上可以连接多个能控制总线的器件。
当2个以上控制器件同时发动传输时,只能有一个控制器件能真正控制总线而成为主机,并使报文不被破坏,这个过程叫仲裁。
与此同时,能够同步多个控制器件所产生的时钟信号。
SDA 和SCL 都是双向线路。
连接到总线的器件的输出级必须是漏极开路或集电极开路,都通过一个电流源或上拉电阻连接到正的电源电压,这样才能够实现“线与”功能。
漫谈兼容内核之十八:Windows的LPC机制
漫谈兼容内核之十八:W indow s的LPC机制毛德操 LP C是“本地过程调用(Local Proc edure Call)”的缩写。
所谓“本地过程调用”是与“远程过程调用”即RPC相对而言的。
其实RP C是广义的,RPC可以发生在不同的主机之间,也可以发生在同一台主机上,发生在同一台主机上就是LPC。
所以在Un ix语境下就没有LP C这一说,即使发生在同一台主机上也称为R PC。
在历史上,RP C是“开放软件基金会(OSF)”设计和提出的一种用以实现“U nix分布计算环境(UnixDCE)”的标准。
实际上,微软的DCOM技术,就是建立在RP C基础上的。
Win2000的R PC可以采用TCP/IP、SP X、Net BIOS、命名管道、以及“本地”作为底层的通信手段,这“本地”就是LP C。
另一方面,Win dows是一个带有许多微内核系统特征的操作系统(尽管它的内核不是微内核),系统中有不少“系统级”的服务进程,例如大家已经熟知的cs rss、管理用户登录的“本地安全认证服务”进程LS ASS等等,用户进程以及微软提供的系统工具软件经常需要调用由这些服务进程提供的服务,这里L PC就起着重要的作用。
LPC的基础是一种称为“端口(Port)”的进程间通信机制,类似于本地的(Un ix域的)Socke t。
这种P ort机制提供了面向报文传递(messa ge pa ssing)的进程间通信,而L PC则是建立在这个基础上的高层机制,目的是提供跨进程的过程调用。
注意这里所谓“跨进程的过程调用”不同于以前所说的“跨进程操作”。
前者是双方有约定、遵循一定规程的、有控制的服务提供,被调用者在向外提供一些什么服务、即提供哪些函数调用方面是自主的,而后者则可以是在不知不觉之间的被利用、被操纵。
CL-10
第九章定义命令一个CL命令是请求系统完成一定功能的语句,这个功能是在进入命令时由运行的程序完成的。
CL命令允许你请求一个大范围的功能。
使用这些命令就象它们是IBM提供的一样,也能修改由IBM提供的缺省值。
这章介绍如何定义和生成自己的命令。
9.1 定义命令简介下面解释生成命令的步聚,接下来有文字介绍每步的作用。
有效性检查程序和提示替代程序是可选的。
9.1.1 各步说明9.1.1.1 命令定义语句命令定义语句包括对工作站用户输入的提示,检查输入的有效性,及在命令运行时传给被调用程序的值的定义。
命令定义语句可以放在作为CRTCMD命令输入的任何文件中。
例如,SEU源文件,软盘,及其它可以包括命令定义语句的设备文件中,它们通常是由SEU输入到源文件中。
表9-1给出定义命令所用的语句。
表9-1定义CL命令的语句语句类型语句名解释命令CMD 对命令名规定提示文本参数PARM 定义参数或键字参数元素ELEM 定义用作参数值的列表中的元素限定QUAL 定义用作参数的限定名关系DEP 定义参数之间的关系提示控制PMTCTL 定义提示参数的条件9.1.1.2 CRTCMD命令它处理命令定义语句,生成命令定义目标,CRTCMD可在交互作业或批作业中运行。
9.1.1.3 命令定义目标命令定义目标是由系统程序检验的确保命令的有效性及输入适当的参数。
9.1.1.4 有效性检查系统对命令做有效性检查,你也可以自己写检查程序。
由系统完成的有效性检查要保证:要输入必须的参数值每个参数值要附合规定的类型和长度每个参数值要附合在命令定义中规定的可选要求:—有效值列表—值的范围—值的关系比较不能输入冲突的参数在下列时候,系统做有效性检查:从工作站交互地进入命令用假脱机从批输入流进入命令用SEU把命令输入到数据库文件中由一个HLL调用把命令传给QCMDEXC、QCMDCHK、QCAPCMD时生成CL模块或OPM程序由CL过程或程序或REXX过程运行命令用C语言系统功能运行命如果要做比系统做的多的检查,可以自己写程序(看9.11),或在命令处理程序中加上检验功能。
低速语音编码
低速率语音编码的实现与仿真摘要:近年来,随着通信与计算机网络的飞速发展,低速率语音编码以其低速率且良好的编码质量等特点,在数字通信中越来越受到重视。
低速率语音编码方案主要是基于LPC-10,混合激励线性预测(MELP),多带激励编码(MBE),正弦变换编码(SCI)等。
它们大都能够工作在2.4kbps速率下。
本文对LPC-10进行了研究,以LPC模型为原型,通过联合帧、矢量量化及参数内插等技术,实现了一种低速率语音编码算法。
归一化互相关函数基音检测算法(NCCFPDA)的引入,提高了清浊音判决的准确率;线谱对(LSP)参数的量化特性,降低了误差率,提高了算法的稳健性;固定矢量量化码本(LSPVQ码本)提高了量化精度并降低了传输码率;联合帧的应用,较好的平衡了低码率与语音质量严重恶化的矛盾,而与参数内插技术的结合更加降低了传输码率。
通过该算法获得了比较满意的合成语音,并在MATLAB中得到实现,验证了算法的可行性。
关键词:语音编码,基音检测,LSP,MATLAB目录第一章绪论 (4)1.1引言 (4)1.2低速率语音编码研究现状 (4)1.3常用低速率语音编码算法 (5)1.3本文主要研究内容及章节安排 (6)第二章 LPC-10编码算法 (7)2.1LPC-10编码算法的理论依据 (7)2.1.1 语音信号的产生模型 (7)2.1.2语音信号的线性预测分析[8] (7)2.2LPC-10编解码算法的分析[9] (8)2.2.1 LPC-10编码算法分析 (8)2.2.2 计算声道滤波参数RC (9)2.2.3 计算增益RMS (10)2.2.4 提取基音周期和检测清/浊音 (10)2.2.5 参数编码与解码 (10)2.2.6 LPC-10解码算法分析 (10)2.3LPC-10声码器存在的问题[9] (11)第三章 900BIT/S极低速率编码算法 (12)3.1算法概述 (12)3.2编码原理 (13)3.2.1预处理 (13)3.2.2线性预测分析 (14)3.2.3 NCCFPDA算法[12] (16)3.2.4 矢量量化[9] (19)3.2.5参数编码 (20)3.3解码原理 (20)3.3.1参数解码 (21)3.3.2合成语音 (21)3.4本章小节 (22)第四章低速率语音编解码算法的仿真实现 (23)4.1仿真实验平台 (23)4.2编解码器的工作流程 (23)4.2语音编码仿真结果 (24)第五章结论与展望 (25)5.1结论 (25)5.2展望 (25)参考文献 (26)第一章绪论1.1引言语音通信是一种非常重要且普遍的通信方式。
语音压缩编码
语⾳压缩编码语⾳编码第⼀章⾳频1.1 ⾳频和语⾳的定义声⾳是携带信息的重要媒体,是通过空⽓传播的⼀种连续的波,叫声波。
对声⾳信号的分析表明,声⾳信号有许多频率不同的信号组成,这类信号称为复合信号。
⽽单⼀频率的信号称为分量信号。
声⾳信号的两个基本参数频率和幅度。
1.1.1声⾳信号的数字化声⾳数字化包括采样和量化。
采样频率由采样定理给出。
1.1.2声⾳质量划分根据声⾳频带,声⾳质量分5个等级,依次为:电话、调幅⼴播、调频⼴播、光盘、数字录⾳带DAT(digital audio tape)的声⾳。
第⼆章语⾳编码技术的发展和分类现有的语⾳编码器⼤体可以分三种类型:波形编码器、⾳源编码器和混合编码器。
⼀般来说,波形编码器的话⾳质量⾼,但数据率也很⾼。
⾳源编码器的数据率很低,产⽣的合成话⾳⾳质有待提⾼。
混合编码器使⽤⾳源编码器和波形编码器技术,数据率和⾳质介于⼆者之间。
语⾳编码性能指标主要有⽐特速率、时延、复杂性和还原质量。
其中语⾳编码的三种最常⽤的技术是脉冲编码调制(PCM)、差分PCM(DPCM)和增量调制(DM)。
通常,公共交换电话⽹中的数字电话都采⽤这三种技术。
第⼆类语⾳数字化⽅法主要与⽤于窄带传输系统或有限容量的数字设备的语⾳编码器有关。
采⽤该数字化技术的设备⼀般被称为声码器,声码器技术现在开始展开应⽤,特别是⽤于帧中继和IP上的语⾳。
在具体的编码实现(如VoIP)中除压缩编码技术外,⼈们还应⽤许多其它节省带宽的技术来减少语⾳所占带宽,优化⽹络资源。
静⾳抑制技术可将连接中的静⾳数据消除。
语⾳活动检测(SAD)技术可以⽤来动态跟踪噪⾳电平,并将噪⾳可听度抑制到最⼩,并确保话路两端的语⾳质量和⾃然声⾳的连接。
回声消除技术监听回声信号,并将它从听话⼈的语⾳信号中清除。
处理话⾳抖动的技术则将能导致通话⾳质下降的信道延时与信道抖动平滑掉。
2.1波形编码波形编解码器的思想是,编码前根据采样定理对模拟语⾳信号进⾏采样,然后进⾏幅度量化与⼆进制编码。