
逻辑斯蒂回归
模型不显著
Logistic回归步骤以及SPSS实现
不显著,去掉最不显著的 月收入变量,重新估计
exp(2.629 2.224 性别+0.102 年龄) ˆi p 1 exp(2.629 2.224 性别+0.102 年龄)
结论:女性乘公交车比例高于男性,年龄越大, 乘车的比例越高。
i 1 j 1
I
J
(nij ni n j n) 2 ni n j n
(550 1231 611 1436 ) 2 (61 205 611 1436) 2 1231 611 1436 205 611 1436 (681 1231 825 1436) 2 (144 205 825 1436 )2 1231 825 1436 205 825 1436
定性数据的建模
1
列联表及列联表分析
2
Logistic回归基本理论和方法
3
Logistic回归步骤以及SPSS实现
列联表及列联表分析
研究两个属性变量之间是否有联系 研究步骤: 通过问卷调查或统计资料获得属性 变量的信息 整理问卷或统计资料获得列联表数据 通过统计假设检验两个属性变量是 否具有独立性
i 0 优势比增加 i 0 优势比减小
Logistic回归系数的估计(分组数据)
n组观测数据结构:
x
参加调查 总数 N
i
序号 1 2 i
Logistic 变换 事件出现 事件出现 次数 mi 频率 mi N i ln[pi (1 pi )]
x1
N1
m1
p1
p1
P与多因素之间的关系预测 p ln 0 1 x1 q xq 1 p
p
e
0 1 x1 q xq 0 1 x1 q xq
1 e
p
1 1 e
( 0 1 x1 q xq )
P与单因素之间的关系图
p2
x2
N2
m2
p2
xi
xn
Ni
mi
pi
pi
pn
n
Nn
mn
pn
拟合模型
回归模型具有异方差性
p i 0 1 xi i
i 1,2,, n
其中
1 2 N ( 0 , ) 近似服从 i N i pi (1 pi )
权(weight)
转换成经典回归模型(加权最小二乘)
零假设:婚姻状态与教育水平没有关系 检验统计量及其分布: n足够大
2
i 1 j 1
2
2
(nij ni n j n) 2 ni n j n
16.01
决策规则:对给定的显著性水平0.05 2 2 16.01 0.05 (1) 3.84 则拒绝零假设,即婚姻状态与教育水平 有关联.
一个一般结论
Logistic 回归模型与判别分析 模型具有相同的判别准确率
yes
数据满足正态分布 No
Logistic 回归模型的判别准确率 高于判别分析模型的判别准确率
本研究结论
当Logistic 回归模型和判别分析模型都 通过运行SPSS 软件来估计模型参数并 建立相应模型时, 线性判别分析模型优 于Logistic 回归模型.
p
1
1 0
e p 0 1 x 1 e
最可能成功范围
0 1 x
x
最不可能成功范围
回归系数的含义
优势比(Odds Ratio)—事件发生与不发生的概率比
p 0 1 x1 q xq OR e 1 p 优势比与单变量系数之间的关系
i
OR( x1 , x2 ,, xi 1,, xq ) e OR( x1 , x2 ,, xi ,, xq )
N i pi (1 pi ) p N i pi (1 pi ) i i 0 N i pi (1 pi ) 1 ( N i pi (1 pi ) xi )
zi 0 X 0i 1 X1i ui
其中 ui 近似服从 N (0, 2 )
例题
在一次住房展销会上,与房地产商签订 初步购房意向书的共有n=325名顾客.在 随后的三个月里,只有一部分顾客确实 购买了房屋.以顾客的年家庭收入 x(万 元)为自变量,建立Logistic回归模型.
引言中提及的一些研究结果
Martin(1977)用Logistic模型预测公司破 产及违约的概率 Ohlson(1980)将Logistic模型应用于信 用风险分析 Madalla(1983)采用Logistic模型区别违 约与非违约贷款申请人
David West(2000)利用5种神经网络 和 5 种统计分类模型 ( 线性判别分析 、 Logistic 回归分析 、 K 最近邻法 、 核密 度分类法 、 分类树法 ) 分别对德国和澳 大利亚两组财务数据进行两类模式分类 , 研究结果表明: Logistic模型的判别准 确率最高,分别为 76.3% 和 87.25%.
1 e
参数的极大似然估计
未 分 组 数 据 结 构
yi 的分布函数
p( yi ) piyi (1 pi )1 yi
y1 , y2 , yn的似然函数
L p( yi ) piyi (1 pi )1 yi
i 1 i 1 n n
似然函数的对数表达
n i 1
SPSS实现
属性变量1
属性变量2
数 据 结 构
SPSS中的数据输入
频数 A水平 B水平 1 1 1 2
n11 n21 n31 n12
n22 n32
1
2 3 1 2 3
2
2
拒绝独立假设,即婚姻与教育程度有关。
Logistic回归基本理论和方法
研究某一事件发生的概率P=P(y=1)与 若干因素之间的关系
点击
exp(0.904 0.159 x) ˆi p 1 exp(0.904 0.159 x)
利用上式可以对购房比例进行预测,如 x0 8
exp(0.904 0.159 8) ˆi p 0.585 1 exp(0.904 0.159 8)
仿真结果表明,Logistic 回归信用评价模型对 总体106 个样本, 判别准确率达到99. 06%. 此外, 本文的研究结果还发现, 当利用SPSS 的Discriminant 给出的模型系数建立的线性 判别分析模型和利用SPSS 的Multinomial Logistic 给出的模型参数建立的Logistic 回归 模型, Logistic 回归模型的判别结果不如线性 判别模型. 但如果剔除不合格的样本, 或是将 样本数据规格化, 则可以提高Logistic 回归模 型的分类准确率.
2 [( I 1 )( J 1 )] ~
决策规则: 对给定的显著性水平 , 若 2 2 [(I 1)(J 1)] 则拒绝零假设.
2 [(I 1)(J 1)]
检验统计量的计算
2 n
i 1 j 1 I J
( pij pi p j ) 2 pi p j
科研教案
庞素林. Logistic回归模型在信用风险中的应 用. 数学的实践与认识. 2006,36(9):129~137
判别模型建立的基本步骤
第一步 第二步 第三步
样本分组 将样本分 成训练样 本组和测 试样本组
建模过程 利用训练 样本建立 分类模型
评价过程 利用测试样 本评价模型 的精度
摘要
任意范围之间的数量
p 0 1 x1 q xq
在0和1之间
若干个状态的标量
logistic变换
logistic变换
优势比
p ln ( , ) 1 p
Logistic回归模型
p ln 0 1 x1 q xq 1 p
概率p的预测
B1
B2
合计
A1
p11
p21
p12 p22
p1
p 2
A2
A3
合计
事件 B1 发生的概率
p31
p1
p32
p 2
p3
1
统计假设与检验
零假设:属性变量A与B相互独立 检验统计量及其分布: n足够大
2 n
i 1 j 1
I
J
( pij pi pቤተ መጻሕፍቲ ባይዱj ) 2 pi p j
女性人口学研究
婚姻 教育
结婚一次
结婚多次
合计
大学 大学以下
550 681 1231
61 144 205
611 825 1436
合计
频数列联表
A B
B1
B2
合计
A1
A2
A3
合计
n11 n21
n12
n1
n22
n2
n31
n1
n32
n2
n3
n
频率列联表
事件 A1 发生的概率 事件 A1与 B1 同 时发生的概率 A B
0 1 q
拟合的优良性
拟合优度
回归模型的优良性
-2log(L)
回归系数的显著性
Wald=
R
2
goodness-of-fit statistics
ˆ2 i 12 D( i )
混合效应逻辑斯蒂回归模型的原理及其应用

语料库语言学 2020年 第7卷 第2期混合效应逻辑斯蒂回归模型的原理及其应用北京航空航天大学 张 懂提要:近年来,混合效应逻辑斯蒂回归模型(mixed-effects logistic regression model)在社会语言学、心理语言学、语料库语言学和认知语言学等领域中得到广泛应用。
本文旨在介绍混合效应逻辑斯蒂回归建模的原理,并以英语与格交替研究作为案例,展示混合效应逻辑斯蒂回归模型在语言研究中的具体应用。
关键词:混合效应逻辑斯蒂回归模型、多变量统计分析、英语与格交替1. 引言基于用法的语言观认为,语言的使用和选择往往受多个因素的共同影响(Gries 2013)。
因此要考察真实使用中的语言选择,需同时考察多个因素及其交互作用。
多变量统计分析方法为同时考察多个因素对语言使用的影响提供了有效的技术支撑。
近年来,使用多变量统计分析方法的语言学研究日益增多(如Gries 2003;Gries & Divjak 2009;Glynn & Fischer 2010;Glynn & Robinson 2014;Divjak et al. 2016 ;Szmrecsanyi et al. 2017;Röthlisberger et al. 2017;许家金、陈哲 2018;房印杰、梁茂成 2019)。
多变量统计分析方法包括众多不同的统计方法,大致可分为探索型统计分析方法和验证型统计分析方法,前者包括聚类分析、对应分析、因子分析和多维尺度等;后者包括多元线性回归分析、逻辑斯蒂回归分析和线性判别分析等。
本文拟简述混合效应逻辑斯蒂回归模型的原理,并通过研究案例,展示混合效应逻辑斯蒂回归分析在语言研究中的具体应用。
本文重点在于呈现混合效应逻辑斯蒂回归分析的操作过程和分析步骤。
2. 混合效应逻辑斯蒂回归模型简介逻辑斯蒂回归分析是一种重要的多变量统计分析方法。
逻辑斯蒂回归模型的反应变量要求是类别型变量(categorical variables)(通常是二分类),符合二项分布( binomial distribution)。
逻辑斯蒂(logistic)回归深入理解、阐述与实现

逻辑斯蒂(logistic)回归深⼊理解、阐述与实现第⼀节中说了,logistic 回归和线性回归的区别是:线性回归是根据样本X各个维度的Xi的线性叠加(线性叠加的权重系数wi就是模型的参数)来得到预测值的Y,然后最⼩化所有的样本预测值Y与真实值y'的误差来求得模型参数。
我们看到这⾥的模型的值Y是样本X各个维度的Xi的线性叠加,是线性的。
Y=WX (假设W>0),Y的⼤⼩是随着X各个维度的叠加和的⼤⼩线性增加的,如图(x为了⽅便取1维):然后再来看看我们这⾥的logistic 回归模型,模型公式是:,这⾥假设W>0,Y与X各维度叠加和(这⾥都是线性叠加W)的图形关系,如图(x为了⽅便取1维):我们看到Y的值⼤⼩不是随X叠加和的⼤⼩线性的变化了,⽽是⼀种平滑的变化,这种变化在x的叠加和为0附近的时候变化的很快,⽽在很⼤很⼤或很⼩很⼩的时候,X叠加和再⼤或再⼩,Y值的变化⼏乎就已经很⼩了。
当X各维度叠加和取⽆穷⼤的时候,Y趋近于1,当X各维度叠加和取⽆穷⼩的时候,Y趋近于0.这种变量与因变量的变化形式就叫做logistic变化。
(注意不是说X各个维度和为⽆穷⼤的时候,Y值就趋近1,这是在基于W>0的基础上,(如果W<0,n那么Y趋近于0)⽽W是根据样本训练出来,可能是⼤于0,也可能是⼩0,还可能W1>0,W2<0…所以这个w值是样本⾃动训练出来的,也因此不是说你只要x1,x2,x3…各个维度都很⼤,那么Y值就趋近于1,这是错误的。
凭直觉想⼀下也不对,因为你连样本都还没训练,你的模型就有⼀个特点:X很⼤的时候Y就很⼤。
这种强假设肯定是不对的。
因为可能样本的特点是X很⼤的时候Y就很⼩。
)所以我们看到,在logistic回归中,X各维度叠加和(或X各维度)与Y不是线性关系,⽽是logistic关系。
⽽在线性回归中,X各维度叠加和就是Y,也就是Y与X就是线性的了。
ologit模型公式
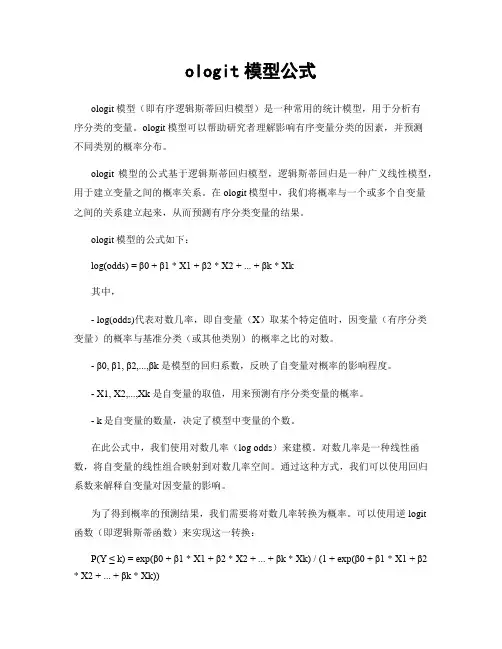
ologit模型公式ologit模型(即有序逻辑斯蒂回归模型)是一种常用的统计模型,用于分析有序分类的变量。
ologit模型可以帮助研究者理解影响有序变量分类的因素,并预测不同类别的概率分布。
ologit模型的公式基于逻辑斯蒂回归模型,逻辑斯蒂回归是一种广义线性模型,用于建立变量之间的概率关系。
在ologit模型中,我们将概率与一个或多个自变量之间的关系建立起来,从而预测有序分类变量的结果。
ologit模型的公式如下:log(odds) = β0 + β1 * X1 + β2 * X2 + ...+ βk * Xk其中,- log(odds)代表对数几率,即自变量(X)取某个特定值时,因变量(有序分类变量)的概率与基准分类(或其他类别)的概率之比的对数。
- β0, β1, β2,...,βk 是模型的回归系数,反映了自变量对概率的影响程度。
- X1, X2,...,Xk 是自变量的取值,用来预测有序分类变量的概率。
- k是自变量的数量,决定了模型中变量的个数。
在此公式中,我们使用对数几率(log odds)来建模。
对数几率是一种线性函数,将自变量的线性组合映射到对数几率空间。
通过这种方式,我们可以使用回归系数来解释自变量对因变量的影响。
为了得到概率的预测结果,我们需要将对数几率转换为概率。
可以使用逆logit函数(即逻辑斯蒂函数)来实现这一转换:P(Y ≤ k) = exp(β0 + β1 * X1 + β2 * X2 + ... + βk * Xk) / (1 + exp(β0 + β1 * X1 + β2 * X2 + ... + βk * Xk))这里,P(Y ≤ k)表示因变量的概率小于等于k,exp是指数函数。
通过使用ologit模型,我们可以利用已知的自变量的取值,计算每个类别的概率。
模型的回归系数可以帮助我们理解不同自变量对结果的影响,从而进行因果推断和预测。
需要注意的是,ologit模型的结果解释和判断需要结合领域知识和实际情况。
逻辑斯蒂回归
逻辑斯谛回归的简介机器学习中经典的逻辑(斯谛)回归(Logistic Regression),什么叫做回归呢?举个例子,我们现在有一些数据点,然后我们打算用一条直线来对这些点进行拟合(该曲线称为最佳拟合曲线),这个拟合过程就被称为回归。
逻辑斯谛回归直接对分类的可能性建模,无需事先假设数据的分布,可以避免假设分布带来的问题,不仅能预测出样本的类别,还能得到该类别的概率。
二项逻辑斯谛回归模型是一种分类模型,由条件概率分布表示,形式为参数化的逻辑斯谛分布。
这里,随机变量X 为实数,变量Y 取值为1或0.二项逻辑斯谛回归模型()X Y P 定义6.2(逻辑斯谛回归模型)二项逻辑斯谛回归模型是如下的条件概率分布:这里,是输入,是输出,和是参数,w 称为权值向量,b 称为偏置,为w 和x 的内积。
nR x ∈{}1,0∈Y nR w ∈R b ∈x w ⋅()()()()()()()4.6exp 1103.6exp 1exp 1b x w x Y P b x w b x w x Y P +⋅+==+⋅++⋅==二项逻辑斯谛回归模型一个事件的几率(odds )是指该事件发生的概率与该事件不发生的概率的比值。
如果事件发生的概率为p ,那么该事件的几率是,该事件的对数几率或logit 函数为p p-1为了方便,将权值向量和输入向量加以扩充,仍记作w, x, 即w =(w (1),w (2),...,w (n),b )T , x =(x (1),x (2),...,x (n),1)T .这时,逻辑斯谛回归模型如下:()()()()()()()6.6exp 1105.6exp 1exp 1x w x Y P x w x w x Y P ⋅+==⋅+⋅==()ppp -=1loglogit{}1,0,∈∈i n i y R x 逻辑斯谛回归模型学习时,对于给定的训练数据是T ={(x 1,y 1),(x 2,y 2),...,(x N ,y N )},其中,,可以应用极大似然估计法估计模型参数,从而得到逻辑斯谛回归模型。
logistic回归模型分析和总结

含有名义数据的logit
含有名义数据的logit
• 例:某地25岁及以上人中各类婚姻状况居民的死
亡情况见表,试建立死亡率关于年龄和婚姻状况
的logit模型。
ln p 1 p
A 1M1
2M 2
3M3
• 其中,A表示年龄(取中值),M1、M2、M3表示婚 姻状况
• 于是,估计的logit方程为:
多项logit模型
【例】研究三个学校、两个课程计划对学生偏好何 种学习方式的影响。调查数据见表:
• 其中,三个学校对应两个哑变量x1和x2,两个课 程计划为常规(x3=1)和附加(x3=0),学习方式分 为:自修(y=1)、小组(y=2)、上课(y=3)
• 从题目可以看出,响应变量是学习方式有三类, 属于多项逻辑斯蒂回归问题。于是,建模为:
ln ln
p1 p3 p2 p3
10 11x1 12 x2 13 x3 20 21x1 22 x2 23x3
多项logit模型
多项logit模型
• 应用统计软件可以得到模型的参数估计和回归方程:
ln
p1 p3
0.5931.134 x1 0.618 x3
ln
p2 p3
0.603 0.635 x3
ln p A E
1 p
• 其中A为年龄,E为文化程度
含有有序数据的logit
含有有序数据的logit
• 于是,估计的logit方程为:
ln p 11.637 0.124A 0.164E 1 p
• 其中,年龄的系数0.124,说明年龄越大死亡率会 越高;
• 文化程度的系数-0.164,说明文化程度与死亡率 呈负相关,文化程度越高,死亡率越低。
logistic回归原理

logistic回归原理
Logistic回归是一种有效的、相对简单的数据分类技术,用于确定某个事件或观测值属于某类的概率。
它可以解释二元数据和多类数据,并且能够应用于各种场景,比如风险分析、金融建模、社会研究等等。
Logistic回归源自线性模型,它是一种称为逻辑斯蒂(logit)模型的回归模型,该模型基于概率理论。
Logistic回归模型是由概率对数函数构建而成的,即:
Y = log(P/(1-P))
其中,P代表事件Y发生的概率。
Logistic归模型在数据分析中最主要的用途就是用于分类,它的原理是:假定输入的数据可以用一个线性函数来描述,并且拟合一条S型函数来获得概率,这个概率决定了每个样本点属于某一类的概率大小。
在使用Logistic回归之前,首先要处理好数据集,确保它具有足够的观测值,并且有合理的分类标签(例如“是”、“否”)。
接下来,要使用回归的模型,先把正确的观测值用正向的系数系数,将错误的观测值用负向的系数进行编码。
然后,确定正确的估计量结果,比如系数、拟合度指标和参数检验,以及误差分析。
最后,定义一个提升指标来评估结果,例如:准确率、召回率和精确率。
Logistic回归在机器学习中有各种应用,比如文本分类、情感分析和预测分析;在图像识别中,它可以用于目标检测、纹理识别和
边缘检测;在金融行业,它可以应用于信贷分析、欺诈检测和市场风险分析。
它也可以用于生物药物研究、病毒鉴别;在医学领域,它可以用于数据分析、诊断分析和临床预测等。
简而言之,Logistic回归是一种用于预测任意事件的概率发生的有效模型,可以用于多类数据的分类,在数据挖掘领域扮演着重要的角色,是结构化数据建模的常用工具。
origin逻辑斯蒂方程拟合步骤
origin逻辑斯蒂方程拟合步骤
用逻辑斯蒂回归进行数据拟合一般需要以下步骤:
1. 数据准备:首先需要准备好用于拟合的数据集。
数据集应包含两个关键列:自变量(X)和因变量(Y)。
自变量可以是单个变量或多个变量,而因变量应为二元变量(0或1)。
2. 模型建立:使用逻辑斯蒂回归模型建立拟合模型。
逻辑斯蒂回归模型是一个用于描述二分类问题的回归模型,通过将线性函数的输出值通过S形函数(逻辑斯蒂函数)转换为概率值。
3. 参数估计:使用最大似然估计方法来估计逻辑斯蒂回归模型的参数。
最大似然估计方法是一种通过最大化观测到的数据的概率来估计模型参数的统计方法。
4. 模型拟合:使用估计出的参数对逻辑斯蒂回归模型进行拟合。
将自变量输入模型,计算输出的概率值。
5. 拟合评估:对拟合结果进行评估,常用的评估指标包括准确率、精确率、召回率、F1分数等。
可以使用交叉验证等方法进一步评估模型的性能。
6. 预测应用:使用拟合完成的逻辑斯蒂回归模型进行新样本的分类预测。
将新的自变量输入模型,根据模型输出的概率值进行分类。
以上是逻辑斯蒂回归模型的拟合步骤,需要注意的是,不同的软件和编程环境可能会有些差异,具体的步骤和实现方法可以根据所使用的工具进行适当调整。
第6章逻辑斯蒂回归模型
–其中probit变换是将概率变换为标准正态分布的 z −值, 形式为:
Logistic回归模型
–双对数变换的形式为:
f ( p ) = ln(− ln(1 − p ))
• 以上变换中以logit变换应最为广泛。 • 假设响应变量Y是二分变量,令 p = P(Y = 1) ,影响Y 的因素有k个 x1 ,L xk ,则称:
β • 其中, 0 , β1 ,L , β k 是待估参数。根据上式可以得到 优势的值: p β + β x +L+ β x
1− p
=e
0
1 1
k k
• 可以看出,参数 βi是控制其它 x 时 xi 每增加一个 单位对优势产生的乘积效应。 • 概率p的值: e β + β x +L+ β x
p=
0 1 1 k k
含有名义数据的logit
• 前例中的协变量为定量数据,logistic回归模型的 协变量可以是定性名义数据。这就需要对名义数 据进行赋值。 • 通常某个名义数据有k个状态,则定义个变量 M 1 ,L , M k −1 代表前面的k-1状态,最后令k-1变量均 为0或-1来代表第k个状态。 • 如婚姻状况有四种状态:未婚、有配偶、丧偶和 离婚,则可以定义三个指示变量M1、M2、M3, 用(1,0,0)、 (0,1,0) 、(0,0,1) 、(0,0,0)或(-1,-1,-1) 来对以上四种状态赋值。
G 2 = −2 ∑ 观测值[ln(观测值/拟合值)]
• 卡方的df应等于观测的组数与模型参数的差,较小的统计量的 值和较大的P-值说明模型拟合不错。 • 当至多只有几个解释变量且这些解释变量为属性变量,并且所 有的单元频数不少于5时,以上统计量近似服从卡方分布。
(教材配套)机器学习基础-第三章-逻辑回归
• 我• 当θTx≥0时,h(x; θ)≥0.5,预测样本 x 为正例;
• 当θTx <0时,h(x; θ)<0.5,预测样本 x 为负例。
• 假如数据集有两个属性,使用如下逻辑回归模型:
•
(3.2)
• 由数学知识可知,
是一条直线,如
图 3-4 所示,该图由脚本BinaryLogisticRegDemo.m 绘制。
3.1.1 线性回归用于分类
• 假设二元分类问题采用1 和0 分别表示正例和负例,直觉是 借用线性回归来求解分类问题,设定一个阈值,如 0.5,如 果h(x;θ )≥0.5,则预测 y=1,如果h(x; θ ) < 0.5,则预测 y=0。将这种思路用于求解假想的癌症问题的方案如图 3-1 所示。假定肿瘤大小决定肿瘤是恶性还是良性,使用小圆 圈表示良性,使用小叉表示恶性,用线性回归得到的假设 h(x; θ )是一条直线,刚好能够在纵坐标为0.5 的地方将良性 肿瘤和恶性肿瘤分开,看起来效果不错。
•
(3.4)
• 其中, log 表示自然对数。
• h(x; θ)与cost(h(x; θ), y)之间的函数关系可用图 3-6表示, 该图由脚本 plotCost.m绘制。
3.2 逻辑回归算法
• 逻辑回归算法的关键问题就是寻找拟合参数集θ,因此逻辑
回归算法都围绕参数集θ进行。为此,首先需要定义一个代
价函数J (θ),这就是参数θ的优化目标,然后求得代价函数
最小的 ,即
。
3.2.1 代价函数
• 在逻辑回归中,模型错分样本x 的代价使用负对数似然代价 函数表示,定义为:
它将数据一分为二,直线上方的数据点为正例,这里是
Setosa,直线下方的数据点为负例,这里是Versicolor。
多元逻辑斯蒂回归 哑变量
多元逻辑斯蒂回归哑变量一、引言多元逻辑斯蒂回归(Multinomial Logistic Regression,MLR)是一种广泛用于分类问题的统计学习方法。
当自变量与因变量之间存在非线性关系或自变量之间的交互效应较强时,传统的线性回归模型可能无法准确地预测因变量,而多元逻辑斯蒂回归在这种情况下表现优异。
在多元逻辑斯蒂回归中,哑变量(Dummy Variables)是一种常见的处理分类变量的方法,它可以解决分类变量不能直接进入线性回归模型的问题。
二、多元逻辑斯蒂回归中的哑变量哑变量在多元逻辑斯蒂回归中起着至关重要的作用。
由于逻辑斯蒂回归是一个基于概率的二项式回归模型,因此无法直接使用分类自变量。
为了将分类自变量引入模型,需要将其转换为哑变量。
哑变量是一种虚拟变量,用于表示分类变量的不同类别。
通过将每个类别表示为一个虚拟变量,可以模拟分类变量与因变量之间的非线性关系。
三、哑变量的构造构造哑变量的基本步骤如下:1.确定分类变量的类别数量。
2.为每个类别创建一个虚拟变量。
3.将虚拟变量引入模型,并指定一个参考类别作为参照点。
4.为每个虚拟变量指定一个截距,以反映该类别的平均效应。
5.估计模型参数,以确定每个类别的相对风险或概率。
四、哑变量的解释在多元逻辑斯蒂回归中,哑变量的解释对于理解模型的输出至关重要。
以下是一些解释哑变量的要点:1.参照组选择:在逻辑斯蒂回归中,通常选择一个参照组作为基准类别。
该参照组在模型中通过截距项表示,所有其他类别的效应则通过与之比较的虚拟变量来解释。
因此,参照组的效应是所有其他类别的平均效应。
2.效应估计:通过估计每个虚拟变量的系数,可以了解各个类别相对于参照组的效应。
具体来说,系数的大小和符号可以揭示各个类别的风险或概率与参照组相比有何不同。
如果某个类别的系数为正数,则表示该类别的风险或概率高于参照组;如果系数为负数,则表示低于参照组。
3.交互效应:通过引入多个哑变量,可以模拟分类自变量之间的交互效应。