
一种支持多条件过滤查询的分页组件设计与实现
一种支持多条件过滤查询的分页组件设计与实现作者:祝衍军来源:《电脑知识与技术》2014年第03期摘要:常见的分页组件存在一些不足,针对多条件组合过滤的分页查询业务场景提出了改进方案,在实现分页查询封装的同时给业务开发者提供足够的开发灵活性,并在Spring MVC 开发框架的基础上实现了该分页组件,在视图层使用JQuery实现了一个与后台开发框架完全分离的分页页面组件,在后台使用泛型和桥接模式实现了分页查询的封装。
应用结果表明该组件能够满足日常开发中的所有应用场景,且具有较好的移植性和稳定性。
关键词:分页组件;查询优化;分页框架;Spring框架中图分类号:TP311 文献标识码:A 文章编号:1009-3044(2014)03-0514-06在企业级应用开发中,对业务实体信息的多条件组合过滤查询是基本功能之一。
针对客户的查询要求,服务器可以一次性将符合条件的所有数据推送给客户端,但这种方式只适合返回少量数据集的情况。
针对大型和超大型数据集,服务器必须采用分页的方式将符合要求的数据以分页的方式推送给客户端。
文献[1]提出了一种基于MVC的分页组件,但对应的查询语句写死在分页抽象类中,这就导致了该分页组件没办法满足多条件组合过滤查询和对结果集按照特定属性进行排序等应用场景。
文献[2]使用泛型DAO实现了支持多条件组合查询和对结果集进行排序的分页组件,但是实现方法是将查询过滤条件和排序字段以键值对的方式存放在Map 中,这就要求业务开发者在处理分页查询时需要进行二次加工,将过滤条件或者排序条件按照预定好的方式组成键值对推入到预定义好的Map变量中,这种方式将界面查询元素和分页查询处理代码进行了紧耦合,不但增加了程序调试和维护的难度,且增加了业务开发者的工作量。
另外上述两种方法也都是针对单个对象的分页查询应用,对多个对象间关联查询的应用场景支持不了,而在实际企业应用中,这种多表关联查询的分页查询业务场景非常多,且分页的多个查询条件通常是动态组合的。
在多条件动态组合查询业务场景中,对于有N个查询条件,这N个查询条件的不同拼接顺序得到的不同JPQL或者SQL语句在执行效率方面相差非常大[3-5],因此在数据查询业务中需要给业务开发人员提供足够的开发灵活性,让其在拼接查询语句时可以根据数据库表的设计、数据量和对应SQL优化器的工作原理对查询条件进行拼接,取得最优的执行效率。
针对上述问题,本文提出了一种改进的Web分页组件方法,在实现分页查询封装的同时给业务开发者提供足够的开发灵活性,在满足分页组件的可扩展性和可移植性要求的同时,达到提高代码可维护性、增加业务开发者的开发灵活性和提高最终应用软件的执行效率等目的。
1 相关实现技术1.1 Spring MVCSpring框架提供了构建Web应用程序的全功能MVC模块,是一种高度可配置的MVC框架,可以定制本地化和主题解析,并提供多种视图技术,实现了控制器、模型对象、分派器以及处理程序对象的多角色分离,这种分离让它们更容易进行定制,在视图层,Spring提供了视图解析器使其可以在浏览器中直接显示模型数据 [6-7]。
1.2 Java泛型泛型是程序设计语言的一种特性,允许程序员在强类型程序设计语言中编写代码时定义一些可变部分,对于这些可变部分允许在其使用前再声明具体的类型,Java泛型是Java SE 1.5及以上版本的新特性。
在Java编程中,常常用到在容器中存放对象或从容器中取出对象,并根据实际情况转型为相应的对象,但在转型过程中极易出现错误,且很难发现。
而使用泛型则可以在存取对象时明确指名对象的类型,将问题暴露在编译阶段,由编译器检测,从而避免Java 在运行时出现转型异常,增加程序的可读性与稳定性,提高程序的运行效率[1]。
1.3 JPAJPA(Java Persistence API)通过注解或XML描述对象-关系表的映射关系,并将运行期的实体对象持久化到数据库中。
由于传统的O/R 映射解决方案太多,不方便开发人员的学习和使用,JPA则提供了数据访问的统一规范和标准[1]。
JPA包括以下优势:1)标准化;2)简单易用,集成方便;3)可媲美JDBC 的查询能力。
1.4 JQueryJQuery是一个轻量级的JavaScript脚本,支持cssl、css2、css3定义的属性和选择器,兼容多种浏览器。
开发人员除了可以使用JQuery自身带有的显示和隐藏元素特效外,还可以通过插件实现更多功能,如表单验证、Tab导航、拖放效果、表格排序、树形菜单、图像特效以及Ajax上传等,极大地方便了开发人员快速开发动态效果网页。
2 分页组件业务架构设计当前大部分web应用都采用了MVC架构模式,该模式把软件系统分为模型(Mode1)、视图(View)和控制器(Controller) 3个部分,其中Model对象包含数据,View对象负责显示有模型包含的数据,用于与用户交互,Controller对象是介于Model与View之间的桥梁,它可以分发和处理用户的请求,选择适当的视图用于显示模型包含的数据返回给用户[8]。
因此分页组件需要灵活适应这种开发架构模式,为业务开发者提供一个既能满足各种业务需求的分页组件,提高程序开发者的工作效率和开发灵活性,同时也能够提高整个软件的代码可读性和扩展性。
与MVC架构模式对应,分页组件的整体业务架构设计图也分为视图层、控制器层和模型层,具体如图1所示。
在视图层,分页组件提供了一个可以随意嵌入的分页页面组件,该页面负责分页信息的展示、分页功能(比如上一页、下一页等)的触发事件监听和分页信息的传递;在模型层,提供记录分页信息和结果集数据的Page对象;在控制器层,为了给业务开发者提供足够的开发灵活性,业务开发者只需要实现分页接口并实现对应的分页查询方法即可,具体分页查询业务代码则可以根据实际的业务逻辑和数据库设计灵活定制。
整个分页处理过程可以分为如下四个步骤:1)用户通过业务展现页面向Web服务器发出各种查询条件和分页信息,分页信息具体包括当前页数、每页显示记录数等信息。
2)业务逻辑层相应方法接收查询条件对象和Page对象,然后调用数据层对应DAO的分页查询方法。
3)数据层的分页查询方法根据查询条件对象里面的查询条件,动态组装查询条件,然后调用数据访问方法,获取结果数据后将整个数据集的情况和满足条件的结果记录集存储到Page对象中,并返回给业务逻辑层;业务开发人员在分页查询方法中可以根据实际业务情况和数据库设计自由定制查询语句。
4)视图层根据Page对象数据结构访问对应的数据成员,分别展现业务数据和分页数据,其中视图层由业务展现页面和分页页面组件组成,业务展现页面负责展现符合条件的业务数据记录集,分页页面组件负责展现分页信息。
3 分页组件实现3.1 完全分离的分页页面组件实现为了实现分页页面的直接复用,一般分页页面都是以一个独立的页面组件嵌入到需要分页的主页中,但分页功能需要与后台服务进行数据交换,因此大部分实现方案都是通过在分页页面组件中使用自定义的标签或者第三方开源框架标签,如Struts标签等[9]。
这种实现方式一定程度上限制了分页页面组件的移植,一旦后台使用的第三方开源框架发生变化,则分页页面组件使用的标签库也需要随之改变。
为了实现与后台第三方开发框架完全分离的分页页面组件,本文在分页页面组件中采用了纯JS来实现分页页面组件与后台的数据交换功能,具体的JS实现则采用JQuery来实现。
首先在分页页面组件加载时,针对页面上的每个按钮注册对应的监听事件,当对应的按钮发生事件时,则触发对应的监听功能方法,在功能方法中则通过以下几步来完成与后台的服务器请求:获取页面输入项的值、检验输入值的合法性、截取嵌入主页的服务地址、组装分页信息page对象、动态设置嵌入主页面的后台服务地址和触发业务展现页面的查询按钮向服务器发起数据请求,具体的分页页面组件处理流程图如图2所示。
页面组件的使用方式与其他分页组件使用方法相似,业务展现页面只需要通过方法将分页页面组件page.jsp包含进去即可,不需要另外再添加任何其他代码。
3.2 传递分页信息的Page类定义及描述Page对象负责将用户设置的分页信息通过Action传递给数据查询Dao,以及将查询后的结果传递给页面,基于泛型进行Page对象进行设计,定义为public class Page,类的实现主要包括四部分:1)分页信息私有成员,包括待分页显示记录总数totalRows、默认每页显示的记录数pageSize,当前页页码currentPage、记录集的总页数、开始行数startRow;2)符合要求的分页数据集私有成员,用于存储符合查询条件的当前页面显示具体内容,定义为private List list;3)构造函数,需要往构造函数传递总记录行数和每行显示的记录数(可选),构造函数根据传递进来的值设置记录总数、计算偏移量、实际显示记录数以及页码值校正;4)私有成员的getter和setter方法,针对1)和2)中的私有成员,形成其getter和setter方法。
根据以上设计,Page类的主要实现代码如下所示:public class Pager {private int totalRows;//总行数private int pageSize = 15;//页面行数private int currentPage;//当前页private int totalPages;//总页数private int startRow;//开始行private List list;//当前页数据public Pager(int _totalRows,int _pageSize) {pageSize = _pageSize;totalRows = _totalRows;totalPages = totalRows / pageSize;int mod = totalRows % pageSize;if (mod > 0) {totalPages++;}currentPage = 1;startRow = 0;}… … //不含_pageSize的构造函数… … //成员变量的getter和setter方法}3.3 分页查询处理业务逻辑分页查询一般都是在一个较大的数据集上做查询,并根据一个或者多个条件对数据集过滤进行精确查询,而对于不同的数据库表结构和索引字段,过滤条件组合的先后顺序和多表连接查询时表连接的顺序对查询效率影响较大,因此分页查询在实现封装的同时还需要给业务开发者一定的灵活性,以达到分页查询的执行效率最优化。
文献[8]使用“IDAO+DAO”的实现模式对分页查询进行了封装,该方式较好的将DAO的实现部分与使用它的Action进行了分离,但是它将查询字段信息和数据库表信息通过字符串的方式从页面一直传递到DAO,对DAO和页面进行了紧耦合,不利于程序的扩展和理解;文献[2] 采用“泛型+反射+桥梁”模式对分页查询封装进行了改进,但是它将查询语句封装到开发人员不能修改的GerneticDAO中,导致该模式不能支持多表连接查询和多条件组合查询的业务需求。
php列表页多条件筛选功能开发实例

一、背景介绍随着互联网的发展,各种全球信息站和应用程序已经成为人们日常生活的一部分。
对于信息丰富的全球信息站来说,用户通常需要对所需信息进行筛选,以便快速找到自己需要的内容。
列表页多条件筛选功能成为了许多全球信息站开发中的重要环节。
本文将以PHP语言为例,介绍如何开发一个高效、灵活的列表页多条件筛选功能。
二、功能要求在开发列表页多条件筛选功能时,我们需要考虑以下几个功能要点: 1. 多条件筛选:用户可以根据自己的需求选择不同的条件,例如价格范围、发布时间、地区等。
2. 筛选结果实时更新:当用户选择了筛选条件后,页面内容应该能够实时更新,展示符合条件的内容。
3. 友好用户交互:在用户进行条件选择时,页面应该提供清晰、易懂的交互界面,以方便用户操作。
三、开发步骤为了实现列表页多条件筛选功能,我们可以按照以下步骤进行开发: 1. 数据库准备:我们需要在数据库中存储需要筛选的信息,并建立好相应的数据表结构。
对于商品列表页,我们可以创建一个包含价格、发布时间、地区等字段的商品表。
2. 后端逻辑处理:在PHP后端中,我们需要编写逻辑代码来处理用户的筛选请求。
这可能涉及到SQL查询语句的构建,根据用户选择的条件筛选相应的数据。
3. 前端交互设计:在前端页面中,我们需要设计用户交互界面,以方便用户选择筛选条件。
这可能涉及到使用HTML、CSS和JavaScript来构建交互界面,以及与后端进行数据交互。
四、实例演示为了更好地理解列表页多条件筛选功能的开发过程,我们将逐步演示一个商品列表页的多条件筛选功能实例。
假设我们有一个商品表,包含商品名称、价格、发布时间和地区四个字段。
1. 数据库准备:我们首先在数据库中创建一个名为"products"的表,包含名称为"name"、"price"、"release_time"和"location"的字段。
oracle sql developer过滤器用法

oracle sql developer过滤器用法一、简介Oracle SQL Developer是一款强大的数据库工具,它提供了丰富的功能,包括查询、过滤、排序等。
过滤器是SQL Developer中一个重要的功能,它可以帮助我们筛选出符合特定条件的数据,提高查询效率。
二、过滤器的基本用法1. 创建过滤器:在SQL Developer的查询窗口中,我们可以通过创建过滤器来限定查询范围。
过滤器通常通过创建WHERE子句来实现,如"WHERE column = value"。
2. 添加多个过滤条件:我们可以使用AND或OR来组合多个过滤条件。
AND用于所有条件都必须满足,而OR则表示只要满足其中一个条件即可。
3. 使用通配符:SQL Developer支持使用通配符进行模糊查询。
常用的通配符有百分号(%)和下划线(_)。
三、高级过滤器用法1. 日期过滤:SQL Developer支持日期过滤,可以使用DATE函数和比较运算符来筛选日期数据。
2. 聚合函数过滤:SQL Developer支持使用聚合函数进行过滤,如SUM、COUNT等。
3. 动态过滤:SQL Developer还支持动态创建和修改过滤器,可以根据查询结果实时调整过滤条件。
四、注意事项1. 确保过滤器的语法正确,否则可能无法得到预期的结果。
2. 合理使用过滤器可以提高查询效率,但过度使用可能导致查询变得复杂和耗时。
3. 在使用通配符进行模糊查询时,要注意避免SQL注入攻击。
五、总结过滤器是SQL Developer中一个非常实用的功能,它可以帮助我们快速筛选出符合特定条件的数据。
通过了解和掌握过滤器的用法,我们可以更好地利用SQLDeveloper进行数据库操作。
希望本文能够帮助你更好地理解和使用Oracle SQL Developer的过滤器功能。
如有任何疑问,请随时联系我们。
unigridcolumnfilter过滤时间-概述说明以及解释
unigridcolumnfilter过滤时间-概述说明以及解释1.引言1.1 概述概述部分旨在向读者介绍本文的主题和内容,提供背景信息以及引发读者对于UnigridColumnFilter时间过滤的兴趣。
本文将探讨UnigridColumnFilter的功能和使用方法,以及时间过滤在此过程中所面临的挑战和需求。
UnigridColumnFilter是一种常用的数据表格过滤工具,广泛应用于各种数据展示和分析的场景。
它的出现使得用户可以方便地通过表格的不同列进行筛选和过滤,以快速定位目标数据,提高数据处理和分析的效率。
然而,在实际应用中,特别是在包含时间字段的数据筛选场景中,UnigridColumnFilter可能遇到一些挑战。
传统的基于字符串匹配的过滤方法无法准确地筛选时间范围内的数据,导致用户对于时间过滤功能的期望无法完全满足。
因此,本文将重点关注如何利用UnigridColumnFilter 实现时间过滤的需求,并探讨解决这一挑战的可能方案。
通过本文的阅读,读者将能够了解UnigridColumnFilter的基本概念和使用方法,深入理解时间过滤的需求和挑战,并在结尾处对于未来时间过滤的发展提出自己的展望。
同时,读者还将能够了解到UnigridColumnFilter在实际应用中的优点和应用场景,以及时间过滤的解决方案和效果评估。
接下来,本文将首先介绍背景信息,为读者提供更全面的上下文理解。
然后,将详细探讨UnigridColumnFilter的功能和使用方法。
接着,我们将进一步探讨时间过滤的需求和挑战,并提出解决方案和效果评估。
最后,文章将总结UnigridColumnFilter的优点和应用场景,展望未来时间过滤的发展。
1.2 文章结构本文主要分为以下几个部分来讨论UnigridColumnFilter过滤时间的相关内容。
1. 引言:在引言部分,我们将对UnigridColumnFilter的概述进行简要介绍。
Habse中Rowkey的设计原则——通俗易懂篇
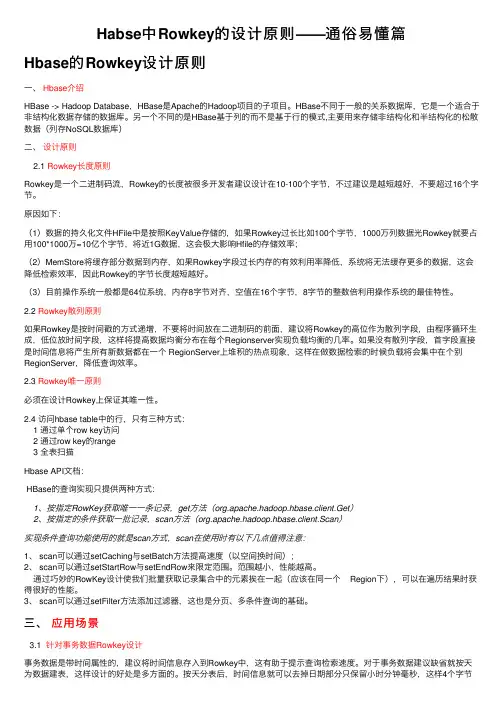
即可搞定。加上散列字段2个字节一共6个字节即可组成唯一 Rowkey。如下图所示:
事务数据Rowkey设计
第0字节
第1字节
第2字节 第3字节 第4字节 第5字节 …
散列字段
时间字段(毫秒)
扩展字段
0~65535(0x0000~0xFFFF) 0~86399999(0x00000000~0x05265BFF)
为了避免写热点,设计rowkey使得不同行在同一个region,但是在更多数据情况下,数据应该被写入集群的多个region,而 不是一个。
下面是一些常见的避免热点的方法以及它们的优缺点:
1. 加盐
这里所说的加盐不是密码学中的加盐,而是在rowkey的前面增加随机数,具体就是给rowkey分配一个随机前缀以使得它和之 前的rowkey的开头不同。分配的前缀种类数量应该和你想使用数据分散到不同的region的数量一致。加盐之后的rowkey就会 根据随机生成的前缀分散到各个region上,以避免热点。
3.1 反转rowkey的例子
以手机号为rowkey,可以将手机号反转后的字符串作为rowkey,这样的就避免了以手机号那样比较固定开头导致热点问题
3.2 时间戳反转
一个常见的数据处理问题是快速获取数据的最近版本,使用反转的时间戳作为rowkey的一部分对这个问题十分有用,可以用 Long.Max_Value - timestamp追加到key的末尾,例如[key][reverse_timestamp],[key]的最新值可以通过scan [key]获得[key] 的第一条记录,因为HBase中rowkey是有序的,第一条记录是最后录入的数据。
3、 scan可以通过setFilter方法添加过滤器,这也是分页、多条件查询的基础。
使用JPA+querydsl如何实现多条件动态查询
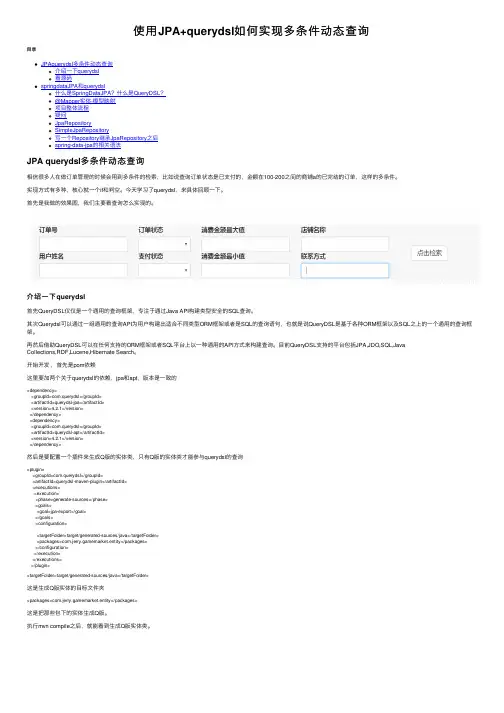
使⽤JPA+querydsl如何实现多条件动态查询⽬录JPAquerydsl多条件动态查询介绍⼀下querydsl看源码springdataJPA和querydsl什么是SpringDataJPA?什么是QueryDSL?@Mapper实体-模型映射项⽬整体流程疑问JpaRepositorySimpleJpaRepository写⼀个Repository继承JpaRepository之后spring-data-jpa的相关语法JPA querydsl多条件动态查询相信很多⼈在做订单管理的时候会⽤到多条件的检索,⽐如说查询订单状态是已⽀付的,⾦额在100-200之间的商铺a的已完结的订单,这样的多条件。
实现⽅式有多种,核⼼就⼀个if和判空。
今天学习了querydsl,来具体回顾⼀下。
⾸先是我做的效果图,我们主要看查询怎么实现的。
介绍⼀下querydsl⾸先QueryDSL仅仅是⼀个通⽤的查询框架,专注于通过Java API构建类型安全的SQL查询。
其次Querydsl可以通过⼀组通⽤的查询API为⽤户构建出适合不同类型ORM框架或者是SQL的查询语句,也就是说QueryDSL是基于各种ORM框架以及SQL之上的⼀个通⽤的查询框架。
再然后借助QueryDSL可以在任何⽀持的ORM框架或者SQL平台上以⼀种通⽤的API⽅式来构建查询。
⽬前QueryDSL⽀持的平台包括JPA,JDO,SQL,JavaCollections,RDF,Lucene,Hibernate Search。
开始开发,⾸先是pom依赖这⾥要加两个关于querydsl的依赖,jpa和apt,版本是⼀致的<dependency><groupId>com.querydsl</groupId><artifactId>querydsl-jpa</artifactId><version>4.2.1</version></dependency><dependency><groupId>com.querydsl</groupId><artifactId>querydsl-apt</artifactId><version>4.2.1</version></dependency>然后是要配置⼀个插件来⽣成Q版的实体类,只有Q版的实体类才能参与querydsl的查询<plugin><groupId>com.querydsl</groupId><artifactId>querydsl-maven-plugin</artifactId><executions><execution><phase>generate-sources</phase><goals><goal>jpa-export</goal></goals><configuration><targetFolder>target/generated-sources/java</targetFolder><packages>com.jerry.gamemarket.entity</packages></configuration></execution></executions></plugin><targetFolder>target/generated-sources/java</targetFolder>这是⽣成Q版实体的⽬标⽂件夹<packages>com.jerry.gamemarket.entity</packages>这是把那些包下的实体⽣成Q版。
filter函数的用法多条件

filter函数的用法多条件以下是filter函数的基本形式:```python```其中,function是一个判断函数,它接收一个元素作为参数,并返回一个布尔值。
iterable是一个可迭代对象,可以是列表、元组、字符串、集合等。
下面我们将详细介绍filter函数的多条件用法。
1. 使用lambda函数进行判断可以使用lambda函数作为filter函数的判断条件,lambda函数是一种匿名函数,可以定义在函数内部或单独使用。
假设我们有一个列表,需要筛选出大于5且为奇数的元素,可以这样写:```pythonmy_list = [1, 2, 3, 4, 5, 6, 7, 8, 9]result = filter(lambda x: x > 5 and x % 2 != 0, my_list)print(list(result)) # 输出:[7, 9]```lambda函数中的x代表列表的每个元素,冒号后面的表达式用来判断元素是否满足条件。
在这里,我们结合了两个条件:大于5和为奇数。
2.使用多个条件进行判断除了使用lambda函数进行判断外,我们还可以使用多个条件进行判断。
在这种情况下,可以定义一个普通的判断函数,接收元素作为参数,并返回布尔值。
假设我们有一个字典列表,需要筛选出年龄大于20且性别为女性的元素,可以这样写:```pythonmy_list ={'name': 'Alice', 'age': 18, 'gender': 'female'},{'name': 'Bob', 'age': 25, 'gender': 'male'},{'name': 'Charlie', 'age': 22, 'gender': 'male'},{'name': 'Diana', 'age': 30, 'gender': 'female'}def filter_func(element):return element['age'] > 20 and element['gender'] == 'female' result = filter(filter_func, my_list)print(list(result)) # 输出:[{'name': 'Diana', 'age': 30, 'gender': 'female'}]```在这个例子中,我们首先定义了一个名为filter_func的函数,接收元素作为参数,并返回一个布尔值。
多条件分页查询优化的设计方法
S Lsae n eo t zddvc dp gn g rh , dtru hteaayi o ert a fr a de p r na eut t on u Q tme tnt p mie e i a aiga oi msa og l s ft oe cl ne n x e me t rsl,op it t t i h i en l t n h h n s h i i s i l s o
LI Hu . ANG Ru - o iW ib
( olg fnoma o c nea d eh oo yB in nvri f hmia e h oo yBe ig10 2 ) C l eo fr t nS i c n c n lg , e igU ies yo e cl cn lg , in 0 0 9 e I i e T j t C T j
二 是寻找查询效率最 高的分页 方法 。
1 分页查询优化方法
数据库分页查询处理的开销通常取决于 2个方面 :一是 磁盘读写的 I / O次数 ;二是 C U 的处理时 间。 P
1 . 多条件组合查询 的 S .1 2 QL优化算法 在 所开发的项 目中常常需要对输入条件进行动态组合查 询 ,如果输 入 A1A , 22个查询条件 ,其中有 A1A , A , 2 A1 2和
o a a a e Th s p p rb g n t e a a y i fk y f c o i h i a tt e s e d o g n u r , o i i g wi e o t i ai n t e r f fd tb s . i a e e i swi t l s so e a t r wh c mp c p e fpa i g q e c mb n n t t p i z to o y o h h n s h y h h m h
searchsourcebuilder用法
搜索源构建器(SearchSourceBuilder)是Elasticsearch中用于配置搜索请求的重要工具。
在Elasticsearch中,搜索请求需要使用搜索源构建器来定义搜索的条件、过滤器、聚合和其他参数。
本文将深入探讨搜索源构建器的用法,并为您提供详细的指导和示例。
1. 什么是搜索源构建器?搜索源构建器是Elasticsearch中用于构建搜索请求的一个重要组件。
它可以帮助您定义搜索的条件、返回的字段、文档的排序方式、聚合、分页等参数。
通过使用搜索源构建器,您可以灵活地控制搜索请求的各个方面,从而实现定制化的搜索需求。
2. 搜索源构建器的基本结构搜索源构建器使用JSON格式来定义搜索请求的各个参数。
下面是一个简单的搜索源构建器的基本结构示例:```json{"query": {// 查询条件},"from": 0,"size": 10,"sort": [// 排序方式],"_source": {// 返回的字段},"aggs": {// 聚合}}```在上面的示例中,query字段用于定义查询条件,from和size字段用于定义分页的参数,sort字段用于定义排序方式,_source字段用于指定返回的字段,aggs字段用于定义聚合。
3. 使用搜索源构建器进行查询现在让我们来看一个实际的例子,假设我们需要搜索某个索引中所有芳龄大于30岁的用户,并按照他们的注册时间进行倒序排序。
我们可以使用搜索源构建器来实现这个查询:```json{"query": {"range": {"age": {"gt": 30}}},"sort": [{"registration_date": {"order": "desc"}]}}```在上面的示例中,我们使用了range查询来定义芳龄大于30岁的条件,并使用sort字段来定义排序方式。
kettle学习笔记及最佳实践
kettle学习笔记及最佳实践最近在⽤kettle迁移数据,从对kettle⼀点不会到⽐较熟悉,对于期间的⼀些问题和坑做了记录和总结,内容涵盖了使⽤的经验和技巧,踩到的坑、最佳实践和优化前后结果对⽐。
常⽤转换组件1. 计算形成新字段:只限算术运算,并且选择固定2. 过滤记录:元表某字段按照某个条件分流,满⾜条件的到⼀个表,不满⾜的到另⼀个表,这两个⽬标表都必须有。
3. Switch/Case:和过滤记录类似,可以多个条件判断,并且有默认转向条件,可以完美替换过滤记录组建4. 记录分组:group by 组建未能正常按照预期理解运⾏5. 设置为NULL:将某个特定值设置为NULL6. ⾏扁平化:⾏扁平化,使⽤与某条件下某名称对应的⾏数相同的情况7. ⾏列转换:⾏转成列,使⽤Row Normalizer组件,事先⼀定要是根据分组字段排好序,关键字段就是name列字段,分组字段就是按照什么分组,⽬标字段就是⾏转列之后形成的字段列表。
8.字段选择:选择需要的⽬的列到⽬标表,并且量表的对应字段不⼀样时可以⽤来做字段映射8. 排序:分组前先排序可以提⾼效率9. 条件分发:根据条件分发,相当与informatica的router组件10. 值映射:相当与oracle的decode函数,源和⽬标字段同名的话,只要写源字段就可以了#常⽤输⼊组件1. 表输⼊:源表输⼊2. ⽂本⽂件输⼊:⽂本⽂件输⼊3. xml⽂件输⼊:使⽤Get Data From XML组件,可以在其中使⽤xpath来选择数据4. JsonInput:貌似在中⽂环境下组件⾯板⾥看不到,切换到英⽂模式就看到了#常⽤输出组件1. 表输出:表输出2. ⽂本⽂件输出:⽂本⽂件输出3. XML⽂件输出:输出的XML⽂件是按照记录⾏存储的,字段名为元素名4. Excel⽂件输出:输出的excel⽂件是按照记录⾏存储的,字段名为元素名5. 删除:符合⽐较条件的记录将删除6. 更新:注意两个表都要有主键才可以7. 插⼊/更新:速度太慢,不建议使⽤8. 检查字段是否存在:若在则家⼀个标志位,值可以是Y/N9. 等值连接:有关联关系字段可以关联,其它的不关联。
(十二)c#Winform自定义控件-分页控件-HZHControls
(⼗⼆)c#Winform⾃定义控件-分页控件-HZHControls 前提⼊⾏已经7,8年了,⼀直想做⼀套漂亮点的⾃定义控件,于是就有了本系列⽂章。
如果觉得写的还⾏,请点个 star ⽀持⼀下吧欢迎前来交流探讨:企鹅群568015492⽬录准备⼯作当⼀个列表加载数据过多时,⽐如datagridview,如果数据过多,则可能超出内存,相应慢等问题,此时需要⽤到翻页控件。
设计思路,对翻页控件定义接⼝,基类实现,如果所列的翻页控件样式或功能⽆法满⾜你的需求的话,你只需要基类翻页控件基类或者实现接⼝即可。
定义接⼝是因为后⾯的⼀些列表控件内置了翻页控件,为了达到兼容扩展,所有使⽤了接⼝定义约束。
开始⾸先需要⼀个分页事件⽤到的委托,偷懒,只写了⼀个[Serializable][ComVisible(true)]public delegate void PageControlEventHandler(object currentSource);我们先定义⼀个接⼝IPageControl1public interface IPageControl2 {3///<summary>4///数据源改变时发⽣5///</summary>6event PageControlEventHandler ShowSourceChanged;7///<summary>8///数据源9///</summary>10 List<object> DataSource { get; set; }11///<summary>12///显⽰数量13///</summary>14int PageSize { get; set; }15///<summary>16///开始下标17///</summary>18int StartIndex { get; set; }19///<summary>20///第⼀页21///</summary>22void FirstPage();23///<summary>24///前⼀页25///</summary>26void PreviousPage();27///<summary>28///下⼀页29///</summary>30void NextPage();31///<summary>32///最后⼀页33///</summary>34void EndPage();35///<summary>36///重新加载37///</summary>38void Reload();39///<summary>40///获取当前页数据41///</summary>42///<returns></returns>43 List<object> GetCurrentSource();44///<summary>45///总页数46///</summary>47int PageCount { get; set; }48///<summary>49///当前页52 }然后定义⼀个分页基类控件,添加⼀个⽤户控件,命名UCPagerControlBase,并实现接⼝IPageControl 看下属性1///<summary>2///总页数3///</summary>4public virtual int PageCount5 {6get;7set;8 }9private int m_pageIndex = 1;10///<summary>11///当前页码12///</summary>13public virtual int PageIndex14 {15get { return m_pageIndex; }16set { m_pageIndex = value; }17 }18///<summary>19///关联的数据源20///</summary>21public virtual List<object> DataSource { get; set; }22public virtual event PageControlEventHandler ShowSourceChanged;23private int m_pageSize = 1;24///<summary>25///每页显⽰数量26///</summary>27 [Description("每页显⽰数量"), Category("⾃定义")]28public virtual int PageSize29 {30get { return m_pageSize; }31set { m_pageSize = value; }32 }33private int startIndex = 0;34///<summary>35///开始的下标36///</summary>37 [Description("开始的下标"), Category("⾃定义")]38public virtual int StartIndex39 {40get { return startIndex; }41set42 {43 startIndex = value;44if (startIndex <= 0)45 startIndex = 0;46 }47 }然后定义虚函数,并做⼀些默认实现///<summary>///第⼀页///</summary>public virtual void FirstPage(){if (DataSource == null)return;startIndex = 0;var s = GetCurrentSource();if (ShowSourceChanged != null){ShowSourceChanged(s);}}///<summary>///上⼀页///</summary>public virtual void PreviousPage(){if (DataSource == null)return;if (startIndex == 0)return;startIndex -= m_pageSize;if (startIndex < 0)startIndex = 0;var s = GetCurrentSource();if (ShowSourceChanged != null){ShowSourceChanged(s);///<summary>///下⼀页///</summary>public virtual void NextPage(){if (DataSource == null)return;if (startIndex + m_pageSize >= DataSource.Count){return;}startIndex += m_pageSize;if (startIndex < 0)startIndex = 0;var s = GetCurrentSource();if (ShowSourceChanged != null){ShowSourceChanged(s);}}///<summary>///最后⼀页///</summary>public virtual void EndPage(){if (DataSource == null)return;startIndex = DataSource.Count - m_pageSize;if (startIndex < 0)startIndex = 0;var s = GetCurrentSource();if (ShowSourceChanged != null){ShowSourceChanged(s);}}///<summary>///刷新数据///</summary>public virtual void Reload(){var s = GetCurrentSource();if (ShowSourceChanged != null){ShowSourceChanged(s);}}///<summary>///获取当前页数据///</summary>///<returns></returns>public virtual List<object> GetCurrentSource(){if (DataSource == null)return null;int intShowCount = m_pageSize;if (intShowCount + startIndex > DataSource.Count)intShowCount = DataSource.Count - startIndex;object[] objs = new object[intShowCount];DataSource.CopyTo(startIndex, objs, 0, intShowCount);var lst = objs.ToList();bool blnLeft = false;bool blnRight = false;if (lst.Count > 0){if (DataSource.IndexOf(lst[0]) > 0){blnLeft = true;}else{blnLeft = false;}if (DataSource.IndexOf(lst[lst.Count - 1]) >= DataSource.Count - 1) {blnRight = false;}else{blnRight = true;}}ShowBtn(blnLeft, blnRight);return lst;}///控制按钮显⽰///</summary>///<param name="blnLeftBtn">是否显⽰上⼀页,第⼀页</param>///<param name="blnRightBtn">是否显⽰下⼀页,最后⼀页</param>protected virtual void ShowBtn(bool blnLeftBtn, bool blnRightBtn){ }如此基类就完成了,看下完整代码1// 版权所有黄正辉交流群:568015492 QQ:6231286292// ⽂件名称:UCPagerControlBase.cs3// 创建⽇期:2019-08-15 16:00:414// 功能描述:PageControl5// 项⽬地址:https:///kwwwvagaa/net_winform_custom_control6using System;7using System.Collections.Generic;8using ponentModel;9using System.Drawing;10using System.Data;11using System.Linq;12using System.Text;13using System.Windows.Forms;1415namespace HZH_Controls.Controls16 {17 [ToolboxItem(false)]18public class UCPagerControlBase : UserControl, IPageControl19 {20#region构造21///<summary>22///必需的设计器变量。