
统计学附录_F分布,t分布临界值表_全
统计学附录 F—分布临界值表
——α(0.005―0.10)
α=0.005
Fα
k1
k2 1 2 3 4 5 6 8 12 24 ∞
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
16211
198.5
55.55
31.33
22.78
18.63
16.24
14.69
13.61
12.83
12.23
11.75
11.37
11.06
10.80
10.58
10.38
10.22
10.07
9.94
20000
199.0
49.80
26.28
18.31
14.45
12.40
11.04
10.11
9.43
8.91
8.51
8.19
7.92
7.70
7.51
7.35
7.21
7.09
6.99
21615
199.2
47.47
24.26
16.53
12.92
10.88
9.60
8.72
8.08
7.60
7.23
6.93
6.68
6.48
6.30
6.16
6.03
5.92
5.82
22500
199.2
46.19
23.15
15.56
12.03
10.05
8.81
7.96
7.34
6.88
6.52
6.23
6.00
5.80
5.64
5.50
5.37
5.27
5.17
23056
199.3
45.39
22.46
14.94
11.46
9.52
8.30
7.47
6.87
6.42
6.07
5.79
5.56
5.37
5.21
5.07
4.96
4.85
4.76
23437
199.3
44.84
21.97
14.51
11.07
9.16
7.95
7.13
6.54
6.10
5.76
5.48
5.26
5.07
4.91
4.78
4.66
4.56
4.47
23925
199.4
44.13
21.35
13.96
10.57
8.68
7.50
6.69
6.12
5.68
5.35
5.08
4.86
4.67
4.52
4.39
4.28
4.18
4.09
24426
199.4
43.39
20.70
13.38
10.03
8.18
7.01
6.23
5.66
5.24
4.91
4.64
4.43
4.25
4.10
3.97
3.86
3.76
3.68
24940
199.5
42.62
20.03
12.78
9.47
7.65
6.50
5.73
5.17
4.76
4.43
4.17
3.96
3.79
3.64
3.51
3.40
3.31
3.22
25465
199.5
41.83
19.32
12.14
8.88
7.08
5.95
5.19
4.64
4.23
3.90
3.65
3.44
3.26
3.11
2.98
2.87
2.78
2.69
21
22
23
24
25
26
27
28
29
30
40
60
120 9.83
9.73
9.63
9.55
9.48
9.41
9.34
9.28
9.23
9.18
8.83
8.49
8.18 6.89
6.81
6.73
6.66
6.60
6.54
6.49
6.44
6.40
6.35
6.07
5.79
5.54 5.73
5.65
5.58
5.52
5.46
5.41
5.36
5.32
5.28
5.24
4.98
4.73
4.50 5.09
5.02
4.95
4.89
4.84
4.79
4.74
4.70
4.66
4.62
4.37
4.14
3.92 4.68
4.61
4.54
4.49
4.43
4.38
4.34
4.30
4.26
4.23
3.99
3.76
3.55 4.39
4.32
4.26
4.20
4.15
4.10
4.06
4.02
3.98
3.95
3.71
3.49
3.28 4.01
3.94
3.88
3.83
3.78
3.73
3.69
3.65
3.61
3.58
3.35
3.13
2.93 3.60
3.54
3.47
3.42
3.37
3.33
3.28
3.25
3.21
3.18
2.95
2.74
2.54 3.15
3.08
3.02
2.97
2.92
2.87
2.83
2.79
2.76
2.73
2.50
2.29
2.09 2.61
2.55
2.48
2.43
2.38
2.33
2.29
2.25
2.21
2.18
1.93
1.69
1.43
α=0.01
Fα
k1
k2 1 2 3 4 5 6 8 12 24 ∞
1
2
3
4
5
6
7 4052
98.49
34.12
21.20
16.26
13.74
12.25 4999
99.01
30.81
18.00
13.27
10.92
9.55 5403
99.17
29.46
16.69
12.06
9.78
8.45 5625
99.25
28.71
15.98
11.39
9.15
7.85 5764
99.30
28.24
15.52
10.97
8.75
7.46 5859
99.33
27.91
15.21
10.67
8.47
7.19 5981
99.36
27.49
14.80
10.29
8.10
6.84 6106
99.42
27.05
14.37
9.89
7.72
6.47 6234
99.46
26.60
13.93
9.47
7.31
6.07 6366
99.50
26.12
13.46
9.02
6.88
5.65
t检验临界值
t检验临界值
在统计学中,我们经常需要比较两组数据的均值,以确定它们是否存在显著差异。这时就需要使用t检验来进行判断。t检验的基本思想是通过计算两组样本的均值差异,进而判断这种差异是否由抽样误差引起,还是由于总体均值的差异。在进行t检验时,我们需要将计算得到的t值与临界值进行比较,以确定差异是否显著。
临界值是进行t检验时的一个重要参考数值。在进行t检验时,我们需要设定一个显著性水平,通常为0.05或0.01。这个显著性水平决定了我们对差异的接受程度。临界值是根据显著性水平和样本量来计算得到的,它代表了在显著性水平下,t值应达到的最小值。如果计算得到的t值大于临界值,则可以认为两组数据的均值差异是显著的,反之则认为差异不显著。
临界值的计算通常需要查找t分布表。在查表时,我们需要知道自由度和显著性水平。自由度是指进行t检验时样本中独立观测值的数量减去约束的数量。自由度的大小决定了t分布的形状和临界值的大小。显著性水平则是我们事先设定的,一般为0.05或0.01。根据自由度和显著性水平,我们可以在t分布表中找到对应的临界值。
在实际应用中,我们通常会计算得到一个t值,然后与临界值进行比较,以判断差异的显著性。如果t值大于临界值,则可以拒绝原假设,即认为差异显著;反之,则接受原假设,认为差异不显著。
需要注意的是,临界值的大小与显著性水平和样本量有关。显著性水平越小,临界值越大,对差异的接受程度越高。而样本量越大,临界值越小,对差异的接受程度也越高。因此,在进行t检验时,我们需要根据具体情况选择合适的显著性水平和样本量,以获得可靠的检验结果。
t检验临界值是进行t检验时的一个重要参考数值,用于判断差异的显著性。在进行t检验时,我们需要计算得到t值,并与临界值进行比较。通过合理选择显著性水平和样本量,我们可以得出可靠的检验结果,从而对两组数据的均值差异进行判断。
t分布表_精品文档

t分布表
1. 什么是t分布表
t分布表(t-distribution table)是统计学中常用的一种参考表格,用于计算学生t分布的临界值。t分布是由William Gosset于1908年引入的,也被称为学生分布。与正态分布不同的是,t分布的形状取决于自由度。 自由度(degrees of
freedom,缩写为df)是t分布中的一个参数,表示数据集中的可用信息的数量。t分布在小样本情况下(自由度较低)更适用,而正态分布在大样本情况下更为适用。t分布表通过提供t分布的不同自由度和置信水平下的临界值,帮助研究人员进行统计推断。
2. t分布表的用途
t分布表的主要用途是计算t检验的临界值。t检验是一种用于比较两个样本均值之间差异的统计方法。通过比较计算出的t值与t分布表中的临界值,可以确定样本均值差异的显著性。在进行t检验时,需要指定置信水平和自由度,然后参考t分布表找到对应的临界值。
此外,t分布表还可用于计算统计推断中的置信区间。置信区间是对参数的估计范围,用于描述样本估计值与真实值之间的不确定性。通过查找t分布表,可以确定在给定的置信水平和样本大小下,t分布的临界值,从而得到参数的置信区间。
3. t分布表的构造
t分布表按照不同的自由度和置信水平划分为不同的表格,每个表格中包含了对应自由度和置信水平的t值。以表格的行表示自由度,表格的列表示置信水平。例如,当样本自由度为9,置信水平为95%时,在t分布表中可以找到一个特定的值,即为t(0.025, 9)。这个值是指在自由度为9的条件下,95%置信水平对应的t临界值。在进行t检验或计算置信区间时,可以通过查找t分布表得到相应的临界值。
需要注意的是,由于t分布的对称性质,t分布表中只提供了t值的正侧临界值。要获得t值的负侧临界值,可以通过对应正侧临界值取反得到。
4. 实际使用示例
假设现有一组实验数据,样本容量为15。我们想要计算该样本的平均值的置信区间。首先,我们需要选择置信水平,假设我们选择95%的置信水平。 根据给定的自由度(样本容量减去1)和置信水平,查找t分布表,可以确定两侧临界值。因为我们选择的是95%置信水平,所以我们需要查找t(0.025, 14)的值。 根据t分布表,我们找到t(0.025, 14)的值为2.145。 然后,我们需要计算样本的平均值和标准误差。假设样本平均值为25,标准误差为3。由于样本容量较小(小于30),我们使用t分布进行统计推断。 根据t分布的性质,样本平均值的置信区间可计算为: (25 - 2.145 * 3 / √15,25 +
统计学分布表(T分布,F分布,卡方分布,正态分布)
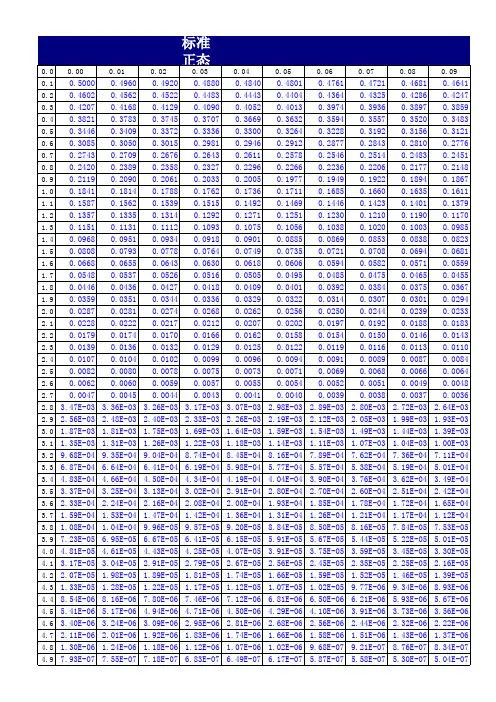
标准正态分布表0.00.000.010.020.030.040.050.060.070.080.090.10.50000.49600.49200.48800.48400.48010.47610.47210.46810.46410.20.46020.45620.45220.44830.44430.44040.43640.43250.42860.42470.30.42070.41680.41290.40900.40520.40130.39740.39360.38970.38590.40.38210.37830.37450.37070.36690.36320.35940.35570.35200.34830.50.34460.34090.33720.33360.33000.32640.32280.31920.31560.31210.60.30850.30500.30150.29810.29460.29120.28770.28430.28100.27760.70.27430.27090.26760.26430.26110.25780.25460.25140.24830.24510.80.24200.23890.23580.23270.22960.22660.22360.22060.21770.21480.90.21190.20900.20610.20330.20050.19770.19490.19220.18940.18671.00.18410.18140.17880.17620.17360.17110.16850.16600.16350.16111.10.15870.15620.15390.15150.14920.14690.14460.14230.14010.13791.20.13570.13350.13140.12920.12710.12510.12300.12100.11900.11701.30.11510.11310.11120.10930.10750.10560.10380.10200.10030.09851.40.09680.09510.09340.09180.09010.08850.08690.08530.08380.08231.50.08080.07930.07780.07640.07490.07350.07210.07080.06940.06811.60.06680.06550.06430.06300.06180.06060.05940.05820.05710.05591.70.05480.05370.05260.05160.05050.04950.04850.04750.04650.04551.80.04460.04360.04270.04180.04090.04010.03920.03840.03750.03671.90.03590.03510.03440.03360.03290.03220.03140.03070.03010.02942.00.02870.02810.02740.02680.02620.02560.02500.02440.02390.02332.10.02280.02220.02170.02120.02070.02020.01970.01920.01880.01832.20.01790.01740.01700.01660.01620.01580.01540.01500.01460.01432.30.01390.01360.01320.01290.01250.01220.01190.01160.01130.01102.40.01070.01040.01020.00990.00960.00940.00910.00890.00870.00842.50.00820.00800.00780.00750.00730.00710.00690.00680.00660.00642.60.00620.00600.00590.00570.00550.00540.00520.00510.00490.00482.70.00470.00450.00440.00430.00410.00400.00390.00380.00370.00362.83.47E-033.36E-033.26E-033.17E-033.07E-032.98E-032.89E-032.80E-032.72E-032.64E-032.92.56E-032.48E-032.40E-032.33E-032.26E-032.19E-032.12E-032.05E-031.99E-031.93E-033.01.87E-031.81E-031.75E-031.69E-031.64E-031.59E-031.54E-031.49E-031.44E-031.39E-033.11.35E-031.31E-031.26E-031.22E-031.18E-031.14E-031.11E-031.07E-031.04E-031.00E-033.29.68E-049.35E-049.04E-048.74E-048.45E-048.16E-047.89E-047.62E-047.36E-047.11E-043.36.87E-046.64E-046.41E-046.19E-045.98E-045.77E-045.57E-045.38E-045.19E-045.01E-043.44.83E-044.66E-044.50E-044.34E-044.19E-044.04E-043.90E-043.76E-043.62E-043.49E-043.53.37E-043.25E-043.13E-043.02E-042.91E-042.80E-042.70E-042.60E-042.51E-042.42E-043.62.33E-042.24E-042.16E-042.08E-042.00E-041.93E-041.85E-041.78E-041.72E-041.65E-043.71.59E-041.53E-041.47E-041.42E-041.36E-041.31E-041.26E-041.21E-041.17E-041.12E-043.81.08E-041.04E-049.96E-059.57E-059.20E-058.84E-058.50E-058.16E-057.84E-057.53E-053.97.23E-056.95E-056.67E-056.41E-056.15E-055.91E-055.67E-055.44E-055.22E-055.01E-054.04.81E-054.61E-054.43E-054.25E-054.07E-053.91E-053.75E-053.59E-053.45E-053.30E-054.13.17E-053.04E-052.91E-052.79E-052.67E-052.56E-052.45E-052.35E-052.25E-052.16E-054.22.07E-051.98E-051.89E-051.81E-051.74E-051.66E-051.59E-051.52E-051.46E-051.39E-054.31.33E-051.28E-051.22E-051.17E-051.12E-051.07E-051.02E-059.77E-069.34E-068.93E-064.48.54E-068.16E-067.80E-067.46E-067.12E-066.81E-066.50E-066.21E-065.93E-065.67E-064.55.41E-065.17E-064.94E-064.71E-064.50E-064.29E-064.10E-063.91E-063.73E-063.56E-064.63.40E-063.24E-063.09E-062.95E-062.81E-062.68E-062.56E-062.44E-062.32E-062.22E-064.72.11E-062.01E-061.92E-061.83E-061.74E-061.66E-061.58E-061.51E-061.43E-061.37E-064.81.30E-061.24E-061.18E-061.12E-061.07E-061.02E-069.68E-079.21E-078.76E-078.34E-074.97.93E-077.55E-077.18E-076.83E-076.49E-076.17E-075.87E-075.58E-075.30E-075.04E-07
正交表及F临界值表

附录1:常用正交表
1)L(23)
4
(2)L8(27)
3)L(34)
9 试验号 列号
1 2 3
1 1 1 1
2 1 2 2
3 2 1 2
4 2 2 1
试验号 1 列号 3 4
1 1 1 1 1
2 1 2 2 2
3 1 3 3 3
4 2 1 2 3
5 2 2 3 1
6 2 3 1 2
7 3 1 3 2
8 3 2 1 3
9 3 3 2 1 (4)L12(211)
试验号 1 2 3 4 5 列号 7 8 9 10 11
1 1 1 1 1 1 1 1 1 1 1 1
2 1 1 1 1 1 2 2 2 2 2 2
3 1 1 2 2 2 1 1 1 2 2 2
4 1 2 1 2 2 1 2 2 1 1 2
5 1 2 2 1 2 2 1 2 1 2 1
6 1 2 2 2 1 2 2 1 2 1 1
7 2 1 2 2 1 1 2 2 1 2 1
8 2 1 2 1 2 2 2 1 1 1 2
9 2 1 1 2 2 2 1 2 2 1 1
10 2 2 2 1 1 1 1 2 2 1 2
11 2 2 1 2 1 2 1 1 1 2 2
12 2 2 1 1 2 1 2 1 2 2 1
5)L(45)
16
6)L(56)
25
试验号 1 2 3 列号
4 5 6
1 1 1 1 1 1 1
2 1 2 2 2 2 2
3 1 3 3 3 3 3
4 1 4 4 4 4 4
5 1 5 5 5 5 5
6 2 1 2 3 4 5
7 2 2 3 4 5 1
8 2 3 4 5 1 2
9 2 4 5 1 2 3
10 2 5 1 2 3 4
11 3 1 3 5 2 4
12 3 2 4 1 3 5
13 3 3 5 2 4 1
14 3 4 1 3 5 2
15 3 5 2 4 1 3
16 4 1 4 2 5 3
17 4 2 5 3 1 4
f分布临界表

F分布临界表
1. 什么是F分布临界表?
F分布临界表是用于统计推断中的假设检验和置信区间计算的重要工具。它提供了在给定显著性水平下,F统计量的临界值。通过与计算得到的F统计量进行比较,可以确定是否拒绝原假设或接受备择假设。
2. F分布的基本概念
在统计学中,F分布是两个独立的卡方分布的比值。它经常用于比较两个样本方差是否有显著差异,也可以用于ANOVA(方差分析)等多个总体方差比较问题。
F分布具有两个参数:自由度(df1和df2)。其中df1为分子自由度,df2为分母自由度。自由度决定了F分布的形状。
3. F分布临界值的意义
在假设检验中,我们通常将原假设表示为“H0”,备择假设表示为“Ha”。根据样本数据计算得到的F统计量将与F分布临界值进行比较。
• 如果计算得到的F统计量大于F分布临界值,则拒绝原假设。
• 如果计算得到的F统计量小于F分布临界值,则接受原假设。
F分布临界值可以通过查表或使用统计软件进行计算。
4. 如何使用F分布临界表?
使用F分布临界表进行假设检验和置信区间计算的步骤如下:
步骤1:确定显著性水平α 在进行假设检验之前,首先需要确定显著性水平α。常见的显著性水平有0.05和0.01。
步骤2:确定自由度 根据具体问题中的样本大小和组数,确定自由度df1和df2。通常,df1为组数减1,df2为样本总数减组数。
步骤3:查找F分布临界值 根据确定的显著性水平α和自由度df1、df2,在F分布临界表中查找对应的F分布临界值。
步骤4:比较计算得到的F统计量 将计算得到的F统计量与查找到的F分布临界值进行比较。
• 如果计算得到的F统计量大于查找到的F分布临界值,则拒绝原假设。
• 如果计算得到的F统计量小于查找到的F分布临界值,则接受原假设。 5. F分布临界表示例
下面是一个简化的F分布临界表示例,以说明如何使用F分布临界表进行假设检验。
df1/df2 0.10 0.05 0.01
f检验临界值表怎么查
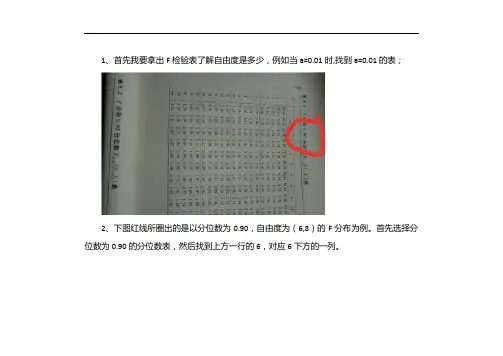
1、首先我要拿出F检验表了解自由度是多少,例如当a=0.01时,找到a=0.01的表;
2、下图红线所圈出的是以分位数为0.90,自由度为(6,8)的F分布为例。首先选择分位数为0.90的分位数表,然后找到上方一行的6,对应6下方的一列。
3、然后我们还要找到左侧一列中的8,对应8的那一行。
4、最后两者相交的那个数字就是需要查找的分位数为0.90,自由度为(6,8)的F分布的值。
需要注意的是:F是一种非对称分布,有两个自由度,且位置不可互换。F分布表横坐标是x,纵坐标是y,一个分位点一张表,F0.05(7,9)就查分位点是0.05的那张表横坐标为7,纵坐标为9处的值。
F检验(F-test),最常用的别名叫做联合假设检验(英语:joint hypotheses test),此外也称方差比率检验、方差齐性检验。它是一种在零假设(null hypothesis, H0)之下,统计值
服从F-分布的检验。其通常是用来分析用了超过一个参数的统计模型,以判断该模型中的全部或一部分参数是否适合用来估计母体。
F检验这名称是由美国数学家兼统计学家George W. Snedecor命名,为了纪念英国统计学家兼生物学家罗纳德·费雪(Ronald Aylmer Fisher)。Fisher在1920年代发明了这个检验和F分配,最初叫做方差比率(Variance Ratio)。
样本标准偏差的平方,即:
S2=∑(-)2/(n-1)
两组数据就能得到两个S2值
F=S2/S2'
然后计算的F值与查表得到的F表值比较,如果
F < F表 表明两组数据没有显著差异;
F ≥ F表 表明两组数据存在显著差异。
f分布临界值计算
f分布临界值计算
摘要:
一、f分布的含义与应用
二、f分布临界值的计算方法
1.单尾检验
2.双尾检验
三、f分布临界值查询工具与表格
四、实例分析
1.假设检验
2.参数估计
五、提高f分布临界值计算的准确性与效率
1.掌握统计软件的使用
2.了解相关领域的知识
正文:
一、f分布的含义与应用
f分布是一种常见的概率分布,主要用于假设检验和参数估计等统计分析场景。它描述了两个独立的标准正态分布的比值服从f分布。在实际应用中,f分布临界值的计算是关键步骤,它可以帮助我们判断样本数据是否具有显著性差异,或者估计未知参数的值。
二、f分布临界值的计算方法
1.单尾检验 在单尾检验中,我们需要计算f分布的临界值,以便与实际计算得到的统计量进行比较。单尾检验的临界值可以通过以下公式计算:
F_c = Φ(-1.96) / Φ(1.96)
其中,Φ(x)表示标准正态分布函数在x处的值,Φ(-1.96)表示标准正态分布函数在-1.96处的值,Φ(1.96)表示标准正态分布函数在1.96处的值。
2.双尾检验
在双尾检验中,我们需要计算f分布的临界值,以便与实际计算得到的统计量进行比较。双尾检验的临界值可以通过以下公式计算:
F_c = Φ(-1.96) / (2 - Φ(1.96))
其中,Φ(x)表示标准正态分布函数在x处的值,Φ(-1.96)表示标准正态分布函数在-1.96处的值,Φ(1.96)表示标准正态分布函数在1.96处的值。
三、f分布临界值查询工具与表格
为了方便用户计算f分布临界值,统计学家们推出了多种查询工具和表格。例如,Excel软件提供了内置的F.1函数,可以直接计算f分布的临界值。此外,网上也有很多专门的f分布临界值查询表格,用户可以根据所需自由选用。
四、实例分析
1.假设检验
假设我们有一组样本数据,想要检验样本均值与总体均值之间是否存在显著性差异。在这种情况下,我们可以使用f分布进行假设检验。首先,计算样本数据的方差,然后根据样本大小和显著性水平,查找相应的f分布临界值。将计算得到的统计量与临界值进行比较,若统计量大于临界值,则拒绝原假设。
t分布与F分布
t分布与F分布
在统计学中,t分布和F分布是两个重要的概率分布。它们在数据分析和假设检验中起着关键的作用。本文将介绍t分布和F分布的定义、特性以及它们的应用。
一、t分布
t分布是一种概率分布,用于描述样本均值的分布情况。在实际应用中,当总体标准差未知且样本容量较小(通常小于30)时,我们无法使用正态分布来描述样本的分布情况,而需要使用t分布。
t分布的形状类似于正态分布,但是它的尾部较宽,曲线较低。t分布的参数是自由度,自由度越大,t分布越接近正态分布。自由度的计算公式为样本容量减去1。
t分布广泛应用于假设检验中。假设检验是一种统计方法,用于通过样本数据判断总体参数是否满足某种假设。t检验是假设检验的重要方法之一,常用于检验两个样本均值是否相等。
二、F分布
F分布是一种概率分布,用于描述两个样本方差比值的分布情况。在实际应用中,当需要比较两个样本方差的差异时,我们可以使用F分布。
F分布的形状呈现右偏态,其特点是尾部较长。F分布的参数是两个自由度,分别对应于分子和分母的自由度。F分布的分子自由度通常对应于较大的样本方差所属的样本容量减去1,而分母自由度对应于较小的样本方差所属的样本容量减去1。
F分布在方差分析中具有重要应用。方差分析是一种统计方法,用于比较两个或多个总体均值的差异。通过计算F值并进行显著性检验,我们可以判断不同组之间的方差是否存在显著差异。
三、t分布与F分布的应用实例
为了更好地理解t分布和F分布的应用,下面给出一个实例。
假设我们想要比较两种不同治疗方法对患者体温的影响。我们分别随机选取了A组和B组的患者,记录了每组患者的体温数据。现在我们想知道,这两种治疗方法是否对患者体温有显著影响。
首先,我们计算每组患者的平均体温和标准差。然后,利用t分布进行假设检验,比较两个样本均值是否存在显著差异。假设显著水平为0.05,我们计算出的t值为1.96,自由度为n-1。根据t分布表,我们发现临界值为2.02。由于计算得到的t值未超过临界值,所以我们不能拒绝原假设,即两种治疗方法对患者体温无显著影响。
统计学附录-卡方分布t-分布表
统计学附录-卡方分布 t-分布表
卡方分布
卡方分布 (χ2分布)是概率论与统计学中常用的一种概率分布。k 个独立的标准正态分布变量的平方和服从自由度为k 的卡方分布。卡方分布常用于假设检验和置信区间的计算。
卡方分布的数学定义
若k 个随机变量Z1、……、Zk 相互独立,且数学期望为0、方差为 1(即服从标准正态分布),则随机变量X
被称为服从自由度为 k 的卡方分布,记作
卡方分布的特征
卡方分布的概率密度函数为:
其中x?0, 当x?0时fk(x) = 0。这里Γ代表Gamma 函数。
卡方分布的累积分布函数为:
其中γ(k,z)为不完全Gamma函数
在大多数涉及卡方分布的书中都会提供它的累积分布函数的对照表。此外许多表格计算软件如 Calc和Microsoft Excel中都包括卡方分布函数。 卡方分布可以用来测试随机变量之间是否相互独立,也可用来检测统计模型是否符合实际要求。
自由度为 k 的卡方变量的平均值是 k,方差是 2k。 卡方分布是伽玛分布的一个特例,它的熵为:
其中ψ(x) 是 Digamma function。
卡方变数与 Gamma变数的关系
当Gamma变数频率(λ)为1/2 时,α 的2倍为卡方变数之自由度(Degree of
freedom)
即:
卡方变数之期望值=自由度卡方变数之方差=两倍自由度
卡方分布
参数 k > 0, 自由度
值域 ,
概率密度函数
,
累积分布函数(cdf)
,
期望值 k,
中位数 大约k ? 2 / 3,
众数 k-2, if,
方差 2,k,
偏态 ,
峰态 12/k,
熵值
动差生成函数(mgf) ,2t<1,
特征函数 ,
t-分布表
For a particular number of degrees of freedom, entry represents the
f统计量临界值表
F检验临界值表是一种常用的统计工具,用于确定样本数据是否符合特定的概率分布。通过查表,可以找到对应显著性水平下的临界值,从而判断样本数据的分布情况。
在F检验中,我们通常会先假设样本数据符合某种分布,如正态分布或t分布,然后计算样本数据的统计量(如均值、方差等)并与临界值进行比较。如果统计量在临界值范围内,则接受原假设,认为样本数据符合该分布;否则,拒绝原假设,认为样本数据不符合该分布。
F检验临界值表的构成包括显著性水平、自由度和临界值三个部分。在表中找到对应的显著性水平和自由度,即可查找到临界值。
F检验临界值表的查找步骤如下:
1. 根据实际问题选择适当的显著性水平,如0.01、0.05或0.1等。
2. 确定样本数据的自由度,自由度通常由样本大小和所考虑的参数个数决定。
3. 在F检验临界值表中查找对应显著性水平和自由度的临界值。
4. 将样本数据的统计量与临界值进行比较,判断是否接受原假设。
需要注意的是,F检验临界值表只是一种参考工具,实际应用中还需要结合具体问题进行综合考虑。同时,随着统计软件的发展,现在也可以通过软件进行F检验,而无需手动查表。