
第5次课(基于字典编码和算术编码)
8 9
10 11 12 13
107 042
109 105 10B FFF
041 107
042 109 105
AA B
BB ABC ABCA
107 108
109 10A 10B
AA AAB
BB BBA ABCA
P1=p(x1) P2=P1+p(x2)…
Pn-1=Pn-2+p(xn-1) Pn=1
算术编码具体过程
(3)如果文件中再没字符,输出当前单词W的序号, 编码过程完备.如果文件中还有字符, 把当前单 词W作为前缀 ,再从被压缩文件中读入一个字符 CH,把CH作为尾字符,得到一个单词W1. (4)在字典中查找 ,如果字典中已经有W1,则更新 当前单词,将 W1看作当前单词W,返回第 (3)步 ;如 果字典中没有W1, 先将原单词W的序号输出, 再将 新单词 W1增加到字典中 ,然后把刚刚读入的字符 CH作为当前单词W,返回第(3)步.
记忆码字 041 042 043 100 044 100 102
解码输出 A B C AB D AB CA A
字典位置 100 101 102 103 104 105 106
新单词 AB BC CA ABD DA ABC CAA
算术编码的思想
假设某离散独立信源有n个消息:x1 ,…,xn, 且对应的概率分别为:p(x1), …,p(xn). 如果将这 些概率用线段的长度来表示 ,则概率大的消息对 应长的线段, 概率小的消息对应短的线段.再将 这些线段顺序连接起来 ,其总长度必然等于1.
(1)字典初始化: 将被压缩文件中所有使用到的 单字节字符放入字典中 .为了压缩任何类型的文 件,可以将字典前 256个位置分配给计算机文件 中出现的所有256 个可能的单个字符.
(2)动态数据初始化:初始化新单词存放位置 指针P, 将它指向字典的第一个空位置; 读入被 压缩文件的第一个字符 cha, 作为待处理单词 W. 单词的前缀为空, 即Q=4095, 尾字符就是cha, 码字N 也是cha.
LZW 解码算法的例子
(5)如果在字典有码字对应的单词 ,则采用递归 算法, 输出该单词的内容.并将该单词的第一个 字符作为尾字符, 将已经记忆的前一个码字作 为前缀 ,组成一个新的单词, 写入字典, 然后记 下当前码字, 返回第(3) 步; 否则先在字典生成 新的单词,再输出这个单词, 将新单词的码字记 忆下, 再返回第(3)步.
码字 长度 1 1
3 4 4 5 7 7
码
字
1 2
3 4 5 6 7 8
1 1
0 1 1 1 0 1
0.01 0.0111
0.0111 0.01111001 0.0111111111 0.100001001101 0.100001001101
0.11 0.1001
0.001001 0.00011011 0.0001010001 0.000011110011 0.00000011110011
从而码字为1000011
4
2017/1/11
算术编码的译码原理
设码字为C, 起点为P,宽度为 A,译码过程如下 :
(1)初始化: 区间起点P =0, 区间宽度A =1; (2)计算分割点Q 的位置 ; (4)进入分割点右边的区间, 若该区间宽度小于 码字最低位的值, 则译码结束;否则译码输出码 元“1”,然后将分割点作为新的区间起点,使用 迭代公式A=A(1-p)进行计算后返回第二步;
用线段长度表示如下:
X0 (p0=0.20) P0=0 X1 (p1=0.30) P1=0.2 X2 (p2=0.35) X3 (p3=0.15) P4=1
算术具体编码
[编码] 由条件p3=0.15 ,P3=0.85得: I Log 2 0.15 2.737 取L=3, 将消息X3的起点 P3=0.85用二进制表示为
2017/1/11
Lz算法基本原理
信息论基础
The Basis of Information Theory
基于字典编码概论
哈夫曼编码和游程编码得到的结果是变长 码,而基于字典的编码方法得到的结果是定长 码,特别适合计算机文件的压缩和保存。此类 压缩编码方法是两位以色列研究人员在1977 年 提出来的,由于他们的名字分别为Abraham Lempel 和Jakob Ziv,所以基于字典的压缩编 码方法简称为LZ 算法。
x1 0 x2 … xn
算术编码的基本原理
由于每个消息的起点位置等于前面各个消 息的概率累积,故将它定义为累积概率Pk. 反过来, 也可以由累积概率来计算某个消 息的概率:pk =Pk-Pk-1 , 即两个相邻起点之间的 距离等于这个线段的长度. 每个消息所对应的 线段从起点开始, 到下一个线段的起点为此, 但 不包含下一个线段的起点, 即消息 Xk的对应区 间为[Pk-1,Pk). 任意选择一个小数 ,它必然落在某个消息 对应的线段上这说明, 可以用一个具有大小概 念的小数来表示某个消息, 这就是算术编码的 基本出发点.
无 无 无 100 无 无 100 无 102 无 无
A B C
041 042 043
100 101 102
AB BC CA
13 14 15 16
AA B
107 042
108 109
AAB BB
ABCABDABCAAAABBBABACBCA
用LZW 算法,具体编码过程如下表 .
3 4 5 6 7 8 9 10 11
接着上面例1 编码后的解码, 在实际解码过 程中, 每次读入三个字节,分解为两个码字. 假设有一个压缩文件,其内容为: 041 042 043 100 102 041 107 042 109 105 10B FFF
2
2017/1/11
步
骤 0 1 2 3 4 5 6 7
读入码字 041 042 043 100 044 100 102 041
通常序号的长度为 12比特,即 0到4095, 而 “单词”的平均长度远大于 12比特,从而达到压 缩的效果.从而达到压缩目的.
LZW 编码算法
LZW压缩编码算法如下:
由于字典的容量有限, 不可能包罗万象. 故 在LZ压缩算法中, 字典的内容直接由被压缩的 文件生成.一边编码,一边将新发现的“单词” 增加到字典中.在解码的过程中, 同样是一边解 码,一边生成字典 .故LZ 编码算法在储存压缩文 件时不需要保存字典, 是一种自适应算法. 1984年,Terry Welch对 LZ算法进行改进 , 使得所以的单词有同样的结构,推出LZW压缩编 码算法 .
二元独立信源的算术编码过程
设码元0 的概率为p,则码元1 的概率为1 -p, 编码过程如下: (1)初始化: 区间的起点 P=0,区间的宽度A= 1;
Pk Ck Pk 1
即码字 Ck必定落在消息 Xk的区间内 ,这样Ck就可 以唯一代表消息Xk . 解码过程是一个比较判断过程,只要将码字C k 和一系列的累积概率Pk 进行比较, 就可以确定 消息Xk. 因为C3 =(0.111)B=0.875,(p0 +p1+p2 )=P3 , 译码为消息X 3.
0.1 0.1
0.100 0.1000 0.1000 0.10001 0.1000011 0.1000011
(5)根据最终区间宽度A,通过2-L≤A<2-(L-1)求得 码字长度L, 然后将区间起点 P截取小数点后的L 位,剩余部分如果不为零,则进位到小数点后的 第L位, 便得到最终编码结果 .
0.1000010111000011 0.0000001011011001
读入 字符 A B B B A B C A B C A 无
查找 对象 AA AAB BB BB BBA AB ABC ABCA AB ABC ABCA
查找 结果 107 无 无 109 无 100 105 无 ቤተ መጻሕፍቲ ባይዱ00 105 10B
编码输出
内容 码字
字典扩充
位置 新单词
AB BC CA AB ABD DA AB ABC CA CAA AA
读入 字符 A B C A B D A B C A A A
查找 对象
查找 结果
编码输出 内容 码字
字典扩充 位置 新单词 步骤 前缀 12 FFF 041 FFF FFF 042 FFF 041 100 FFF 041 100 105
当 前 单 词
尾字符 A A B B B A B C A B C A 码字 041 107 042 042 109 041 100 105 041 100 105 10B
主题 No5 :基于字典编码和算术编码
计算机文件是以字节为单位组成的,每个 字节的取值从0到 255(2 8=256). 把每个字节都 看成一个“字符”,我们再把连续的若干个 “字符”看成一个“单词”将全部“单词”组 合起来就成为“字典” . 只要知道某个“单词”在字典中的位置 (即 序号), 就可以知道这个“单词”的内容,“单词” 的序号和“单词”的内容存在一一对应的关系. 我们将计算机文件按“单词”进行分割,然后用 “单词”在字典中的序号取代“单词”的内容, 就可以得到全部由序号组成的编码结果.
1
2017/1/11
LZW 编码算法的例子
例1 设有一文件内容为
当 前 单 词 步骤 前缀 0 1 2 FFF FFF FFF FFF 041 FFF FFF 041 FFF 043 FFF A B C A B D A B C A A 041 042 043 041 100 044 041 100 043 102 041 尾字符 码字
P3 0.85D 0.11011001B
故C 3 =(0.111)B
P2=0.5
P3=0.85
3
2017/1/11
精品课课件信息论与编码(全套讲义)
跨学科交叉融合
信息论将与更多学科进行交叉融合,如物理学、 化学、社会学等,共同推动信息科学的发展。
编码技术的发展趋势
高效编码算法
随着计算能力的提升,更高效的编码算法将不断涌现,以提高数据 传输和存储的效率。
智能化编码
借助人工智能和机器学习技术,编码将实现智能化,自适应地调整 编码参数以优化性能。
跨平台兼容性
未来的编码技术将更加注重跨平台兼容性,以适应不同设备和网络环 境的多样性。
信息论与编码的交叉融合
理论与应用相互促进
信息论为编码技术提供理论支持, 而编码技术的发展又反过来推动 信息论的深入研究。
共同应对挑战
精品课课件信息论与编码(全套 讲义)
目
CONTENCT
录
• 信息论基础 • 编码理论 • 信道编码 • 信源编码 • 信息论与编码的应用 • 信息论与编码的发展趋势
01
信息论基础
信息论概述
信息论的研究对象
研究信息的传输、存储、处理和变换规律的科学。
信息论的发展历程
从通信领域起源,逐渐渗透到计算机科学、控制论、 统计学等多个学科。
卷积编码器将输入的信息序列按位输入到一个移位寄存器中,同时根据生成函数将移位寄存 器中的信息与编码器中的冲激响应进行卷积运算,生成输出序列。
卷积码的译码方法
卷积码的译码方法主要有代数译码和概率译码两种。代数译码方法基于最大似然译码准则, 通过寻找与接收序列汉明距离最小的合法码字进行译码。概率译码方法则基于贝叶斯准则, 通过计算每个合法码字的后验概率进行译码。
04
视频压缩 基本算法与标准
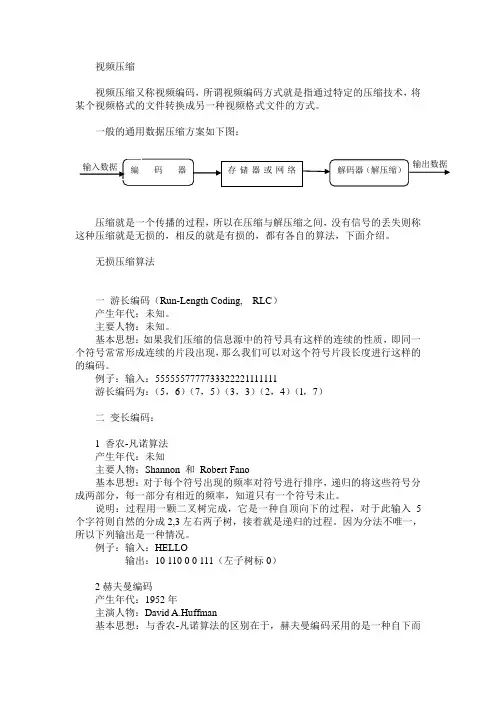
视频压缩视频压缩又称视频编码,所谓视频编码方式就是指通过特定的压缩技术,将某个视频格式的文件转换成另一种视频格式文件的方式。
一般的通用数据压缩方案如下图:压缩就是一个传播的过程,所以在压缩与解压缩之间,没有信号的丢失则称这种压缩就是无损的,相反的就是有损的,都有各自的算法,下面介绍。
无损压缩算法一游长编码(Run-Length Coding, RLC)产生年代:未知。
主要人物:未知。
基本思想:如果我们压缩的信息源中的符号具有这样的连续的性质,即同一个符号常常形成连续的片段出现,那么我们可以对这个符号片段长度进行这样的的编码。
例子:输入:5555557777733322221111111游长编码为:(5,6)(7,5)(3,3)(2,4)(l,7)二变长编码:1 香农-凡诺算法产生年代:未知主要人物:Shannon 和Robert Fano基本思想:对于每个符号出现的频率对符号进行排序,递归的将这些符号分成两部分,每一部分有相近的频率,知道只有一个符号未止。
说明:过程用一颗二叉树完成,它是一种自顶向下的过程,对于此输入5个字符则自然的分成2,3左右两子树,接着就是递归的过程。
因为分法不唯一,所以下列输出是一种情况。
例子:输入:HELLO输出:10 110 0 0 111(左子树标0)2赫夫曼编码产生年代:1952年主演人物:David A.Huffman基本思想:与香农-凡诺算法的区别在于,赫夫曼编码采用的是一种自下而上的描述方式,先从符号的频率中选取最小的两个符号,合成一个新的结点,进行等效的代替,然后也是个递归过程。
说明:赫夫曼编码具有唯一的前缀性质和最优性。
例子:对于输入:HELLO 建立的一刻赫夫曼树 扩展:扩展的赫夫曼编码,这是相对于数据中某个符号的概率较大(接近1.0)时,将几个符号组成组,然后为整个组赋予一个码字。
自适应的赫夫曼编码,这是一个边接收边编码的过程,完全的体现了适应的过程,需要对二叉树进行改变,由接收到的数据去添加进二叉树中,自动生成新的“赫夫曼树”。
冀教版小学信息技术五年级上册《第5课 算法的特征》教学设计

冀教版小学信息技术五年级上册《第5课算法的特征》教学设计教材分析:冀教版小学信息技术第5课主要介绍了算法的基本概念和特征。
教材以生动的实例,如做家务、走迷宫等,引导学生理解算法是解决问题的一系列步骤,强调了算法的逻辑性和可执行性。
教材还通过简单的编程示例,让学生初步感知到算法在信息技术中的应用。
学情分析:学生在学习本课前,已经对计算机有了一定的了解,能够进行基本的计算机操作。
但他们对“算法”这个概念可能比较陌生,理解起来可能会有一定的难度。
此外,小学生的逻辑思维能力正在发展中,需要通过具体实例和活动来帮助他们理解和掌握。
教学目标:1. 知识与技能:理解算法的定义,掌握算法的四个基本特征(明确性、有限性、输入、输出)。
2. 过程与方法:通过实例分析和讨论,培养学生的逻辑思维能力和问题解决能力。
3. 情感态度与价值观:激发学生对信息技术的兴趣,认识到算法在日常生活和学习中的重要性。
教学重难点:教学重点:理解并能描述算法的四个基本特征。
教学难点:如何将生活中的问题抽象为算法,理解算法的逻辑性和可执行性。
教学过程:在教育的广阔领域中,引导学生理解和应用“算法”这一概念是现代科技教育的重要一环。
以下是一种有效的教学策略,旨在将抽象的理论知识转化为生动的实践体验。
1. 导入新课:教学活动始于一个日常生活中的常见问题,例如“如何煮一个完美的鸡蛋”。
教师可以引导学生详细描述煮鸡蛋的步骤,如加热水、设定时间、搅拌等。
这样的开场白不仅吸引学生的注意力,也自然地引出了“算法”这一主题——即一系列有序的步骤,用于解决特定问题或完成特定任务。
2. 讲解新知:接着,教师将深入介绍算法的四个关键特征:明确性、有限性、输入和输出。
每讲到一个特征,都要配以生动的实例。
例如,明确性可以通过描述每一步的具体操作来体现,有限性则可以通过说明煮鸡蛋的步骤是有限的,不会无休止地进行来解释。
这样的讲解方式使抽象的概念变得具体可感。
3. 实践操作:理论讲解后,是实践操作的时间。
压缩算法的分类
压缩算法的分类
压缩算法的分类可以根据不同的标准和角度进行。
以下是一些常见的分类方式:
1.有损压缩和无损压缩:根据压缩后数据是否可逆,可以分为有损和无
损压缩。
无损压缩能够完全还原原始数据,而有损压缩则无法完全还原,会丢失一些数据。
2.熵编码和非熵编码:根据是否利用数据本身存在的冗余和相关性,可
以分为熵编码和非熵编码。
熵编码是一种无损压缩方法,它利用数据本身存在的冗余和相关性进行压缩;而非熵编码则是一种有损压缩方法,它通过去除数据中的冗余和相关性来压缩数据。
3.字典编码和算术编码:根据使用数据的存储方式,可以分为字典编码
和算术编码。
字典编码将出现过的字符串存入字典中,并用位置来代替这些字符串;而算术编码则是将数据表示为一个范围在0到1之间的概率值。
4.单独压缩和联合压缩:根据是否针对单个文件进行压缩,可以分为单
独压缩和联合压缩。
单独压缩是对单个文件进行压缩,而联合压缩则是将多个文件组合在一起进行压缩。
5.基于预测的压缩和基于统计的压缩:根据使用数据的不同方法,可以
分为基于预测的压缩和基于统计的压缩。
基于预测的压缩利用前一个或多个数据点的值来预测当前数据点的值,并去除预测误差来压缩数据;而基于统计的压缩则是利用数据的概率分布来进行压缩。
这些分类方式只是其中的一部分,根据不同的标准还可以将压缩算法分为更多类别。
了解压缩算法的不同分类方式有助于更好地选择和应用适当的算法。
信源编码的方案实施

信源编码的方案实施引言信源编码是信息论中的一个重要概念,用于在信息传输中提高数据的传输效率。
信源编码方案的选择及实施对于信息传输的性能有很大的影响。
本文将介绍信源编码方案的实施过程,并讨论其在实际应用中的一些考虑因素。
信源编码方案的选择在实施信源编码方案之前,首先需要选择一个合适的编码方案。
常用的信源编码方案包括霍夫曼编码、算术编码和基于字典的编码等。
选择合适的编码方案需要考虑以下几个因素:数据特性不同的数据具有不同的特性,例如数据的统计特性、冗余程度等。
对于具有较高冗余程度的数据,应选择具有较好压缩效果的编码方案,如霍夫曼编码。
对于具有较低冗余程度的数据,应选择具有较高编码效率的方案,如算术编码。
处理能力选择的信源编码方案要考虑实际系统的处理能力。
某些编码方案可能需要较高的计算能力来进行编解码操作,这对于资源受限的系统来说可能不太适合。
因此,在选择编码方案时,需要权衡计算能力和编码效率之间的关系。
误码率对于一些对误码率要求较高的系统,例如无线通信系统,选择能够提供具有很好错误保护能力的编码方案是十分重要的。
这种编码方案需要具备较好的纠错能力,并能提供较低的误码率。
在选择编码方案时,需要考虑系统的误码率要求以及编码方案所能提供的错误保护能力。
信源编码方案的实施步骤信源编码方案的实施包括编码器和解码器的设计及实现两个步骤。
以下是信源编码方案的实施步骤:步骤一:设计编码器根据选择的编码方案,在设计编码器时需要确定编码的规则和算法。
根据数据特性和处理能力,可以选择合适的编码算法,并进行相应的优化。
编码器的设计需要根据具体的应用场景和系统要求来进行,例如可以考虑加入压缩算法来提高编码效率。
步骤二:实现编码器根据设计的编码规则和算法,进行编码器的实现。
实现编码器可以采用软件实现或硬件实现的方式,具体根据系统平台和资源情况来选择。
编码器的实现需要将设计的编码算法转化为具体的编码逻辑,同时要考虑性能和内存消耗等因素。
四种压缩算法原理介绍
四种压缩算法原理介绍压缩算法是将数据经过特定的编码或转换方式,以减少数据占用空间的方式进行压缩。
常见的压缩算法可以分为四种:无损压缩算法、有损压缩算法、字典压缩算法和算术编码压缩算法。
一、无损压缩算法是指在数据压缩的过程中不丢失任何信息,压缩前后的数据完全相同,通过对数据进行编码或转换,以减少数据的存储空间。
常见的无损压缩算法有:1. 霍夫曼编码(Huffman Coding):霍夫曼编码是一种可变长度编码方式,通过根据数据出现频率给予高频率数据较低的编码长度,低频率数据较高的编码长度,从而达到减少数据存储空间的目的。
2.雷霍尔曼编码(LZ77/LZ78):雷霍尔曼编码是一种字典压缩算法,它通过在数据中并替换相同的字节序列,从而实现数据的压缩。
LZ77算法是将数据划分为窗口和查找缓冲区,通过在查找缓冲区中查找与窗口中相匹配的字节序列来进行压缩。
LZ78算法主要通过建立一个字典,将数据中的字节序列与字典中的序列进行匹配并进行替换,实现数据的压缩。
3.哈夫曼-雷霍尔曼编码(LZW):哈夫曼-雷霍尔曼编码是一种常见的字典压缩算法,它综合了霍夫曼编码和雷霍尔曼编码的特点。
它通过维护一个字典,将数据中的字节序列与字典中的序列进行匹配并进行替换,实现数据的压缩。
二、有损压缩算法是指在数据压缩的过程中会丢失一部分信息,压缩后的数据无法完全还原为原始数据。
常见的有损压缩算法有:1. JPEG(Joint Photographic Experts Group):JPEG 是一种常用的图像压缩算法,它主要通过对图像的颜色和亮度的变化进行压缩。
JPEG算法将图像分成8x8的块,对每个块进行离散余弦变换(DCT),并通过量化系数来削减数据,进而实现压缩。
2. MP3(MPEG Audio Layer-3):MP3 是一种常用的音频压缩算法,它通过分析音频中的声音频率以及人耳对声音的敏感程度,对音频数据进行丢弃或砍切,以减少数据的占用空间。
信息论与编码教学大纲(2024)
LDPC码在无线通信中的应用研究。探讨LDPC码在无线通信系统中的 编译码算法及性能优化方法。
选题三
极化码原理及性能分析。研究极化码的编译码原理,分析其在不同信 道条件下的性能表现,并与传统信道编码方案进行比较。
选题四
5G/6G通信中的信道编码技术。调研5G/6G通信系统中采用的信道编 码技术,分析其优缺点,并提出改进方案。
Polar码应用
探讨Polar码在5G通信、物联网等领域的应用,并分 析其性能表现。
22
06 实验环节与课程 设计
2024/1/25
23
实验环节介绍
实验一
信道容量与编码定理验证。 通过搭建简单的通信系统, 验证不同信道条件下的信道 容量及编码定理的有效性。
实验二
线性分组码编译码实验。利 用计算机软件实现线性分组 码的编译码过程,并分析其 纠错性能。
LDPC码基本原理
介绍LDPC码的编码结构、译码原理以及性 能分析。
LDPC码应用
探讨LDPC码在光纤通信、数据存储等领域 的应用,并分析其性能表现。
21
Polar码原理及应用
2024/1/25
Polar码基本原理
介绍Polar码的编码结构、信道极化原理以及性能分 析。
Polar码编译码算法
详细阐述Polar码的编码算法、译码算法以及关键技 术的实现。
2024/1/25
预测编码
利用信源符号间的相关 性进行预测,并对预测 误差进行编码,如差分 脉冲编码调制(DPCM )。
变换编码
将信源信号通过某种变 换转换为另一域的信号 ,再对变换系数进行编 码,如离散余弦变换( DCT)编码。
14
04 信道编码
2024/1/25
词典编码课程设计
词典编码课程设计一、教学目标本课程旨在让学生掌握词典编码的基本知识和技巧,包括词条的编排规则、字母顺序、拼音标注等,使学生能够熟练运用词典进行自主学习和查阅资料。
通过本课程的学习,学生将能够:1.理解词典编码的基本原理和方法。
2.掌握词典编码的技巧和要点。
3.能够独立使用词典进行词汇学习和查阅。
4.培养学生的自主学习能力和信息检索能力。
二、教学内容本课程的教学内容主要包括以下几个部分:1.词典编码的基本原理:介绍词典编码的起源和发展,解释词典编码的基本概念和规则。
2.词典编码的技巧:讲解词典编码的方法和技巧,包括字母顺序、词条编排等。
3.词典的使用方法:教授学生如何正确使用词典,包括查阅词汇、理解词条等。
4.实践练习:提供相关的练习题目,让学生通过实际操作来巩固所学的知识。
三、教学方法为了提高学生的学习兴趣和主动性,本课程将采用多种教学方法相结合的方式进行教学:1.讲授法:通过讲解词典编码的基本原理和方法,使学生掌握编码的基本知识。
2.案例分析法:通过分析具体的词典编码案例,使学生理解编码的技巧和要点。
3.实验法:通过实际的编码练习,使学生熟练掌握词典编码的技巧和方法。
四、教学资源为了支持教学内容和教学方法的实施,丰富学生的学习体验,我们将准备以下教学资源:1.教材:选用权威、实用的词典编码教材,为学生提供系统、科学的学习材料。
2.参考书:提供相关的参考书籍,为学生提供更多的学习资源和拓展知识。
3.多媒体资料:制作相关的教学课件和视频,以图文并茂的形式展示词典编码的知识和方法。
4.实验设备:准备相关的实验设备,如计算机、词典等,为学生提供实际操作的机会。
五、教学评估为了全面反映学生的学习成果,本课程将采用多种评估方式相结合的方法进行评估:1.平时表现:通过观察学生在课堂上的参与程度、提问回答等情况,评估学生的学习态度和理解程度。
2.作业:布置适量的作业,通过学生的完成情况和质量,评估学生的掌握程度。
2024-2025学年人教版新教材信息技术五年级上册 第05课 数学运算讲方法 教案
第5课数学运算讲方法一、教学目标1.学生掌握数学解题时的算法。
2.理解算法是解决问题的方法描述。
3.学会用流程图表示算法的顺序结构。
二、教学重点与难点教学重点1.掌握数学解题的算法。
2.用流程图表示算法。
教学难点1.理解复杂数学问题中的算法。
2.准确绘制流程图表示算法。
三、教学准备1.多媒体课件,包含数学问题示例及流程图绘制方法。
2.练习纸和彩笔。
四、教学过程(一)导入新课师:同学们,在我们的学习和生活中,经常会遇到各种各样的数学问题。
那么,大家有没有想过,我们在解决这些数学问题的时候,其实也在运用一种方法呢?这种方法就是算法。
今天,我们就一起来学习数学运算讲方法,看看如何用算法来解决数学问题。
(二)新课讲解1.数学解题中的算法概念(1)引入数学问题师:我们先来看看一个简单的数学问题。
小明有5个苹果,小红有3个苹果,他们一共有多少个苹果?同学们很快就能回答出是8个苹果。
那么,我们是怎么得到这个答案的呢?其实,我们在心里进行了一个简单的计算过程,先把小明的5个苹果和小红的3个苹果数出来,然后把它们加在一起,就得到了8个苹果。
这个计算过程就是一种算法。
(2)算法的定义师:算法就是解决问题的方法和步骤。
在数学解题中,算法就是我们解决数学问题的具体方法和步骤。
比如,我们要计算两个数的和,就需要先确定这两个数,然后把它们相加,最后得到结果。
这个过程就是一个算法。
2.数学解题算法的示例(1)加法算法师:我们再来看看一个加法问题。
比如,12+15=?我们可以这样来解决这个问题。
首先,我们把12和15分别拆分成10+2和10+5。
然后,我们先把两个十相加,得到20。
接着,把2和5相加,得到7。
最后,把20和7相加,得到27。
这个过程就是一个加法算法。
(2)减法算法师:再来看一个减法问题。
比如,2513=?我们可以这样来解决这个问题。
首先,我们把25拆分成20+5,把13拆分成10+3。
然后,我们先从20里面减去10,得到10。
三种常用的统计编码法
三种常用的统计编码法统计编码法是一种将符号转化为二进制编码的方法,常用于数据的存储和传输。
在统计编码法中,最常用的有三种方法,分别为霍夫曼编码、算术编码和字典编码。
下面将对这三种编码法进行详细介绍。
首先是霍夫曼编码法。
霍夫曼编码法是一种无损压缩编码方法,适用于频率分布不均匀的数据。
该编码法利用数据出现的概率进行编码,出现频率高的符号用较短的码字表示,而出现频率低的符号则用较长的码字表示。
这样可以使编码后的数据占用的位数最少。
算术编码是另一种常用的统计编码法。
它将整个消息作为一个整体来编码,而不是将消息划分为固定长度的符号进行编码。
算术编码通过维护一个区间,根据符号的概率分布,逐渐缩小区间的范围,最后将落在最终区间内的小数编码输出。
这样可以实现更高的压缩比,但解码复杂度较高。
最后是字典编码法。
字典编码法通过建立符号和编码之间的一一对应关系来进行编码。
它根据数据中的重复模式,将重复出现的符号用较短的码字表示,而不重复的符号则用较长的码字表示。
字典编码法常用于无损压缩算法中,如LZW算法。
三种常用的统计编码法在具体的应用场景和数据特征上都有所不同。
在选择编码方法时,需要考虑数据的分布、数据的类型、压缩比要求和解码复杂度等因素。
霍夫曼编码法适用于频率分布不均匀的数据,并且对解码的要求不高。
它可以在一定程度上提高压缩比,但解码时需要使用相同的霍夫曼编码表进行解码,因此对于无法完全传输编码表的场景可能不适用。
算术编码在压缩比方面优于霍夫曼编码,但解码复杂度较高,需要使用相同的符号概率分布来进行解码。
算术编码适用于数据中存在较多冗余信息的情况,可以达到较高的压缩比。
字典编码法通过建立符号和编码的对应关系,适用于数据中存在较多重复模式的情况。
它可以实现较高的压缩比,但需要建立和传输字典表,在某些场景下不便于使用。
综上所述,霍夫曼编码、算术编码和字典编码是三种常用的统计编码法。
它们在不同的应用场景和数据特征下具有不同的优势和适用性。