
编译原理教程课后答案
1.2 计算机执行用高级语言编写的程序有哪些途径?它们之间的主要区别是什么?
【解答】计算机执行用高级语言编写的程序主要有两种途径:解释和编译。
在解释方式下,翻译程序事先并不采用将高级语言程序全部翻译成机器代码程序,然后执行这个机器代码程序的方法,而是每读入一条源程序的语句,就将其解释(翻译)成对应其功能的机器代码语句串并执行,而所翻译的机器代码语句串在该语句执行后并不保留,最后再读入下一条源程序语句,并解释执行。
这种方法是按源程序中语句的动态执行顺序逐句解释(翻译)执行的,如果一语句处于一循环体中,则每次循环执行到该语句时,都要将其翻译成机器代码后再执行。
在编译方式下,高级语言程序的执行是分两步进行的:第一步首先将高级语言程序全部翻译成机器代码程序,第二步才是执行这个机器代码程序。
因此,编译对源程序的处理是先翻译,后执行。
从执行速度上看,编译型的高级语言比解释型的高级语言要快,但解释方式下的人机界面比编译型好,便于程序调试。
这两种途径的主要区别在于:解释方式下不生成目标代码程序,而编译方式下生成目标代码程序。
1.3 请画出编译程序的总框图。
如果你是一个编译程序的总设计师,设计编译程序时应当考虑哪些问题?
【解答】编译程序总框图如图所示。
作为一个编译程序的总设计师,首先要深刻理解被编
译的源语言其语法及语义;其次,要充分掌握目标指令的
功能及特点,如果目标语言是机器指令,还要搞清楚机器
的硬件结构以及操作系统的功能;第三,对编译的方法及
使用的软件工具也必须准确化。
总之,总设计师在设计编
译程序时必须估量系统功能要求、硬件设备及软件工具等
诸因素对编译程序构造的影响等。
2.2 什么是扫描器?扫描器的功能是什么?
【解答】扫描器就是词法分析器,它接受输入的源程序,对源程序进行词法分析并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
通常是把词法分析器作为一个子程序,每当词法分析器需要一个单词符号时就调用这个子程序。
每次调用时,词法分析器就从输入串中识别出一个单词符号交给语法分析器。
编译原理课后习题答案

(a) 0 ( 0 | 1)* 0
由0和1组成且以0开始和结束的符号串全体. (b) ( ( | 0 ) 1* ) * 由0和1组成的符号串全体.
(c) ( 0 | 1 )* 0 ( 0 | 1) ( 0 | 1) 由0和1组成且以000,001,010或011结束的符号串全体. 长度大于等于3且倒数第3个字符为0的01符号串全体.
R R ‘|’ S | S S ST | T T U* | U U (R) | a | b
a
a
a
28
4.5 dangling-else文法: stmt if expr then stmt | matched-stmt matched-stmt if expr then matched-stmt else stmt | other 试说明此文法是二义性的。 句子 if e1 then if e2 then s1 else if e3 then s2 else s3 if e1 then if e2 then s1 else if e3 then s2 else s3
0|1 B 1 D E 0 ABDE ABDE ABCDE ABDE 1 ABCDE ABCDE
start
A
1
C
NFA 0
start A' 1
0
B'
0
1
start
A'
1
最小化DFA
24
DFA
3.8 给定右线性文法G: S 0S | 1S | 1A | 0B A 1C |1 B 0C | 1 C 0C | 1C | 0 | 1 试求一个等价的左线性文法G’.
20
3.6 给出接受下列在字母表{0,1}上的DFA。 (a)所有以00结束的符号串的集合; (1|0)*00
编译原理课后答案-第二版
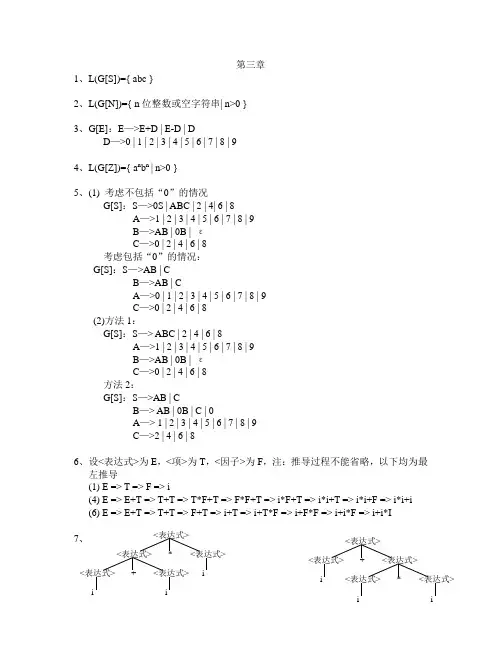
第三章1、L(G[S])={ abc }2、L(G[N])={ n位整数或空字符串| n>0 }3、G[E]:E—>E+D | E-D | DD—>0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 94、L(G[Z])={ a n b n | n>0 }5、(1) 考虑不包括“0”的情况G[S]:S—>0S | ABC | 2 | 4| 6 | 8A—>1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9B—>AB | 0B | εC—>0 | 2 | 4 | 6 | 8考虑包括“0”的情况:G[S]:S—>AB | CB—>AB | CA—>0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9C—>0 | 2 | 4 | 6 | 8(2)方法1:G[S]:S—> ABC | 2 | 4 | 6 | 8A—>1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9B—>AB | 0B | εC—>0 | 2 | 4 | 6 | 8方法2:G[S]:S—>AB | CB—> AB | 0B | C | 0A—> 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9C—>2 | 4 | 6 | 86、设<表达式>为E,<项>为T,<因子>为F,注:推导过程不能省略,以下均为最左推导(1) E => T => F => i(4) E => E+T => T+T => T*F+T => F*F+T => i*F+T => i*i+T => i*i+F => i*i+i(6) E => E+T => T+T => F+T => i+T => i+T*F => i+F*F => i+i*F => i+i*I7、<表达式><表达式>*<表达式><表达式>+<表达式>i i i<表达式><表达式>+<表达式>i <表达式>*<表达式>i i8、是有二义性的,因为句子abc 有两棵语法树(或称有两个最左推导或有两个最右推导)最左推导1:S => Ac => abc 最左推导2:S => aB => abc 9、(1)(2) 该文法描述了变量a 和运算符+、*组成的逆波兰表达式10、(1) 该文法描述了各种成对圆括号的语法结构(2) 是有二义性的,因为该文法的句子()()存在两种不同的最左推导: 最左推导1:S => S(S)S => (S)S => ()S => ()S(S)S => ()(S)S => ()()S => ()()最左推导2:S => S(S)S => S(S)S(S)S => (S)S(S)S=> ()S(S)S => ()(S)S => ()()S => ()()11、(1) 因为从文法的开始符E 出发可推导出E+T*F ,推导过程如下:E => E+T =>E+T*F ,所以E+T*F 是句型。
编译原理教程课后习题答案

第二章 词法分析2.1 完成下列选择题: (1) 词法分析器的输出结果是 。
a. 单词的种别编码 b. 单词在符号表中的位置 c. 单词的种别编码和自身值 d. 单词自身值 (2) 正规式M1和M2等价是指 。
a. M1和M2的状态数相等 b. M1和M2的有向边条数相等 c. M1和M2所识别的语言集相等 d. M1和M2状态数和有向边条数相等 (3) DFA M(见图2-1)接受的字集为 。
a. 以0开头的二进制数组成的集合 b. 以0结尾的二进制数组成的集合 c. 含奇数个0的二进制数组成的集合 d. 含偶数个0的二进制数组成的集合 【解答】 (1) c (2) c (3) d图2-1 习题的DFA M2.2 什么是扫描器?扫描器的功能是什么? 【解答】 扫描器就是词法分析器,它接受输入的源程序,对源程序进行词法分析并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
通常是把词法分析器作为一个子程序,每当词法分析器需要一个单词符号时就调用这个子程序。
每次调用时,词法分析器就从输入串中识别出一个单词符号交给语法分析器。
2.3 设M=({x,y}, {a,b}, f, x, {y})为一非确定的有限自动机,其中f 定义如下: f(x,a)={x,y} f {x,b}={y} f(y,a)=Φ f{y,b}={x,y} 试构造相应的确定有限自动机M ′。
【解答】 对照自动机的定义M=(S,Σ,f,So,Z),由f 的定义可知f(x,a)、f(y,b)均为多值函数,因此M 是一非确定有限自动机。
先画出NFA M 相应的状态图,如图2-2所示。
图2-2 习题的NFA M用子集法构造状态转换矩阵,如表表2-1 状态转换矩阵1b将转换矩阵中的所有子集重新命名,形成表2-2所示的状态转换矩阵,即得到 M ′=({0,1,2},{a,b},f,0,{1,2}),其状态转换图如图2-3所示。
编译原理课后习题答案+清华大学出版社第二版
用以引用非局部(包围它的过程)变量时,寻找该变量的地址。 DL: 动态链,指向调用该过程前正在运行过程的数据段基地址,用以过程执行结束释放
数据空间时,恢复调用该过程前运行栈的状态。 RA: 返回地址,记录调用该过程时目标程序的断点,即调用过程指令的下一条指令的地
编译程序大致有哪几种开发技术?
答案:
(1)自编译:用某一高级语言书写其本身的编译程序。 (2)交叉编译:A 机器上的编译程序能产生 B 机器上的目标代码。 (3)自展:首先确定一个非常简单的核心语言 L0,用机器语言或汇编语言书写出它的编
译程序 T0,再把语言 L0 扩充到 L1,此时 L0⊂ L1 ,并用 L0 编写 L1 的编译程序 T1,再把语 言 L1 扩充为 L2,有 L1 ⊂ L2 ,并用 L1 编写 L2 的编译程序 T2,……,如此逐步扩展下 去, 好似滚雪球一样,直到我们所要求的编译程序。 (4)移植:将 A 机器上的某高级语言的编译程序搬到 B 机器上运行。
(main).
答案: 程序执行到赋值语句 b∶=10 时运行栈的布局示意图为:
1
《编译原理》课后习题答案第二章
第 3题 写出题 2 中当程序编译到 r 的过程体时的名字表 table 的内 容。
name
kind
level/val
adr
size
答案:
题 2 中当程序编译到 r 的过程体时的名字表 table 的内容为:
盛威网()专业的计算机学习网站
2
《编译原理》课后习题答案第一章
合实现方案,即先把源程序翻译成较容易解释执行的某种中间代码程序,然后集中解释执行 中间代码程序,最后得到运行结果。
(完整word版)编译原理课后答案
第二章 高级语言及其语法描述4.令+、*和↑代表加,乘和乘幂,按如下的非标准优先级和结合性质的约定,计算1+1*2↑2*1↑2的值:(1) 优先顺序(从高至低)为+,*和↑,同级优先采用左结合。
(2) 优先顺序为↑,+,*,同级优先采用右结合。
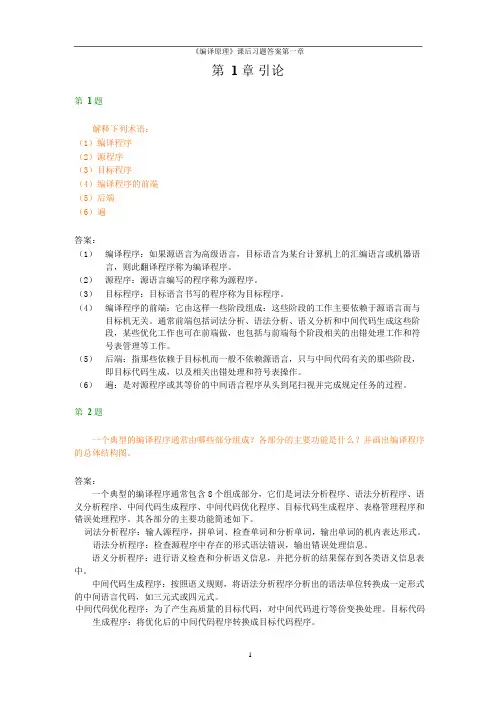
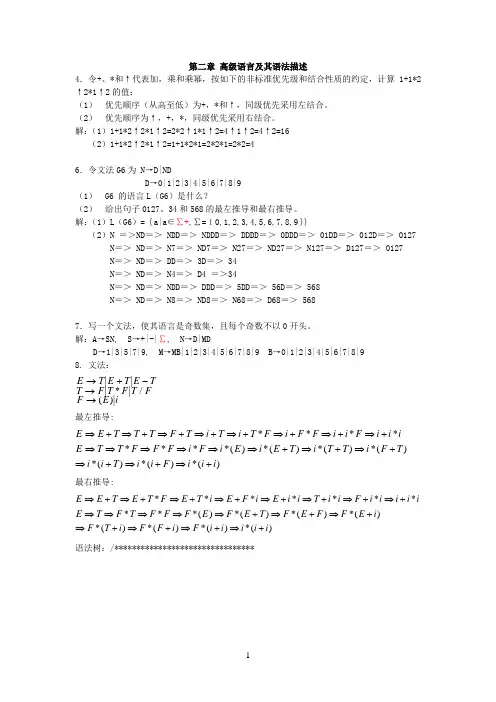
解:(1)1+1*2↑2*1↑2=2*2↑1*1↑2=4↑1↑2=4↑2=16 (2)1+1*2↑2*1↑2=1+1*2*1=2*2*1=2*2=46.令文法G6为 N →D|NDD →0|1|2|3|4|5|6|7|8|9 (1) G6 的语言L (G6)是什么?(2) 给出句子0127、34和568的最左推导和最右推导。
解:(1)L (G6)={a|a ∈∑+,∑=﹛0,1,2,3,4,5,6,7,8,9}}(2)N =>ND => NDD => NDDD => DDDD => 0DDD => 01DD => 012D => 0127 N => ND => N7=> ND7=> N27=> ND27=> N127=> D127=> 0127 N => ND => DD => 3D => 34 N => ND => N4=> D4 =>34N => ND => NDD => DDD => 5DD => 56D => 568 N => ND => N8=> ND8=> N68=> D68=> 5687.写一个文法,使其语言是奇数集,且每个奇数不以0开头。
解:A →SN, S →+|-|∑, N →D|MDD →1|3|5|7|9, M →MB|1|2|3|4|5|6|7|8|9 B →0|1|2|3|4|5|6|7|8|9 8. 文法:E T E T E T TF T F T F F E i→+-→→|||*|/()| 最左推导:E E T T TF T i T i T F i F F i i F i i i E T T F F F i F i E i E T i T T i F T i i T i i F i i i ⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒⇒⇒⇒⇒⇒+⇒+⇒+⇒+⇒+⇒+********()*()*()*()*()*()*()最右推导:E E T E TF E T i E F i E i i T i i F i i i i i E T F T F F F E F E T F E F F E i F T i F F i F i i i i i ⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒⇒⇒⇒⇒+⇒+⇒+⇒+⇒+⇒+⇒+**********()*()*()*()*()*()*()*()语法树:/********************************EE FTE +T F F T +iiiEEFTE-T F F T -iiiEEFT+T F FTiii*i+i+ii-i-ii+i*i*****************/9.证明下面的文法是二义的:S → iSeS|iS|I解:因为iiiiei 有两种最左推导,所以此文法是二义的。
编译原理(龙书)课后习题解答(详细)

编译原理(龙书)课后习题解答(详细)编译原理(龙书)课后题解答第一章1.1.1 :翻译和编译的区别?答:翻译通常指自然语言的翻译,将一种自然语言的表述翻译成另一种自然语言的表述,而编译指的是将一种高级语言翻译为机器语言(或汇编语言)的过程。
1.1.2 :简述编译器的工作过程?答:编译器的工作过程包括以下三个阶段:(1) 词法分析:将输入的字符流分解成一个个的单词符号,构成一个单词符号序列;(2) 语法分析:根据语法规则分析单词符号序列中各个单词之间的关系,确定它们的语法结构,并生成抽象语法树;(3) 代码生成:根据抽象语法树生成目标程序(机器语言或汇编语言),并输出执行文件。
1.2.1 :解释器和编译器的区别?答:解释器和编译器的主要区别在于执行方式。
编译器将源程序编译成机器语言或汇编语言等,在运行时无需重新编译,程序会一次性运行完毕;而解释器则是边翻译边执行,每次执行都需要进行一次翻译,一次只执行一部分。
1.2.2 :Java语言采用的是解释执行还是编译执行?答:Java一般是编译成字节码的形式,然后由Java虚拟机(JVM)进行解释执行。
但是,Java也有JIT(即时编译器)的存在,当某一段代码被多次执行时,JIT会将其编译成机器语言,提升代码的执行效率。
第二章2.1.1 :使用BNF范式定义简单的加法表达式和乘法表达式答:<加法表达式> ::= <加法表达式> "+" <乘法表达式> | <乘法表达式><乘法表达式> ::= <乘法表达式> "*" <单项式> | <单项式><单项式> ::= <数字> | "(" <加法表达式> ")"2.2.3 :什么是自下而上分析?答:自下而上分析是指从输入字符串出发,自底向上构造推导过程,直到推导出起始符号。
编译原理课后习题答案
编译原理课后习题答案编译原理习题答案习题11.1翻译程序:把⽤某种程序设计语⾔(源语⾔)编写的程序(源程序)翻译成与之等价的另⼀种语⾔(⽬标语⾔)的程序(⽬标程序)。
编译程序:⼀种翻译程序,将⾼级语⾔编写的源程序翻译成等价的机器语⾔或汇编语⾔的⽬标程序。
1.2词法分析、语法分析、语义分析和中间代码⽣成、代码优化、⽬标代码⽣成1.3词法分析:根据语⾔的词法规则对构成源程序的符号进⾏扫描和分解,识别出⼀个个的单词。
语法分析:根据语⾔的语法规则,把单词符号串分解成各类语法单位。
语义分析及中间代码⽣成:对语法分析识别出的语法单位分析其含义,并进⾏初步翻译。
代码优化:对中间代码进⾏加⼯变换,以产⽣更⾼效的⽬标代码。
⽬标代码⽣成:将中间代码变换成特定机器上的绝对指令代码、可重定位的指令代码或会变指令代码。
以上5个阶段依次执⾏。
习题22.1 (1)有穷⾮空的符号集合(2)利⽤产⽣是规则A->v将A替换为v时与A的上下⽂⽆关。
(3)略(4)推导是把句型中的⾮终结符⽤⼀个产⽣是规则的右部开替代的过程;直接推导是将⾮终结符的替代结果只⽤了⼀次产⽣式规则。
(5)略(6)⼀个句型的最左直接短语(7)如果⼀个⽂法存在某个句⼦对应两棵不同的语法树或有两个不同的最左(右)推导,则称这个⽂法是⼆义的。
2.2(1)VN ={Z,A,B} VT ={a,b,c,d,e}(2)abbcde,abbbcde是,acde不是。
2.3 (1)L[G]={d|n≥1,m≥0}(2)2.4 (1) A=>B=>c=>fAg=>fBg=>fCg=>feg(2)A=>AaB=>AaC=>Aae=>Bae=>BcCae=>Bceae=>Cceae=>eceae(3)A=>B=>BcC=>BcfAg=>BcfAaBg=>BcfAaCg=>BcfAaeg=>BcfBaeg =>BcfCaeg=>Bcfeaeg=>Ccfeaeg=>ecfeaeg(3)中题⽬有错应为C fCg|e2.5L[G]={a?b?c?|aab,n≥2}2.6 (1)Z→AB A→Aa|ε B→Bb|ε(2)Z→aZb|ab(3)Z→aAb A→aAb|b(4)Z→AB A→aAb|ab B→cB|ε(5)Z→aaAb|ab Z→aaBb|bb A→aaAb|ab B→aaBb|bb2.7 ⼀位数:Z→2|4|6|8两位数:Z→AB A→1|2|3|4|5|6|7|8|9 B→0|2|4|6|8三位以上:Z→ACB A→1|2|3|4|5|6|7|8|9 B→0|2|4|6|8 C→CDD→0|1|2|3|4|5|6|7|8|92.8证明:E=>E+T=>E+T*F短语:T*F E+T*F 直接短语:T*F 句柄:T*F2.9 语法树: E 短语:E*T , (E*T) , F↑(E*T) ,F ,E* F↑(E*T)E *F 直接短语:E*T , FT ↑ F 句柄:FF ( E )E * T2.10(1)语法树(2)直接短语:a , ZZ 句柄:Z( L )L , ZZ ( L )Za2.11最左推导:Z=>ZaB=>BaB=>B+AaB=>A+AaB=>(+)Z*aB=>(+)ZaB*aB =>(+)+aB*aB=>(+)+aA*aB=>(+)+a(*aB=>(+)+a(*aA=>(+)+a(*a(直接短语:(,+句柄:(2.12(1) S=>iSeS=>iiSeS=>iiIeS=>iiIeIS=>iS=>iiSeS=>iiIeS=>iiIeI(2) S=>SaS=>cSaS=>cfaS=>cfafS=>cS=>cSaS=>cfaS=>cfaf(3) E=>EOE=>EOEOE=>iOEOE=>i+EOE=>i+iOE=>i+i-E=>i+i-iE=>EOE=>iOE=>i+E=>i+EOE=>i+iOE=>i+i-E=>i+i-i2.13 Z→aABZ|cCACdA→bAB|aZA|cCCB→bAB|CzbC→cZ|c习题33.1(1)确定的有限⾃动机(2)不确定的有限⾃动机(3)正规集是⼀类特殊的单词集合,正规式是正规集的描述⼯具 3.2 (1) (1|2|3|4|5|6|7|8|9|0)*(1|3|5|7|9) (2) 11(0|1)*00 3.3 证明:b *(a|b)+={a,b,ab,ba,aa,bb …} (a|b)+={a,b,ab,ba,aa,bb …} 3.4 (1)(2)DDDD3.5(1) (2)(3)3.6(1) (01|10) *(01|10)(2) (0(1|00)*)|003.7(1) Z →1AB (2)Z →ABA →(0|1)A A →0A|εA →0|1B →(0|1)B|ε B →0B B →ε3.8 r=a(a|b )*bb3.9 Z →1BB →0Z|0 Z →0Z|ε3.10 3.11DDD习题44.1 (1)若⽂法G[Z]满⾜①⽂法不含左递归②③(2)4.2(1) First(S)={a,d} First(B)={a,d,c,ε}First(A)={a,d,e,c} First(D)={a,d,ε}Follow(S)={#,a,b,d,e} Follow(B)={a,d}Follow(A)={b} Follow(D)={e,a,d,b}(2) 不是4.3 (1) 证明: First(Z)={a,b,c} Follow(S)={#,a,b,c,d} First(A)={a,b,c,d} Follow(A)={ #,a,b,c,d }First(B)={a,d,c} Follow(B)={ a,b,c,d } 是LL(1)⽂法。
编译原理教程-课后习题答案第三章语法分析ppt课件
a. LALR文法 b. LR(0)文法
c. LR(1)文法 d. SLR(1)文法
第三章 语法分析
(8) 同心集合并有能够产生新的 冲突。
a. 归约
b. “移进〞/“移进〞
c.“移进〞/“归约〞 〞
d. “归约〞/“归约
【解答】 (1) c (2) a (3) c (5) b (6) b (7) d (8) d
#⋖ (⋖,⋖ (⋖a⋗)⋗)⋗# 因此,素短语为a。
第三章 语法分析
3.8 下述文法描画了C言语整数变量的声明语句: G[D]: D→TL T→int|long|short L→id|L,id
(1) 改造上述文法,使其接受一样的输入序列, 但文法是右递归的;
(2) 分别用上述文法G[D]和改造后的文法G[D′] 为输入序列int a,b,c构造分析树。
第三章 语法分析
(2) 为了构造字母表Σ={a,b}上同时只需奇数个a 和奇数个b的一切串集合的正规式,我们画出如图3-3 所示的DFA,即由开场符S出发,经过奇数个a到达形状 A,或经过奇数个b到达形状B;而由形状A出发,经过 奇数个b到达形状C(终态);同样,由形状B出发经过奇 数个a到达终态C。
第三章 语法分析
第三章 语法分析
3.1 完成以下选择题:
(1) 文法G:S→xSx|y所识别的言语是 。
a. xyx
b. (xyx)*
c. xnyxn(n≥0)
d. x*yx*
(2) 假设文法G是无二义的,那么它的任何句子α 。
a. 最左推导和最右推导对应的语法树必定一样
b. 最左推导和最右推导对应的语法树能够不同 c. 最左推导和最右推导必定一样
能否不画出语法树,而直接由定义(即在句型中)寻觅满足某 个产生式的候选式这样一个最左子串(即句柄)呢?例如,对句型 aAaBcbbdcc,我们可以由左至右扫描找到第一个子串AaB,它恰好 是满足A→AaB右部的子串;与树(a)对照,AaB确实是该句型的句 柄。能否这一方法一直正确呢?我们继续检查句型aAcbBdcc,由 左至右找到第一个子串c,这是满足A→C右部的子串,但由树(b) 可知,c不是该句型的句柄。由此可知,画出对应句型的语法树然 后寻觅最左直接短语是确定句柄的好方法。
编译原理教程第四版答案
编译原理教程第四版答案编译原理教程第四版答案【篇一:编译原理教程课后习题答案——第三章】.1 完成下列选择题:(1) 文法g:s→xsx|y所识别的语言是a. xyxb. (xyx)*c. xnyxn(n≥0)d. x*yx*a. 最左推导和最右推导对应的语法树必定相同b. 最左推导和最右推导对应的语法树可能不同c. 最左推导和最右推导必定相同d. 可能存在两个不同的最左推导,但它们对应的语法树相同(3) 采用自上而下分析,必须。
a. 消除左递 a. 必有ac归b. 消除右递归c. 消除回溯d. 提取公共左因子(4) 设a、b、c是文法的终结符,且满足优先关系ab和bc,则。
b. 必有cac. 必有bad. a~c都不一定成立(5) 在规范归约中,用a. 直接短语b. 句柄c. 最左素短语d. 素短语a. 归约b. 移进d. 待约a. lalr文法b. lr(0)文法c. lr(1)文法d. slr(1)文法(8) 同心集合并有可能产生新的冲突。
a. 归约b. “移进”/“移进”c.“移进”/“归约”d. “归约”/“归约”【解答】 (1) c (2) a (3) c (4) d (5) b (6) b (7) d (8) d3.2 令文法g[n]为g[n]: n→d|ndd→0|1|2|3|4|5|6|7|8|9(1) g[n]的语言l(g[n])是什么?(2) 给出句子0127、34和568的最左推导和最右推导。
【解答】(1) g[n]的语言l(g[n])是非负整数。
(2) 最左推导: nndnddnddddddd0ddd01dd012d0127nnddd3d34nndnddddd5dd56d568最右推导: nndn7nd7n27nd27n127d1270127nndn4d434nndn8nd8n68d685683.3 已知文法g[s]为s→asb|sb|b,试证明文法g[s]为二义文法。
编译原理教程课后习题答案第二章
第二章 词法分析2.1 完成下列选择题:(1) 词法分析器的输出结果是。
a. 单词的种别编码b. 单词在符号表中的位置c. 单词的种别编码和自身值d. 单词自身值(2) 正规式M1和M2等价是指。
a. M1和M2的状态数相等b. M1和M2的有向边条数相等c. M1和M2所识别的语言集相等d. M1和M2状态数和有向边条数相等(3) DFA M(见图2-1)接受的字集为。
a. 以0开头的二进制数组成的集合b. 以0结尾的二进制数组成的集合c. 含奇数个0的二进制数组成的集合d. 含偶数个0的二进制数组成的集合【解答】(1) c (2) c (3) d图2-1 习题2.1的DFA M2.2 什么是扫描器?扫描器的功能是什么?【解答】 扫描器就是词法分析器,它接受输入的源程序,对源程序进行词法分析并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
通常是把词法分析器作为一个子程序,每当词法分析器需要一个单词符号时就调用这个子程序。
每次调用时,词法分析器就从输入串中识别出一个单词符号交给语法分析器。
2.3 设M=({x,y}, {a,b}, f, x, {y})为一非确定的有限自动机,其中f 定义如下:f(x,a)={x,y} f {x,b}={y}f(y,a)=Φ f{y,b}={x,y}试构造相应的确定有限自动机M ′。
【解答】 对照自动机的定义M=(S,Σ,f,So,Z),由f 的定义可知f(x,a)、f(y,b)均为多值函数,因此M 是一非确定有限自动机。
先画出NFA M 相应的状态图,如图2-2所示。
图2-2 习题2.3的NFA M 用子集法构造状态转换矩阵,如表表2-1 状态转换矩阵1b将转换矩阵中的所有子集重新命名,形成表2-2所示的状态转换矩阵,即得到 M ′=({0,1,2},{a,b},f,0,{1,2}),其状态转换图如图2-3所示。
表2-2 状态转换矩阵将图2-3所示的DFA M ′最小化。