
hadoop开发入门教程48 - HBase编程实践及案例分析(8)
OpenTSDB的最佳实践
宽行使得查询效率更高 按照时间范围来切分行,比如每10m 每个KeyValue行存储更多的数据 使用async hbase + Netty,而不要在使用 HTable/HTablePool 使用定长的key。对于变长的key,scan的效率很低 RegionServer管理的region数量不宜过多。Region恢复成 本高
使用异步处理
OpenTSDB能解决的问题
如何高效的在Hbase里面存储时间序列数据? 在没有同步写的情况下如何启动并发写? 如何在Hbase里存储数据的时候节省磁盘/内存空间?
时间序列数据在Hbase的存储
最简单的设计:1个TS,单一的KeyValue 支持时间范围扫描
时间序列数据在Hbase的存储
时间序列数据在Hbase的存储
时间序列数据在Hbase的存储
什么时候开始新的பைடு நூலகம்? 以10分钟为界限分行
时间序列数据在Hbase的存储
设置宽行来提升查询速度
时间序列数据在Hbase的存储
时间序列数据在Hbase的存储
欢迎访问我们的官方网站
在RowKey前面添加metric方便定位数据 问题:在行键中存储大量文本造成空间浪费
时间序列数据在Hbase的存储
创建一个独立的表来保存metrics和tags的数据,并分配唯 一ID
时间序列数据在Hbase的存储
通过在同一行存储多个连续的数据点,减少行的数量 更少的行=对指定行更快的查询
Hadoop大数据解决方案进阶应用
HBase编程实践及案例分析 (8)
Hadoop
讲师:迪伦(北风网版权所有)
课程目标 Hbase案例:OpenTSDB
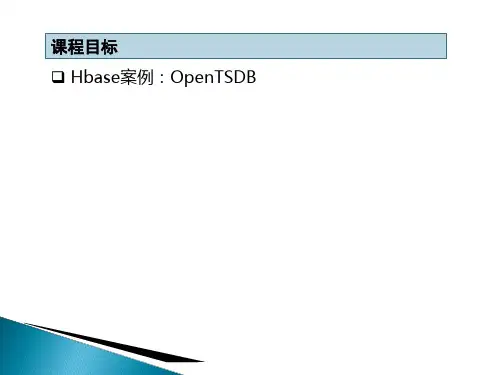
OpenTSDB核心概念
Data Points (time, value) Metrics proc.loadavg.1m Tags host=web42 pool=static Metric + Tags = 时间序列 Order of magnitude: >106 time series, >1012 data points
Hadoop大数据开发基础教案Hadoop介绍教案
Hadoop大数据开发基础教案Hadoop介绍教案第一章:Hadoop概述1.1 课程目标了解Hadoop的定义、发展历程及应用场景掌握Hadoop的核心组件及其作用理解Hadoop在大数据领域的优势1.2 教学内容Hadoop的定义与发展历程Hadoop的核心组件:HDFS、MapReduce、YARN Hadoop的应用场景与优势1.3 教学方法讲解与案例分析相结合互动提问,巩固知识点1.4 课后作业简述Hadoop的发展历程及其在大数据领域的优势。
第二章:HDFS(分布式文件系统)2.1 课程目标掌握HDFS的架构与工作原理了解HDFS的优势与局限性掌握HDFS的常用操作命令2.2 教学内容HDFS的架构与工作原理HDFS的优势与局限性HDFS的常用操作命令:hdfs dfs, hdfs dfsadmin2.3 教学方法讲解与实践操作相结合案例分析,理解HDFS的工作原理2.4 课后作业利用HDFS命令练习文件的与。
第三章:MapReduce编程模型3.1 课程目标掌握MapReduce的基本概念与编程模型理解MapReduce的运行原理与执行过程学会使用MapReduce解决大数据问题3.2 教学内容MapReduce的基本概念:Mapper、Reducer、Shuffle与Sort MapReduce的编程模型:Map阶段、Shuffle阶段、Reduce阶段MapReduce的运行原理与执行过程3.3 教学方法讲解与编程实践相结合剖析经典MapReduce案例,理解编程模型3.4 课后作业编写一个简单的MapReduce程序,实现单词计数功能。
第四章:YARN(资源管理器)4.1 课程目标掌握YARN的基本概念与架构了解YARN的工作原理与调度策略掌握YARN的资源管理与优化方法4.2 教学内容YARN的基本概念与架构YARN的工作原理与调度策略YARN的资源管理与优化方法4.3 教学方法讲解与案例分析相结合实操演练,掌握YARN的资源管理方法4.4 课后作业分析一个YARN集群的资源使用情况,提出优化方案。
48-大数据技术教学大纲-大数据技术基础-宋旭东-清华大学出版社

《大数据技术》课程教学大纲课程编号:适用专业:数据科学与大数据技术及相关专业执笔:适用年级:本科四年级一、课程性质和教学目的(-)课程性质《大数据技术》是数据科学与大数据技术专业以及讣算机科学与技术、软件工程、网络工程及物联网等相关专业的专业基础课。
(二)教学目的通过本课程的学习,要求学生达到:1.掌握大数据的基本概念和相关技术。
2.掌握大数据分布式存储和并行讣算的思想,能够构建大数据Hadoop平台。
3.理解HDFS、HBase. Hive、Spark的工作原理、掌握其基本操作。
4.能够编写简单的大数据MapReduce程序。
5.培养学生大数据思维和讣算思维的能力。
二、课程教学内容1.大数据基础。
着重介绍大数据基本概念,大数据的4V特征及在其应用,大数据框架体系,大数据采集与预处理技术、数据存储和管理技术、数据分析与挖掘技术、数据可视化等技术;大数据并行计算框架Hadoop平台及其核心组件。
2.大数据存储与管理。
着重介绍大数据存储与管理的基本概念和技术,大数据数据类型, 大数分布式系统基础理论,NoSQL数据库,分布式存储技术、虚拟化技术和云存储技术;大数据分布式文件系统HDFS,包括HDFS的设计特点,体系结构和工作组件;大数据分布式数据库系统HBase,包括HBase列式数据库的逻辑模型和物理模型,HBase体系结构及其工作原理;大数据分布式数据仓库系统Hive,包括Hive的工作原理和执行流程、Hive的数据类型与数据模型,以及Hive 主要访问接口等。
3.大数据釆集与预处理。
着重介绍大数据采集与预处理相关技术,包括数据抽取、转换和加载技术,数据爬虫技术、数据清理、数据集成、数据变换和数据归约的方法和技术;大数据采集工具,包括Sqoop关系型大数据采集工具,Flume日志大数据采集工具和分布式大数据Nutch爬虫系统。
4.大数据分析与挖掘。
着重介绍大数据计算模式,包括大数据批处理、大数据查询分析计算、大数据流计算、大数据迭代计算、大数据图讣算;大数据MapReduce计算模型、模型框架和数据处理过程,以及MapReduce主要编程接口;大数据Spark II'算模型,包括Spark 的工作流程与运行模式;大数据MapReduce基础算法和挖掘算法(这部分内容可选讲)。
Hadoop大数据开发基础教案Hadoop基础操作教案

一、Hadoop简介1. 教学目标:(1)了解Hadoop的起源、发展历程和应用场景;(2)掌握Hadoop的核心组件及其作用;(3)了解Hadoop的生态体系。
2. 教学内容:(1)Hadoop的起源和发展历程;(2)Hadoop的核心组件:HDFS、MapReduce、YARN;(3)Hadoop的生态体系:Hive、HBase、Spark等。
3. 教学方法:(1)采用讲解、案例演示相结合的方式进行教学;(2)引导学生通过课后资料了解Hadoop的发展历程和应用场景;(3)组织学生讨论Hadoop的核心组件及其作用。
4. 教学资源:(1)PPT课件;(2)课后资料:Hadoop相关论文、博客等。
5. 教学环节:(1)介绍Hadoop的起源和发展历程;(2)讲解Hadoop的核心组件及其作用;(3)介绍Hadoop的生态体系;(4)案例演示:Hadoop的基本操作;(5)课后作业:深入了解Hadoop的应用场景。
二、HDFS分布式文件系统1. 教学目标:(1)了解HDFS的架构和原理;(2)掌握HDFS的基本操作;(3)了解HDFS的优缺点。
2. 教学内容:(1)HDFS的架构和原理;(2)HDFS的基本操作:文件、文件、文件权限管理等;(3)HDFS的优缺点。
3. 教学方法:(1)采用讲解、案例演示相结合的方式进行教学;(2)引导学生通过课后实践掌握HDFS的基本操作;(3)组织学生讨论HDFS的优缺点。
4. 教学资源:(1)PPT课件;(2)课后实践:搭建HDFS集群,进行文件操作。
5. 教学环节:(1)讲解HDFS的架构和原理;(2)演示HDFS的基本操作;(3)介绍HDFS的优缺点;(4)课后实践:搭建HDFS集群,进行文件操作;(5)课后作业:总结HDFS的使用经验和注意事项。
三、MapReduce编程模型1. 教学目标:(1)了解MapReduce的原理和流程;(2)掌握MapReduce的基本编程方法;(3)了解MapReduce的优缺点。
《Hadoop平台搭建与应用》项目HBase环境搭建与基本操作

HBase集群监控工具使用
使用HBase Shell
HBase Shell是一个交互式shell程序,可以用于管理和操作HBase。
使用HBase Browser
HBase Browser是一个Web应用程序,可以查看HBase的状态、表结构等信息,也可以进行数据浏览、操作 等。
HBase集群常见问题与解决方案
THANKS
创建表时,需要指定表的名称和列族名称及属性 。
删除表时,使用`disable`命令禁用表,然后 使用`drop`命令删除表。
HBase表的数据读取与写入
HBase表中的数据包括行键、列族、列限定符和时间戳等。
读取数据时,使用HBase Shell或HBase API通过行键或过滤器进行查询。
写入数据时,通过HBase Shell或HBase API向表中插入、更新或删除数据,HBase会自动将数据存储 到相应的列族中。
07
总结与展望
HBase学习总结
HBase是一个高可扩展、高可用、面向列的分布 式数据库系统,运行在Hadoop分布式文件系统 (HDFS)之上,提供了高性能的随机读/写访问 能力。
HBase具有非常灵活的表结构定义能力,支持动 态数据模型和数据版本控制,这使得HBase在处 理半结构化和非结构化数据方面具有很强的能力 。
HBase Java API基本操作
连接HBase
创建表
插入数据
查询数据
使用HBase的Java API连接到 HBase集群。
通过Java代码创建HBase表,需 要定义表名、列族等信息。
向HBase表中插入数据,需要指 定表名、行对象、列对象和数据 值。
根据行号、列名或者时间戳等条 件查询HBase表中的数据,需要 指定表名、行号、列名和时间戳 等条件。
Hadoop业务开发测试HBase

业务开发测试HBase之旅四:HBase MapReduce实例分析引言跟Hadoop的无缝集成使得使用MapReduce对HBase的数据进行分布式计算非常方便,本文将以前面的blog示例,介绍HBase下MapReduce开发要点。
很好理解本文前提是你对HadoopMapReduce有一定的了解,如果你是初次接触HadoopMapReduce编程,可以参考/?p=10523 这篇文章来建立基本概念。
HBaseMapReduce核心类介绍首先一起来回顾下MapReduce的基本编程模型,可以看到最基本的是通过Mapper和Reducer来处理KV对,Mapper的输出经Shuffle及Sort后变为Reducer的输入。
除了Mapper和Reducer外,另外两个重要的概念是InputFormat和OutputFormat,定义了Map-Reduce的输入和输出相关的东西。
HBase通过对这些类的扩展(继承)来方便MapReduce任务来读写HTable中的数据。
实例分析我们还是以最初的blog例子来进行示例分析,业务需求是这样:找到具有相同兴趣的人,我们简单定义为如果author之间article的tag相同,则认为两者有相同兴趣,将分析结果保存到HBase。
除了上面介绍的blog表外,我们新增一张表tag_friend,RowKey为tag,Value为authors,大概就下面这样。
我们省略了一些跟分析无关的Column数据,上面的数据按前面描述的业务需求经过MapReduce分析,应该得到下面的结果实际的运算过程分析如下代码实现有了上面的分析,代码实现就比较简单了。
只需以下几步定义Mapper类继承TableMapper,map的输入输出KV跟上面的分析一致。
public static class Mapper extends TableMapper<ImmutableBytesWritable, ImmutableBytesWritable> {public Mapper() {}@Overridepublic void map(ImmutableBytesWritable row, Resultvalues,Contextcontext) throws IOException {ImmutableBytesWritable value = null;String[] tags = null;for (KeyValuekv : values.list()) {if ("author".equals(Bytes.toString(kv.getFamily()))&&"nickname".equals(Bytes.toString(kv.getQualifier()))) {value = new ImmutableBytesWritable(kv.getValue());}if ("article".equals(Bytes.toString(kv.getFamily()))&&"tags".equals(Bytes.toString(kv.getQualifier()))) {tags = Bytes.toString(kv.getValue()).split(",");}}for (inti = 0; i<tags.length; i++) {ImmutableBytesWritable key = new ImmutableBytesWritable(Bytes.toBytes(tags[i].toLowerCase()));try {context.write(key,value);} catch (InterruptedException e) {throw new IOException(e);}}}}定义Reducer类继承TableReducer,reduce的输入输出KV跟上面分析的一致。
hadoop开发入门教程48 - HBase编程实践及案例分析(8)17页PPT
OpenTSDB核心概念
Data Points (time, value)
Metrics proc.loadavg.1m
Tags host=web42 pool=static
Metric + Tags = 时间序列 Order of magnitude: >106 time series, >1012 data
points
OpenTSDB的最佳实践
宽行使得查询效率更高 按照时间范围来切分行,比如每10m 每个KeyValue行存储更多的数据 使用async hbase + Netty,而不要在使用
HTable/HTablePool 使用定长的key。对于变长的key,scan的效率很低 RegionServer管理的region数量不宜过多。Region恢复成
时间序列数据在Hbase的存储
时间序列数据在Hbase的存储
什么时候开始新的行? 以10分钟为界限分行
时间序列数据在Hbase的存储
设置宽行来提升查询速度
时间序列数据在Hbase的存储
时间序列数据在Hbase的存储
欢迎访问我们的官方网站 ibeifeng
更多精品资请访问
更多品资源请访问
本高使用异步处理OpnTSDB能解决的问题如何高效的在Hbase里面存储时间序列数据? 在没有同步写的情况下如何启动并发写? 如何在Hbase里存储数据的时候节省磁盘/内存空间?
时间序列数据在Hbase的存储
最简单的设计:1个TS,单一的KeyValue 支持时间范围扫描
时间序列数据在Hbase的存储
在RowKey前面添加metric方便定位数据 问题:在行键中存储大量文本造成空间浪费
Hadoop学习文档
Had oop学习文档Hbase学习总结(一)Hbase的安装与运行1.下载并解压hbase-0.94.6.1.tar.gztar xfz hbase-0.94.6.1.tar.gz2.编辑conf/hbase-site.xml在configuration标签中添加:<property><name>hbase.rootdir</name><value>file:///var/lib/tcommsvr/Hbase_lin/hbase</value></property>说明:该项配置了数据写入的目录,默认 hbase.rootdir 是指向 /tmp/hbase-${} ,也就说你会在重启后丢失数据(重启的时候操作系统会清理/tmp目录)。
3.编辑conf/hbase-env.sh修改JAVA_HOME路径export JAVA_HOME=/usr/java/jdk1.6.0_29说明:该项默认是注释掉的,需要放开并修改4.进入bin目录,运行start-hbase.sh进入logs目录下查看hbase-root-master-slave2.log日志,查看运行情况5.查看hbase文件夹,可以看到如上图所示的内容生成。
Hbase的shell操作1.进入bin目录,运行sh hbase shell进入shell命令输入help可查看常用命令下面测试建立一个表并添加几条数据,并查询,然后删除该表create 'test_lin' ,'cf'然后执行list,可以看到该表已创建,该表名称为test_lin , 这个表只有一个column family 为 cf,注意:表名称和column family 都必须加上单引号下面插入一些记录:put 'test_lin','lucy','cf:name_lucy','New York_lucy'put 'test_lin','lily','cf:name_lily','London_Lily'put 'test_lin','Jack','cf:name_Jack','Beijing_Jack'查看该表:scan 'test_lin'获取一行(行为Jack的)数据get 'test_lin', 'Jack'清除该表(删掉)disable 'test_lin'然后drop 'test_lin'关闭shell:exit停止HbaseBin目录中有相应的脚本:stop-hbase.sh(二)Hbase的存储结构数据在Hbase中是以表的方式存储的,所有的表(由行和列构成)从属于某一个column family。
hbase java使用示例
hbase java使用示例HBase是一个分布式的、高可靠性的、面向列的NoSQL数据库,它在Hadoop生态系统中扮演着重要的角色。
HBase使用Java语言进行开发,提供了丰富的API和工具来简化操作。
本文将介绍HBase Java的使用示例,并详细解释各个示例的代码。
首先,我们需要在Java项目中引入HBase的依赖。
可以使用Maven来管理依赖,将以下代码添加到项目的pom.xml文件中:```<dependencies><!-- HBase dependencies --><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-client</artifactId><version>2.4.7</version></dependency><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-server</artifactId><version>2.4.7</version></dependency><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-common</artifactId><version>2.4.7</version></dependency><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-annotations</artifactId><version>2.4.7</version></dependency><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-protocol</artifactId><version>2.4.7</version></dependency></dependencies>```接下来,我们将介绍HBase Java的一些常用操作示例。
Hadoop大数据开发基础教案-MapReduce入门编程教案
一、MapReduce简介1.1 课程目标理解MapReduce的概念和原理掌握MapReduce编程模型了解MapReduce在Hadoop中的作用1.2 教学内容MapReduce定义MapReduce编程模型(Map、Shuffle、Reduce阶段)MapReduce的优势和局限性Hadoop中的MapReduce运行机制1.3 教学方法理论讲解实例演示学生实操1.4 教学资源PPT课件Hadoop环境MapReduce实例代码1.5 课后作业分析一个大数据问题,尝试设计一个简单的MapReduce解决方案二、Hadoop环境搭建与配置2.1 课程目标学会在本地环境搭建Hadoop掌握Hadoop配置文件的基本配置理解Hadoop文件系统(HDFS)的存储机制2.2 教学内容Hadoop架构简介Hadoop环境搭建步骤Hadoop配置文件介绍(如:core-site.xml、hdfs-site.xml、mapred-site.xml)HDFS命令行操作2.3 教学方法讲解与实操相结合学生分组讨论问答互动2.4 教学资源PPT课件Hadoop安装包Hadoop配置文件模板HDFS命令行操作指南2.5 课后作业搭建本地Hadoop环境,并配置Hadoop文件系统三、MapReduce编程基础3.1 课程目标掌握MapReduce编程的基本概念理解MapReduce的运行原理3.2 教学内容MapReduce编程入口(Java)MapReduce关键组件(Job, Configuration, Reporter等)MapReduce编程实践(WordCount案例)MapReduce运行流程解析3.3 教学方法理论讲解与实操演示代码解析学生实践与讨论3.4 教学资源PPT课件MapReduce编程教程WordCount案例代码编程环境(Eclipse/IntelliJ IDEA)3.5 课后作业完成WordCount案例的编写与运行分析MapReduce运行过程中的各个阶段四、MapReduce高级特性4.1 课程目标掌握MapReduce的高级特性了解MapReduce在复杂数据处理中的应用4.2 教学内容MapReduce高级数据处理(如:排序、分组合并等)MapReduce性能优化策略(如:数据分区、序列化等)复杂场景下的MapReduce应用(如:多层嵌套、自定义分区等)4.3 教学方法理论讲解与实操演示代码解析与优化学生实践与讨论4.4 教学资源PPT课件MapReduce高级特性教程性能优化案例代码编程环境(Eclipse/IntelliJ IDEA)4.5 课后作业优化WordCount程序的性能分析复杂场景下的MapReduce应用案例5.1 课程目标了解MapReduce在大数据处理领域的应用趋势掌握进一步学习MapReduce的途径5.2 教学内容MapReduce编程要点回顾MapReduce在实际项目中的应用案例大数据处理领域的新技术与发展趋势(如:Spark、Flink等)5.3 教学方法知识点梳理与讲解案例分享学生提问与讨论5.4 教学资源PPT课件实际项目案例相关技术资料5.5 课后作业结合实际项目,分析MapReduce的应用场景六、MapReduce编程实战(一)6.1 课程目标掌握MapReduce编程的实战技巧学会分析并解决实际问题理解MapReduce在不同场景下的应用6.2 教学内容实战案例介绍:倒排索引构建MapReduce编程实战:倒排索引的MapReduce实现案例分析:倒排索引在搜索引擎中的应用6.3 教学方法实操演示与讲解学生跟随实操案例分析与讨论6.4 教学资源PPT课件实战案例代码搜索引擎原理资料6.5 课后作业完成倒排索引的MapReduce实现分析MapReduce在搜索引擎中的应用七、MapReduce编程实战(二)7.1 课程目标进一步掌握MapReduce编程的实战技巧学会分析并解决复杂问题了解MapReduce在不同行业的应用7.2 教学内容实战案例介绍:网页爬虫数据处理MapReduce编程实战:网页爬虫数据的抓取与解析案例分析:MapReduce在网络爬虫领域的应用7.3 教学方法实操演示与讲解学生跟随实操案例分析与讨论7.4 教学资源PPT课件实战案例代码网络爬虫原理资料7.5 课后作业完成网页爬虫数据的MapReduce实现分析MapReduce在网络爬虫领域的应用八、MapReduce性能优化8.1 课程目标掌握MapReduce性能优化的方法与技巧学会分析并提升MapReduce程序的性能理解MapReduce性能优化的意义8.2 教学内容性能优化概述:MapReduce性能瓶颈分析优化方法与技巧:数据划分、序列化、并行度等性能优化案例:WordCount的性能提升8.3 教学方法理论讲解与实操演示代码解析与优化学生实践与讨论8.4 教学资源PPT课件性能优化教程性能优化案例代码编程环境(Eclipse/IntelliJ IDEA)8.5 课后作业分析并优化WordCount程序的性能研究其他MapReduce性能优化案例九、MapReduce在大数据处理中的应用9.1 课程目标理解MapReduce在大数据处理中的应用场景学会分析并解决实际问题掌握MapReduce与其他大数据处理技术的比较9.2 教学内容大数据处理场景:日志分析、分布式文件处理等MapReduce应用案例:日志数据分析MapReduce与其他大数据处理技术的比较9.3 教学方法理论讲解与实操演示案例分析与讨论学生提问与互动9.4 教学资源PPT课件大数据处理案例资料MapReduce与其他技术比较资料9.5 课后作业分析MapReduce在日志数据分析中的应用研究MapReduce与其他大数据处理技术的优缺点10.1 课程目标了解MapReduce技术的发展趋势掌握进一步学习MapReduce的途径10.2 教学内容MapReduce编程要点回顾MapReduce技术的发展趋势:YARN、Spark等拓展学习资源与推荐10.3 教学方法知识点梳理与讲解技术发展趋势分享学生提问与讨论10.4 教学资源PPT课件技术发展趋势资料拓展学习资源列表10.5 课后作业制定个人拓展学习计划重点和难点解析:一、MapReduce简介理解MapReduce的概念和原理掌握MapReduce编程模型了解MapReduce在Hadoop中的作用二、Hadoop环境搭建与配置学会在本地环境搭建Hadoop掌握Hadoop配置文件的基本配置理解Hadoop文件系统(HDFS)的存储机制三、MapReduce编程基础掌握MapReduce编程的基本概念学会编写MapReduce应用程序理解MapReduce的运行原理四、MapReduce高级特性掌握MapReduce的高级特性学会优化MapReduce程序性能了解MapReduce在复杂数据处理中的应用六、MapReduce编程实战(一)掌握MapReduce编程的实战技巧学会分析并解决实际问题理解MapReduce在不同场景下的应用七、MapReduce编程实战(二)进一步掌握MapReduce编程的实战技巧学会分析并解决复杂问题了解MapReduce在不同行业的应用八、MapReduce性能优化掌握MapReduce性能优化的方法与技巧学会分析并提升MapReduce程序的性能理解MapReduce性能优化的意义九、MapReduce在大数据处理中的应用理解MapReduce在大数据处理中的应用场景学会分析并解决实际问题掌握MapReduce与其他大数据处理技术的比较了解MapReduce技术的发展趋势掌握进一步学习MapReduce的途径本教案主要涵盖了MapReduce编程的基础知识、Hadoop环境搭建、编程实战、高级特性、性能优化以及应用场景等内容。
HBase原理与实践
6.3 HBase读取流程
6.4深入理解 Coprocessor
7.1 Compaction
基本工作原 理
7.2 Compaction 高级策略
8.1 Region 迁移
8.2 Region 合并
8.3 Region 分裂
8.4 HBase 的负载均衡 应用
9.1 HBase常见故障 分析
9.2 HBase故障恢复 基本原理
目录分析
1.1 HBase前生今世 1.2 HBase数据模型
1.3 HBase体系结构 1.4 HBase系统特性
2.1跳跃表
2.2 LSM树
2.3布隆过滤 器
2.4设计KV存 储引擎 MiniBase
3.1 ZooKeeper简 介
3.2 HBase中 ZooKeeper核心配置
3.3 HDFS简介
集群基准性能 测试
3 12.3 HBase
YCSB
4 12.4 HBase
业务隔离
5
12.5 HBase HBCK
12.7 HBase表设计
12.6 HBase核心参 数配置
12.8 Salted Table
13.1 HBase GC调 优
13.2 G1 GC性能调 优
13.3 HBase操作系 统调优
cell:单元格,由五元组(row, column, timestamp, type, value)组成的结构,其中type表示 Put/Delete这样的操作类型,timestamp代表这个cell的版本。这个结构在数据库中实际是以KV结构存储的,其 中(row, column, timestamp, type)是K,value字段对应KV结构的V。