
Oracle 表三种连接方式使用介绍(sql优化)
1. NESTED LOOP
对于被连接的数据子集较小的情况,nested loop连接是个较好的选择。
nested loop就是扫描一个表,每读到一条记录,就根据索引去另一个表里面查找,没有索引一般就不会是nested loops。
一般在nested loop中,驱动表满足条件结果集不大,被驱动表的连接字段要有索引,这样就走nstedloop。
如果驱动表返回记录太多,就不适合nested loops了。
如果连接字段没有索引,则适合走hash join,因为不需要索引。
可用ordered提示来改变CBO默认的驱动表,可用USE_NL(table_name1 table_name2)提示来强制使用nested loop。
要点如下:
1)对于被连接的数据子集较小的情况,嵌套循环连接是个较好的选择
2)使用USE_NL(table_name1 table_name2)可是强制CBO 执行嵌套循环连接
3)Nested loop一般用在连接的表中有索引,并且索引选择性较好的时候
4)OIN的顺序很重要,驱动表的记录集一定要小,返回结果集的响应时间是最快的。
5)Nested loops 工作方式是从一张表中读取数据,访问另一张表(通常是索引)来做匹配,nested loops适用的场合是当一个关联表比较小的时候,效率会更高。
2. HASH JOIN
hash join是CBO 做大数据集连接时的常用方式。
优化器扫描小表(数据源),利用连接键(也就是根据连接字段计算hash 值)在内存中建立hash表,然后扫描大表,每读到一条记录就探测hash表一次,找出与hash表匹配的行。
当小表可以全部放入内存中,其成本接近全表扫描两个表的成本之和。
如果表很大不能完全放入内存,这时优化器会将它分割成若干不同的分区,不能放入内存的部分就把该分区写入磁盘的临时段,此时要有较大的临时段从而尽量提高I/O 的性能。
临时段中的分区都需要换进内存做hash join。
这时候成本接近于全表扫描小表+分区数*全表扫描大表的代价和。
至于两个表都进行分区,其好处是可以使用parallel query,就是多个进程同时对不同的分区进行join,然后再合并。
但是复杂。
使用hash join时,HASH_AREA_SIZE初始化参数必须足够的大,如果是9i,Oracle建议使用SQL工作区自动管理,设置WORKAREA_SIZE_POLICY 为AUTO,然后调整PGA_AGGREGATE_TARGET即可。
以下条件下hash join可能有优势:
1)两个巨大的表之间的连接。
2)在一个巨大的表和一个小表之间的连接。
要点如下:
1)散列连接是CBO 做大数据集连接时的常用方式.
2)也可以用USE_HASH(table_name1 table_name2)提示来强制使用散列连接
3)Hash join在两个表的数据量差别很大的时候.
4)Hash join的工作方式是将一个表(通常是小一点的那个表)做hash运算并存储到hash列表中,从另一个表中抽取记录,做hash运算,到hash 列表中找到相应的值,做匹配。
可用ordered提示来改变CBO默认的驱动表,可用USE_HASH(table_name1 table_name2)提示来强制使用hash join。
3. SORT MERGE JOIN
a)对连接的每个表做table access full;
b)对table access full的结果进行排序;
c)进行merge join对排序结果进行合并。
sort merge join性能开销几乎都在前两步。
一般是在没有索引的情况下,9i开始已经很少出现,因为其排序成本高,大多为hash join替代。
通常情况下hash join的效果都比sort merge join要好,但是,如果行源已经被排过序,在执行sort merge join时不需要再排序,这时sort merge join的性能会优于hash join。
当全表扫描比“索引范围扫描后再通过rowid进行表访问”更可取的情况下,sort merge join会比nested loops性能更佳。
要点如下:
1)使用USE_MERGE(table_name1 table_name2)来强制使用排序合并连接.
2)Sort Merge join 用在没有索引,并且数据已经排序的情况.
3)连接步骤:将两个表排序,然后将两个表合并。
4)通常情况下,只有在以下情况发生时,才会使用此种JOIN方式:
a)RBO模式
b)不等价关联(>,<,>=,<=,<>)
c)bHASH_JOIN_ENABLED=false
d)数据源已排序
e)Merge Join 是先将关联表的关联列各自做排序,然后从各自的排序表中抽取数据,到另一个排序表中做匹配,因为merge join需要做更多的排序,所以消耗的资源更多。
f) like ,not like
通常来讲,能够使用merge join的地方,hash join都可以发挥更好的性能
可用USE_MERGE(table_name1 table_name2)提示强制使用sort merge join。
更多信息请查看IT技术专栏。
Oracle+表连接方式(内连接-外连接-自连接)+详解
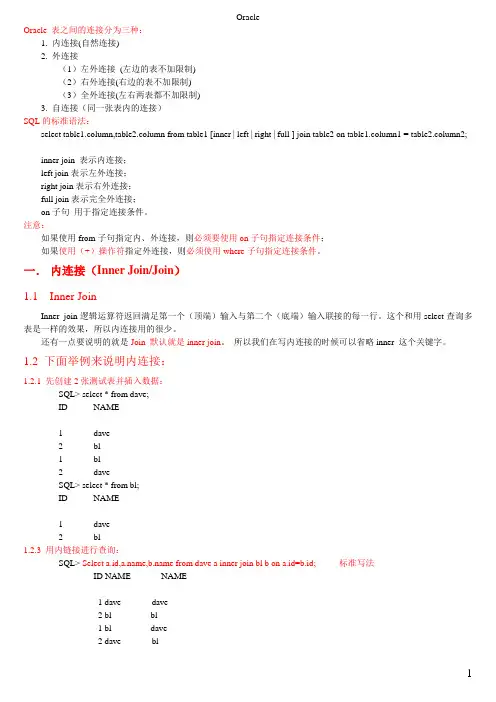
Oracle 表之间的连接分为三种:1. 内连接(自然连接)2. 外连接(1)左外连接(左边的表不加限制)(2)右外连接(右边的表不加限制)(3)全外连接(左右两表都不加限制)3. 自连接(同一张表内的连接)SQL的标准语法:select table1.column,table2.column from table1 [inner | left | right | full ] join table2 on table1.column1 = table2.column2;inner join 表示内连接;left join表示左外连接;right join表示右外连接;full join表示完全外连接;on子句用于指定连接条件。
注意:如果使用from子句指定内、外连接,则必须要使用on子句指定连接条件;如果使用(+)操作符指定外连接,则必须使用where子句指定连接条件。
一.内连接(Inner Join/Join)1.1 Inner JoinInner join逻辑运算符返回满足第一个(顶端)输入与第二个(底端)输入联接的每一行。
这个和用select查询多表是一样的效果,所以内连接用的很少。
还有一点要说明的就是Join 默认就是inner join。
所以我们在写内连接的时候可以省略inner 这个关键字。
1.2 下面举例来说明内连接:1.2.1 先创建2张测试表并插入数据:SQL> select * from dave;ID NAME---------- ----------1 dave2 bl1 bl2 daveSQL> select * from bl;ID NAME---------- ----------1 dave2 bl1.2.3 用内链接进行查询:SQL> Select a.id,, from dave a inner join bl b on a.id=b.id; -- 标准写法ID NAME NAME---------- ---------- ----------1 dave dave2 bl bl1 bl dave2 dave blSQL> Select a.id,, from dave a join bl b on a.id=b.id; -- 这里省略了inner 关键字ID NAME NAME---------- ---------- ----------1 dave dave2 bl bl1 bl dave2 dave blSQL> Select a.id,, from dave a,bl b where a.id=b.id; -- select 多表查询ID NAME NAME---------- ---------- ----------1 dave dave2 bl bl1 bl dave2 dave bl从这三个SQL 的结果我们也可以看出,他们的作用是一样的。
Oracle数据库连接的几种方式
Oracle数据库连接的⼏种⽅式⼀、本地通过JDBC获得Oracle数据库连接通过JDBC获得Oracle数据库连接,有三种⽅式:OCI⽅式、thin⽅式和JdbcOdbc桥⽅式。
OCI⽅式依赖于本地的动态链接库,如果在本地安装了Oracle数据库客户端可以采⽤该⽅式;⽽thin⽅式为纯java的数据库连接⽅式;JdbcOdbc桥⽅式依赖于本地ODBC数据库源的配置,这种⽅式⼀般不太被采⽤。
1、OCI⽅式 先在本地安装Oracle客户端,安装完之后,在安装的路径中可以找到…/jdbc/lib/classes12.zip⽂件,我们在环境变量classpath中设置classes12.zip所在的路径。
然后通过以下的数据库连接类,在本地通过OCI⽅式获得Oracle数据库连接。
/*** 在本地获得数据库连接*/package com.j2ee.db;import java.util.*;import java.sql.*;import javax.sql.*;import java.io.*;import oracle.jdbc.driver.*;import javax.naming.*;/*** 通过OCI⽅式获得Oracle数据库连接*/public class DbConnection{ final static String sDBDriver = "oracle.jdbc.driver.OracleDriver"; final static String sConnStr = "jdbc:oracle:oci8:sr/sr@ora199"; /** * */ public DbConnection() { } /** * 获得Oracle数据库连接 */ public java.sql.Connection connectDbByOci() { java.sql.Connection conn=null; try { Class.forName(sDBDriver); conn = DriverManager.getConnection(sConnStr); } catch (Exception e) { System.out.println("ERROR:"+e.getMessage()); } return conn; }}/*** 在本地获得数据库连接*/package com.j2ee.db;import java.util.*;import java.sql.*;import javax.sql.*;import java.io.*;import oracle.jdbc.driver.*;import javax.naming.*;/*** 通过thin⽅式获得Oracle数据库连接*/public class DbConnection{ private String sConnStr = ""; /** * 缺省构造器 */ public DbConnection() { sConnStr = "jdbc:oracle:thin:@10.1.4.199:1521:ora199"; } /** * @param ip,serviceName */ public DbConnection(String ip,String serviceName) { sConnStr = "jdbc:oracle:thin:@"+ip+":1521:"+serviceName; } /** * 通过thin⽅式获得Oracle数据库的连接. */ public java.sql.Connection connectDbByThin() { java.sql.Connection conn=null; try { Class.forName(sDBDriver); conn = DriverManager.getConnection(sConnStr,"sr","sr"); } catch (Exception e) { System.out.println("ERROR:"+e.getMessage()); } return conn; } /** * 通过thin⽅式获得Oracle数据库的连接. * @param userId,password */ public java.sql.Connection connectByJdbc(String userId,String password) { java.sql.Connection conn=null; try { Class.forName(sDBDriver); conn = DriverManager.getConnection(sConnStr,userId,password); } catch (Exception e) { System.out.println("ERROR:"+e.getMessage()); } return conn; }} 这种⽅式运⽤起来⽐较灵活,简单,具有较强的移植性和适⽤性。
Oracle SQL语句优化技术分析
O a e S L 句的性 能问题 常常是 由于 rl Q 语 c 在索引设计和查询设计方面存在各种缺陷引起 的。 Q 优化的实质就是在结果正确的前提下 , SL 充份利用索引 , 减少表扫描的 I / O次数 , 尽量避 免表搜索的发生 。 其实 S L Q 的性能优 化是一个 复杂的过程 ,以上这些只是在应用层次 的一种 体现 , 深入研究还会涉及数据库层 的资源配置 、 网络层的流量控制 以及操作系统层 的总体设计 如 等等方面 , 已经超 出本文所要讨论 的范 围, 这些 S EC EL T FROM US ER LOG WHER 因此不在本文赘述 了。 E 总之 Oal S L语句 的 r e Q c USE N R AME ei ( L C U E _ A 不断总结 , 才 xs t S E T S R N ME 优化需要我们在生产 中不断学习 , E FROM T F W HE TY C D =05 ' S AF E R CI 能更为得心应手 的应用到工作中去。 O E ' 1 4 3 O N操作符 . N TI 2 此操作是 强列不推荐使用 的 , 因为它不能
的 ,因为索引是不索引空值的。使用 I N L SU 或 I O U ,r l会停止使用 索引而执 SN TN L Oa e c 行 全表扫描。 以考虑在设计表时 , 引列设 可 对索 置为 N T N L 。这样就可以用其他操作来取 O U L 代 判断 N L 的操作。 UL
_
b .同一功能 同一性能 不同写法 S QL的影 响。 如一个 S L在 A程序员写的为 slc S Q eetU— e a ,s d f m s fB程序员写 的为 s—  ̄nme e r t u o a e le s r n meu e i f m zj s ( e t u e a . s r d r h .a 带表所有 o st f 者的前缀 )c程序员写的为 Sl tu rn n, e c s_s e e e z u ser i f m Z J . A F ( 写表名 )D程序 d r HS T F 大 o S 员 写 的 为 Slc srnme sri f m e et e_a , e_d r u u o z SS A F 中间多 了空格 )以上 四个 S L在 Ⅲ . F( T Q OAL R C E分析整理之后产生的结果及执行的时
oracle之使用OracleDeveloper对SQL进行简单调优(二)
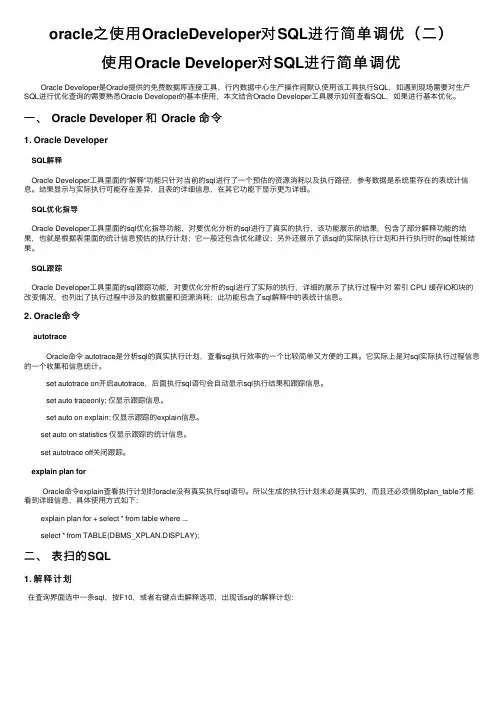
oracle 之使⽤OracleDeveloper 对SQL 进⾏简单调优(⼆)使⽤Oracle Developer 对SQL 进⾏简单进⾏简单调优调优Oracle Developer 是Oracle 提供的免费数据库连接⼯具,⾏内数据中⼼⽣产操作间默认使⽤该⼯具执⾏SQL ,如遇到现场需要对⽣产SQL 进⾏优化查询的需要熟悉Oracle Developer 的基本使⽤,本⽂结合Oracle Developer ⼯具展⽰如何查看SQL ,如果进⾏基本优化。
⼀、 Oracle Developer 和 Oracle 命令1. Oracle DeveloperSQL 解释Oracle Developer ⼯具⾥⾯的“解释”功能只针对当前的sql 进⾏了⼀个预估的资源消耗以及执⾏路径,参考数据是系统⾥存在的表统计信息。
结果显⽰与实际执⾏可能存在差异,且表的详细信息,在其它功能下显⽰更为详细。
SQL 优化指导Oracle Developer ⼯具⾥⾯的sql 优化指导功能,对要优化分析的sql 进⾏了真实的执⾏,该功能展⽰的结果,包含了部分解释功能的结果,也就是根据表⾥⾯的统计信息预估的执⾏计划;它⼀般还包含优化建议;另外还展⽰了该sql 的实际执⾏计划和并⾏执⾏时的sql 性能结果。
SQL 跟踪Oracle Developer ⼯具⾥⾯的sql 跟踪功能,对要优化分析的sql 进⾏了实际的执⾏,详细的展⽰了执⾏过程中对 索引 CPU 缓存IO 和块的改变情况,也列出了执⾏过程中涉及的数据量和资源消耗;此功能包含了sql 解释中的表统计信息。
2. Oracle 命令autotraceOracle 命令 autotrace 是分析sql 的真实执⾏计划,查看sql 执⾏效率的⼀个⽐较简单⼜⽅便的⼯具。
它实际上是对sql 实际执⾏过程信息的⼀个收集和信息统计。
set autotrace on 开启autotrace ,后⾯执⾏sql 语句会⾃动显⽰sql 执⾏结果和跟踪信息。
oracle join用法

oracle join用法
oracle join 是一类用于从多个表中抓取数据的语句,其用于连接两个或更多表,以
返回表之间共同存在的数据记录。
Oracle JOIN 可以用几种不同的类型,它们正好对应于 SQL 中提供的主要连接类型,如内连接、外连接、自然连接和交叉连接。
内连接
一种常见的 Oracle Join 类型是内连接。
Oracle 内连接 JOIN 使用两个或多个表中
的公共字段,在都有的情况下返回记录。
SQL 语句来完成 Oracle 内连接如下:
SELECT table1.column1, table1.column2, table2.column1
FROM table1
INNER JOIN table2
ON mon_field = mon_field;
自然连接
自然连接是另一种常见的 Oracle Join 类型,它基于双表之间存在的某种关系,而
不是显式地指定任何一列来连接它们。
假设 table1 表中包含一个列 employee_id,表 table2 中也包含同一个列
employee_id,因此它们之间存在自然关系,我们可以使用下面的 SQL 语句完成自然连接:
交叉连接
最后,我们还可以使用交叉连接来完成 Oracle Join。
Oracle 交叉连接用于将两表
中的每个行与另一表中的每个行进行连接,从而返回两个表中所有可能的组合。
Oracle培训之:sql优化--

13
在SQLPLUS 配置AUTOTRACE
AUTOTRACE 参数
SET AUTOTRACE OFF SET AUTOTRACE ON EXPLAIN SET AUTOTRACE ON STATISTICS SET AUTOTRACE ON SET AUTOTRACE TRACEONLY
解
释
不能获得AUTOTRACE报告. 这是默认的. 仅仅显示优化器执行计划的AUTOTRACE 报告 仅仅显示SQL语句执行的统计结果的 AUTOTRACE报告 包括上面两项内容的AUTOTRACE报告 与SET AUTOTRACE ON类似,所有的统计 和数据都在,但不可以打印
23
第五章:SQL重编译问题
SQL共享原理 SQL共享的三个条件 PROC程序的SQL共享 PROC程序中以下类型的语句不需进行变量 绑定 • PROC程序的CLIENT参数 • 存储过程的SQL共享 • SQL共享的数据库参数的利弊
24
• • • •
SQL共享原理
• ORACLE将执行过的SQL语句存放在内存 的共享池(shared buffer pool)中,可以被所 有的数据库用户共享 • 当你执行一个SQL语句(有时被称为一个游 标)时,如果它和之前的执行过的语句完全相 同, ORACLE就能很快获得已经被解析的语 句以及最好的 执行路径. 这个功能大大地提 高了SQL的执行性能并节省了内存的使用
查找原因的步骤(四)
• 是否为表和相关的索引搜集足够的统计数 据。对数据经常有增、删、改的表最好定 期对表和索引进行分析,可用SQL语句 “analyze table xxxx compute statistics for all indexes;”。ORACLE掌握了充分反映实 际的统计数据,才有可能做出正确的选择 • 索引列的选择性不高 (字段值重复率高)
oracle sql查询条件拼接
oracle sql查询条件拼接使用Oracle SQL查询条件拼接,可以更灵活地获取所需的数据集。
本文将探讨如何使用Oracle SQL查询条件拼接来实现不同的查询需求。
一、基本查询在Oracle SQL中,我们可以使用SELECT语句来进行基本的数据查询。
通过SELECT关键字以及FROM、WHERE等子句,我们可以指定要查询的表、条件以及需要返回的字段。
例如,我们有一个名为"employees"的表,其中包含了员工的信息,如姓名、性别、年龄等。
我们可以使用以下语句来查询所有员工的信息:SELECT * FROM employees;二、使用WHERE子句进行条件查询如果我们只想查询满足特定条件的员工信息,可以使用WHERE子句来添加查询条件。
条件可以是等于、不等于、大于、小于等关系。
例如,我们想查询所有性别为女性的员工信息,可以使用以下语句:SELECT * FROM employees WHERE gender = '女';三、使用AND和OR进行条件组合在实际的查询中,我们可能需要同时满足多个条件或者满足其中任意一个条件。
此时,可以使用AND和OR进行条件组合。
例如,我们想查询年龄大于30岁并且性别为男性的员工信息,可以使用以下语句:SELECT * FROM employees WHERE age > 30 AND gender = '男';如果我们想查询年龄大于30岁或者性别为女性的员工信息,可以使用以下语句:SELECT * FROM employees WHERE age > 30 OR gender = '女';四、使用LIKE进行模糊查询有时候,我们需要查询满足特定模式的数据,这时可以使用LIKE关键字进行模糊查询。
LIKE支持使用通配符%和_来匹配任意字符或者单个字符。
例如,我们想查询名字以"张"开头的员工信息,可以使用以下语句:SELECT * FROM employees WHERE name LIKE '张%';如果我们想查询名字中包含"三"字的员工信息,可以使用以下语句:SELECT * FROM employees WHERE name LIKE '%三%';五、使用IN进行多值查询有时候,我们需要查询某个字段的值在一组指定的值中的数据,可以使用IN关键字进行多值查询。
oracle三种表连接方式
oracle三种表连接⽅式
1、排序合并连接(Sort Merge Join)
排序合并连接的执⾏过程如下所⽰:
* 将每个⾏源的⾏按连接谓词列排序
* 然后合并两个已排序的⾏源,并返回⽣成的⾏源
例如:
select * from employees d,departments t where d.department_id=t.department_id;
访问机制如下:访问departments表并排序department_id列,访问employees表并排序department_id列,然后依次交替⽐较、归并。
注意:排序合并连接⼀般⽤在两张表中没有索引,并且连接列已经排好序的情况下。
2、嵌套循环连接(Nested Loops Join)
* 两个表中的⼀个被定义为“外部表”(或“驱动表”)
* 另⼀个表被称为“内部表”
* 将针对外部表中的每⼀⾏检索内部表中所有匹配的⾏
注意:join的顺序很重要,⼀般选择⼩表作为“驱动表”,⼤表作为“内部表”。
如两个表,⼀个100⾏,⼀个10000⾏,理想的连接⽅式是:100⾏的⼩表作为“驱动表”,10000⾏的⼤表作为“内部表”,⽤⼩表中的每条记录去匹配⼤表中的记录。
如果两张表的连接词在⼤表中是索引列,则是最完美的。
3、哈希连接(Hash Join)
* 优化器对⼩表利⽤连接键在内存中建⽴hash表
* 扫描⼤表,每得到⼀条记录,就来hash表中“探测”⼀次,找出与hash表匹配的⾏
注意:Hash Join 是CBO做⼤数据集连接时的常⽤⽅式。
Oracle表连接操作——Merge Sort Join(合并排序连接)
Oracle表连接操作——Merge Sort Join(合并排序连接)关系型数据库并不是最早出现的数据库表现形式,之前还存在层次、网状数据库结构。
随着关系型数据库的出现,以数据表的方式进行信息留存的方案迅速发展起来。
关系型数据库的重要元素包括数据表和表连接,借助各种类型的表连接,可以将平铺直叙的信息加以组装拼接。
1、Merge Sort Join原理机制Nest Loop Join嵌套循环是一种比较古老的连接匹配方式,特点是通过两层的循环结构,将符合条件的数据行整理出来。
嵌套循环的最大缺陷之一,就是伴随着驱动表被驱动表之间的选择,以及大量随机读现象。
Merge Sort Join连接的优势就是可以一定程度上减少随机读的情况。
合并排序连接的最大特征是在一次扫描的同时,就判断连接。
不会像Nest Loop Join那样频繁的进行数据读取。
使用这种方式的前提,就是连接的两个数据集合必须按照连接列的顺序进行排序。
具体操作流程如下:✓∙∙∙∙∙∙∙对Merge Sort Join连接而言,不存在驱动表和被驱动表的问题。
两边的数据集合没有顺序区别,都要进行排序操作;✓∙∙∙∙∙∙∙根据Oracle排序规则和方法,按照连接列的顺序对两个数据集合进行排序;✓∙∙∙∙∙∙∙依次对两边的数据集合进行扫描,由于已经是排序过得结果,可以直接确定连接条件是否匹配;✓∙∙∙∙∙∙∙确定进行连接的两端数据行,再依据筛选列的要求获取数据;下面是一个进行Merge Sort Join的执行计划://使用Merge Sort Join方法SQL>select /*+use_merge(segs,tabs)*/* from segs, tabs where segs.segment_name=tabs.table_name;已选择865行。
执行计划----------------------------------------------------------Plan hash value: 3475644097------------------------------------------------------------------------------------| Id | Operation | Name | Rows | Bytes |TempSpc| Cost (%CPU)| Time |------------------------------------------------------------------------------------| 0 | SELECT STATEMENT | | 990 | 354K| | 144 (2)| 00:00:02 || 1 | MERGE JOIN | | 990 | 354K| | 144 (2)| 00:00:02 || 2 | SORT JOIN | | 968 | 229K| 712K| 65 (2)| 00:00:01 || 3 | TABLE ACCESS FULL| TABS | 968 | 229K| | 11 (0)| 00:00:01 ||* 4 | SORT JOIN | | 2267 | 274K| 824K| 79 (2)| 00:00:01 || 5 | TABLE ACCESS FULL| SEGS | 2267 | 274K| | 13 (0)| 00:00:01 |------------------------------------------------------------------------------------Predicate Information (identified by operation id):---------------------------------------------------4 - access("SEGS"."SEGMENT_NAME"="TABS"."TABLE_NAME")filter("SEGS"."SEGMENT_NAME"="TABS"."TABLE_NAME")统计信息----------------------------------------------------------2010 recursive calls0 db block gets378 consistent gets0 physical reads0 redo size72346 bytes sent via SQL*Net to client1003 bytes received via SQL*Net from client59 SQL*Net roundtrips to/from client10 sorts (memory)0 sorts (disk)865 rows processed//使用嵌套循环;SQL>select /*+use_nl(segs,tabs)*/* from segs, tabs where segs.segment_name=tabs.table_name;已选择865行。
SQL各种连接查询详解(左连接、右连接..)
SQL各种连接查询详解(左连接、右连接..)一、交叉连接(cross join)交叉连接(cross join):有两种,显式的和隐式的,不带on子句,返回的是两表的乘积,也叫笛卡尔积。
例如:下面的语句1和语句2的结果是相同的。
语句1:隐式的交叉连接,没有cross join。
select o.id, o.order_number, c.id, from orders o , customers c where o.id=1;语句2:显式的交叉连接,使用cross join。
select o.id,o.order_number,c.id, from orderso cross join customers c where o.id=1;语句1和语句2的结果是相同的,查询结果如下:二、内连接(inner join)内连接(inner join):有两种,显式的和隐式的,返回连接表中符合连接条件和查询条件的数据行。
(所谓的链接表就是数据库在做查询形成的中间表)。
例如:下面的语句3和语句4的结果是相同的。
语句3:隐式的内连接,没有inner join,形成的中间表为两个表的笛卡尔积。
select o.id,o.order_number,c.id, from customers c, orders o where c.id=o.customer_id;语句4:显示的内连接,一般称为内连接,有inner join,形成的中间表为两个表经过on条件过滤后的笛卡尔积。
select o.id,o.order_number,c.id, from customersc inner join orders o on c.id=o.customer_id;语句3和语句4的查询结果:三、外连接(outer join):外连不但返回符合连接和查询条件的数据行,还返回不符合条件的一些行。
外连接分三类:左外连接(left outer join)、右外连接(right outer join)和全外连接(full outer join)。