
基于数据挖掘的关联规则挖掘算法及其应用
基于数据挖掘的关联规则挖掘算法及其应用关联规则挖掘算法及其应用
数据挖掘技术是指对大量的数据进行分析,探索数据之间的关系,从而发现有用的信息的过程,通常由数据预处理、数据挖掘、数据后处理三个步骤组成。
其目的是使数据转化为有用的知识,
为决策提供支持。
关联规则挖掘算法是数据挖掘领域中的一种重要技术,应用广泛。
关联规则挖掘算法的基本思想是通过分析数据中的相关项集,挖掘出不同项集之间的关联规则,从而发现相关性或相关规律。
例如,在超市购物时,如果顾客购买了牛奶和面包,可以推断出
顾客还需要购买黄油,这便是关联规则挖掘的应用之一。
关联规则挖掘算法的基本原理
关联规则挖掘算法主要有Apriori算法、FP-Growth算法、ECLAT算法等。
Apriori算法是最为经典的关联规则挖掘算法之一。
该算法基于
频繁项集的概念,即频繁出现的项集表示高频的模式。
其基本思
想是通过寻找频繁项集来发现高度关联的集合,然后将它们转换
成关联规则。
算法需要多次扫描数据集,通过迭代计算候选项集
的支持度,将支持度超过阈值的项集作为频繁项集。
FP-Growth算法是近年来发展的一种高效的挖掘算法。
它将数据集压缩成一棵频繁模式树,以减少数据集的扫描次数。
该算法使用一种“不生成候选项集”的方法,即直接利用频繁项集在树中的结构,而不产生候选项集。
在以此方式从数据集中提取出频繁项集后,可以应用关联规则生成的方法发掘规则。
ECLAT算法是另一种常见的关联规则挖掘算法,也是一种基于频繁项集的算法。
该算法使用一种垂直数据存储的技术来管理数据集。
在这种存储方式下,每个项集用一个数组表示,数组中的每个元素代表一个事务,以便在寻找频繁项集时对每个项进行计数,以发现其支持度。
应用实例
关联规则挖掘算法广泛应用于各行各业,如市场营销、网站推荐、医疗决策等领域。
下面介绍一些实际应用的例子。
在市场营销方面,关联规则挖掘算法可以用于预测顾客可能购买的商品,为企业定制个性化的广告宣传方案。
例如,使用关联规则挖掘算法来分析一家超市的销售数据,可以发现很多顾客会同时购买牛奶、面包和黄油,因此超市可在周末时将它们摆在一起,以吸引更多的购买者。
在网站推荐方面,关联规则挖掘算法可以分析用户的浏览记录和点击行为,为用户推荐与其兴趣相关的商品或服务。
例如,电
商网站可以根据顾客之前浏览过的商品,预测其购买行为,并推荐相应的产品给买家。
在医疗决策方面,关联规则挖掘算法可以应用于医学领域,根据病人病历中的结构化和非结构化数据,挖掘疾病的相关规律及其治疗方案,为临床医生提供辅助决策的依据。
例如,在医学领域中,如果一个病人有头痛、发烧、咳嗽等症状,关联规则挖掘算法可以预测该病人是否患有感冒或其他相关疾病,并为医生提供治疗方案。
总结
关联规则挖掘算法的应用范围广泛,可以帮助机构、企业、个人发现数据之间的关系规律,为之后的决策提供支持。
但是,在进行关联规则挖掘时,需要注意数据的采集、处理和分析方法,避免不当操作导致信息的失真。
同时,隐私保护在关联规则挖掘中也需要重视。
相信在不断技术的改进和进步下,关联规则挖掘算法也会越来越好地服务于我们的日常生活和工作中。
关联规则在数据挖掘中的应用

-
1
2
目录
3
CONTENTS
4
5
引言 关联规则的定义 关联规则的挖掘过程 关联规则在数据挖掘中的应用
结论
1
引言
引言
关联规则是数据挖掘中的一种重要技术,主要 用于发现数据集中变量之间的有趣关系,如购
物篮分析中经常一起购买的商品组合
关联规则可以揭示数据集中变量之间的潜在关 联,从而帮助企业更好地理解客户需求、优化
5
结论
结论
关联规则在数据挖掘中 具有广泛的应用前景, 可以帮助企业更好地理 解客户需求、优化产品 组合、提高销售策略等
然而,关联规则挖掘也 存在一些挑战,如处理 大规模数据、处理高维 数据等
未来,随着技术的不断 发展,相信关联规则挖 掘将会在更多领域发挥 重要作用
-
谢谢观看
XXXXX
XXXXXX XXXXX
3
关联规则的挖掘过 程
关联规则的挖掘过程
关联规则的挖掘过程 通常包括以下步骤
关联规则的挖掘过程
数据准备
首先需要对数据进行预处理,包括数据清洗、数据转换等, 以便为后续的关联规则挖掘提供合适的数据格式和结构
关联规则生成
基于频繁项集,可以生成关联规则。这些规则可以表示为“如 果购买商品A,则购买商品B”的形式
商品或服务
03
金融欺诈检测
在金融领域,关联规 则可以用于检测欺诈 行为。通过对客户的 交易记录进行分析, 可以发现异常的交易 组合或模式,从而及
时发现欺诈行为
04
医疗诊断
在医疗领域,关联规 则可以用于辅助诊断。 通过对患者的症状和 病史进行分析,可以 发现疾病之间的关联 关系,从而为医生提
数据库中的关联规则挖掘与应用

数据库中的关联规则挖掘与应用随着数据量的不断增加和信息化的发展,数据库技术在各行各业中得到了广泛应用。
为了从海量数据中挖掘出有用的信息,关联规则挖掘成为一种重要的数据挖掘技术。
本文将就数据库中关联规则挖掘的概念、方法和应用进行详细介绍。
一、关联规则挖掘的概念关联规则挖掘是指在大规模数据库中,根据数据项之间的相关性挖掘出频繁项集,并根据频繁项集产生关联规则的过程。
关联规则包含两个部分:前项和后项,表示两个数据项之间的条件和结果。
例如,一个超市的购物数据集包含了很多交易记录,每个交易记录由一组购买的商品集合组成。
通过关联规则挖掘,可以找到一些有意义的规则,比如“如果购买了牛奶,那么很可能也会购买面包”。
二、关联规则挖掘的方法在关联规则挖掘中,频繁项集和支持度是两个关键概念。
频繁项集是指在数据库中经常出现的数据项的集合,而支持度则表示一个频繁项集在数据库中出现的频率。
常见的关联规则挖掘算法有Apriori算法和FP-Growth算法。
1. Apriori算法Apriori算法是一种迭代算法,它通过扫描数据库多次来获得频繁项集。
首先,算法会生成单个项的频繁项集(频繁1-项集),然后通过生成候选项集和计算支持度逐步筛选,最后获得频繁k-项集。
Apriori算法的主要优势是易于理解和实现,但由于需要多次扫描数据库,对于大规模数据集来说,其运行效率较低。
2. FP-Growth算法FP-Growth算法是一种基于前缀树数据结构的关联规则挖掘算法。
它通过构建一个频繁模式树来寻找频繁项集,避免了多次扫描数据库。
FP-Growth算法通过两个步骤来构建频繁模式树:首先,利用一次扫描数据库生成频繁1-项集;然后,根据频繁1-项集构建条件模式基,再递归地构建频繁模式树。
相比于Apriori算法,FP-Growth算法具有较高的运行效率和内存利用率。
三、关联规则挖掘的应用关联规则挖掘在许多领域都有着广泛应用,以下列举几个具体的应用场景。
数据挖掘中关联规则算法及其应用

( ∞ffC m ue  ̄/ c n &b o p t o r e ead a
r 昭 . ̄hnluzt o 鲢 Tca/ y A d . 魄 A a a / e f . u e o g ,a wn h o
r 14 0 , ) 崎 10 2 c 如口
Ab ta t T ep p rit d c d teascain rlsca sc l loi ms t rt,h np t o w r sr c : h a e nr u e h so it ue lsia grt s te u r ad o o a h af i f : me i rvn eh oo isa da piain i e ea ed . 8 o mpo ig tc n lge n p l t ns v rlf ls c o i
医疗保 险、 金融业 、 司法部 门等, 因此对它的研究有着极其重要韵意义.
1 关联 规 则 理 论
11 关联 规则 的定 义 为 : .
定义 1 设 ,= lI :…. f f i, i 是由 m个不同的属性 ( , 谓词或项 目) 组成的集合( 习惯上我们还称 I 为项集 , 但其中的元素与 R A r a等人的定义有所不同, .g wl a 这里项集中的元素可能是谓词或项 目, R 而 . A aa 等人定义的项集仅包含项 目) 给定一个 数据库 D, 中的每一个记录 T是 I  ̄ wl . 其 中一组属性的集 合 , £, 有一个唯一的标识符 T 若集合 即 , I D. , 且 , 则记录 包含集合 . 一条关联规则
度优先算法 , 通过对数据库 D的多趟扫描来发现所有的频繁项 目集 , 在每一趟扫描 中只考虑具有同一
在第一趟扫描中 ,pii A r r算法计算数据库 D中所有单个项 目的支持度 , o 生成所有长度为 1 的频繁项目
基于关联规则的数据挖掘算法及其应用的开题报告
基于关联规则的数据挖掘算法及其应用的开题报告一、选题背景和意义:随着互联网时代的到来,数据量不断增长,信息爆炸的问题愈发突出。
为了从数据中挖掘出有用的知识,需要用到数据挖掘技术。
关联规则挖掘算法是数据挖掘中一项重要的技术之一,主要用于发现数据集中的关联项和频繁项集,以支持决策和预测。
随着数据量和数据类型的不断增加,关联规则算法也面临着越来越大的挑战。
本文选取基于关联规则的数据挖掘算法及其应用作为研究对象,旨在深入了解关联规则挖掘算法的原理和特点,以及相关的应用场景。
该研究将有助于提高数据挖掘技术在实际应用中的效率和准确性,为企业和机构提供更准确的决策支持。
二、研究内容和方法:1. 研究背景和意义:重点介绍数据挖掘技术在互联网时代的应用和发展趋势,分析关联规则挖掘算法在数据挖掘中的重要性和应用场景。
2. 关联规则挖掘算法:介绍Apriori算法和FP-Growth算法等关联规则挖掘算法的原理和特点,并比较各算法之间的优缺点。
3. 应用案例分析:以电子商务领域为例,通过实际的数据挖掘案例,探讨关联规则挖掘算法的应用方法和效果,并评估算法的准确性和效率。
4. 研究总结和展望:总结关联规则挖掘算法的特点和应用价值,探讨其未来在数据挖掘领域的发展方向和趋势。
三、预期成果:本研究的预期成果为:1. 对关联规则挖掘算法的原理和特点进行深入探讨,比较各算法之间的优缺点。
2. 经过应用案例分析,评估关联规则挖掘算法的准确性和效率。
3. 提供对于数据挖掘在实际应用中的一定指导意义和支持。
四、研究计划:1. 第一周:进行文献查阅,确定研究方向和内容。
2. 第二周:深入研究关联规则挖掘算法的原理和特点。
3. 第三周:比较各种关联规则挖掘算法,选择适合的算法。
4. 第四周:通过实际应用案例,评估算法的准确性和效率。
5. 第五周:总结研究成果,撰写开题报告初稿。
6. 第六周:进行报告修改和完善,最终完成开题报告。
五、研究难点和风险:本研究的难点主要在于:1. 关联规则挖掘算法的理解和应用需要较强的数学基础和编程能力。
医疗数据分析中的关联规则挖掘算法研究与应用
医疗数据分析中的关联规则挖掘算法研究与应用概述随着医疗系统的数字化和数据量的急剧增加,医疗数据分析成为了提高医疗质量和效率的关键。
关联规则挖掘算法作为数据挖掘领域的重要技术之一,被广泛应用于医疗数据分析中,用于发现医疗数据中的潜在关联规律。
本文将对医疗数据分析中的关联规则挖掘算法进行详细研究,并探讨其应用领域。
一、关联规则挖掘算法概述关联规则挖掘算法是一种用于发现数据中的关联规律的方法。
它通过分析数据集中的项集之间的频繁出现模式来挖掘关联规则。
关联规则通常形如“A->B”,表示项集A的出现与项集B的出现之间存在某种关系。
关联规则挖掘算法主要包括Apriori算法、FP-Growth算法等。
1. Apriori算法Apriori算法是最经典和常用的关联规则挖掘算法之一。
它通过迭代计算频繁项集来挖掘数据中的关联规则。
Apriori算法的基本思想是:首先生成数据集中的所有频繁1-项集,然后通过连接这些频繁1-项集来生成频繁2-项集,再通过连接频繁2-项集来生成频繁3-项集,直到得到所有频繁项集为止。
最后,通过检测置信度来生成关联规则。
2. FP-Growth算法FP-Growth算法是一种基于频繁模式树的关联规则挖掘算法。
相较于Apriori算法,FP-Growth算法能够更高效地挖掘频繁项集。
FP-Growth算法通过构建一棵频繁模式树来快速发现频繁项集,然后通过后缀路径来生成关联规则。
二、医疗数据分析中的关联规则挖掘算法研究关联规则挖掘算法在医疗数据分析中起到了重要的作用。
通过挖掘医疗数据中的关联规律,可以帮助医疗行业从海量数据中提取出有价值的信息,用于医疗决策、疾病预测、药物研发等方面。
以下是几个医疗数据分析中关联规则挖掘算法的研究方向:1. 医疗数据预处理在进行关联规则挖掘之前,需要对医疗数据进行预处理。
医疗数据预处理包括数据清洗、数据集成和数据变换等步骤。
这些步骤的目的是消除数据中的噪声和冗余,以提高关联规则挖掘算法的准确性和效率。
数据挖掘原理 算法及应用第3章 关联规则挖掘
第3章
关联规则挖掘
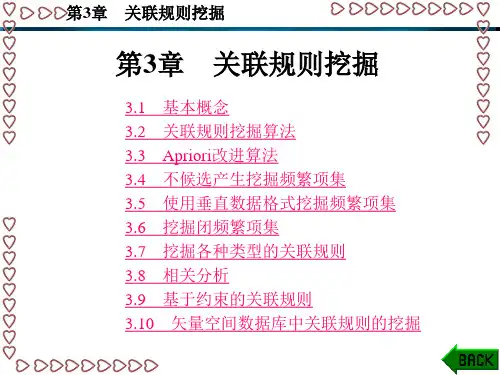
图3-1 搜索候选项集和频繁项集过iori算法和它的相关过程的伪代码。
算法3.1
Apriori (发现频繁项目集)
输入: 数据集D、最小支持数minsup_count。 输出: 频繁项目集L。 (1) L1={large 1-itemsets}; //所有支持数不小于 minsup_count 的1
第3章
关联规则挖掘
(1) 发现频繁项目集:通过用户给定的最小支持度, 寻找所有频繁项目集,即满足支持度Support不小于 Minsupport的所有项目子集。发现所有的频繁项目集是形 成关联规则的基础。 (2) 生成关联规则:通过用户给定的最小可信度, 在 每个最大频繁项目集中,寻找置信度不小于Minconfidence 的关联规则。
l2 是可连接的,即l1[1]=l2[1]∧l1[2]=l2[2]
∧…∧l1[k-1]<l2[k-1]。条件l1[k-1]<l2[k-1]可以
保证不产生重复,而按照L1,L2, …,Lk-1,Lk, …,Ln
次序寻找频繁项集可以避免对事务数据库中不可能发生的
项集所进行的搜索和统计的工作。连接l1、l2的结果项集是l1 [1]、l1[2]、 …、 l1[k-1]、l2[k-1]。
第3章
关联规则挖掘
第 3章
3.1 3.2 3.3 3.4 3.5 3.6 3.7 3.8 3.9 3.10
关联规则挖掘
基本概念 关联规则挖掘算法 Apriori改进算法 不候选产生挖掘频繁项集 使用垂直数据格式挖掘频繁项集 挖掘闭频繁项集 挖掘各种类型的关联规则 相关分析 基于约束的关联规则 矢量空间数据库中关联规则的挖掘
第3章
关联规则挖掘
基于关联规则数据挖掘Apriori算法的研究与应用
第2 卷 l
21 0 1年 6月
第 6期
计 算 机 技 术 与 发 展
COMPlT J ER ECHNOLOGY I AND DEVEL OPMENT
V 12 No 6 0. l .
J n 2 1 Βιβλιοθήκη ue 0 1基 于关 联 规 则 数 据挖 掘 A roi 法 p ir 算 的研 究 与应 用
GUO o,ZHANG i ua Ta Da -y n
( ol f o u rN nigUnv f ot adT l o mu iao s N nig20 0 , hn ) C i mp t 。 aj i.o s n e c m n t n , aj 10 3 C ia .o C e n P s e ci n
郭 涛, 张代远
( 南京 邮 电大 学 计 算机 学 院 , 江苏 南京 200 ) 10 3
摘 要: 目前在 我 国 , 据挖 掘技术 的研 究与 应用 并不 是 很广 泛 。 大多 数 数据 库 只 能实 现 数 据 的 录入 、 询 、 对数 查 统计 等 较
低层 次 的功 能 , 无法发 现数 据 中存在 的各种 有 用的信 息 。基 于关联 规则 的数据 挖 掘 主要用 于发 现数 据集 中项 目之 间 的联 系 。以超市 购物 为例 , 目的在于 找 出顾 客所 购买 商 品之 间的 内在关联 。利用 A r r算法 的先验 原 理 , 少 A f f算 法在 pi i o 减 po ii
关联规则挖掘方法的研究及应用
关联规则挖掘方法的研究及应用一、本文概述本文旨在深入研究关联规则挖掘方法,探索其在不同领域的应用价值。
关联规则挖掘是一种数据挖掘技术,旨在从大型数据集中发现项之间的有趣关系,如购物篮分析中经常一起购买的商品组合。
本文首先将对关联规则挖掘的基本概念、原理和方法进行详细的介绍和梳理,为后续的应用研究提供理论基础。
接着,本文将重点探讨关联规则挖掘在多个领域的应用。
这些领域包括但不限于零售业、电子商务、医疗保健、社交网络分析等。
在这些领域中,关联规则挖掘可以帮助我们理解客户行为、优化产品组合、预测疾病趋势、分析社交网络结构等,具有重要的实际应用价值。
本文还将对关联规则挖掘方法的优化和改进进行探讨。
尽管关联规则挖掘已经取得了一些重要的成果,但在处理大规模、高维度、复杂数据集时,仍然存在一些挑战。
因此,我们需要不断探索新的算法和技术,以提高关联规则挖掘的效率和准确性。
本文将总结关联规则挖掘方法的研究现状和未来发展趋势,为相关领域的研究和实践提供参考和借鉴。
通过本文的研究,我们希望能够为关联规则挖掘的应用提供更多的思路和方法,推动其在更多领域发挥更大的作用。
二、关联规则挖掘方法理论基础关联规则挖掘是数据挖掘领域中的一种重要技术,它主要用于发现数据集中项之间的有趣关系。
这些关系通常表现为形如“如果购买了A,则很可能也会购买B”的关联规则。
关联规则挖掘方法理论基础主要涉及到频繁项集和关联规则的产生,以及它们之间的度量指标——支持度和置信度。
我们需要明确什么是频繁项集。
在给定的事务数据库中,如果某个项集出现的频率高于用户设定的最小支持度阈值,那么这个项集就被称为频繁项集。
最小支持度阈值是用户根据实际需求设定的一个参数,它决定了项集被认为是“频繁”的最低标准。
在确定了频繁项集之后,我们可以进一步生成关联规则。
关联规则是一种形如“A -> B”的蕴含关系,其中A和B都是项集。
一个关联规则是否成立,取决于它的支持度和置信度是否满足用户设定的阈值。
关联规则的四种算法
关联规则的四种算法关联规则是数据挖掘领域中的一个基础方法,其主要用于寻找一个数据集中不同属性之间的关系和规律。
在实际的应用场景中,关联规则算法被广泛应用于市场营销、电商推荐、客户分析等领域。
本文将介绍关联规则的四种经典算法:Apriori算法、FP-growth算法、ECLAT算法和SPMF算法,并分别从算法原理、实现过程、优缺点等多个方面进行详细的介绍。
一、Apriori算法Apriori算法是关联规则中的一种基础算法,它是R. Agrawal和R. Srikanth于1994年提出的。
该算法的主要思想是:如果某个项集是频繁的,那么它的所有子集也应该是频繁的。
这意味着如果一个项集没有达到最小支持度的要求,那么包含这个项集的项集必定不能达到最小支持度要求。
Apriori算法的实现过程主要分为两个步骤。
第一步是生成候选项集,即根据原始数据集生成所有可能出现的项集,包括单项、双项、三项等。
第二步是计算每个项集的支持度,并根据最小支持度对项集进行筛选,得到频繁项集。
Apriori算法的优点是它的思想简单易懂,容易实现。
然而,由于该算法需要生成大量的候选项集,因此它的计算复杂度比较高,而且在处理大规模数据时不够高效。
二、FP-growth算法FP-growth算法是一种基于树结构的关联规则算法,它最早是由Han J.和Kamber M.在2000年提出的。
该算法主要采用基于前缀树的方法,先将原始数据集转换为一棵FP树(频繁模式树),然后通过对FP树的递归遍历,得到所有的频繁项集。
FP-growth算法的实现过程主要分为两个步骤。
第一步是构建FP树,即对原始数据集进行一个预处理,生成一棵FP树。
第二步是遍历FP树,根据FP树的头指针表和条件模式基,递归地生成频繁项集。
FP-growth算法的优点是它不需要生成大量的候选项集,可以减少计算复杂度,同时也具有较高的效率和准确率。
同时,该算法也具有较好的扩展性和灵活性,可以通过实现不同的优化方式来适应不同的数据集。
基于关联规则的遥感数据挖掘与应用
基于关联规则的遥感数据挖掘与应用基于关联规则的遥感数据挖掘与应用遥感技术的应用日益广泛,为了更好地利用遥感数据,挖掘其中隐藏的规律和知识,关联规则成为一种常用且有效的数据挖掘方法。
本文将介绍基于关联规则的遥感数据挖掘原理与应用,探讨如何利用关联规则挖掘遥感数据中的规律,以及该方法在资源管理、环境监测和决策支持等领域的应用。
一、关联规则挖掘的基本原理和方法关联规则挖掘是一种发现数据集中项之间有趣关系的技术。
基于频繁项集的挖掘方法是关联规则挖掘的经典算法,其基本思想是通过计算项集的支持度和置信度来确定频繁项集和关联规则。
频繁项集指出在数据集中经常同时出现的项集,而关联规则则表示两个项集之间的关系。
在遥感数据中,关联规则挖掘可以将遥感数据中的像元或特征组合起来,发现相互之间的关联关系,从而揭示遥感数据中的规律和知识。
关联规则挖掘的基本过程包括数据预处理、频繁项集的发现、关联规则的生成和评价等步骤。
二、关联规则在遥感数据中的应用1. 资源管理领域的应用遥感数据在资源管理中起着重要的作用,例如土地利用、森林资源和水资源等。
通过挖掘遥感数据中的关联规则,可以发现不同土地类型之间的关联关系,进而预测土地利用的变化趋势。
对于森林资源的管理,可以利用关联规则挖掘找到各种自然因素和人为活动之间的关联关系,为森林保护和管理提供决策支持。
2. 环境监测领域的应用关联规则挖掘在环境监测中也发挥重要作用。
以城市的空气质量监测为例,遥感数据中包含了大量的空气污染指标和环境因素。
通过挖掘关联规则,可以发现不同因素之间的关联关系,进而预测某些因素的变化趋势,为环保部门和政府提供决策参考。
3. 决策支持领域的应用关联规则挖掘可以为决策支持提供有力的依据。
在遥感数据中,通过挖掘关联规则,可以找到不同特征之间的关联关系,从而帮助决策者更好地理解遥感数据中的规律和潜在关系。
例如,在城市规划中,可以利用关联规则挖掘发现不同因素之间的关联,为城市规划师提供科学决策支持。