
定量研究方法论--多变量回归建模
23
24 所以,根据额外平方和,易学性在易用性的基础上没有显著地增加对信任的解释。
25 我们把这种结果归因于易学性和易用性之间的信息重复。这种模型的“危害”有哪
26 些呢?我们在以前已经提到过,这种模型:
27
28 *没有简洁性
29 *具有误导性。如果我们只看回归分析的结果,我们很可能得到一个错误的结论:
21 于 x 单独作用于 y 时显著地降低(c’),但仍大于零(图?)。如果 x 的回归系数变
22 为零,这种情况叫做完全中介,如果只是显著降低,则为部分中介(partial
23 mediation)。显然,部分中介的情况更为普遍(Baron & Kenny, 1986; Frazier et al.,
t
Sig.
B Std. Error
B
Std. Error
peou 0.39
0.09 4.58 0.00 peou 0.69
0.21 3.33 0.00
peol 0.26
0.08 3.40 0.00 peol -0.29
0.18 -1.58 0.12
16
17 这些问题,在线性回归中叫做多重共线性问题,因为线性关系不只出现在自、应变
30 易学性是不重要的。
31
1
版权所有,徐云杰,博士,新加坡国立大学电脑学院信息系统系。xuyj@.sg。版本号:D1-0
1
如果我们查看组合模型的回归系数,我们还会发现易学性的系数是负的(-
2 0.29),这几乎是这个变量单独作用是的相反数(0.26)。这“说明”易学性对信
(Constant) peou
peol
1
1
2.98
1.00
0.00
0.00
0.00
2
0.02
12.52
0.93
0.03
0.06
3
0.00
34.18
0.07
0.97
0.94
a
Dependent Variable: trust
24
25 可以看出,PEOU 和 PEOL 同时负载一个很小的主成份信息,所以具有多重共线
33 (VIF,variance inflation factor)。可以证明(附一),在标准化后的回归模型
34 中,b1 的方差是残差的方差乘以这个方差膨胀系数。当一个自变量中全部是独特
35 信息时,方差膨胀系数=1。方差膨胀系数是一个多重共线性的重要指标。在社会
2
版权所有,徐云杰,博士,新加坡国立大学电脑学院信息系统系。xuyj@.sg。版本号:D1-0
12 倍。这与回归系数的不稳定性是一致的,标准差变大意味着回归系数的变化范围变
13 大。同时,它也意味着这两个变量都变得更不容易具有显著性,因为显著性与系数
14 的标准差成反比。
15
独立作用时
组合模型
Unstandardized
Unstandardized
Coefficients
t
Sig.
Coefficients
15 量起作用。最后我们介绍两个自变量之间的调节作用,即一个自变量对应变量作用
16 的大小取决于另外一个自变量的水平。
17
18 多重共线性
19
我们先来回顾一下前一章的例子。我们假设消费者对网店的信任受到两个变
20 量的影响:网店的易用性与易学性。我们的方差分析结果表明虽然这两个变量在独
21 自作用时对应变量都有显著影响,当组合在一起时:
9 际研究中,研究者往往事先计划(而不是事后投机)使用多个高度相关的显性测度
10 来表示一个隐性变量,并用其均值进行回归。当然,理论模型要针对隐性变量而不
11 是显性测度。我们会在以后再详细介绍这种使用多个测度项的方法。
12 第三种方法是用(ridge regression)。使用这种方法不需去除自变量。但这种方法也
3
版权所有,徐云杰,博士,新加坡国立大学电脑学院信息系统系。xuyj@.sg。版本号:D1-0
1 由于这个样本的特殊性。“后见之明”会增加我们拒绝一个不该拒绝的假设的风
2 险,从而降低这个模型的统计效用(statistical power)。所以,正确的方法是在设
3 计理论模型的过程中就充分考虑到多重共线性出现的可能性,避免相关性高的自变4Biblioteka 量,从根本上解决这个问题。5
另一种方法是组合相关性很高的自变量(Stevens, 2002)。在这种情况下,多
6 个相关性很高的自变量其实被看作一个隐性变量(latent variable)的显性测度。常
7 用的办法是把这些相关自变量进行加总或平均,然后再放入回归模型。这种方法必
8 须首先保证相关自变量具有理论上的相关性。否则,这种组合是没有意义的。在实
18 量之间,而且出现在自变量之间。这种出现在自变量之间的线性关系使得自变量对
19 应变量的作用难以直观解释,并使得线性回归的结果不具有可靠性。
20
那么多重共线性的最基本的形成原因是什么呢?从理论的角度看,这是因为
21 自变量之间的信息重叠。这种信息重叠会导致一系列的数学后果,最终使得回归系
22 数变得无法解释或者不可靠。
1
第八章 线性回归的建模
2 引言
3
我们以前对于单变量与多变量回归模型的介绍侧重于理解应、自变量之间的
4 最基本的数量关系,也即回归模型是如何表达应变量是如何被自变量解释的、应变
5 量中的信息可以如何被分解成不同的部分、这些不同的信息如何反映在回归系数、
6 (偏)决定系数、部分相关系数、残差、与方差分析上。我们在这一章所侧重的是
8 过高地表达了易用性对信任的作用(0.69),然后再用易学性进行反向调整(-
9 0.29)。显然,这不是我们建立回归模型的初衷(或者说,我们以前往往对回归分
10 析有一种误解,认为每一个回归系数表达了一个自变量对应变量的直接作用)。
11 我们还会发现回归系数的标准差变大了。对于这两个自变量,它们的标准差至少翻
20 90%是由这个很小的主成份贡献的,我们就知道这两个自变量之间有多重共线性
21 (常数项除外)。
22
在以上的例子中,从 SPSS 的输出我们得到:
23
Collinearity Diagnostics(a)
Condition
Model Dimension Eigenvalue Index
Variance Proportions
29 被叫做它(相对于其它自变量)的容限(tolerance)。一个自变量中的独特信息越
30 多,它的容限越小,即它越不容纳其它自变量中的信息。当一个变量中的信息全部
31 是独特是时候,它的容限是 0。注:Pedharzur and Schmelkin 1991 defined tolerance
32 in another way. This needs to be checked.]。 (1 − Rk2 ) 的倒数叫做方差膨胀系数
29 (longitudinal study);第二,以 y 为核心变量,这种方法给出一种区分外围与直
30 接原因的工具。这样,我们可以理清哪些变量是 y 的最直接原因,从而简化且深化
31 对 y 的理解。所以,这种测试计划首先必须是基于理论论证的。
23
如何鉴定多重共线性呢?对于一个经过标准化的两个自变量的回归模型,我
24 们在前一章提到过:
25
b1
=
x'1
y − r12x'2 1 − r122
y
=
(x'1 −r12x'2 1 − r122
)y
=(x1
的相对于
x2
的残差与
y
的积和/x1
中的独特
26 信息),
27 所以b1 是一个y的线性组合。这意味着当x1 中的独特信息很少,即 (1 − r122 ) 很小, 28 b1 的方差就会很大。[xk中在被其它所有的自变量联合解释后的独特信息 (1 − Rk2 ) 又
1 科学中,经验法则是每一个自变量的方差膨胀系数应该小于 10(ref)(Kutner et
2 al., 1996)。显然,这个经验法则要求每一个变量的独特信息至少是 10%。但是,
3 方差膨胀系数小于 10 并不意味着没有多重共线性。在这个例子中,VIF(x1) = 1/(1-
4 0.912) = 5.82。但是显然,多重共线性已经产生严峻的副作用。
11 量水平的影响。对这些不同的自变量之间的关系的分析是一个科研模型在数据收集
12 与测试之前的不可或缺的步骤。在这一章,我们将先介绍多重共线性
13 (multicollinearity),它描述了两个变量之间的因为有过多的信息重复而导致的问
14 题。然后我们介绍自变量之间的中继关系,即一个自变量通过另一个自变量对应变
22
Sum of
Mean
Model
Squares df
Square F
Sig.
3 Regression 17.00
2
8.50 11.90
0.00
x1 15.23
1 15.23 21.32
0.00
x2|x1
1.77
1
1.77
2.48
0.12
Residual
73.58
103
0.71
Total
90.58
105
24 2004)。z 是中介变量(mediator)。
25
中介作用表达了一组变量之间的间接因果关系。这样的关系往往就是一个理
26 论假设的重点。很多论文的主题就是为了测试几个变量之间的的间接关系。如果一
定量分析方法(11-1)
第十一章 回 归 分 析本章以一元线性回归模型为重点介绍回归分析方法,对于一元线性回归模型所建立的理论与方法作适当的修改便可推广到多元线性回归模型。
§1 回归的概念一、变量之间的关系现实中,各种变量相互依赖、相互影响,存在着某种关系。
如:价格与需求量、利率与投资、收入与消费,等等。
大致可以归纳为两类关系:确定性关系(函数关系),非确定性关系(统计关系)。
1. 确定性关系:变量之间存在着某种完全确定的关系。
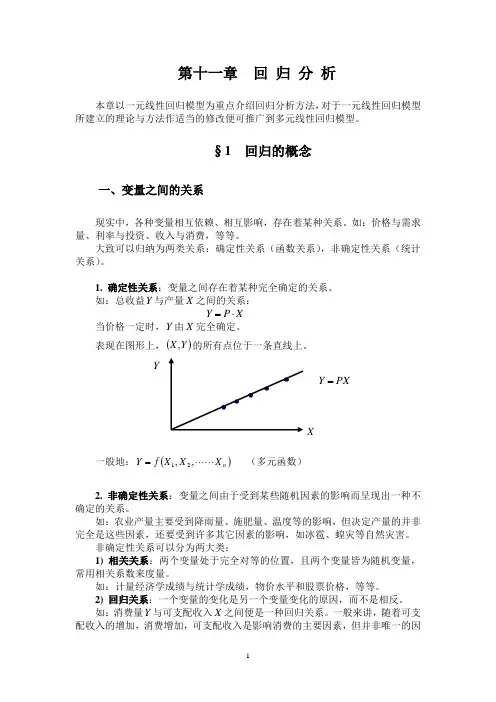
如:总收益Y 与产量X 之间的关系:X P Y ⋅=当价格一定时,Y 由X 完全确定。
表现在图形上,()Y X ,的所有点位于一条直线上。
一般地:()n X X X f Y ,,21= (多元函数)2. 非确定性关系:变量之间由于受到某些随机因素的影响而呈现出一种不确定的关系。
如:农业产量主要受到降雨量、施肥量、温度等的影响,但决定产量的并非完全是这些因素,还要受到许多其它因素的影响,如冰雹、蝗灾等自然灾害。
非确定性关系可以分为两大类:1) 相关关系:两个变量处于完全对等的位置,且两个变量皆为随机变量,常用相关系数来度量。
如:计量经济学成绩与统计学成绩,物价水平和股票价格,等等。
2) 回归关系:一个变量的变化是另一个变量变化的原因,而不是相反。
如:消费量Y 与可支配收入X 之间便是一种回归关系。
一般来讲,随着可支配收入的增加,消费增加,可支配收入是影响消费的主要因素,但并非唯一的因XYPX Y =素,影响消费的因素还有消费习惯、地区差异、年龄构成、宗教信仰等等。
同样收入的家庭,有的支出多,有的支出少,即使是同一家庭,其每个月的收入相同的话,各个月的支出也不会完全一样。
这样,对应于一个X 的值,Y 有多个不同的值相对应,X 与Y 呈现出不确定性的关系。
此时:()u X f Y += (u 为随机影响)表现在图形上,()Y X ,的点不是完全处于一条直线(或曲线)上,而是围绕在一条理论线的两旁变化。
23 种定量研究方法
23 种定量研究方法,你会几种?量化研究方法2019-12-28文章作者| 乔晓春首先我们对前面介绍的方法进行简单的归纳。
我们把研究方法分为三个层面,即方法论、一般方法和特殊方法。
在一般方法层面又分为定量研究和定性研究方法,而定量研究方法所涵盖的内容最多,也是社会科学研究中使用最为广泛的方法,规范的定性研究方法在中国使用得并不多。
这主要是因为中国学者对定性研究有自己的理解,甚至把理论研究、思辨研究都称为定性研究,这是错误的。
∆研究方法的三个层次下面给出23种具体定量研究方法的名称:01. 社会科学应用统计学原理02. 社会测量方法03. 实验设计方法04. 抽样调查方法05. 应用线性回归模型06. 分类数据分析07. 生存分析(或事件史分析)08. 空间数据分析09. 多元数据分析10. 分层分析11. 纵向分析12. 路径分析13. 结构方程模型14. 项目评估方法15. 系统动态学16. 贝叶斯方法17. 队列分析18. 随机过程或马尔科夫链19. 系统仿真方法20. 文献分析方法21. 内容分析方法22. 势分析方法23. 复杂调查数据分析方法在一般方法中的定性研究方法中,给出了下面几种方法:1. 叙述研究2. 现象学3. 扎根理论4. 民族志5. 案例研究6. 焦点组讨论上面所列的研究方法课程,并不是可以随便想学哪一门课就可以学哪一门课的,它们之间具有内在逻辑联系。
要想系统学习社会科学研究方法,需要遵循这种内在的逻辑顺序,否则会影响对内容的理解。
学习社会科学研究方法,第一门课应该是“研究设计和研究方法”。
学习这门课,可以对社会科学研究的基本思路、原理、过程、各类方法等有基本的、全面的理解。
在这门课中还会介绍一些简单的、与社会测量有关的内容,包括实验设计、问卷设计、抽样设计等。
学完这门课以后,有人喜欢继续学习定量研究方法,也有人可能会喜欢学习定性研究方法,那么就可以开始学习第二个层次的课程。
定量研究方法的数据收集与分析
定量研究方法的数据收集与分析在定量研究方法中,数据的收集和分析是非常重要的环节。
本文将介绍定量研究方法中常用的数据收集技术,以及常见的数据分析方法。
一、数据收集方法1.问卷调查:问卷调查是收集大量数据的一种有效方式。
研究者可以通过编制问卷,针对样本对象进行调查,并收集他们的回答。
问卷调查可以采用纸质问卷或在线问卷的形式。
在设计问卷时,需要注意问题的编排顺序、选项的设定以及语言表达的准确性,以确保数据的可靠性和有效性。
2.实验研究:实验研究可以通过在控制变量的条件下观察变量之间的关系。
在实验中,研究者可以人为地引入某种变化,观察其他变量的变化情况。
实验研究的数据收集需要明确的实验设计和实验流程,并严格控制变量,以保证结果的可靠性。
3.观察法:观察法是通过观察研究对象的行为或现象,收集数据并进行分析。
观察可以是实地观察,也可以是间接观察。
在观察中,研究者需要确保观察的客观性和准确性,避免主观偏见的干扰。
二、数据分析方法1.描述统计:描述统计是对数据进行整体的概括和描述。
常用的描述统计指标有平均数、中位数、众数、标准差等。
通过描述统计,研究者可以了解数据的分布情况和集中趋势,对数据进行初步的整理和分析。
2.推论统计:推论统计是通过对样本数据进行分析,推断总体数据的特征和关系。
推论统计包括参数估计和假设检验两个方面。
研究者可以通过对样本数据的分析,对总体数据的某种特征进行估计,并对研究假设进行检验。
3.回归分析:回归分析用于研究变量之间的因果关系。
通过回归分析,研究者可以了解一个或多个自变量对因变量的影响程度。
常见的回归分析方法包括线性回归和多元回归等。
4.相关分析:相关分析用于研究变量之间的相关性。
通过相关分析,研究者可以判断两个变量之间的相关程度,并探索其关系的方向和强度。
相关分析常用的方法包括皮尔逊相关系数和斯皮尔曼相关系数等。
5.因子分析:因子分析用于研究多个变量之间的内在关系。
通过因子分析,研究者可以将多个相关的变量综合为较少的几个因子,从而简化数据分析的复杂性。
学术论文中的定量研究方法

学术论文中的定量研究方法在学术界,研究方法是进行科学研究的基础,而定量研究方法是其中一种重要的方法论。
定量研究方法通过收集和分析数量化的数据,从而得出客观、可量化的结论。
本文将探讨学术论文中的定量研究方法,包括其定义、特点、应用以及一些常见的统计分析方法。
一、定量研究方法的定义和特点定量研究方法是指通过收集和分析数量化的数据,以数值化的方式描述和解释研究对象的方法。
与定性研究方法相比,定量研究方法更加注重数据的客观性和可重复性,能够提供更加精确的结果。
定量研究方法的特点主要有以下几个方面:1. 数量化的数据:定量研究方法的核心是收集和分析数量化的数据,这些数据可以通过问卷调查、实验观察、统计数据等方式获得。
通过对这些数据进行统计分析,可以得出客观、可量化的结论。
2. 大样本研究:定量研究方法通常需要较大的样本量,以保证结果的可靠性和代表性。
通过大规模的数据收集,可以更好地反映研究对象的整体情况,提高研究结果的可信度。
3. 统计分析:定量研究方法依赖于统计学的理论和方法,通过对数据进行统计分析,揭示数据之间的关系和趋势。
常见的统计分析方法包括描述统计、相关分析、回归分析等。
二、定量研究方法的应用领域定量研究方法广泛应用于各个学科领域,包括社会科学、自然科学、医学等。
在社会科学领域,定量研究方法常用于经济学、心理学、教育学等学科的研究中。
例如,在经济学中,可以通过问卷调查和统计数据分析来研究消费者行为、市场需求等经济现象。
在自然科学领域,定量研究方法常用于物理学、化学、生物学等学科的研究中。
例如,在物理学中,可以通过实验观察和数据分析来研究物体的运动规律、能量转化等物理现象。
在医学领域,定量研究方法常用于临床试验和流行病学研究中。
通过对大量病例的观察和数据分析,可以评估药物的疗效、疾病的发病率等医学问题。
三、常见的统计分析方法在定量研究方法中,统计分析是非常重要的一部分,可以帮助研究者揭示数据之间的关系和趋势。
定量研究报告中的回归分析与解读

定量研究报告中的回归分析与解读回归分析是统计学中常用的一种数据分析方法,用于研究因变量与自变量之间的关系。
回归分析在定量研究报告中扮演着重要的角色,帮助研究人员解读数据并验证假设。
本文将从六个方面展开,介绍回归分析的概念、使用方法和解读结果。
一、回归分析的概念及基本原理回归分析是一种用来预测因变量Y与自变量X之间关系的统计技术。
其基本原理是利用若干个自变量的数值与因变量的数值,建立一个数学模型,通过对模型进行数学运算,得到自变量与因变量之间的关系。
二、简单线性回归分析简单线性回归分析是回归分析中最简单的形式之一,它假设因变量与自变量之间的关系是线性的。
通过计算回归方程中的斜率和截距,可以得出因变量Y随着自变量X变化的趋势。
三、多元线性回归分析多元线性回归分析是考虑多个自变量对因变量的影响的一种回归分析方法。
通过计算多元回归方程中的回归系数,可以了解各个自变量对因变量的独立贡献。
四、逻辑回归分析逻辑回归分析是一种应用于因变量为二分类变量的回归方法。
它通过将因变量的取值转化为概率,用于解决分类问题。
逻辑回归可以帮助研究人员判断自变量与因变量之间的关系对于不同分类结果的影响。
五、回归分析中的模型评价模型评价是回归分析中十分重要的一环,可以用于评估回归模型的拟合程度和预测能力。
常用的评价指标包括R方值、均方误差和残差分析等。
这些指标可以帮助研究人员判断回归模型的可靠性和解释力。
六、回归分析结果的解读回归分析结果的解读是定量研究报告中不可或缺的部分。
研究人员需要根据回归系数的大小和正负,判断自变量对因变量的影响方向。
此外,还需要解释回归系数的统计显著性,以确定自变量对因变量的影响是否具有统计学意义。
总结起来,回归分析在定量研究报告中发挥着重要作用。
研究人员可以通过回归分析来验证假设、解读数据以及预测因变量的变化。
通过六个方面的详细论述,希望读者对回归分析在定量研究中的应用有一定的了解,并能更好地理解和解释研究报告中的回归分析结果。
SAS多重logistic回归汇总

Data Set
WORK.L2
Response Variable
Y
Number of Response Levels 4
Weight Variable
f
Model
cumulative logit
Optimization Technique Fisher's scoring
累积logit模型
因变量取值顺序是1~4,模型的建立以 因变量最低取值为基础。
Response Profile
Ordere d Value
1
acciden t
1
Total Frequency
25
说明该模型是以1 为基础,即以发生 事故的概率为基础 建模
P2robability m0odeled is ac2c0ident=1.
19
Deviance and Pearson Goodness-of-Fit Statistics Criterion Value DF Value/DF Pr > ChiSq Deviance 0.1170 2 0.0585 0.9432 Pearson 0.1168 2 0.0584 0.9433
多重Logistic回归分析
统计教研室
2011.12.31
1
主要内容
多重Logistic回归概念 多重Logistic回归模型 多重Logistic回归方程的假设检验 多重Logistic回归的SAS实现
2
一、多重Logistic回归概念
多重Logistic回归是一种重要的统计分析方法, 它用于研究一个定性因变量与多个自变量之间的 关系。
对模型偏回归系数假设 检验的结果,三种方法 分别是似然比检验、计 分检验和Wald检验。 P<0.05说明模型成立。
常用的定量分析方法
常用的定量分析方法引言在科学研究、商业决策以及数据分析等领域,定量分析方法被广泛使用。
定量分析方法通过数学和统计学的技术,将问题转化为可量化的形式,并使用数值化的方法进行分析和解决。
本文将介绍一些常用的定量分析方法,包括描述统计分析、回归分析、时间序列分析和假设检验等。
描述统计分析描述统计分析是最常见的定量分析方法之一,用于对数据进行总结和描述。
常用的描述统计方法包括平均值、中位数、众数、方差、标准差等。
这些统计量可以帮助我们了解数据的分布情况、集中趋势和离散程度。
描述统计分析可以帮助我们从数据中获得一些基本的统计信息,为后续的定量分析提供基础。
回归分析回归分析是一种用于研究变量之间关系的定量分析方法。
它通过建立数学模型,来描述和预测因变量与自变量之间的关系。
回归分析可以帮助我们理解变量之间的相互影响,以及预测因变量的可能取值。
常见的回归分析方法包括线性回归、多元回归和逻辑回归等。
线性回归是一种用于研究连续因变量与一个或多个连续自变量之间关系的回归分析方法。
它基于线性模型,通过最小二乘法来估计模型参数,并对因变量进行预测。
多元回归是在线性回归的基础上,引入多个自变量来建立模型。
逻辑回归则是一种用于研究二分类或多分类问题的回归分析方法,通过对因变量取对数几率的线性组合来进行建模和预测。
时间序列分析时间序列分析是一种定量分析方法,用于分析和预测时间序列数据。
时间序列数据是按时间顺序排列的数据,具有时间相关性。
时间序列分析可以帮助我们研究数据的趋势、周期性和季节性变化,并对未来的趋势进行预测。
常见的时间序列分析方法包括平滑法、移动平均法、指数平滑法和ARIMA模型等。
平滑法是一种常用的时间序列分析方法,用于平滑原始数据,去除数据中的噪声和随机波动。
移动平均法通过计算一定窗口内数据的平均值,来平滑时间序列数据。
指数平滑法则是根据过去观测值的加权平均值,对未来的趋势进行预测。
ARIMA模型是一种常用的时间序列预测模型,可以对时间序列数据进行拟合和预测。
大学毕业论文的定量研究方法与技巧
大学毕业论文的定量研究方法与技巧引言大学毕业论文是学生毕业前最重要的学术项目之一,它要求学生通过研究和分析来深入探讨一个特定的课题。
论文的定量研究方法和技巧是保证研究过程科学、准确的关键。
本文将介绍一些大学生在写毕业论文时可以采用的定量研究方法和技巧,旨在提供一些建议,帮助学生完成高质量的毕业论文研究。
一、问题的明确和假设的设定在进行定量研究之前,首先需要明确论文研究的问题,并设定明确的假设。
问题的明确有助于研究者更好地理解研究方向和目标。
假设则是对研究问题的一种预期答案,并为研究过程提供了指导。
二、数据收集定量研究的关键环节之一是数据收集。
数据可以通过调查问卷、实证观察、统计数据等方式获取。
在收集数据时,需要确保数据的准确性和可靠性。
1. 调查问卷调查问卷是获取大量数据的一种常见方法。
设计问卷时,应注意以下几点:- 问题的设计:问题应该明确、具体,并能覆盖研究范围;- 选项的设计:选项应该具有一定的分类和细化程度,以保证数据的准确性;- 问卷的测试:在正式运用之前,应先进行问卷的测试,以发现潜在问题并进行修正。
2. 实证观察实证观察是通过观察和记录来收集数据的方法。
在实施观察时,应注意以下几点:- 观察的选择:选择被观察的对象和场景,并明确观察的目的;- 观察记录:记录观察结果时应具体、客观,最好使用数字化的评估工具;- 观察的准确性:观察应该是准确无误的,可以通过重复观察和对比验证的方式提高观察的可靠性。
3. 统计数据在某些研究领域,可以利用历史数据或公开数据进行统计分析。
在使用统计数据时,应关注以下几个方面:- 数据来源:确保数据来源可靠和权威;- 数据分析:使用适当的统计方法对数据进行分析,如描述性统计、回归分析等;- 比较和验证:将研究数据与其他类似数据进行比较和验证,以验证研究结果的可靠性。
三、数据分析在数据收集之后,需要对数据进行分析和解释。
数据分析可以使用统计软件如SPSS、Excel等。
多个自变量曲线拟合
多个自变量曲线拟合是指将一个因变量与多个自变量之间的关系进行建模。
这种建模方法可以帮助我们理解和预测因变量如何随着自变量的变化而变化。
在多个自变量曲线拟合中,我们通常使用多元回归分析或者主成分分析等方法。
多元回归分析是一种常见的统计分析方法,可以用来描述一个因变量与多个自变量之间的关系。
在多元回归分析中,我们假设因变量与自变量之间存在线性关系,并通过最小二乘法估计回归系数。
多元回归分析的优点是可以提供预测精度较高的模型,并且可以分析各个自变量对因变量的影响程度。
然而,多元回归分析也有局限性,例如对于自变量之间的多重共线性比较敏感,可能会导致模型的不稳定。
主成分分析是一种常见的线性变换方法,可以将多个自变量转化为几个线性无关的主成分。
通过保留最大的几个主成分,我们可以减少自变量的数量,同时保留尽可能多的原始信息。
主成分分析的主要优点是可以降低数据的维度,减少计算量,并且可以消除自变量之间的多重共线性。
然而,主成分分析也有一些局限性,例如可能无法很好地处理非线性关系,以及对异常值比较敏感。
在多个自变量曲线拟合中,我们还可以使用其他方法,例如岭回归、LASSO回归、神经网络等。
这些方法在一定程度上可以改善模型的预测性能,并且可以处理自变量之间的多重共线性问题。
然而,这些方法也有一些局限性,例如需要调整参数,可能会导致过拟合等问题。
总之,在多个自变量曲线拟合中,我们需要根据实际情况选择合适的方法,同时注意模型的优化与解释。
定量研究方法与建模
公共管理中的很多问题很难量化提炼
整理课件
7
最优化方法几种常见的问题和模型
1 )线性规划问题及其数学模型:单纯形解法和 运输问题
2 )动态规划:解决多阶段决策过程最优化
3 )资源分配问题:将数量一定的资源恰当的分 配给若干个使用者,使总的目标函数最优
整理课件
8
7、对策与对策方法
整理课件
33
社会科学的任务是研究并阐述各种社会现象 及其发展规律,而自然科学的任务是帮助人 类认识自然规律,为人类正确改造自然开辟 道路;
研究社会问题(人)比研究如何种土豆要困 难的多?
互相影响,共同支撑社会的发展
研究天气预测和研究应急预案和应急措施
整理课件
34
社会科学对社会的作用和影响更多地表现 在理性功能方面,而自然科学更多地表现 在技术功能方面。
交论文的时间:进入考期前
整理课件
20
本课程的主要内容
绪论 (社会科学中的定量研究方法简介) 研究设计 抽样方法 数据收集方法 数据分析方法
1 描述统计
–数据分布特征
2 推断统计 3 双变量统计分析方法
列联表分析,方差分析,相关分析,回归分析
4 时间序列分析 5 结构方程分析方法
整理课件
21
第一章 绪论
整理课件
22
本章内容
第一节 科学与社会科学 第二节 定量研究方法概述
整理课件
23
第一节 科学与社会科学
1.科学的基础 2.科学研究的三大层面 3.社会科学和自然科学 4、社会科学中的两个基本观念
整理课件
24
1、科学的基础
科学对世界的理解必须言之成理并且符合 我们的观察