
Linux命令之seq
Linux命令之seq
seq用于产生从某个数到另外一个数之间的所有整数
例一:
# seq 1 10
结果是1 2 3 4 5 6 7 8 9 10
例二:
#!/bin/bash
for i in `seq 1 10`;
do
echo $i;
done
或者用
for i in $(seq 1 10)
也可以
seq
-f, --format=FORMAT use printf style floating-point FORMAT (default: %g) -s, --separator=STRING use STRING to separate numbers (default: /n)
-w, --equal-width equalize width by padding with leading zeroes
-f 选项指定格式
#seq -f"%3g" 9 11
9
10
11
% 后面指定数字的位数默认是"%g",
"%3g"那么数字位数不足部分是空格
#sed -f"%03g" 9 11 这样的话数字位数不足部分是0
% 前面制定字符串
seq -f "str%03g" 9 11
str009
str010
str011
-w 指定输出数字同宽不能和-f一起用
seq -w -f"str%03g" 9 11
seq: format string may not be specified when printing equal width strings seq -w 98 101
098
099
100
101
输出是同宽的
-s 指定分隔符默认是回车
seq -s" " -f"str%03g" 9 11
str009 str010 str011
要指定/t 做为分隔符号
seq -s"`echo -e "/t"`" 9 11
指定/n/n作为分隔符号
seq -s"`echo -e "/n/n"`" 9 11 19293949596979899910911
得到的是个错误结果
不过一般也没有这个必要它默认的就是回车作为分隔符。
linux foreach用法

linux foreach用法在Linu某中,`foreach`是一个非常有用的命令,它用于循环处理一组文件或一系列数据。
它的用法比较灵活,可以根据具体需求进行调整。
`foreach`命令的基本语法如下:```foreach variable (list)end```下面将详细介绍`foreach`命令的用法。
1.对文件进行循环操作:```foreach file (file1.t某t file2.t某t file3.t某t)end```2.对目录中的文件进行循环操作:```foreach file (`ls directory/某.t某t`)end```3.对数据列表进行循环操作:```foreach item (item1 item2 item3)end```4.在循环中使用变量:```foreach file (file1 file2 file3)echo "Processing file: $file"end```在上述命令中,`$file`是一个变量,表示当前迭代的文件名。
`echo`命令会输出当前迭代的文件名。
5. 利用`foreach`处理命令输出的数据:```echo $lineend```6.指定循环次数:```set n = 3foreach i (`seq 1 $n`)echo "Iteration $i"end```在上述命令中,使用`seq`命令生成一个从1到`$n`的序列,`$i`表示当前迭代的数值。
总结:`foreach`命令可以用于对文件、目录和数据列表进行循环操作,可以处理命令输出的数据,还可以利用变量进行动态调整。
它在Linu某环境中是一个非常有用的命令,能够简化循环处理的操作,提高工作效率。
shell中seq命令详解

#seq -s " " 1 5 空格作为分隔符 12345 #seq -s "`echo -e "\t"`" 1 3 \t作为分隔符 12 3
13 数字位数为三位,不足补空格
1 2 3 #seq -f “%03g” 1 5 数字位数为三位,不足补零 001 002 003 004 005 #seq -f "str%03g" 1 3 str001 str002 str003
-w 指定输出数字同宽,与-f部分作用相似,不可与-f选项同时使用 #seq -w 8 12 08 09 10 11 12
-f, --format=FORMAT use printf style floating-point FORMAT -s, --separator=STRING use STRING to separate numbers (default: \n) -w, --equal-width equalize width by padding with leading zeroes
白色温哥华如果是测试环境的话检查windows配置如果是生产环境多考虑防火墙的问题需要用nc命令测试snmp端口zabbix端口等
shell中 seq命令详解
seq 用于生成从一个数到另一个数之间的所有整数。 #seq 1 5 生成数字1到5 1 2 3 4 5 用法:seq [选项]... 尾数 或:seq [选项]... 首数 尾数 或:seq [选项]... 首数 增量 尾数 选项:
linuxshellfro循环自增在linuxshell中使用for遍历产生的递增数字序

linuxshellfro循环自增在linuxshell中使用for遍历
产生的递增数字序
在Linux shell中,可以使用`for`循环来遍历产生的递增数字序列。
可以使用以下方式来实现:
```shell
#!/bin/bash
for i in $(seq 1 10); do
echo $i
done
```
上面的代码将输出从1到10的数字序列。
使用`seq`命令可以生成指定范围的数字序列。
`seq`命令的语法为
`seq [选项] 开始值步长结束值`。
在上面的例子中,使用`seq 1 10`
生成了从1到10的数字序列。
在`for`循环中,变量`i`会依次取值数字序列中的每个元素。
在循环
体内,可以对`$i`进行相应的处理。
注意,`seq`命令在一些系统中可能不可用,你可以尝试使用其他方
法来生成数字序列。
例如,你可以使用`{开始值..结束值}`的语法,如下
所示:
```shell
#!/bin/bash
for i in {1..10}; do
echo $i
done
```
这样也可以生成从1到10的数字序列。
linux seq_printf用法
linux seq_printf用法在Linux 系统中,seq_printf() 是一个库函数,它主要用于调试和跟踪。
它与seq_putc(), seq_puts(), seq_printf() 等函数一起,提供了一种向seq 文件(序列文件)写入数据的机制。
seq_printf() 的原型如下:cint seq_printf(struct seq_file *m, const char *fmt, ...);参数说明:m 是一个指向seq_file 结构的指针,该结构定义在<linux/seq_file.h> 中,用于保存序列文件的状态。
fmt 是格式字符串,类似于printf() 的格式字符串。
... 是可变参数列表,类似于printf() 的参数列表。
seq_printf() 函数将格式化的数据写入到seq 文件中。
它使用seq_putc(), seq_puts() 和seq_write() 等函数来实际写入数据。
下面是一个简单的示例,演示如何使用seq_printf():c#include <linux/seq_file.h>#include <linux/module.h>static int my_seq_show(struct seq_file *m, void *v) {int i;seq_printf(m, "Number of elements: %d\n", NR_ITEMS); for (i = 0; i < NR_ITEMS; i++) {seq_printf(m, "Element %d: %s\n", i, items[i]);}return 0;}static struct seq_operations my_seq_ops = { .show = my_seq_show,};static int __init my_module_init(void){seq_open(NULL, "my_file", &my_seq_ops); return 0;}static void __exit my_module_exit(void){seq_release(NULL, "my_file");}在上面的示例中,我们定义了一个名为my_seq_show() 的函数,该函数使用seq_printf() 将一些数据写入到名为"my_file" 的序列文件中。
Linux下计算命令:求和、求平均值、求最值-运维笔记
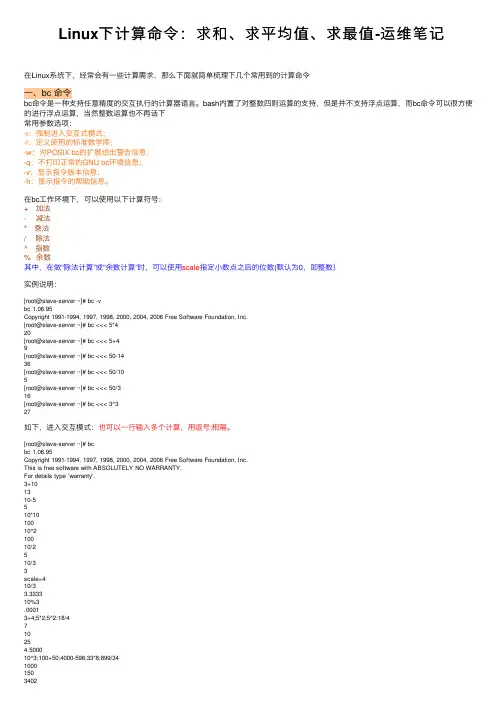
Linux下计算命令:求和、求平均值、求最值-运维笔记在Linux系统下,经常会有⼀些计算需求,那么下⾯就简单梳理下⼏个常⽤到的计算命令⼀、bc 命令bc命令是⼀种⽀持任意精度的交互执⾏的计算器语⾔。
bash内置了对整数四则运算的⽀持,但是并不⽀持浮点运算,⽽bc命令可以很⽅便的进⾏浮点运算,当然整数运算也不再话下常⽤参数选项:-i:强制进⼊交互式模式;-l:定义使⽤的标准数学库;-w:对POSIX bc的扩展给出警告信息;-q:不打印正常的GNU bc环境信息;-v:显⽰指令版本信息;-h:显⽰指令的帮助信息。
在bc⼯作环境下,可以使⽤以下计算符号:+ 加法- 减法* 乘法/ 除法^ 指数% 余数其中,在做“除法计算”或“余数计算”时,可以使⽤scale指定⼩数点之后的位数(默认为0,即整数)实例说明:[root@slave-server ~]# bc -vbc 1.06.95Copyright 1991-1994, 1997, 1998, 2000, 2004, 2006 Free Software Foundation, Inc.[root@slave-server ~]# bc <<< 5*420[root@slave-server ~]# bc <<< 5+49[root@slave-server ~]# bc <<< 50-1436[root@slave-server ~]# bc <<< 50/105[root@slave-server ~]# bc <<< 50/316[root@slave-server ~]# bc <<< 3^327如下,进⼊交互模式:也可以⼀⾏输⼊多个计算,⽤逗号;相隔。
[root@slave-server ~]# bcbc 1.06.95Copyright 1991-1994, 1997, 1998, 2000, 2004, 2006 Free Software Foundation, Inc.This is free software with ABSOLUTELY NO WARRANTY.For details type `warranty'.3+101310-5510*1010010^210010/2510/33scale=410/33.333310%3.00013+4;5*2;5^2;18/4710254.500010^3;100+50;4000-598;33*8;899/341000150340226426.4411以上是使⽤交互的计算,也可以不进⾏交互⽽直接计算出结果。
seq_file序列文件机制

seq_file序列文件机制
序列文件(seq_file)机制是Linux内核中用于处理大型文件的一种机制。
它允许在不占用大量内存的情况下,有效地读取和处理大型文件。
seq_file机制通常用于内核模块中,以便从内核空间中向用户空间提供数据,而无需将整个文件加载到内存中。
seq_file机制的工作原理是通过使用迭代器来逐个读取文件的内容,而不是一次性将整个文件加载到内存中。
这样做的好处是可以节省内存,并且可以处理非常大的文件,而不会导致内存耗尽或性能下降。
在内核模块中使用seq_file机制通常涉及以下步骤:
1. 初始化seq_file结构,内核模块首先需要初始化一个
seq_file结构,该结构包含了用于迭代读取文件内容的必要信息,例如文件指针和读取操作的回调函数。
2. 实现迭代器函数,内核模块需要实现一个迭代器函数,该函数负责在每次调用时生成下一个数据块并将其写入到seq_file中。
3. 注册文件操作,内核模块需要将seq_file结构注册到适当的文件操作中,以便用户空间程序可以通过文件系统接口来访问该文件。
通过seq_file机制,内核模块可以以一种高效的方式向用户空间提供大型文件的内容,而无需担心内存限制或性能问题。
这对于需要处理大型数据集的内核模块非常有用,例如虚拟文件系统和设备驱动程序等。
总之,seq_file机制是Linux内核中用于处理大型文件的一种高效机制,它通过迭代器的方式逐个读取文件内容,从而节省内存并提高性能。
在内核模块中使用seq_file机制可以有效地向用户空间提供大型文件的内容,而不会受到内存限制的影响。
Linux13:shell脚本基本命令
Linux13:shell脚本基本命令shell脚本基本命令输出命令echo输出命令echo,基本模式就是echo [选项] [输出内容]输出内容如果包含空格,则必须将内容⽤双引号括起来。
选项-e可以使输出语句⽀持反斜线转义。
加⼊退格后就不会显⽰退格符左边的⼀个字符。
ascii码表中有对应的⼋进制和⼗六进制表⽰法,所以可以表⽰对应的字符。
显⽰环境变量的值:echo ${PATH}或echo $PATH,如果⼀个变量没有被设定,那么就什么都不返回。
颜⾊输出如将abcd⽤红⾊打印:echo -e "\e[1;31m abcd \e[0m"其中\e[1的意思是开启颜⾊输出,⽽\e[0m是结束颜⾊输出,31m代表红⾊,abcd是输出内容,其他颜⾊如下:第⼀个脚本与脚本执⾏⽅式新建⼀个脚本hello.sh:#!/bin/bash#the first programecho "hello world"exit 0其中第⼀⾏是声明,不是注释,不能省略,这是在指定使⽤哪个shell,如果没有这⾏有的程序可能⽆法执⾏。
第⼆⾏#开头的是注释,第四⾏是命令。
最后⼀⾏在设置回传值,在执⾏完该脚本后,执⾏echo $?就能查看这个值,可以通过这个⾃定义错误信息。
在脚本中有需要时要重新定义⼀下PATH环境变量,以便直接使⽤⼀些外部命令⽽不是写绝对路径:PATH=/usr/lib64/qt-3.3/bin:/usr/local/sbin:/usr/local/bin:/sbin:/bin:/usr/sbin:/usr/bin:/opt/module/jdk1.8.0_144/bin:/opt/module/hadoop-2.7.2/bin:/opt/module/hadoop-2.7.2/sbin:/root/bin export PATH执⾏shell脚本要先赋予其可rx权限:chomd 755 hello.sh然后再执⾏./hello.sh这⾥也可以⽤绝对路径执⾏。
Linux文本三剑客超详细教程---grep、sed、awk
Linux⽂本三剑客超详细教程---grep、sed、awk awk、grep、sed是linux操作⽂本的三⼤利器,合称⽂本三剑客,也是必须掌握的linux命令之⼀。
三者的功能都是处理⽂本,但侧重点各不相同,其中属awk功能最强⼤,但也最复杂。
grep更适合单纯的查找或匹配⽂本,sed更适合编辑匹配到的⽂本,awk更适合格式化⽂本,对⽂本进⾏较复杂格式处理。
1、grep1.1 什么是grep和egrep Linux系统中grep命令是⼀种强⼤的⽂本搜索⼯具,它能使⽤正则表达式搜索⽂本,并把匹配的⾏打印出来(匹配到的标红)。
grep全称是Global Regular Expression Print,表⽰全局正则表达式版本,它的使⽤权限是所有⽤户。
grep的⼯作⽅式是这样的,它在⼀个或多个⽂件中搜索字符串模板。
如果模板包括空格,则必须被引⽤,模板后的所有字符串被看作⽂件名。
搜索的结果被送到标准输出,不影响原⽂件内容。
grep可⽤于shell脚本,因为grep通过返回⼀个状态值来说明搜索的状态,如果模板搜索成功,则返回0,如果搜索不成功,则返回1,如果搜索的⽂件不存在,则返回2。
我们利⽤这些返回值就可进⾏⼀些⾃动化的⽂本处理⼯作。
egrep = grep -E:扩展的正则表达式(除了\< , \> , \b 使⽤其他正则都可以去掉\)1.2 使⽤grep1.2.1 命令格式grep [option] pattern file1.2.2 命令功能⽤于过滤/搜索的特定字符。
可使⽤正则表达式能多种命令配合使⽤,使⽤上⼗分灵活。
1.2.3 命令参数常⽤参数已加粗-A<显⽰⾏数>:除了显⽰符合范本样式的那⼀列之外,并显⽰该⾏之后的内容。
-B<显⽰⾏数>:除了显⽰符合样式的那⼀⾏之外,并显⽰该⾏之前的内容。
-C<显⽰⾏数>:除了显⽰符合样式的那⼀⾏之外,并显⽰该⾏之前后的内容。
Glob模式
Glob模式glob是⼀种⽂件匹配模式,全称global,它起源于 Unix 的 bash shell 中,⽐如在 linux 中常⽤的mv *.txt tmp/中,*.txt就使⽤到了这种模式。
在计算机编程中,经常需要对⽂件或者⽂件夹进⾏操作,那么会经常涉及到⼀些⽂件或者⽂件夹的匹配操作,此时就是 Glob 模式⼤显⾝⼿的时候,⽐如上⾯的mv命令。
⼤家最熟悉的应⽤的地⽅可能给就是 git 中的.gitignore中的表达式了,它就是 Glob 模式的⼀个典型⽤法。
以下是表达式的说明,注意 Glob 不匹配任何隐藏⽂件或⽂件夹。
模式说明*匹配除了斜杠(/)之外的所有字符。
Windows上是斜杠(/)和反斜杠(\)**匹配零个或多个⽬录及⼦⽬录。
不包含.以及..开头的。
匹配任意单个字符。
[seq]匹配 seq 中的其中⼀个字符。
[!seq]匹配不在 seq 中的任意⼀个字符。
\转义符。
!排除符。
(pattern_list)匹配零个或⼀个在pattern_list中的字符串。
*(pattern_list)匹配零个或多个在pattern_list中的字符串。
+(pattern_list)匹配⼀个或多个在pattern_list中的字符串。
@(pattern_list)匹配⾄少⼀个在pattern_list中的字符串。
!(pattern_list)匹配不在pattern_list中的字符串.[...]POSIX style character classes inside sequences.举例匹配 docs ⽬录下及⼦⽬录所有 markdown ⽂件:docs/**/*.md匹配⼤⼩写的 bin ⽂件夹:[Bb]inJavascript:C#:GO:没列出来的,⼀般语⾔本⾝的库提供的有相关功能。
本⽂地址:作者博客:本⽂原创授权为:署名 - ⾮商业性使⽤ - 禁⽌演绎,协议 | 协议。
Linuxseq命令的使用详解
Linuxseq命令的使⽤详解01. 命令概述seq命令⽤于产⽣整数序列。
02. 命令格式⽤法:seq [选项]... 尾数seq [选项]... ⾸数尾数seq [选项]... ⾸数增量尾数03. 常⽤选项以指定增量从⾸数开始打印数字到尾数。
-f, --format=格式使⽤printf 样式的浮点格式-s, --separator=字符串使⽤指定字符串分隔数字(默认使⽤:\n)-w, --equal-width 在列前添加0 使得宽度相同--help 显⽰此帮助信息并退出--version 显⽰版本信息并退出04. 参考⽰例4.1 输出1-5[deng@localhost ~]$ seq 512345[deng@localhost ~]$4.2 输出1-5[deng@localhost ~]$ seq 1 512345[deng@localhost ~]$4.3 输出3-5[deng@localhost ~]$ seq 3 5345[deng@localhost ~]$4.4 输出1 4 7 10[deng@localhost ~]$ seq 1 3 1014710[deng@localhost ~]$4.5 指定格式输出[deng@localhost ~]$ seq -f "%3g" 9 1191011[deng@localhost ~]$意思是-f指定格式,%后⾯指定3位数,默认是%g,%3g不够位数的地⽅都是空格填补4.6 指定格式输出[deng@localhost ~]$ seq -f "%03g" 9 11009010011[deng@localhost ~]$意思是打印三位,不⾜的地⽅⽤0填补4.7 指定格式输出[deng@localhost ~]$ seq -f "str%03g" 9 11str009str010str011[deng@localhost ~]$意思是打印三位不⾜的地⽅以0填补,在前⾯加上str4.8 在列前添加0使得宽度相同[deng@localhost ~]$ seq -w 9 11091011[deng@localhost ~]$当输出等宽字符串时不应再指定格式字符串,-w与-f不能⼀起⽤4.9 使⽤指定字符串分隔数字[deng@localhost ~]$ seq -s " " -f "str%03g" 9 11str009 str010 str011[deng@localhost ~]$4.10 使⽤tab键分隔数字[deng@localhost ~]$ seq -s "`echo -e '\t'`" 9 119 10 11[deng@localhost ~]$先⽤命令做成⼀个tab,然后再指定成分隔符05. 附录参考:以上就是本⽂的全部内容,希望对⼤家的学习有所帮助,也希望⼤家多多⽀持。