
基于EViews6的面板数据计量分析.
EViews_6[1].0_beta面板数据模型估计,详细!
EViews 6.0 beta在面板数据模型估计中的应用来自免费的minixi1、进入工作目录cd d:\nklx3,在指定的路径下工作是一个良好的习惯2、建立面板数据工作文件workfile(1)最好不要选择EViews默认的blanaced panel 类型Moren_panel(2)按照要求建立简单的满足时期周期和长度要求的时期型工作文件3、建立pool对象(1)新建对象(2)选择新建对象类型并命名(3)为新建pool对象设置截面单元的表示名称,在此提示下(Cross Section Identifiers: (Enter identifiers below this line )输入截面单元名称。
,建议采用汉语拼音,例如29个省市区的汉语拼音,建议在拼音名前加一个下划线“_”,如图关闭建立的pool对象,它就出现在当前工作文件中。
4、在pool对象中建立面板数据序列双击pool对象,打开pool对象窗口,在菜单view的下拉项中选择spreedsheet (展开表)在打开的序列列表窗口中输入你要建立的序列名称,如果是面板数据序列必须在序列名后添加“?”。
例如,输入GDP?,在GDP后的?的作用是各个截面单元的占位符,生成了29个省市区的GDP的序列名,即GDP后接截面单元名,再在接时期,就表示出面板数据的3维数据结构(1变量2截面单元3时期)了。
请看工作文件窗口中的序列名。
展开表(类似excel)中等待你输入、贴入数据。
(1)打开编辑(edit)窗口(2)贴入数据(3)关闭pool窗口,赶快存盘见好就收6、在pool窗口对各个序列进行单位根检验选择单位根检验设置单位根检验单位根检验结果注意检验方法和两种检验的零假设:Null: Unit root (assumes common unit root process)各截面有相同的单位根Null: Unit root (assumes individual unit root process)允许各截面有不同单位根其中,Levin, Lin & Chu t*检验拒绝含有单位根的零假设,即拒绝非平稳7、在pool窗口对面板数据组合进行协整检验选择进行协整检验协整检验设置对话框,注意有3种检验方法(test type)协整检验结果,同样要注意两种假定(含有AR,即含有单位根,非协整),两种零假设都是非协整,小概率事件发生拒绝非协整。
EVIEWS面板数据分析操作教程及实例解析

模型选择对分析结果影响
模型适用性
根据研究目的和数据特征选择合 适的面板数据模型,如固定效应 模型、随机效应模型等。
模型假设
确保所选模型满足基本假设,如 线性关系、误差项独立同分布等 ,否则可能导致结果不准确。
模型比较与选择
通过比较不同模型的拟合优度、 参数显著性等指标,选择最优模 型进行分析。
操作规范性与结果可靠性保障措施
操作步骤规范
结果验证与解读
对分析结果进行验证,确保结果的合理性和准确性 ;同时,正确解读分析结果,避免误导读者。
严格按照EVIEWS软件的操作步骤进行分析 ,避免操作失误或遗漏关键步骤。
数据分析报告
编写详细的数据分析报告,包括数据来源、 处理方法、模型选择、分析结果及解读等, 以便读者全面了解分析过程。
方和来估计模型参数。
广义最小二乘法(GLS)
02
当存在异方差性或自相关性时,采用广义最小二乘法进行参数
估计,以提高估计效率。
最大似然法(ML)
03
适用于随机效应模型等复杂面板数据模型,通过最大化似然函
数来估计模型参数。
模型诊断与检验
残差分析
检查残差是否满足独立同分布等假设条件, 以评估模型的拟合效果。
07 EVIEWS面板数 据分析操作注意 事项
数据质量对分析结果影响
数据来源
确保数据来自可靠、权威的来源,避免使用不准确或存在偏见的数 据。
数据完整性
检查数据是否存在缺失值、异常值或重复值,这些问题可能导致分 析结果失真。
数据处理
对数据进行适当的预处理,如清洗、转换和标准化,以提高数据质量 和一致性。
增强了解决实际问题的能力
通过实例解析和操作演示,学员们学会了如何运用所学知识解决实际问题,提高了分析 问题和解决问题的能力。
详细EVIEWS面板数据分析操作37页PPT
25、学习是劳动,是充满思想的劳动。——乌申斯基
谢谢!
详细EVIEWS面板数据分析操作
31、园日涉以成趣,门虽设而常关。 32、鼓腹无所思。朝起暮归眠。 33、倾壶绝余沥,窥灶不见烟。
34、春秋满四泽,夏云多奇峰,秋月 扬明辉 ,冬岭 秀孤松 。 35、丈夫志四海,我愿不知老。
Hale Waihona Puke 21、要知道对好事的称颂过于夸大,也会招来人们的反感轻蔑和嫉妒。——培根 22、业精于勤,荒于嬉;行成于思,毁于随。——韩愈
基于EViews 6的面板数据计量分析
基于EViews 6的面板数据计量分析对于面板数据,EViews 6 提供的估计方法有如下三种,最小二乘估计——LS - Least Squares (and AR)二阶段最小二乘估计——TSLS - Two-Stage Least Squares (and AR)动态面板数据模型的广义矩估计——GMM / DPD - Generalized Method of Moments/Dynamic Panel Data第1节“LS - Least Squares (LS and AR)”估计如果选择最小二乘方法估计面板数据模型,在“Equation Estimation”窗口中,须依次设置“Specification”、“Panel Options”和“Options”页面。
1.1“Specification”页面在“Specification”页面中,完成模型设定和估计样本时间范围的选择。
1 在“Equation specification”编辑区,指定模型的被解释变量、截距项和解释变量;2 在“Sample”编辑区,指定估计样本时间的范围。
1.2“Panel Options”页面设置模型中不可观测的双(单)因素效应,即面板数据回归模型的选择。
点击“Panel Options”该页面包含三方面内容。
1 效应设置在“Effects specification”选择区,设定面板数据模型的个体效应和时间效应,可选择的选项有“None”、“Fixed”和“Random”,分别表示“无效应”、“固定效应”和“随机效应”。
如果选择了“Fixed”或“Random”,EViews在输出结果中自动添加一个共同常数,即截距项,以保证效应之和为零。
否则,截距项必要时,须在“Specification”页面的“Equation specification”编辑区设定模型截距项。
2 GLS加权设置“GLS Weights”可以在下拉框中选择如下选项之一。
eviews面板数据实例分析(包会)
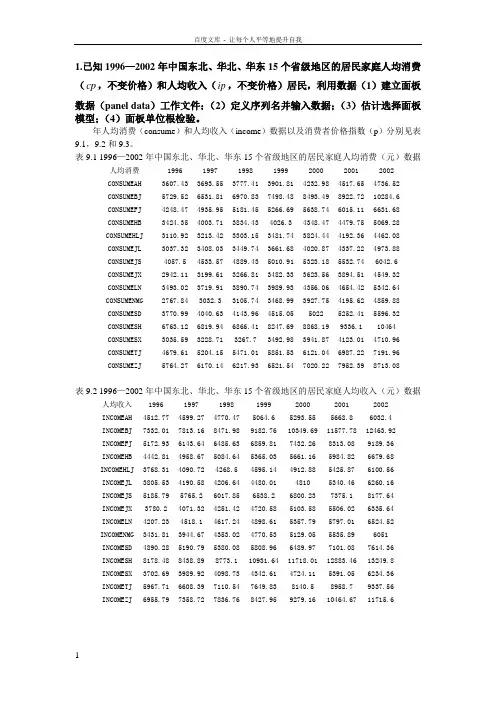
1.已知1996—2002年中国东北、华北、华东15个省级地区的居民家庭人均消费(cp,不变价格)和人均收入(ip,不变价格)居民,利用数据(1)建立面板数据(panel data)工作文件;(2)定义序列名并输入数据;(3)估计选择面板模型;(4)面板单位根检验。
年人均消费(consume)和人均收入(income)数据以及消费者价格指数(p)分别见表9.1,9.2和9.3。
表9.1 1996—2002年中国东北、华北、华东15个省级地区的居民家庭人均消费(元)数据人均消费1996 1997 1998 1999 2000 2001 2002CONSUMEAH 3607.43 3693.55 3777.41 3901.81 4232.98 4517.65 4736.52CONSUMEBJ 5729.52 6531.81 6970.83 7498.48 8493.49 8922.72 10284.6CONSUMEFJ 4248.47 4935.95 5181.45 5266.69 5638.74 6015.11 6631.68CONSUMEHB 3424.35 4003.71 3834.43 4026.3 4348.47 4479.75 5069.28CONSUMEHLJ 3110.92 3213.42 3303.15 3481.74 3824.44 4192.36 4462.08CONSUMEJL 3037.32 3408.03 3449.74 3661.68 4020.87 4337.22 4973.88CONSUMEJS 4057.5 4533.57 4889.43 5010.91 5323.18 5532.74 6042.6CONSUMEJX 2942.11 3199.61 3266.81 3482.33 3623.56 3894.51 4549.32CONSUMELN 3493.02 3719.91 3890.74 3989.93 4356.06 4654.42 5342.64CONSUMENMG 2767.84 3032.3 3105.74 3468.99 3927.75 4195.62 4859.88CONSUMESD 3770.99 4040.63 4143.96 4515.05 5022 5252.41 5596.32CONSUMESH 6763.12 6819.94 6866.41 8247.69 8868.19 9336.1 10464CONSUMESX 3035.59 3228.71 3267.7 3492.98 3941.87 4123.01 4710.96CONSUMETJ 4679.61 5204.15 5471.01 5851.53 6121.04 6987.22 7191.96CONSUMEZJ 5764.27 6170.14 6217.93 6521.54 7020.22 7952.39 8713.08表9.2 1996—2002年中国东北、华北、华东15个省级地区的居民家庭人均收入(元)数据人均收入1996 1997 1998 1999 2000 2001 2002INCOMEAH 4512.77 4599.27 4770.47 5064.6 5293.55 5668.8 6032.4INCOMEBJ 7332.01 7813.16 8471.98 9182.76 10349.69 11577.78 12463.92INCOMEFJ 5172.93 6143.64 6485.63 6859.81 7432.26 8313.08 9189.36INCOMEHB 4442.81 4958.67 5084.64 5365.03 5661.16 5984.82 6679.68INCOMEHLJ 3768.31 4090.72 4268.5 4595.14 4912.88 5425.87 6100.56INCOMEJL 3805.53 4190.58 4206.64 4480.01 4810 5340.46 6260.16INCOMEJS 5185.79 5765.2 6017.85 6538.2 6800.23 7375.1 8177.64INCOMEJX 3780.2 4071.32 4251.42 4720.58 5103.58 5506.02 6335.64INCOMELN 4207.23 4518.1 4617.24 4898.61 5357.79 5797.01 6524.52INCOMENMG 3431.81 3944.67 4353.02 4770.53 5129.05 5535.89 6051INCOMESD 4890.28 5190.79 5380.08 5808.96 6489.97 7101.08 7614.36INCOMESH 8178.48 8438.89 8773.1 10931.64 11718.01 12883.46 13249.8INCOMESX 3702.69 3989.92 4098.73 4342.61 4724.11 5391.05 6234.36INCOMETJ 5967.71 6608.39 7110.54 7649.83 8140.5 8958.7 9337.56INCOMEZJ 6955.79 7358.72 7836.76 8427.95 9279.16 10464.67 11715.6表9.3 1996—2002年中国东北、华北、华东15个省级地区的消费者物价指数(1)建立面板数据工作文件 首先建立工作文件。
EVIEWS面板数据分析操作教程及实例

获得S1,S2,S3后手工计算F2,F1,并查找临界值做出判定 请点:判定规则 请点 判定实例
27
模型形式检验步骤:注要手工计算
例10.5中系数 和 取何种形式可以利用模型形式设定检验方法 来确定。 (1) 首先分别计算3种形式的模型:变参数模型、变截距模 型和不变参数模型,在每个模型的回归统计量里可以得到相应 的残差平方和S1=339121.5、S2 = 444288.4 和S3 = 1570884。 (2) 按(10.2.7)式和(10.2.8)式计算F统计量,其中N=5、k=2、 T=20,得到的两个F统计量分别为: F1=((S2-S1)/8)/(S1 /85) = 3.29 F2=((S3-S1)/12)/(S1 /85) = 25.73 利用函数 @qfdist(d,k1,k2) 得到F分布的临界值,其中d 是临 界点,k1和k2是自由度。在给定5%的显著性水平下(d=0.95),得 到相应的临界值为: F2(12, 85) = 1.87 F1(8, 85) =2.049
16
表10.8 Johansen面板协整检验结果
(选择序列有确定性趋势而协整方程只有截距的情况) Fisher联合-max统计 量(p值) 128.7 (0.0000)* 65.74 (0.2266)
原假设
Fisher联合迹统计 量(p值) 133.4 (0.0000)* 65.74 (0.2266)
Kao检验 H0: = 1
除此项 外均支 持协整
Group-rho-Statistic -0.837712(0.2809) H0: = 1 Group PP-Statistic -6.990581(0.0000)* H1 :(i = )< 1 Group ADF-Statistic -7.194068(0.0000)*
计量学教程及eviews实现面板数据模型的分析
二、一般面板数据模型介绍
符 号 介 绍 : yit — — 因 变 量 在 横 截 面 i 和 时 间 t 上 的 数 值 ;
x
j it
——第 j 个解释变量在横截面 i 和时间 t 上的数值;
假设:有 K 个解释变量,即 j 1,2,, K ;
有 N 个横截面,即i 1,2,, N ;
时间指标 t 1,2,,T 。
ˆ
2 ˆ w
s 2 ( X P D X ) 1
s2
ˆ
2 ˆ
i
s2 T
X iˆ ˆw X i
其中 是对误差项方差的估计量:
( y it ˆ i x it ˆ w ) 2
s2 i t
NT ቤተ መጻሕፍቲ ባይዱN K
注意:在对误差项方差的估计量中,分母(NT-N-K)反映了整个
模型的自由度。有了这些方差的估计量,就可以用传统的t-统计量 对估计系数的显著性进行检验。同时,还可以运用下列F-统计量对
;
(7
)
2
E
(
2 i
),
i
。
给定这些假设,随机效应面板数据模型也可同样写为:
其中
(In
i )
y=X β +μ
, α 的 向 量 形 式 与 以 前 相 同 。
是 Kronecker 乘法 符 号。
例 2 Kronecker 乘 法 :
I2
i 21
i
21
0
0 i 21
例 3 前 面 的 矩 阵 D 也 可 用 Kronecker 乘 法 表 示 : D I N iT 1
记第 i 个横截面的数据为
yi1
yi
yi2
详细的EVIEWS面板数据分析操作
至少1个协整向量 65.74 (0.2266)
65.74 (0.2266)
注:加“*”表示在5%的显著性水平下拒绝原假设而接受备择假设。
上述检验结果检验的样本区间为1991-2003年,从表10.8和 表10.9的检验结果可以看出,我国29个省市的城镇居民消费和 收入的面板数据之间存在协整关系。
详细的EVIEWS面板数据分析操作
View/Spreadsheet View:i? m? k?
详细的EVIEWS面板数据分析操作
第二步 分析数据的平稳性(单位根检验) 请点 说明 请点 软件操作 结果 点检验结果1 结果2
详细的EVIEWS面板数据分析操作
分析数据的平稳性(单位根检验)说明 注:所有序列者要检验
原:不稳定(Hadri 除外, Hadri 中 原:稳定)
除此项 外均支 持协整
详细的EVIEWS面板数据分析操作
表10.8 Johansen面板协整检验结果
(选择序列有确定性趋势而协整方程只有截距的情况)
原假设
支
Fisher联合迹统计量 Fisher联合-max统计
持
(p值)
量(p值)
协Leabharlann 整0个协整向量133.4 (0.0000)*
128.7 (0.0000)*
此时不能进行协整检验与直接对原序列进行回归。
◎对序列进行差分或取对数使之变成同阶序列
若变换序列后均为平稳序列可用变换后的序列直接进行回归
思路二 若变换序列后均为同阶非平稳序列,则请点
详细的EVIEWS面板数据分析操作
思路二 变量之间是同阶单整:协整检验
请点协整检验说明 请点 软件操作 结果判定请点 1 2 3 协整检验通过:
基于EViews 6的面板数据计量分析
基于EViews 6的面板数据计量分析对于面板数据,EViews 6 提供的估计方法有如下三种,最小二乘估计——LS - Least Squares (and AR)二阶段最小二乘估计——TSLS - Two-Stage Least Squares (and AR)动态面板数据模型的广义矩估计——GMM / DPD - Generalized Method of Moments/Dynamic Panel Data第1节“LS - Least Squares (LS and AR)”估计如果选择最小二乘方法估计面板数据模型,在“Equation Estimation”窗口中,须依次设置“Specification”、“Panel Options”和“Options”页面。
1.1“Specification”页面在“Specification”页面中,完成模型设定和估计样本时间范围的选择。
1 在“Equation specification”编辑区,指定模型的被解释变量、截距项和解释变量;2 在“Sample”编辑区,指定估计样本时间的范围。
1.2“Panel Options”页面设置模型中不可观测的双(单)因素效应,即面板数据回归模型的选择。
点击“Panel Options”该页面包含三方面内容。
1 效应设置在“Effects specification”选择区,设定面板数据模型的个体效应和时间效应,可选择的选项有“None”、“Fixed”和“Random”,分别表示“无效应”、“固定效应”和“随机效应”。
如果选择了“Fixed”或“Random”,EViews在输出结果中自动添加一个共同常数,即截距项,以保证效应之和为零。
否则,截距项必要时,须在“Specification”页面的“Equation specification”编辑区设定模型截距项。
2 GLS加权设置“GLS Weights”可以在下拉框中选择如下选项之一。
Eviews6.0面板数据操作
E 【2 】views6.0面板数据操作一、数据输入1.创建工作文档.如下图操作,在”workfile create”文本框的“workfile structure type”选择“balanced panel”,”panel specification”的”start date”和”end date”输入数据的起止时代,”wf”输入工作文档的名称,点击”OK”即跳出新建的工作文档a界面.2.创建新对象.操作如下图.在”new object”文本框的”type of object”选择”pool”,”name for object ”输入新对象的名称.创建成功后的界面如下面第3张图所示.-3.输入数据.双击”workfile”界面的,跳出”pool”界面,输入个别.一般输入方法为如下:若上海输入_sh,北京输入_bj,….个别输入完成后,点击该界面的键,在跳出的”series list”输入变量名称,留意变量后要加问号.格局如下:y?x?.点击”OK”后,跳出数据输入界面,如下面第4张图所示.在这个界面上点击键,即可以输入或者从EXCEL处复制数据.在输入数据后,记得保存数据.保存操作如下:在跳出的“workfile save”文本框选择“ok”即可,则主动保存到我的文档.然后在“workfile”界面如下会显示保存路径:d:\my documents\a.wf1.若要保存到本身选择的路径下面,则在保存时选择“save as”,在跳出的文本框里选择本身要保存的路径以及定名文件名称.4.单位根磨练.一般回归前要磨练面板数据是否消失单位根,以磨练数据的安稳性,避免伪回归,或虚伪回归,确保估量的有用性.单位根磨练时要分变量磨练.(补充:网上对面板数据的单位根磨练和协整磨练消失不赞成见,一般以为时光区间较小的面板数据无需进行这两个磨练.)(1)生成数据组.如下图操作.点击”make group”后在跳出的”series list”里输入要单位根磨练的变量,完成后就会跳出如下图3所示的组数据.(2)生成时序图.如下图操作.在”graghoptions”界面的”specifi”下选择生成的时序图的外形,一般都默认设置,生成的时序图如下图3所示.不雅察时序图的趋向,以肯定单位根磨练的磨练模式.(3)单位根磨练.单位根磨练时,在”group unit root test”里的”test for root in”按磨练成果一步步磨练,假如原值”level”的磨练成果相符请求,即不消失单位根,则单位根磨练就不须要磨练下去了,假如不相符请求,则需持续磨练一阶差分”1stdifference”.二阶差分”2nd difference”.”include in test equation”是磨练模式的选择,依据上面时序图的外形来选择.从上面的时序图可以看出,原值的磨练模式应当选择含有截距项和趋向的磨练模式,即”include in test equation”选择”individual intercept and trend”.磨练成果如下图3所示.从磨练成果可以看出,磨练成果除了levin磨练办法外其他办法的成果都不相符请求(Prob.xx小于置信度(如0.05),则以为谢绝单位根的原假设,经由过程磨练).所以持续磨练一阶差分和二阶差分,直到磨练成果达到请求.假如变量原值序列经由过程单位根磨练,则称变量为0阶单整;假如变量一阶差分后的序列经由过程单位根磨练,则称变量为一阶单整,以此推之.留意:单位根磨练的办法(test type)较多,可以运用LLC.IPS.Breintung.ADF-Fisher 和PP-Fisher这5种办法进行面板单位根磨练.一般,为了便利起见,只采用雷同根单位根磨练LLC和不同根单位根磨练Fisher-ADF这两种磨练办法,假如它们都谢绝消失单位根的原假设,则可以以为此序列是安稳的,反之就长短安稳的.5.协整磨练.协整磨练磨练的是模子的变量之间是否消失长期稳固的关系,其前提是解释变量和被解释变量在单位根磨练时为同阶单整.操作如下图所示.6.回归估量面板数据模子依据常数项和系数向量是否为常数,分为3种类型:混杂回归模子(都为常数).变截距模子(系数项为常数)和变系数模子(皆异常数).混杂模子: itit it y x αβμ=++1,2,,;1,2,,i N t T == 变截距模子:iti it it y x αβμ=++1,2,,;1,2,,i N t T == 变系数模子:iti it i it y x αβμ=++1,2,,;1,2,,i N t T ==断定一个面板数据毕竟属于哪种模子,用F 统计统计量:()[]()2111()/11,(1)/(1)S S N K F F N K N T K S NT N K --⎡⎤⎣⎦=---⎡⎤⎣⎦-+()[]()3121()/1(1)1(1),(1)/(1)S S N K F F N K N T K S NT N K --+⎡⎤⎣⎦=-+--⎡⎤⎣⎦-+来磨练以下两个假设:121:N H βββ===,12122:,N N H αααβββ======.个中,1S .2S .3S 分离为变系数模子.变截距模子和混杂模子的残差平方和,K 为解释变量的个数,N 为截面个别数目,α为常数项,β为系数向量.若盘算得到的统计量2F 的值小于给定明显性程度下的响应临界值,则接收假设2H ,用混杂模子拟合样本.反之,则需用1F 磨练假设1H ,假如盘算得到的1F 值小于给定明显性程度下的响应临界值,则以为接收假设1H ,用变截距模子拟合,不然用变系数模子拟合.具体操作:1).分离对面板数据进行3种类型模子的回归,得到1S .2S .3S .此外,一般来说,用样本数据揣摸总体效应,运用随机效应回归模子;直接对样本数据进行剖析,采用固定效应回归模子. 起首回到面板数据表,假如是在如下这个界面时,点击按钮,在跳出的“series list”文本框里输入模子变量,如下图.也可以经由过程从新打开工作文件,如下图操作.选择本身当初保存的路径和文件名,点击打开.打开后,跳出工作文件双击,然后分离进行变系数.变截距和混杂模子的回归估量:点击,进行变系数回归(变系数)变截距回归混杂模子估量前面同2)操作,在“pool estimation”输入如下2).肯定模子情势把模子估量取得的s1.s2.s3数值代入前述公式(第13页),如下()[]()2111()/11,(1)/(1)S S N K F F N K N T K S NT N K --⎡⎤⎣⎦=---⎡⎤⎣⎦-+()[]()3121()/1(1)1(1),(1)/(1)S S N K F F N K N T K S NT N K --+⎡⎤⎣⎦=-+--⎡⎤⎣⎦-+盘算得到F1.F2值,磨练假设H1.H2,从而肯定采用何种模子情势(变系数.变截距.混杂效应).3).回归剖析若磨练成果表明应采用变系数模子,回到以下界面进行估量点击,进行变系数回归上图列示了回归成果,个中:①Coefficient为系数,比如AH的系数为0.760053,截距项为477.4820-315.8649②t-Statistic为t值,磨练每一个自变量的合理性.|t|大于临界值表示可谢绝系数为0的假设,即系数合理.Prob为系数的概率,若其小于置信度(如0.05)则表明|t|大于临界值,即以为系数合理.从成果可以看出,本例中系数合理.③R-squared为样本决议系数,表示总离差平方和中由回归方程可以解释部分的比例,比例越大解释回归方程可以解释的部分越多.值为0-1,越接近1表示拟合越好,>0.8以为可以接收,但是R2随因变量的增多而增大,所以可以经由过程增长自变量的个数来进步模子的R-squared.本例中R-squared0.995382,接近1,拟合度相当好.Adjust R-seqaured为修改的R-squared,与R-squared有类似意义.④F-statistic表示模子拟合样本的后果,即选择的所有自变量对因变量的解释力度.F大于临界值则解释谢绝0假设.若Prob(F-statistic)小于置信度(如0.05)则解释F大于临界值,方程明显性明显.本例中Prob(F-statistic)为0.000000, 模子方程明显.⑤Durbin-Watson stat:磨练残差序列的自相干性.其值在0-4之间._01_02_03_04_05_06_08 _09 _10 _11 _12 _13 _14 _15 _16 _17 _18 _19 _20 _21 _22 _23 _24 _25 _26 _27 _28 _29 _30 _31_33_34w? trade? ex? im? pr? mo? rc? tech? dex? dim? log(ex?) log(im?) log(pr?) log(mo?) rc? log(tech?)。