
数据挖掘原理、算法及应用第6章时间序列数据挖掘
数据挖掘教学大纲
数据挖掘教学大纲
引言概述:
数据挖掘是一门涉及数据分析和模式识别的学科,它通过挖掘数据中的隐藏模式和关联性,帮助我们从大量的数据中提取有价值的信息。因此,设计一份合理的数据挖掘教学大纲是非常重要的。本文将从五个大点出发,详细阐述数据挖掘教学大纲的内容。
正文内容:
1. 数据挖掘基础知识
1.1 数据挖掘概述:介绍数据挖掘的定义、目标和应用领域。
1.2 数据挖掘过程:详细阐述数据挖掘的步骤和流程,包括数据预处理、特征选择、模型建立和评估等。
1.3 数据挖掘算法:介绍常用的数据挖掘算法,如分类、聚类、关联规则等,并分析它们的原理和适用场景。
2. 数据预处理
2.1 数据清洗:讲解如何处理缺失值、异常值和重复值等数据问题。
2.2 数据集成:介绍如何将来自不同数据源的数据整合到一个数据集中。
2.3 数据变换:讲解如何对数据进行规范化、离散化和归一化等处理。
2.4 特征选择:详细介绍如何选择对数据挖掘任务有用的特征。
3. 数据挖掘算法
3.1 分类算法:介绍常用的分类算法,如决策树、朴素贝叶斯和支持向量机等,并分析它们的原理和应用场景。 3.2 聚类算法:讲解聚类算法的原理和常用方法,如K-means和层次聚类等。
3.3 关联规则挖掘:详细介绍关联规则挖掘的原理和算法,如Apriori和FP-Growth等。
3.4 预测算法:介绍常用的预测算法,如线性回归和时间序列分析等。
4. 模型评估与选择
4.1 模型评估指标:讲解常用的模型评估指标,如准确率、召回率和F1值等。
4.2 交叉验证:介绍交叉验证的原理和方法,如K折交叉验证和留一法等。
4.3 模型选择:详细阐述如何选择适合的模型,包括根据数据特点和任务需求进行选择。
5. 数据挖掘应用
5.1 金融领域:介绍数据挖掘在风险评估、信用评分和欺诈检测等方面的应用。
5.2 健康领域:讲解数据挖掘在疾病预测、医疗决策和基因分析等方面的应用。
《数据挖掘》试题与答案

一、解答题(满分30分,每小题5分)
1。 怎样理解数据挖掘和知识发现的关系?请详细阐述之
首先从数据源中抽取感兴趣的数据,并把它组织成适合挖掘的 数据组织形式;然后,调用相应的算法生成所需的知识;最后对生成的知识模式进行评估,并把有价值的知识集成到企业的智能系统中。
知识发现是一个指出数据中有效、崭新、潜在的、有价值的、一个不可忽视的流程,其最终目标是掌握数据的模式.流程步骤:先理解要应用的领域、熟悉相关知识,接着建立目标数据集,并专注所选择的数据子集;再作数据预处理,剔除错误或不一致的数据;然后进行数据简化与转换工作;再通过数据挖掘的技术程序成为模式、做回归分析或找出分类模型;最后经过解释和评价成为有用的信息。
2。 时间序列数据挖掘的方法有哪些,请详细阐述之
时间序列数据挖掘的方法有:
1)、确定性时间序列预测方法: 对于平稳变化特征的时间序列来说,假设未来行为与现在的行为有关,利用属性现在的值预测将来的值是可行的。例如,要预测下周某种商品的销售额,可以用最近一段时间的实际销售量来建立预测模型.
2)、 随机时间序列预测方法: 通过建立随机模型,对随机时间序列进行分析,可以预测未来值。若时间序列是平稳的,可以用自回归(Auto Regressive,简称AR)模型、移动回归模型(Moving Average,简称MA)或自回归移动平均(Auto
Regressive Moving Average,简称ARMA)模型进行分析预测.
3)、 其他方法: 可用于时间序列预测的方法很多,其中比较成功的是神经网络。由于大量的时间序列是非平稳的,因此特征参数和数据分布随着时间的推移而变化。假如通过对某段历史数据的训练,通过数学统计模型估计神经网络的各层权重参数初值,就可能建立神经网络预测模型,用于时间序列的预测.
3. 数据挖掘的分类方法有哪些,请详细阐述之
分类方法归结为四种类型:
数据挖掘中的现代时间序列分析方法
2007牟第7期
中图分类号:TP274 文献标识码:A 文章编号:1009—2552(2007)07—0100—02
数据挖掘中的现代时间序列分析方法
刘劲松
(黑龙江省信息中心,哈尔滨150001)
摘要:在比较了现代时间序列分析方法与传统时间序列分析方法优缺点基础上,认为现代时 间序列分析方法,是目前处理海量时间序列数据挖掘的一种新的非常适用的较好方法,具有一
定的推广和应用价值。同时提出在目前时间序列数据挖掘中,采用现代时间序列分析算法,全
面代替传统时间序列分析算法这一新的观点。 关键词:数据挖掘;现代时间序列分析;时变参数;自适应预测
Modern time series analysis method in data mining
LIU Jin—song (Heilongjiang Provincial Information Center,Harbin 150001,a ̄na) Abstract:This paper compares the modem time series analysis method with the traditional time series analysis
method based on the merits,it shows this method is a new application and good method for processing massive
time series in data mining has certain promotional and value.Meanwhile,in the current time series data mining, modem time series analysis atgo ̄thm fully replaces the traditional time series analysis t}lm.
数据挖掘技术简介
1. 引言
数据挖掘(Data Mining)是从大量的、不完全的、有噪声的、模糊的、随机的数据中提取隐含在其中的、人们事先不知道的、但又是潜在有用的信息和知识的过程。随着信息技术的高速发展,人们积累的数据量急剧增长,动辄以TB计,如何从海量的数据中提取有用的知识成为当务之急。数据挖掘就是为顺应这种需要应运而生发展起来的数据处理技术。是知识发现(Knowledge Discovery in Database)的关键步骤。
2. 数据挖掘的任务
数据挖掘的任务主要是关联分析、聚类分析、分类、预测、时序模式和偏差分析等。
⑴关联分析(association analysis)
关联规则挖掘是由Rakesh Apwal等人首先提出的。两个或两个以上变量的取值之间存在某种规律性,就称为关联。数据关联是数据库中存在的一类重要的、可被发现的知识。关联分为简单关联、时序关联和因果关联。关联分析的目的是找出数据库中隐藏的关联网。一般用支持度和可信度两个阀值来度量关联规则的相关性,还不断引入兴趣度、相关性等参数,使得所挖掘的规则更符合需求。
⑵聚类分析(clustering)
聚类是把数据按照相似性归纳成若干类别,同一类中的数据彼此相似,不同类中的数据相异。聚类分析可以建立宏观的概念,发现数据的分布模式,以及可能的数据属性之间的相互关系。
⑶分类(classification)
分类就是找出一个类别的概念描述,它代表了这类数据的整体信息,即该类的内涵描述,并用这种描述来构造模型,一般用规则或决策树模式表示。分类是利用训练数据集通过一定的算法而求得分类规则。分类可被用于规则描述和预测。
⑷预测(predication)
预测是利用历史数据找出变化规律,建立模型,并由此模型对未来数据的种类及特征进行预测。预测关心的是精度和不确定性,通常用预测方差来度量。
⑸时序模式(time-series pattern)
时序模式是指通过时间序列搜索出的重复发生概率较高的模式。与回归一样,它也是用己知的数据预测未来的值,但这些数据的区别是变量所处时间的不同。
数据挖掘概述
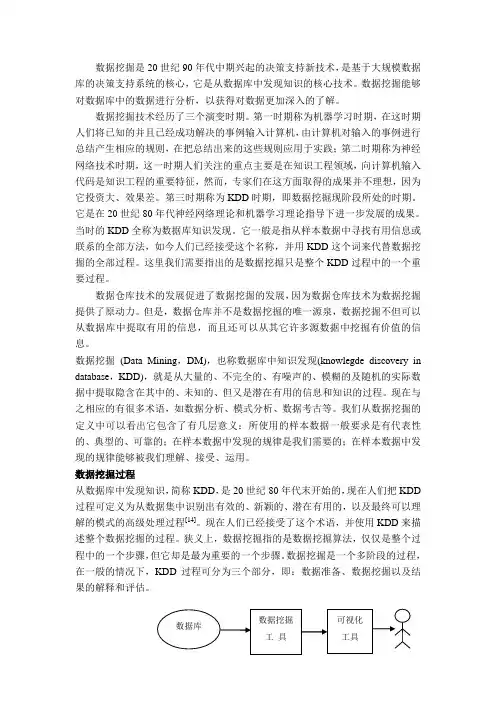
数据挖掘是20世纪90年代中期兴起的决策支持新技术,是基于大规模数据库的决策支持系统的核心,它是从数据库中发现知识的核心技术。数据挖掘能够对数据库中的数据进行分析,以获得对数据更加深入的了解。
数据挖掘技术经历了三个演变时期。第一时期称为机器学习时期,在这时期人们将已知的并且已经成功解决的事例输入计算机,由计算机对输入的事例进行总结产生相应的规则,在把总结出来的这些规则应用于实践;第二时期称为神经网络技术时期,这一时期人们关注的重点主要是在知识工程领域,向计算机输入代码是知识工程的重要特征,然而,专家们在这方面取得的成果并不理想,因为它投资大、效果差。第三时期称为KDD时期,即数据挖掘现阶段所处的时期。它是在20世纪80年代神经网络理论和机器学习理论指导下进一步发展的成果。当时的KDD全称为数据库知识发现。它一般是指从样本数据中寻找有用信息或联系的全部方法,如今人们已经接受这个名称,并用KDD这个词来代替数据挖掘的全部过程。这里我们需要指出的是数据挖掘只是整个KDD过程中的一个重要过程。
数据仓库技术的发展促进了数据挖掘的发展,因为数据仓库技术为数据挖掘提供了原动力。但是,数据仓库并不是数据挖掘的唯一源泉,数据挖掘不但可以从数据库中提取有用的信息,而且还可以从其它许多源数据中挖掘有价值的信息。
数据挖掘 (Data Mining,DM),也称数据库中知识发现(knowlegde discovery in
database,KDD),就是从大量的、不完全的、有噪声的、模糊的及随机的实际数据中提取隐含在其中的、未知的、但又是潜在有用的信息和知识的过程。现在与之相应的有很多术语,如数据分析、模式分析、数据考古等。我们从数据挖掘的定义中可以看出它包含了有几层意义:所使用的样本数据一般要求是有代表性的、典型的、可靠的;在样本数据中发现的规律是我们需要的;在样本数据中发现的规律能够被我们理解、接受、运用。
数据挖掘导论课后习题答案
数据挖掘导论课后习题答案
数据挖掘导论课后习题答案
数据挖掘是一门涉及统计学、机器学习和数据库技术的跨学科领域,旨在从大量的数据中发现有价值的信息和模式。在这门课程中,学生将学习数据挖掘的基本概念、方法和技术,并通过习题的解答来加深对这些概念的理解和应用。下面是一些常见的数据挖掘导论课后习题及其答案,供学生参考。
1. 什么是数据挖掘?数据挖掘的目标是什么?
答:数据挖掘是从大量的数据中提取出有用的信息和模式的过程。其目标是发现隐藏在数据背后的知识和规律,以便支持决策和预测。
2. 数据挖掘的主要任务有哪些?
答:数据挖掘的主要任务包括分类、聚类、关联规则挖掘、异常检测和预测等。分类是将数据分为不同的类别;聚类是将数据分为相似的群组;关联规则挖掘是发现数据中的关联关系;异常检测是识别与其他数据不同的异常数据;预测是根据已有的数据来预测未来的趋势。
3. 数据挖掘的过程包括哪些步骤?
答:数据挖掘的过程一般包括问题定义、数据收集、数据预处理、特征选择、模型建立、模型评估和结果解释等步骤。问题定义是明确挖掘的目标和需求;数据收集是获取相关数据;数据预处理是对数据进行清洗、集成、转换和规约;特征选择是选择对挖掘任务有用的特征;模型建立是选择合适的模型并进行训练;模型评估是评估模型的性能;结果解释是对挖掘结果进行解释和应用。
4. 什么是分类算法?常见的分类算法有哪些?
答:分类算法是将数据分为不同类别的算法。常见的分类算法包括决策树、朴素贝叶斯、支持向量机和神经网络等。决策树通过构建树状结构来进行分类;朴素贝叶斯基于贝叶斯定理进行分类;支持向量机通过寻找最优超平面进行分类;神经网络模拟人脑神经元的工作原理进行分类。
5. 什么是聚类算法?常见的聚类算法有哪些?
答:聚类算法是将数据分为相似群组的算法。常见的聚类算法包括K均值聚类、层次聚类和DBSCAN等。K均值聚类通过将数据分为K个簇来进行聚类;层次聚类通过构建树状结构来进行聚类;DBSCAN基于密度的聚类算法,将高密度区域看作簇。
基于时间序列的聚类分析方法研究
基于时间序列的聚类分析方法研究
一、引言
随着数据量不断增加,人们对数据挖掘算法的需求越来越高。而数据挖掘算法中的聚类分析方法可以帮助人们在数据量较大的情况下,快速发现数据的规律和特征。其中,基于时间序列的聚类分析方法是一种在时间序列中搜索重复模式并进行聚类分析的方法。本文将介绍基于时间序列的聚类分析方法的定义、流程、算法等内容。
二、基于时间序列的聚类分析方法的定义
基于时间序列的聚类分析方法是一种利用时间对数据进行分类的方法。通过寻找时间序列中的规律和相似性,可以将相似的时间序列进行聚类,以便发现数据的规律和特征。
三、基于时间序列的聚类分析方法的流程
1. 数据准备:首先,需要将原始时间序列进行数据清洗和预处理,对数据进行标准化、归一化等操作,以便后续处理。
2. 相似度计算:对于时间序列中的每个子序列,需要计算与其他子序列的相似度。常用的相似度计算方法包括欧氏距离、曼哈顿距离等。 3. 聚类算法:可以使用常见的聚类算法,如K-means、DBSCAN等,对相似的时间序列进行聚类分析。
4. 结果评估:对聚类结果进行评估,可以使用聚类有效性指标,如轮廓系数,来评估聚类的质量。
四、基于时间序列的聚类分析方法的算法
1. K-means算法
K-means算法是基于距离的聚类算法,它将数据分为K个簇,使每个数据点到其所属的簇内的所有数据点的距离之和最小化。该算法的具体步骤为:
(1)随机选择K个初始中心点。
(2)计算每个数据点到中心点的距离,并将其分配到最近的簇中。
(3)更新每个簇的中心点。
(4)重复第2和3步,直到中心点不再改变或达到预定的迭代次数。
2. DBSCAN算法
DBSCAN算法是一种密度聚类算法,它将数据分为若干个簇,这些簇由密集的数据点组成,并且簇与簇之间较为稀疏。该算法的具体步骤为: (1)选取一个未访问的核心点。
(2)找出与该核心点密度可达的所有点,加入到该簇中。
数据挖掘教学大纲 2
数据挖掘教学大纲
一、课程概述
数据挖掘是从大量数据中发现有价值的信息和知识的过程。本课程旨在介绍数据挖掘的基本概念、方法和技术,培养学生在实际问题中运用数据挖掘技术解决问题的能力。
二、教学目标
1. 理解数据挖掘的基本概念和原理;
2. 掌握数据挖掘的常用方法和技术;
3. 学会运用数据挖掘工具进行数据挖掘分析;
4. 培养学生的数据挖掘实践能力。
三、教学内容
1. 数据挖掘概述
1.1 数据挖掘的定义和应用领域;
1.2 数据挖掘的基本任务和流程;
1.3 数据挖掘的技术和工具。
2. 数据预处理
2.1 数据清洗:处理缺失值、异常值和重复值;
2.2 数据集成:合并多个数据源的数据;
2.3 数据变换:对数据进行规范化、离散化和归一化处理; 2.4 数据降维:使用主成份分析等方法减少数据维度。
3. 数据挖掘方法
3.1 分类:决策树、朴素贝叶斯、支持向量机等;
3.2 聚类:K均值、层次聚类、DBSCAN等;
3.3 关联规则挖掘:Apriori算法、FP-Growth算法等;
3.4 时间序列分析:ARIMA模型、指数平滑法等。
4. 模型评估与选择
4.1 模型评估指标:准确率、召回率、F1值等;
4.2 交叉验证:K折交叉验证、留一法等;
4.3 模型选择:过拟合与欠拟合的判断。
5. 数据挖掘应用案例
5.1 电商推荐系统;
5.2 社交网络分析;
5.3 医疗数据挖掘;
5.4 金融风控分析。
四、教学方法
1. 理论授课:通过讲解理论知识,介绍数据挖掘的基本概念和方法;
2. 案例分析:通过实际案例,讲解数据挖掘在不同领域的应用;
3. 实践操作:引导学生使用数据挖掘工具进行实际数据挖掘分析; 4. 课堂讨论:组织学生讨论数据挖掘方法和技术的优缺点。
五、考核方式
头歌实践教学数据挖掘(3篇)
第1篇
摘要:随着信息技术的飞速发展,数据挖掘技术已经成为当今社会的重要技术之一。在头歌实践教学过程中,数据挖掘技术能够帮助我们更好地理解和分析数据,提高教学效果。本文将从数据挖掘的基本概念、在头歌实践教学中的应用以及实施策略等方面进行探讨。
一、引言
数据挖掘是指从大量数据中提取有价值信息的过程。在头歌实践教学过程中,数据挖掘技术可以帮助教师和学生更好地理解教学数据,发现教学过程中的问题和不足,从而提高教学质量。本文旨在探讨数据挖掘在头歌实践教学中的应用及其实施策略。
二、数据挖掘的基本概念
1. 数据挖掘的定义
数据挖掘是指利用统计学、机器学习、数据库等技术,从大量数据中提取有价值信息的过程。它旨在发现数据中的规律、趋势和模式,为决策提供支持。
2. 数据挖掘的方法
数据挖掘的方法主要包括以下几种:
(1)关联规则挖掘:通过挖掘数据中的关联规则,发现不同属性之间的关系。
(2)分类挖掘:将数据分为不同的类别,预测新数据的类别。
(3)聚类挖掘:将相似的数据归为一类,发现数据中的自然分组。
(4)异常检测:识别数据中的异常值,分析其产生的原因。
三、数据挖掘在头歌实践教学中的应用
1. 教学资源分析
通过对教学资源的分析,可以了解教学资源的使用情况,为教学资源的优化提供依据。例如,通过关联规则挖掘,发现哪些教学资源被学生频繁使用,哪些资源使用率较低,从而调整教学资源分配。
2. 学生学习行为分析 通过对学生学习行为的分析,可以了解学生的学习特点、学习需求和存在的问题。例如,通过分类挖掘,将学生分为不同的学习类型,针对不同类型的学生制定个性化的教学策略。
3. 教学效果评估
通过数据挖掘技术,可以对教学效果进行评估。例如,利用聚类挖掘,将学生按照学习效果分为不同的群体,分析不同群体之间的差异,为教学改进提供参考。
4. 教学资源推荐
根据学生的学习特点和需求,利用数据挖掘技术为学生推荐合适的教学资源。例如,通过关联规则挖掘,为学生推荐与其学习兴趣相关的课程、资料等。
基于滑动窗口的时间序列离群数据挖掘
第32卷第6期 2008年11月 燕山大学学报 Journal ofYanshan University 、,o1.32 NO.6 NOV. 2008
文章编号:1007—791X(2008)06-0483-04
基于滑动窗口的时间序列离群数据挖掘
张 宁
(1.燕山大学信息科学与工程学院,河北秦皇岛066004)
摘 要:离群数据挖掘是数据挖掘中的重要内容。本文针对时间序列数据进行离群数据挖掘方法的研究。在引 入了基于局部离群点因子的离群数据挖掘方法与时间序列上滑动窗口基础上,将二者相结合,提出了基于滑动 窗口的时间序列离群数据挖掘算法,并将算法应用于海表温度数据得到海表温度的异常之处。
关键词:局部离群点因子;滑动窗口;时间序列;离群数据挖掘
中图分类号:TP311.13 文献标识码:A
0引言
时间序列数据挖掘,是数据挖掘中的一个重要
分支。目前时问序列数据挖掘主要集中于时序数据
相似性挖掘等的研究…,对于离群数据,通常将其
忽略。然而时间序列数据中的离群数据能够使人们
发现时序数据中更有用的信息,如网络入侵的检
测,灾难天气的预测等,都具有一定的实际应用价
值,因此也越来越受到人们的重视。
Hawkins最早给出了异常点(离群点或孤立
点)的本质性定义口 。统计学领域对离群数据进行
了最早的研究 ,但此方法应用时需事先知道数据
集的分布及分布参数等信息,而确定这些参数通常
都比较困难。Arning等 提出了一种基于偏离的 离群数据挖掘方法,但如果相异函数的选取不合
适,得到的离群挖掘结果很可能不尽人意。Knorr
和Ng 提出基于距离的离群数据挖掘方法,此方
法比较接近Hawkins对离群数据本质的定义,理
论上可以处理任意维任意类型的数据,但需要通过
实验确定合适的基准值和距离范围。Breuning 提
出了局部异常的概念及基于密度的离群数据挖掘
算法,此方法更贴近Hawkins对离群数据本质的