
模式识别第二版答案完整版
模式识别期末考试题及答案
模式识别期末考试题及答案一、选择题(每题2分,共20分)1. 以下哪一项不是模式识别的主要任务?A. 分类B. 回归C. 聚类D. 预测答案:B2. 以下哪一种方法不属于统计模式识别方法?A. 最小二乘法B. 感知机C. 支持向量机D. 决策树答案:A3. 在模式识别中,以下哪种技术用于降低特征维度?A. 主成分分析(PCA)B. 线性判别分析(LDA)C. 神经网络D. K-均值聚类答案:A4. 以下哪一种模式识别方法适用于非线性问题?A. 线性判别分析(LDA)B. 支持向量机(SVM)C. 主成分分析(PCA)D. K-最近邻(K-NN)答案:B5. 以下哪一项不是模式识别的评价指标?A. 准确率B. 精确率C. 召回率D. 信息熵答案:D二、填空题(每题2分,共20分)6. 模式识别的主要任务包括分类、回归、聚类和________。
答案:预测7. 统计模式识别方法包括最小二乘法、感知机、________和决策树。
答案:支持向量机8. 主成分分析(PCA)的主要目的是________特征。
答案:降低维度9. 在模式识别中,________用于将样本分为不同的类别。
答案:分类器10. 支持向量机(SVM)的基本思想是找到一个________,使得不同类别的样本之间的间隔最大化。
答案:最优分割超平面三、简答题(每题10分,共30分)11. 请简述模式识别的主要步骤。
答案:(1)数据预处理:对原始数据进行清洗、标准化和降维等处理。
(2)特征提取:从原始数据中提取有助于分类的特征。
(3)模型训练:使用训练集对分类器进行训练。
(4)模型评估:使用测试集对分类器的性能进行评估。
(5)模型优化:根据评估结果对模型进行调整和优化。
12. 请简述支持向量机(SVM)的基本原理。
支持向量机是一种二分类模型,其基本思想是找到一个最优分割超平面,使得不同类别的样本之间的间隔最大化。
SVM通过求解一个凸二次规划问题来寻找最优分割超平面,从而实现分类任务。
模式识别答案复习课程

模式识别答案模式识别试题二答案问答第1题答:在模式识别学科中,就“模式”与“模式类”而言,模式类是一类事物的代表,概念或典型,而“模式”则是某一事物的具体体现,如“老头”是模式类,而王先生则是“模式”,是“老头”的具体化。
问答第2题答:Mahalanobis距离的平方定义为:其中x,u为两个数据,是一个正定对称矩阵(一般为协方差矩阵)。
根据定义,距某一点的Mahalanobis距离相等点的轨迹是超椭球,如果是单位矩阵Σ,则Mahalanobis距离就是通常的欧氏距离。
问答第3题答:监督学习方法用来对数据实现分类,分类规则通过训练获得。
该训练集由带分类号的数据集组成,因此监督学习方法的训练过程是离线的。
非监督学习方法不需要单独的离线训练过程,也没有带分类号(标号)的训练数据集,一般用来对数据集进行分析,如聚类,确定其分布的主分量等。
就道路图像的分割而言,监督学习方法则先在训练用图像中获取道路象素与非道路象素集,进行分类器设计,然后用所设计的分类器对道路图像进行分割。
使用非监督学习方法,则依据道路路面象素与非道路象素之间的聚类分析进行聚类运算,以实现道路图像的分割。
问答第4题答:动态聚类是指对当前聚类通过迭代运算改善聚类;分级聚类则是将样本个体,按相似度标准合并,随着相似度要求的降低实现合并。
问答第5题答:在给定观察序列条件下分析它由某个状态序列S产生的概率似后验概率,写成P(S|O),而通过O求对状态序列的最大似然估计,与贝叶斯决策的最小错误率决策相当。
问答第6题答:协方差矩阵为,则1)对角元素是各分量的方差,非对角元素是各分量之间的协方差。
2)主分量,通过求协方差矩阵的特征值,用得,则,相应的特征向量为:,对应特征向量为,对应。
这两个特征向量即为主分量。
3) K-L变换的最佳准则为:对一组数据进行按一组正交基分解,在只取相同数量分量的条件下,以均方误差计算截尾误差最小。
4)在经主分量分解后,协方差矩阵成为对角矩阵,因而各主分量间相关消除。
模式识别习题集答案解析

模式识别习题集答案解析1、PCA和LDA的区别?PCA是⼀种⽆监督的映射⽅法,LDA是⼀种有监督的映射⽅法。
PCA只是将整组数据映射到最⽅便表⽰这组数据的坐标轴上,映射时没有利⽤任何数据部的分类信息。
因此,虽然做了PCA后,整组数据在表⽰上更加⽅便(降低了维数并将信息损失降到了最低),但在分类上也许会变得更加困难;LDA在增加了分类信息之后,将输⼊映射到了另外⼀个坐标轴上,有了这样⼀个映射,数据之间就变得更易区分了(在低纬上就可以区分,减少了很⼤的运算量),它的⽬标是使得类别的点距离越近越好,类别间的点越远越好。
2、最⼤似然估计和贝叶斯⽅法的区别?p(x|X)是概率密度函数,X是给定的训练样本的集合,在哪种情况下,贝叶斯估计接近最⼤似然估计?最⼤似然估计把待估的参数看做是确定性的量,只是其取值未知。
利⽤已知的样本结果,反推最有可能(最⼤概率)导致这样结果的参数值(模型已知,参数未知)。
贝叶斯估计则是把待估计的参数看成是符合某种先验概率分布的随机变量。
对样本进⾏观测的过程,把先验概率密度转化为后验概率密度,利⽤样本的信息修正了对参数的初始估计值。
当训练样本数量趋于⽆穷的时候,贝叶斯⽅法将接近最⼤似然估计。
如果有⾮常多的训练样本,使得p(x|X)形成⼀个⾮常显著的尖峰,⽽先验概率p(x)⼜是均匀分布,此时两者的本质是相同的。
3、为什么模拟退⽕能够逃脱局部极⼩值?在解空间随机搜索,遇到较优解就接受,遇到较差解就按⼀定的概率决定是否接受,这个概率随时间的变化⽽降低。
实际上模拟退⽕算法也是贪⼼算法,只不过它在这个基础上增加了随机因素。
这个随机因素就是:以⼀定的概率来接受⼀个⽐单前解要差的解。
通过这个随机因素使得算法有可能跳出这个局部最优解。
4、最⼩错误率和最⼩贝叶斯风险之间的关系?基于最⼩风险的贝叶斯决策就是基于最⼩错误率的贝叶斯决策,换⾔之,可以把基于最⼩错误率决策看做是基于最⼩风险决策的⼀个特例,基于最⼩风险决策本质上就是对基于最⼩错误率公式的加权处理。
模式识别(山东联盟)智慧树知到课后章节答案2023年下青岛大学
模式识别(山东联盟)智慧树知到课后章节答案2023年下青岛大学青岛大学第一章测试1.关于监督模式识别与非监督模式识别的描述正确的是答案:非监督模式识别对样本的分类结果是唯一的2.基于数据的方法适用于特征和类别关系不明确的情况答案:对3.下列关于模式识别的说法中,正确的是答案:模式可以看作对象的组成成分或影响因素间存在的规律性关系4.在模式识别中,样本的特征构成特征空间,特征数量越多越有利于分类答案:错5.在监督模式识别中,分类器的形式越复杂,对未知样本的分类精度就越高答案:错第二章测试1.下列关于最小风险的贝叶斯决策的说法中正确的有答案:条件风险反映了对于一个样本x采用某种决策时所带来的损失;最小风险的贝叶斯决策考虑到了不同的错误率所造成的不同损失;最小错误率的贝叶斯决策是最小风险的贝叶斯决策的特例2.我们在对某一模式x进行分类判别决策时,只需要算出它属于各类的条件风险就可以进行决策了。
答案:对3.下面关于贝叶斯分类器的说法中错误的是答案:贝叶斯分类器中的判别函数的形式是唯一的4.当各类的协方差矩阵相等时,分类面为超平面,并且与两类的中心连线垂直。
答案:错5.当各类的协方差矩阵不等时,决策面是超二次曲面。
答案:对第三章测试1.概率密度函数的估计的本质是根据训练数据来估计概率密度函数的形式和参数。
答案:对2.参数估计是已知概率密度的形式,而参数未知。
答案:对3.概率密度函数的参数估计需要一定数量的训练样本,样本越多,参数估计的结果越准确。
答案:对4.下面关于最大似然估计的说法中正确的是答案:在最大似然函数估计中,要估计的参数是一个确定的量。
;在最大似然估计中要求各个样本必须是独立抽取的。
;最大似然估计是在已知概率密度函数的形式,但是参数未知的情况下,利用训练样本来估计未知参数。
5.贝叶斯估计中是将未知的参数本身也看作一个随机变量,要做的是根据观测数据对参数的分布进行估计。
答案:对第四章测试1.多类问题的贝叶斯分类器中判别函数的数量与类别数量是有直接关系的。
中科院模式识别第二次作业参考答案
4
当 2 3 时,有:
Q( , 0 ) 不存在。
对分布进行归一化,有 P ( x2 ) ~ U (0, 2 ) ,故
P( x )dx
2
2
1
对 P ( x1 ) ,有
p( x1 )dx1
0 0
1
1
e 1x1 dx1 1
因此, 1 1 。
2
1 ( x )2 1 1 x v 2 exp 2 2 nh 2 hn 2 2 hn 2 n 2 hn hn hn nhn hn nhn 1 ( x )2 exp 2 2 2 2 hn 2 2 hn 1 1 ( x )2 1 exp 2 2 2
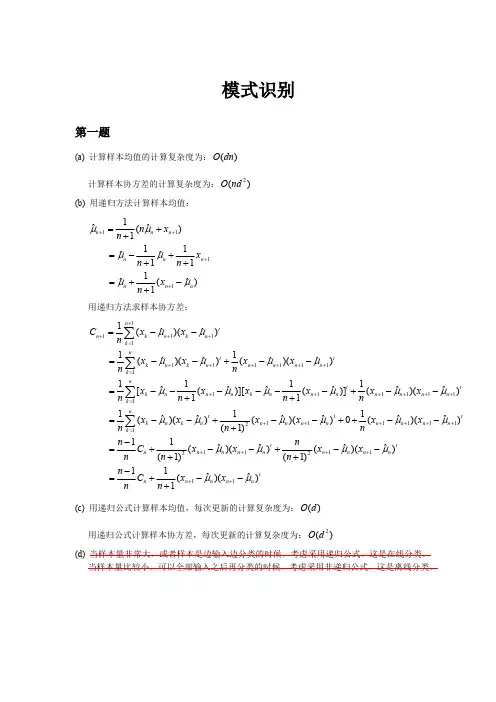
(c) 用递归公式计算样本均值,每次更新的计算复杂度为: O ( d ) 用递归公式计算样本协方差,每次更新的计算复杂度为: O ( d ) (d) 当样本量非常大,或者样本是边输入边分类的时候,考虑采用递归公式,这是在线分类。 当样本量比较小,可以全部输入之后再分类的时候,考虑采用非递归公式,这是离线分类。
2
2
)1 。
当 1 1, 2 3 时,取得最大值: Q ( , 0 ) 8.52 故,当 3 时, Q( , 0 ) 取得最大值。
1
1 2 x1 2 e (c) 当 4 时,有 P ( x1 , x2 ) 8 0
因此: pn ( x) ~ N ( , hn )
(b) 计算得:
Var [ pn ( x)] Var [
1 nhn
模式识别试题答案最终版【范本模板】

模式识别非学位课考试试题考试科目:模式识别考试时间考生姓名: 考生学号任课教师考试成绩一、简答题(每题6分,12题共72分):1、监督学习和非监督学习有什么区别?参考答案:监督学习与非监督学习的区别:监督学习方法用来对数据实现分类,分类规则通过训练获得。
该训练集由带分类号的数据集组成,因此监督学习方法的训练过程是离线的.非监督学习方法不需要单独的离线训练过程,也没有带分类号(标号)的训练数据集,一般用来对数据集进行分析,如聚类,确定其分布的主分量等.2、你如何理解特征空间?表示样本有哪些常见方法?参考答案:由利用某些特征描述的所有样本组成的集合称为特征空间或者样本空间,特征空间的维数是描述样本的特征数量。
描述样本的常见方法:矢量、矩阵、列表等。
3、什么是分类器?有哪些常见的分类器?参考答案:将特征空中的样本以某种方式区分开来的算法、结构等。
例如:贝叶斯分类器、神经网络等。
4、进行模式识别在选择特征时应该注意哪些问题?参考答案:特征要能反映样本的本质;特征不能太少,也不能太多;要注意量纲。
5、聚类分析中,有哪些常见的表示样本相似性的方法?参考答案:距离测度、相似测度和匹配测度。
距离测度例如欧氏距离、绝对值距离、明氏距离、马氏距离等。
相似测度有角度相似系数、相关系数、指数相似系数等。
6、SVM的主要思想可以概括为两点:(1)它是针对线性可分情况进行分析,对于线性不可分的情况,通过使用非线性映射算法将低维输入空间线性不可分的样本转化为高维特征空间使其线性可分,从而使得高维特征空间采用线性算法对样本的非线性特征进行线性分析成为可能;(2)它基于结构风险最小化理论之上在特征空间中建构最优分割超平面,使得学习器得到全局最优化,并且在整个样本空间的期望风险以某个概率满足一定上界。
7、请论述模式识别系统的主要组成部分及其设计流程,并简述各组成部分中常用方法的主要思想。
特征空间信息获取:通过测量、采样和量化,可以用矩阵或向量表示二维图像或以为波形。
(完整word版)模式识别题目及答案(word文档良心出品)
一、(15分)设有两类正态分布的样本集,第一类均值为T1μ=(2,0),方差11⎡⎤∑=⎢⎥⎣⎦11/21/2,第二类均值为T2μ=(2,2),方差21⎡⎤∑=⎢⎥⎣⎦1-1/2-1/2,先验概率12()()p p ωω=,试求基于最小错误率的贝叶斯决策分界面。
解 根据后验概率公式()()()()i i i p x p p x p x ωωω=, (2’)及正态密度函数11/21()exp[()()/2]2T i i i i nip x x x ωμμπ-=--∑-∑ ,1,2i =。
(2’) 基于最小错误率的分界面为1122()()()()p x p p x p ωωωω=, (2’) 两边去对数,并代入密度函数,得1111112222()()/2ln ()()/2ln T T x x x x μμμμ----∑--∑=--∑--∑ (1) (2’)由已知条件可得12∑=∑,114/3-⎡⎤∑=⎢⎥⎣⎦4/3-2/3-2/3,214/3-⎡⎤∑=⎢⎥⎣⎦4/32/32/3,(2’)设12(,)Tx x x =,把已知条件代入式(1),经整理得1221440x x x x --+=, (5’)二、(15分)设两类样本的类内离散矩阵分别为11S ⎡⎤=⎢⎥⎣⎦11/21/2, 21S ⎡⎤=⎢⎥⎣⎦1-1/2-1/2,各类样本均值分别为T 1μ=(1,0),T2μ=(3,2),试用fisher 准则求其决策面方程,并判断样本Tx =(2,2)的类别。
解:122S S S ⎡⎤=+=⎢⎥⎣⎦200 (2’) 投影方向为*112-2-1()211/2w S μμ-⎡⎤⎡⎤⎡⎤=-==⎢⎥⎢⎥⎢⎥--⎣⎦⎣⎦⎣⎦1/200 (6’)阈值为[]*0122()/2-1-131T y w μμ⎡⎤=+==-⎢⎥⎣⎦(4’)给定样本的投影为[]*0-12241T y w x y ⎡⎤===-<⎢⎥-⎣⎦, 属于第二类 (3’)三、 (15分)给定如下的训练样例实例 x0 x1 x2 t(真实输出) 1 1 1 1 1 2 1 2 0 1 3 1 0 1 -1 4 1 1 2 -1用感知器训练法则求感知器的权值,设初始化权值为0120w w w ===;1 第1次迭代(4’)2 第2次迭代(2’)3 第3和4次迭代四、 (15分)i. 推导正态分布下的最大似然估计;ii. 根据上步的结论,假设给出如下正态分布下的样本{}1,1.1,1.01,0.9,0.99,估计该部分的均值和方差两个参数。
模式识别_作业2
作业一:在一个10类的模式识别问题中,有3类单独满足多类情况1,其余的类别满足多类情况2。
问该模式识别问题所需判别函数的最少数目是多少?答案:将10类问题可看作4类满足多类情况1的问题,可将3类单独满足多类情况1的类找出来,剩下的7类全部划到4类中剩下的一个子类中。
再在此子类中,运用多类情况2的判别法则进行分类,此时需要7*(7-1)/2=21个判别函数。
故共需要4+21=25个判别函数。
作业二:一个三类问题,其判别函数如下:d1(x)=-x1, d2(x)=x1+x2-1, d3(x)=x1-x2-11. 设这些函数是在多类情况1条件下确定的,绘出其判别界面和每一个模式类别的区域。
2. 设为多类情况2,并使:d12(x)= d1(x), d13(x)= d2(x), d23(x)=d3(x)。
绘出其判别界面和多类情况2的区域。
3. 设d1(x), d2(x)和d3(x)是在多类情况3的条件下确定的,绘出其判别界面和每类的区域。
答案:123作业三:两类模式,每类包括5个3维不同的模式,且良好分布。
如果它们是线性可分的,问权向量至少需要几个系数分量?假如要建立二次的多项式判别函数,又至少需要几个系数分量?(设模式的良好分布不因模式变化而改变。
)答案:如果它们是线性可分的,则至少需要4个系数分量;如果要建立二次的多项式判别函数,则至少需要个系数分量。
作业四:用感知器算法求下列模式分类的解向量w:ω1: {(0 0 0)T, (1 0 0)T, (1 0 1)T, (1 1 0)T}ω2: {(0 0 1)T, (0 1 1)T, (0 1 0)T, (1 1 1)T}答案:将属于ω2的训练样本乘以(-1),并写成增广向量的形式。
x①=(0 0 0 1)T,x②=(1 0 0 1)T,x③=(1 0 1 1)T,x④=(1 1 0 1)Tx⑤=(0 0 -1 -1)T,x⑥=(0 -1 -1 -1)T,x⑦=(0 -1 0 -1)T,x⑧=(-1 -1 -1 -1)T第一轮迭代:取C=1,w(1)=(0 0 0 0)T因wT(1)x① =(0 0 0 0)(0 0 0 1)T=0≯0,故w(2)=w(1)+x①=(0 0 0 1)因wT(2)x②=(0 0 0 1)(1 0 0 1)T =1>0,故w(3)=w(2)=(0 0 0 1)T因wT(3)x③=(0 0 0 1)(1 0 1 1)T=1>0,故w(4)=w(3)=(0 0 0 1)T因wT(4)x④=(0 0 0 1)(1 1 0 1)T=1>0,故w(5)=w(4)=(0 0 0 1)T因wT(5)x⑤=(0 0 0 1)(0 0 -1 -1)T=-1≯0,故w(6)=w(5)+x⑤=(0 0 -1 0)T因wT(6)x⑥=(0 0 -1 0)(0 -1 -1 -1)T=1>0,故w(7)=w(6)=(0 0 -1 0)T因wT(7)x⑦=(0 0 -1 0)(0 -1 0 -1)T=0≯0,故w(8)=w(7)+x⑦=(0 -1 -1 -1)T因wT(8)x⑧=(0 -1 -1 -1)(-1 -1 -1 -1)T=3>0,故w(9)=w(8)=(0 -1 -1 -1)T因为只有对全部模式都能正确判别的权向量才是正确的解,因此需进行第二轮迭代。
模式识别思考题答案
X ( NT ) 两部分,这两部分没有公共元素,它们的样本数各为 NR 和 NT,NR+NT=N。利用参照
集X
( NR)
中的样本 y1 , y2 ,, y NR 采用最近邻规则对已知类别的测试集 X
( NT )
中的每个样
x1 , x2 ,, xNT 进行分类,剪辑掉 X ( NT ) 中被错误分类的样本。
k=10, x k =x 2 ,d ( x k ) =w(k)' xk =2>0, w(11)= w(10)
k=11, x k =x3 ,d ( x k ) =w(k)' xk =0, w(12)= w(11)+x3 (2, 3, 1,2)
k=12, x k =x 4 ,d ( x k ) =w(k)' xk =1>0, w(13)= w(12) k=13, x k =x5 ,d ( x k ) =w(k)' xk =-1<0, w(14)= w(13)+x 5 (2, 3, 2)
x2
W2
+ W1
x
Hale Waihona Puke 1d 23 (x)=2x 2
-
W3
+
-
d13 ( x) 2 x1 x2 1
五、以下列两类模式为样本,用感知器算法求其判决函数。 (令 w(1) = (-1,-2,-2)T) 1:{(0,0,0)’, (1,0,0)’, (1,0,1)’, (1,1,0)’,} 2:{(0,0,1)’, (0,1,1)’, (0,1,0)’, (1,1,1)’,} 解: (1)将训练样本分量增广化及符号规范化,将训练样本增加一个分量 1,且把来自 w2 类的 训练样本的各分量乘以-1,则得到训练模式集:
模式识别课后习题答案
– (1) E{ln(x)|w1} = E{ln+1(x)|w2} – (2) E{l(x)|w2} = 1 – (3) E{l(x)|w1} − E2{l(x)|w2} = var{l(x)|w2}(教材中题目有问题) 证∫ 明ln+:1p对(x于|w(12)),dxE={ln∫(x()∫p(|wp(x(1x|}w|w=1)2))∫n)+nl1nd(xx)所p(x以|w∫,1)Ed{xln=(x∫)|w(1p(}p(x(=x|w|Ew1)2{))ln)n+n+11d(xx)又|wE2}{ln+1(x)|w2} = 对于(2),E{l(x)|w2} = l(x)p(x|w2)dx = p(x|w1)dx = 1
对于(3),E{l(x)|w1} − E2{l(x)|w2} = E{l2(x)|w2} − E2{l(x)|w2} = var{l(x)|w2}
• 2.11 xj(j = 1, 2, ..., n)为n个独立随机变量,有E[xj|wi] = ijη,var[xj|wi] = i2j2σ2,计 算在λ11 = λ22 = 0 及λ12 = λ21 = 1的情况下,由贝叶斯决策引起的错误率。(中心极限 定理)
R2
R1
容易得到
∫
∫
p(x|w2)dx = p(x|w1)dx
R1
R2
所以此时最小最大决策面使得P1(e) = P2(e)
• 2.8 对于同一个决策规则判别函数可定义成不同形式,从而有不同的决策面方程,指出 决策区域是不变的。
3
模式识别(第二版)习题解答