
空间数据存储机制研究
街道 街坊 宗地号 宗地面积 权利人 …
5 10
1
123.4 张三 …
5 10
1
123.4 张三 …
…… …
…
……
Geometry 20 ,0 , 20, 10 ,0 , 10
0 ,0 , 20, 0 …
EntitySEQ 1 2 …
按表 1 这样设计的表通过 ObjectID 字段定义了实体 的惟一性 , 通过 EntitySEQ 字段定义了此实体的坐标记录
采用这样的混合数据模型一方面利用了 GIS 产品提 供的空间索引 、空间查询 、空 间分析 的能力 ;另 一方面 也 利用了关 系 数 据库 对 属性 数 据的 强 大 的查 询 、定 位 能 力 。但这样的 混合 数据 模型 也存 在以 下几 点明 显的 不 足 :(1)空间数据采用 各个 GIS 厂 商定义 的各种 格式 , 不 利于数据共享 ;(2)空间数据 以文件 格式存储 , 安全性 难 以得到保 证 , 也 不利 于管 理 ;(3)空间 数据 、属 性数 据 的 一致性维护比 较困 难 ;(4)对 C/ S , B/ S 体系 结构 的支 持 能力差 , 不利于数据的传输 。
4.2 Oracle Spatial
在 Oracle 8i 版本 后 , Oracle 数 据库 中 内置 了空 间数 据库 引擎 Oracle Spatial 。Oracle Spatial 通过 Geometrytype 类型能把复杂的地图对象 存入 Oracle 中 , 能为 其建立 RTree 及 Quad-Tree(四分树)空 间数据 索引 , 并能运 用 SQL 对空间数据查询 , 从而在 Oracle 上 实现了 对空间 图形数 据和属性 数 据的 统一 管 理 。通过 Oracle Spatial , 能 实现 空间数据级的互操作 , 如图 3 所示 。
Abstract :In GIS , the storage of spatial data is important .The paper discussed storage models of spatial data , and pointed out good storage model is extended RDBMS or oriented RDBMS .ORDBMS will become more popular in GIS . Key words :Spatial Data ;RDBMS Storage ;ORDBMS Storage ;ARCSDE ;Oracle Spatial
(1)以二进制方式打开图像文件 , 读取二进制数据 。 (2)把二进制数据存储 , 如下示例所示 :
Set MyConnection =Server.CreateObject(″ADODB .Connection″) MyConnection .open =″Driver={M icrosort Accesss Driver (*.mdb);dbq =″Serve r .Mappath(″CLGL .mdb″)″} Dim Res as New ADODB .Recordset Mystr =″Select * from CLKZD″ Res .open Mystr , MyConnection Res .Addnew Res .(″DZJ″).Appendchunk BufferData Res(″XZBZ″)=坐标值(, 其它字段赋值) … Res .update Res .Close
表 ,毋 需关 联业务 表到 F 表和 S 表 , 从 而使 对象关 系数
据运行速度很快 。其中 F 表结构如下 :
fid INTEGER NOT NULL,
numofpt s entity
INTEGER NOT NULL, SMALLINT NOT NULL,
eminx eminy
图 3 基于 Oracle Spatial 的空间数据互操 作
5 空间数据库存储的实践———ARCSDE 的存储
ARCSDE 是全球最大的 GIS 厂商 ESRI 公司的空间数
据库引擎 , 主要由 A 表 、F 表 、S 表 及部 分元 数据表 所构
成 。在 Oracle8i Spatial 对象关 系数据 库中只有 业务表 A
· 40 ·
计算机应用研究
2003 年
中 ,采用了 上述 表设 计结 构 。为减 少属 性的 重复 存 储 ,
也可把表 1 分解为两个表 , 如表 2(属性表)和表 3 或表 4
(几何表)所示 。其中表 2 在原属性表的 基础上加上 Ob-
jectID 字段以便与表 3 或表 4 关联 ;表 3 的几何实体以 一
序数 , Geometry 字段 存放的 是具 体的 坐标 值 。当然 此表 存在的最大的问题是存 储空间的 浪费 。一般 而言 , 很难
确定 Geometry 字 段 的 长 度 , 但 其 优点 是 脱 离 了 具 体的 GIS 软件 , 便于数据 共享 。目 前 , 在我 国的部 分城 市 GIS
FLOAT(64)NOT NULL, FLOAT(64)NOT NULL,
emaxx
FLOAT(64)NOT NULL,
(下转第 74 页)
· 74 ·
计算机应用研究
2 常规的空间数据存储方式
常规的空间数据一般以 数据文 件的方式 存在 , 如 在 ArcInfo 中以 Coverage 方式 存 在 , 由 一 系 列的 文 件 组 成 ,
收稿日期 :2002-04-29;修返日期 :2002-07-08
如 :tic , bad , arc , aat , pat , tol 等 , 对 任一要 素的修改 将引起 一系列文 件的 变化 。在 AutoCAD 中以 Dwg 的 文件 方式 存在 , 所有的空 间操 作都 在 Dwg 中得 以反映 , 这样 的数 据管理模式不利于数据的安全 、共享 、发布 。
try Type , 用于解决空间 数据的 存储与 查询 , 如 IBM DB2 , Informix ,Oracle Spatial 等 , 其空间数据与 属性数 据存储于
同一表中 , 如表 7 所示 。
表 7 空间 数据的对象关系存储表
FeatureID 街道 街坊 宗地号 宗地面积 权利人 … 几何值 Geometry Type
图 2 类与子类关系图
这样可采用 SQL 进行空间查询 , 例 如从地 块数据库 中查找与某一多边形相交的所有地块 , 其 SQL 语句为 :
SELECT Parcel .Name , Parcel .Id FROM Parcels WHERE Intersects(Parcels .Geometry , MyPolygon)
Geometry 几何实体字段(字符型 , 长度根据 具体几何类型 而定);另一个为 EntitySEQ 字段(定义一个实体所在的行 数 、字符型)。以土地 管理为 例 。图 1 所示为 某一图斑 。 其表结构与存储内容如表 1 所示 。
图 1 土地图斑 表 1 空间数据的全关系存储表
ObjectID 1 1 …
传统的几何类型的数据读取比 较简单 , 但 要真正 实 用 ,还需 建 立空 间 数 据库 引 擎 SDE(Spatial Database Engine), 使传统的 GIS 产品既能使用全关系数据库 , 又不降 低它的空间数据查询效率 、空间分析能力 。
3.2 图像数据的存储
对于图像 、声音等多媒体 信息可 采用二进 制方式 存 储 , 当然 几何实 体 、文 件等信 息也可 采用 二进制 方式 存 储 。以 VB 对 Access 数 据 库 进 行 操 作 为 例 , 至 于 SQL Server 与 Oracle 方法一致 。VB 对 Access 数据库的二进制 存储与 读 取 主要 用 到 AppendChunk 与 GetChunk 两 个 功 能 。其步骤为 :
为克服采用 混合 数据 模型 的缺 点 , 目前 , 商用 成 熟 GIS 软件都朝着将空间数据与属性数据存 储于同一关 系 型数据库 RDBMS 方向发展 。其中比较成熟的有 ESRI 公 司的 ArcSDE , MapInfo 公 司的 SpatialWare 以及 Oracle 的 Oracle8i Spatial , 它们都提供了全关系型或对象-关系型 的 数据模型 。本 文对 目前 几种 常见 的空 间数 据存 储机 制 进行研究 , 并提出相应的 GIS 空间数据存储方案 。
1
5 10 1
123 .4 张三 …
(x, y , … , x, y)
2
…
(x, y , … , x, y)
…
…… …
…
……
…
4.1 空间数据对象类
在 OpenGIS(开放 式地理 信息 系 统)规范 中 , 对 空间 数据采用 SQL Spatial Type 的类 与子类 有明确的 规范(图 2)。
数据的查询 , 方法之一是如上 所述采用 空间索 引与实体
范围定位的 辅助 表 来解 决 , 方 法 之二 是对 RDBMS 进行 扩展 。使用扩展 SQL 查询语言对空间 数据进 行查询 , 但
其缺点是数据库 I/O 检查比 较费时 , 需 要完成 一些附加
操作 ,查询效率比纯 OODBMS 低 。 现在部分 RDBMS 厂商提供了空 间对象 模型 Geome-
1 引言
在地理信息 系统 中 , 空 间数 据的 存 储至 关重 要 , 以 往 , 在 GIS 的数据库设计中 , 空间数据库和属性数据库一 般分开设计 , 空间数据库按已有的 GIS 产品进行设计 , 属 性数据库针对具体的 GIS 项目进行数据结构设计 。空间 数据和属性数据通过关键词 USER ID 关联 。
The Research of Storage Theory for Spatial Data
空间数据的分析

立数据恢复机制,以便于在必要时进行数据恢复。
03 空间数据分析方法
统计分析法
描述性统计
多元统计分析
对空间数据进行基本的统计描述,如 均值、方差、偏度、峰度等,以了解 数据的分布和特征。
运用多元统计方法,如主成分分析、因 子分析等,对空间数据进行降维和特征 提取,以揭示数据的主要特征和结构。
推论性统计
数据预处理与清洗
针对原始空间数据中存在的噪声、异常值和缺失值 等问题,需要进行有效的预处理和清洗。
数据质量评估与改进
建立数据质量评估体系,对空间数据进行定 期评估和改进,提高数据的可用性和可信度 。
算法复杂性与计算效率问题
算法优化与改进
针对空间数据分析中的复杂算法,研究算法优 化和改进方法,提高计算效率和准确性。
时空大数据分析与挖掘
发展时空大数据分析和挖掘技术,揭示时空数据的内在规律和潜在 价值,为决策提供支持。
跨平台、跨领域应用拓展
推动空间数据分析技术在跨平台、跨领域的应用拓展,促进其在智 慧城市、环境保护、公共安全等领域的广泛应用。
THANKS FOR WATCHING
感谢您的观看
缺失值处理
对于缺失的空间数据,可 以采用插值、填充等方法 进行处理,以保证数据的 完整性。
异常值处理
对于异常的空间数据,需 要进行识别和处理,以避 免对分析结果产生不良影 响。
数据转换与标准化
坐标转换
将不同坐标系下的空间数 据转换为统一的坐标系, 以便于进行空间分析和可 视化。
数据格式转换
将不同格式的空间数据转 换为统一的格式,以便于 进行数据处理和分析。
发展多源数据协同分析算法,挖掘多 源数据之间的关联和互补信息,提高
基于空间规划的数据集成存储关键技术研究
32 信息化测绘为推进空间规划试点工作有序开展,河南省委办公厅、河南省人民政府办公厅印发了《河南省省级空间规划试点实施方案》,指出要整合各部门现有空间管控信息管理平台,搭建基础数据、目标指标、空间坐标、技术规范统一衔接共享的空间规划信息平台,为规划编制提供辅助决策,对规划实施监测评估,实现项目并联审批,提高行政审批效率。
空间规划项目开展中,数据库建设承担着中流砥柱作用[1]。
空间规划数据库采用空间数据和关系型数据统一管理的模式,高效管理基础测绘数据、地理国情普查数据、自然资源数据、空间规划底图数据、项目规划并联审批资料数据及其他行业规划专题数据。
结合项目等级的质量控制及高性能数据管理的需求,构建一个包含海量、多源、异构数据的集成化数据库系统,可实现项目中各类数据的高效分布存储和统一管理。
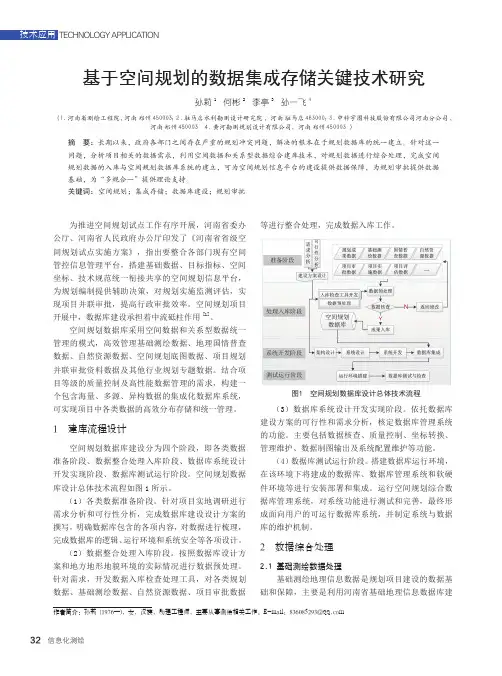
1 建库流程设计空间规划数据库建设分为四个阶段,即各类数据准备阶段、数据整合处理入库阶段、数据库系统设计开发实现阶段、数据库测试运行阶段。
空间规划数据库设计总体技术流程如图1所示。
(1)各类数据准备阶段。
针对项目实地调研进行需求分析和可行性分析,完成数据库建设设计方案的撰写,明确数据库包含的各项内容,对数据进行梳理,完成数据库的逻辑、运行环境和系统安全等各项设计。
(2)数据整合处理入库阶段。
按照数据库设计方案和地方地形地貌环境的实际情况进行数据预处理。
针对需求,开发数据入库检查处理工具,对各类规划数据、基础测绘数据、自然资源数据、项目审批数据孙莉1 何彬2 李亭3 孙一飞4(1.河南省测绘工程院,河南 郑州 450003;2.驻马店水利勘测设计研究院, 河南 驻马店 463000;3.中科宇图科技股份有限公司河南分公司,河南 郑州 450003 4.黄河勘测规划设计有限公司,河南 郑州 450003 )摘 要:长期以来,政府各部门之间存在严重的规划冲突问题,解决的根本在于规划数据库的统一建立。
针对这一问题,分析项目相关的数据需求,利用空间数据和关系型数据综合建库技术,对规划数据进行综合处理,完成空间规划数据的入库与空间规划数据库系统的建立,可为空间规划信息平台的建设提供数据保障,为规划审批提供数据基础,为“多规合一”提供理论支持。
安卓数据存储实验报告

安卓数据存储实验报告一、实验背景在当今移动应用开发中,数据存储是一个至关重要的环节。
安卓系统提供了多种数据存储方式,以满足不同应用场景和数据需求。
为了深入了解安卓数据存储的机制和性能,进行了本次实验。
二、实验目的本次实验的主要目的是:1、比较安卓系统中不同数据存储方式(如内部存储、外部存储、SQLite 数据库、SharedPreferences 等)的性能和特点。
2、探究在不同数据量和操作频繁程度下,各种存储方式的效率和稳定性。
3、为实际应用开发中选择合适的数据存储方式提供依据。
三、实验环境1、操作系统:Android 112、开发工具:Android Studio 423、测试设备:_____ 手机四、实验内容(一)内部存储内部存储是应用私有存储空间,其他应用无法直接访问。
在实验中,通过文件输入输出流进行数据的读写操作。
创建了文本文件来存储简单的字符串数据,并进行了多次读写测试。
(二)外部存储外部存储分为公共外部存储和私有外部存储。
公共外部存储可被其他应用和用户访问,私有外部存储则只有本应用可以访问。
测试了在不同外部存储区域写入和读取大文件的性能。
(三)SQLite 数据库SQLite 是安卓中常用的轻量级数据库。
创建了数据库表,进行了数据的插入、查询、更新和删除操作,同时观察了数据库操作的时间消耗和资源占用情况。
(四)SharedPreferencesSharedPreferences 适用于存储少量的键值对数据。
对其进行了读写操作,并测试了在多线程环境下的并发访问性能。
五、实验步骤1、准备测试数据,包括不同大小和类型的数据,如文本、图片等。
2、分别使用上述四种数据存储方式对测试数据进行存储和读取操作。
3、记录每次操作的时间、内存使用等性能指标。
4、对相同的数据量和操作,改变操作的频繁程度,重复实验步骤2 和 3。
六、实验结果与分析(一)内部存储在小数据量和操作不频繁的情况下,内部存储的读写速度较快。
双特征空间客体捆绑关系的存储机制——来自ERP的证据
双特征空间客体捆绑关系的存储机制——来自ERP的证据傅亚强【摘要】利用事件相关电位技术(ERPs),采用延迟匹配任务的实验范式,测查了16名正常被试完成位置客体、方向客体和位置—方向捆绑客体的工作记忆诱发的皮层慢电位.实验发现:在第1个客体呈现后的300ms到600ms之间,在顶叶皮层(CP5、P7、P3),位置客体、方向客体比捆绑客体诱发了一个更负的成分;在右额(F4、FC6、FC2、F8)、右后颞(TP10)、左颞(T7)、左后颞(TP9)等脑区,捆绑客体比单一特征客体诱发出了一个更正的成分;在800至1400ms的慢波成分上,位置和方向捆绑客体在F4、FC6和F8三个记录点诱发的波形比单一特征客体的波形波幅更正.右侧前额叶参与了客体整合表征的存储,该结果支持了情景缓冲器的假设.【期刊名称】《心理学探新》【年(卷),期】2019(039)002【总页数】6页(P127-132)【关键词】捆绑过程;皮层慢电位;情景缓冲器;视空间模板【作者】傅亚强【作者单位】杭州师范大学心理学系,杭州311121【正文语种】中文【中图分类】B842.51 引言许多日常任务需要人们记住观察对象的多方面特征。
在工作记忆中,这些特征整合起来,成为一个完整客体表征,该过程称为捆绑过程(binding),例如“向东南飞行的飞机在我的右前方”。
捆绑过程的相关研究聚焦于捆绑过程是否涉及特定的工作记忆资源之问题。
对此,研究者提出了两种观点:一种观点认为捆绑过程依赖于视觉空间模板,注意指向某一空间位置,把该位置上的多个特征捆绑起来,形成整合表征,即空间位置充当了特征捆绑的线索。
第二种观点认为,特征捆绑后形成的整合表征由情景缓冲器存储。
Langerock(2014)认为情景缓冲器是一个多种形式编码的存储系统,它有两项重要功能,一是将来自视空间模板的信息进行整合,二是存储整合表征。
第一种观点得到了Klaver(1999)研究的支持,Klaver采用ERP的方法探索了形状客体、位置客体和形状—位置捆绑客体的工作记忆激活脑区和时程。
基于机器学习的城市空间数据分析研究

基于机器学习的城市空间数据分析研究在当今数字化的时代,城市空间数据正以前所未有的速度增长和积累。
这些数据包含了城市的方方面面,如土地利用、交通流量、人口分布、建筑物信息等。
如何有效地分析和利用这些海量的数据,以支持城市的规划、管理和发展,成为了一个重要的研究课题。
机器学习作为一种强大的数据分析工具,为城市空间数据的分析提供了新的思路和方法。
一、城市空间数据的特点城市空间数据具有多源性、时空性、复杂性和高维度等特点。
多源性指的是数据来源广泛,包括传感器、卫星图像、社交媒体、政府部门等。
时空性意味着数据不仅在空间上有分布,还随时间而变化。
复杂性体现在数据的结构多样,既有结构化的数据,如表格数据,也有非结构化的数据,如图像、文本等。
高维度则是由于数据包含了众多的属性和特征。
二、机器学习在城市空间数据分析中的应用1、城市土地利用分类通过对卫星图像、航拍图像等数据的分析,利用机器学习算法,如卷积神经网络(CNN),可以实现对城市土地利用类型的准确分类,如住宅、商业、工业、绿地等。
这有助于城市规划者了解土地的使用情况,为合理规划土地资源提供依据。
2、交通流量预测基于历史的交通流量数据,运用机器学习中的回归算法,如支持向量回归(SVR)、随机森林回归等,可以对未来的交通流量进行预测。
这对于优化交通信号灯控制、规划道路建设等具有重要意义。
3、城市人口分布预测结合人口普查数据、移动手机数据等,利用机器学习模型,如高斯过程回归(GPR),能够预测城市人口的分布情况。
这有助于合理配置公共服务设施,如学校、医院等。
4、建筑物能耗预测通过分析建筑物的结构、使用情况、气象数据等,运用机器学习算法,如决策树、人工神经网络(ANN)等,可以预测建筑物的能耗。
这对于推动城市的节能减排,实现可持续发展具有重要作用。
三、机器学习应用于城市空间数据分析的挑战1、数据质量问题城市空间数据往往存在数据缺失、错误、不一致等质量问题。
这些问题可能会影响机器学习模型的训练效果和预测准确性。
趣味小知识为什么电脑可以存储大量数据
趣味小知识为什么电脑可以存储大量数据电子计算机的大量数据存储能力是现代科技的重大突破之一,使得人们能够方便地保存和管理海量的信息。
此次,我们将探讨电脑能够存储大量数据背后的原理和机制。
无论是用于工作、学习还是娱乐,对于电脑存储空间的需求似乎越来越大,因此,了解电脑存储的原理将有助于我们更好地利用它们。
要理解为什么电脑可以存储大量数据,先让我们回顾一下计算机的基本原理。
一台计算机主要由中央处理器(CPU)、存储器和输入输出设备组成。
中央处理器是计算机的核心部件,负责执行各种计算和操作,而存储器则用于存储数据和程序。
首先要了解的是计算机内部数据存储的基本单位——比特(bit)。
比特是计算机中最小的存储单位,可以表示0或1两种状态。
计算机中的所有数据都是以比特的形式存储和传输。
在计算机内部,数据的存储和传输是通过电子信号来实现的。
通过控制电子信号的开关状态,计算机能够表示和操作不同的数据。
一个比特就是一个开关,可以表示0或1。
对于一个8位的二进制数字,它可以表示256(2^8)种不同的状态。
然而,一个比特的存储容量太小了,无法满足实际的数据存储需求。
因此,计算机中使用的存储单位是字节(Byte),一个字节等于8个比特。
字节是计算机存储容量的基本单位,我们通常使用的存储空间(如硬盘、内存)的大小都是以字节为单位来表示的。
现代计算机的存储容量通常以千字节(KB)、兆字节(MB)、千兆字节(GB)甚至是吉字节(TB)来计算。
这些单位之间的换算关系是:1 KB = 1024 B1 MB = 1024 KB1 GB = 1024 MB1 TB = 1024 GB那么,电脑如何实现大容量的数据存储呢?其实,计算机的存储原理涉及到硬盘和内存这两个重要组件。
首先,我们来看硬盘。
硬盘是计算机中最主要的存储设备之一,它通过圆盘上的磁性材料来存储数据。
硬盘的结构复杂,但其基本原理是利用磁场的变化来表示和存储数据。
硬盘上的圆盘被分成一个个小的磁区,每个磁区可以存储一定量的数据。
城市地理空间数据更新机制和流程探究
城市地理空间数据更新机制和流程探究白易【摘要】从基础地理数据、专题数据的角度,分析了城市地理空间数据的内涵,研究了各类数据更新机制中的关键问题,制定了包括更新责任机构、更新周期在内的更新策略,探索了实用的更新技术,规定了数据更新的质量检查和安全控制方案,制定了历史数据管理机制.探究了具备应用价值的城市地理空间数据更新流程,并用实验证明了更新机制和流程的可操作性.【期刊名称】《地理空间信息》【年(卷),期】2011(009)001【总页数】3页(P63-65)【关键词】城市地理空间数据;基础地理数据;专题数据;数据更新【作者】白易【作者单位】武汉大学地理信息系统教育部重点实验室,湖北武汉,430079;武汉大学资源与环境科学学院,湖北武汉,430079【正文语种】中文【中图分类】P208随着城市地理空间数据在各方面的深入应用,其现势性已成为管理者和用户最为关注的热点问题并对数据的使用深度和广度产生重要影响。
自 1999年 D. FRITSCH博士提出“当前GIS的核心已从数据生产转为数据更新,数据更新关系着GIS的可持续发展”[1]这一观点以来,国内外众多学者纷纷在推帚和散点相结合的更新机制(英国,1999)、数据更新模型(美国俄亥俄州立大学测图中心,2002)、基础地理数据库更新步骤(蒋捷,1999)、动态更新技术体系(陈军,2004)等方面进行了有意义的研究 [2-5],浙江(徐韬,2004)、上海(叶云,2005)[6-7]等省市有关部门也进行了有效的基础地理数据更新实践。
但是,城市地理空间数据包括基本框架(即基础地理数据)和专题数据两部分,而绝大多数已有研究和实践都只是立足于基础地理数据更新,还缺少规范有效的基础地理数据加专题数据的更新机制与技术方法。
专题数据具有专业性、统计性和空间性特点,其更新对于具备社会性的城市而言必不可少,且更新手段与基础空间数据比起来有特殊性。
因此,从城市地理空间数据更新的需要出发,探讨城市基础空间数据更新、专题数据更新问题,研究合理并且有效的数据更新机制和流程,给出不同情况下的更新策略,具有较为重要的实际意义。
基于elasticsearch的时空大数据存储与分析方法
152 •电子技术与软件工程 Electronic Technology & Software Engineering数据库技术• Data Base Technique【关键词】时空大数据 Elasticsearch 空间索引1 引言地理信息技术的快速发展,使其信息化水平越来越高,随之而来的是数据的爆炸式增长,使得海量空间数据的存储与查询时效性面临巨大挑战。
由于空间数据的特殊性,在存储和管理方面也存在诸多的限制,而分布式技术的迅速发展,无疑为空间数据的存储与管理提供了解决方法。
ElasticSearch 作为一个分布式可扩展的实时搜索和分析引擎,在海量数据的存储与搜索方面得到广泛应用。
由于ElasticSearch 面向文档的特性,使得它在海量空间数据的存储方面也有很好的表现,但如何实现空间数据的高效查询是业界研究的一个热点问题。
传统的关系型数据库大多建立树的索引实现空间查询,在面临大数据量的查询时其性能很难满足实际需求,而传统的空间索引很难应用于非关系型数据库中,所以需要对空间数据进行转换,将转换后的数据作为索引字段以用于查询。
因此,本文依据ElasticSearch 的存储特性,结合四叉树网格编码算法,将矢量数据进行转换,并构建空间索引,以提升空间数据的查询效率。
在此基础上,设计并实现了基于Spark 的空间数据分析的优化方案,为海量空间数据的存储与查询分析提供了一种快速有效的解决方案。
2 四叉树网格编码算法由于四叉树编码算法原理较简单且容易实现,已被广泛应用于地理信息系统的业务处基于Elasticsearch 的时空大数据存储与分析方法文/俞志宏 栗国保 李少白理中。
该算法的基本思想是将一个已知范围的空间划分成四个相等的子空间,并按照此方式递归执行,直到树的层次达到指定的深度或满足某种终止条件时则停止划分。
本文依据四叉树编码算法的思想,实现了利用平面直角坐标系所划分的四个象限作为编号的四叉树编码算法。
操作系统内存管理实验报告
操作系统内存管理实验报告操作系统内存管理实验报告引言:操作系统是计算机系统中的核心软件,负责管理计算机系统的各种资源,其中内存管理是操作系统的重要功能之一。
内存管理的目标是有效地管理计算机的内存资源,提高计算机系统的性能和可靠性。
本实验旨在通过设计和实现一个简单的内存管理系统,加深对操作系统内存管理原理的理解,并通过实践来加深对操作系统的认识。
一、实验背景计算机内存是计算机系统中的重要组成部分,它用于存储程序和数据。
在操作系统中,内存被划分为多个不同的区域,每个区域有不同的用途和访问权限。
内存管理的主要任务是为进程分配内存空间,并进行合理的管理和调度,以提高系统的性能和资源利用率。
二、实验目的本实验旨在通过设计和实现一个简单的内存管理系统,加深对操作系统内存管理原理的理解,并通过实践来加深对操作系统的认识。
具体目标包括:1. 设计和实现一个简单的内存分配算法,实现内存的动态分配和回收;2. 实现内存的地址映射机制,实现虚拟地址到物理地址的转换;3. 实现内存保护机制,确保进程之间的内存隔离和安全性;4. 实现内存的页面置换算法,提高内存的利用率和性能。
三、实验设计与实现1. 内存分配算法为了实现内存的动态分配和回收,我们设计了一个简单的内存分配算法。
该算法根据进程的内存需求和剩余内存空间的大小,选择合适的内存块进行分配。
当进程结束或释放内存时,将已使用的内存块标记为空闲状态,以便下次分配。
2. 地址映射机制为了实现虚拟地址到物理地址的转换,我们设计了一个地址映射机制。
该机制使用页表来记录虚拟地址与物理地址的映射关系。
当进程访问内存时,操作系统根据页表将虚拟地址转换为物理地址,并进行内存访问。
3. 内存保护机制为了确保进程之间的内存隔离和安全性,我们实现了一个简单的内存保护机制。
该机制通过设置每个进程的访问权限,限制进程对内存的读写操作。
只有获得相应权限的进程才能访问内存,确保进程之间的数据安全和隔离。
网络计算环境下大容量数据安全存储策略研究
网络计算环境下大容量数据安全存储策略研究徐艳;王茜【摘要】近年来,随着计算机技术的发展,网络环境下的数据运算能力愈来愈强;加之,大数据时代的来临将人们日常生活、工作、学习的物质化信息转化为数据化关联性链条,通过网络进行大数据资源共享,简化了工作学习的繁杂,提升了工作学习效率;但是,传统的网络储存策略常常出现数据泄露、储存服务器数据溢出等一系列储存安全问题;针对问题产生原因,提出网络计算环境下大容量数据安全存储策略研究方法;通过采用数据修正单元、逻辑补偿单元与节点加密单元,对传统网络储存策略进行动态化针对性解决;通过仿真实验证明,提出的网络计算环境下大容量数据安全存储策略研究方法,具有数据储存响应速度快、反渗透逻辑性强、数据安全级别高、易用性强的优点.%In recent years,with the development of computer technology,data computing power under the network environment become more and more strong.In addition,the advent of the era of big data will turn people's daily life,work and study the materialization of information into digital correlation chain,big data through the network resource sharing,simplifies the learning multifarious work,improve the efficiency of work and study.However,the traditional network storage strategy often leaks of data overflow and a series of storage,storage server data security issues.In view of the problem,put forward under the network computing environment,large capacity data security storage strategy research methods.By adopting data correction unit,logic compensationunit and node encryption unit dynamic targeted to solve the traditional network storage strategy.Through the simulation experiments show thatunder the network computing environment of large capacity data storage strategy research method,a data storage response speed,reverse osmosis,strong logicality,the advantages of high data security,ease of use.【期刊名称】《计算机测量与控制》【年(卷),期】2017(025)008【总页数】5页(P147-150,158)【关键词】网络计算环境;数据安全;存储策略;数据溢出【作者】徐艳;王茜【作者单位】电子科技大学成都学院微电子技术系,成都 611731;电子科技大学成都学院微电子技术系,成都 611731【正文语种】中文【中图分类】TP311随着科技迅猛发展,海量数据也出现飞速发展态势,同时,海量数据存储也受到越来越严峻的挑战,其爆炸性的数据一直冲击着我们的生活,同时,各行各业对海量数据的安全性要求越来越高。