
VFP 中的 SQL SELECT 语句使用要点
VFP 中的SQL SELECT 语句使用要点作者: 康康(张初康)第一节select - SQL 的工作流程再复杂的SQL SELECT 命令,也是由一些基本的结构组成的。
所以在看、去做一条很复杂的SQL SEL ECT 命令时,要会把它一级一级的折分,最后折成最简单的,这样才容易理解。
而这个折分过程,如果不熟悉SQL SELECT 命令的工作流程,那就比较难折分了。
大体来说,它是先根据联接条件(即联接条件on 中的表达式),把几个的表合成一个临时表,然后根据w here 中的条件进行过滤,过滤出来的结果根据分组条件再把这个临时表分成一组一组,然后对分别对些组进行字段计算,最后又得出一个临时表,然后又根据having 中的条件对这个临时表进行再次过滤,最后输入到指定的地方,如数组、表等。
它中间生成的临时表对用户来说,是完全透明的,用户是不可能使用、也不能创建,它是由系统自己创建、自己使用、自己撤除,完全不受用户控制的。
我举个例子:有二个表:提货单thd、提货单明细thdmx:thd提货单号提货日期thdbh thrq01 2000/01/0202 2000/01/1503 2000/02/01thdmx提货单号产品编号提货数量thdbh cpbh Thsl01 001 501 003 1501 005 1202 001 1302 002 1402 005 2003 002 14现在有个要求:要统计day1 = 2000/01/01 至day2 = 2000/01/20 这段时间内,提货数量大于10 的产品有那些,它们各自的总提货量是多少。
命令如下:sele cpbh,sum(thsl) ;from thd join thdmx ;on thd.thdbh=thdmx.thdbh.and.thsl>10.and.betw(thrq,day1,day2) ;grou by cpbh ;into curs temp1为什么把thsl>0 和betw(thrq,day1,day2) 这二个条件表达式放在on 那里,参见on、where 与havin g 的区别。
它的工作流程:首先根据on 中的过滤条件,对所涉及的表进行预处理。
过程如下:两个表根据thd.thdbh = thdmx.thdbh 进行合并,变成一个这样的临时表:thdbh1 thrq thdbh2 Cpbh thsl01 2000/01/02 01 001 501 2000/01/02 01 003 1501 2000/01/02 01 005 1201 2000/01/02 02 001 1301 2000/01/02 02 002 1401 2000/01/02 02 005 2001 2000/01/02 03 002 1402 2000/01/15 01 001 502 2000/01/15 01 003 1502 2000/01/15 01 005 1202 2000/01/15 02 001 1302 2000/01/15 02 002 1402 2000/01/15 02 005 2002 2000/01/15 03 002 1403 2000/02/01 01 001 503 2000/02/01 01 003 1503 2000/02/01 01 005 1203 2000/02/01 02 001 1303 2000/02/01 02 002 1403 2000/02/01 02 005 2003 2000/02/01 03 002 14合并是按照笛卡尔积进行计算的,即二个表都有10 个记录,那积就会有10*10 = 100 个记录,这是很历害的。
但因为on 条件中有过滤条件,所以VFP 并不会这么笨,它会把符合这个条件的记录才放到临时表中的。
这样,结果就少了很多记录了。
结果出来后,再根据on 后来的过滤条件thsl>10.and.betw(t hrq,day1,day2) 进行过滤,这样thsl 大于10 而且提货日期是在day1 至day2 的记录最后才出现在这一步的临时表中。
01 2000/01/02 01 003 1501 2000/01/02 01 005 1202 2000/01/15 02 001 1302 2000/01/15 02 002 1402 2000/01/15 02 005 20现在轮到分组了。
根据产品编号进行分组,它具体的分组方法我不知道是怎样,我想可能是这样的:象在投票选举时点票那样,在上面那个临时表从头到尾扫一次,每经过一记录时,它就看一下,当前的产品编号是不是一个新的组,如果是就新增一个分组记号,相当于新增加一个被选举人,然后在它下面加上thsl 的值,全部记录数完了,就看看有多少个分组标记,各个分组又有多少thsl。
结果就是以下的样子:001 13002 14003 15005 32这就是这条命令的结果了。
然后把它生成一个cursor 表,命令就完成了。
如果再深入一点,把要求改成某段时间内全部产品的提货情况,如果没有进货记录,那就是0,一样要出现在结果表里。
这时,就涉及到三个表了:产品表cpb、提货表thd、提货明细表thdmx。
我们先用内联接来把这三个表联接起来。
sele cpb.cpbh,cpb.cpmc,sum(iif(isnull(thdmx.thsl),0,thdmx.thsl)) as thsl ;from cpbh join thdmx ;join thd ;on cpbh.cpbh=thdmx.cpbh ;on thdmx.thdbh=thd.thdbh.and.betw(thd.thrq,day1,day2) ;grou by cpbh ;into curs temp1根据内联接的定义,即某个产品编号在产品表和提货明细表中都存在的记录,才会出现在结果表中,如果某种产品没有提货,那在提货明细表就没有这个记录,这样,也就不会出现在结果表中。
那样就符合要求中的"全部产品"这个条件了。
所以我们要把产品表左联接提货明细表,这样不管这种产品有没有提货,它都会出现在结果表中,只是以null 的值出现。
但这个现象可以消除的。
命令过程也和上一个要求那样,先进行联接,只是这条命令的中间临时表比上面更大,因为是三个表的记录数相乘。
但经过联接条件过滤后,就会剩下这些内容:001 02 2000/01/15 02 001 13002 02 2000/01/15 02 002 14003 01 2000/01/02 01 003 15004 null null null null null005 01 2000/01/02 01 005 12005 02 2000/01/15 02 005 20然后也一样进行分组,分组时的判断过程也一样,只是在累加的时候有点不同:sum(iif(isnull(thdmx.thsl),0,thdmx.thsl)),是先用isnull(thdmx.thsl) 检查thsl 是不是null,如果是,则ii f() 就返回0,如果不是,则返回thdmx.thsl。
然后外层的sum() 就根据iif() 返回的数值进行累加,最后做为这个分组的累加值。
还有一种使用方法,说出来也可以加深命令当中的sum() 函数的处理过程。
人事表rsb:姓名xm 年龄age张三 25李四 32王五 28现在想统计一下各个年龄段(20-30,31-40)的人数是多少。
sele sum(iif(betw(age,20,30),1,0) as _20-30,sum(iif(betw(age,31,40),1,0) as _31-40 ;from rsb ;grou by zc ;into curs temp1因为这条命令没有过滤条件、联接,所以不需事先预处理,一来就进行分组。
和投票中点票一样,在"黑板"上写划出三列:zc _20-30 _31-40这样,在rsb 中从头扫到尾时,每经过一记录时,都用iif(betw(age,20,30),1,0) 检查这个人的年龄是不是处于20-30,如果是就在_20-30 这一列下面加一横,否则就不加。
第二个iif() 也这样处理。
如果当前的年龄是53,那二个iif() 都是返回0,即二列都不加,相当于废票。
全部记录都点完了,然后就用su m() 进行合计了,结果就出来了。
因为二个sum() 都是扫描完后再合计的,它不象sum 命令。
sum 命令会移动记录指针,而sum() 函数不会,所以不必怕使用这个函数会造成不良后果。
而且二个iif() 都有自己的判断条件,两者不互相重合,所以一个记录不会重复计算(除非你的命令设计错了)。
如果使用union 参数把两条运算结果的格式一模一样的命令合在一起,那也是一样的。
它是把其中的每一节select 命令单独运行(它单独运行时的运行流程跟上面说的一样),最后才把每一节的结果首尾相接后,再根据最后那节的orde by 进行排序。
所以一条带union 的SQL SELECT 命令,只能有一个orde b y。
而每一节select 命令,却可以有自己的grou by,它自己的grou by 只对这一节有影响,是不会影响到其它节的运算的。
更不会对最后结果有影响。
这里举个例子:我想统计一段时间内的提货、进货情况。
这里要涉及到 5 个表:产品表、提货表、提货明细表、进货表、进货明细表:sele cpbh,sum(thdmx.thsl) as thsl,100000-100000 as jhsl ;from thd join thdmx ;on thd.thdbh=thdmx.thdbh ;grou by cpbh ;union ;sele cpbh,0,sum(jhdmx.jhsl) ;from jhd join jhdmx ;on jhd.jhdbh=jhdmx.jhdbh ;grou by cpbh ;orde by cpbh ;into curs temp1如果看了上面的解释,应该可以理解每一节SQL SELECT 命令的意思。
这里要说的是:1、union 要求前后两节SQL SELECT 命令产生的表,在结构上要完全一样,包括字段的顺序也要一样。
所以为了达到这个要求,在第一节,就要人为建立一个字段jhsl,而在第二节命令,也要建立一个字段t hsl 以对应。
2、用SQL SELECT 产生的表,它不象crea table 那样可以直接指定字段的类型、长度,而是在根据生成的临时表中第一个记录的长度来确定的。
所在在第一节,如果不使用100000-100000 而是直接使用0,这样产生的jhsl 这个字段,它的长度就只有 2 个字节了。
select用法

SELECT命令在全国计算机等级考试二级VFP考试中所占的比重可以说非常大,在笔试考试中可以占8-12分,上机考试中占20-50分,所以我将SELECT命令做如下说明,请大家认真学习.SELECT各短语功能:SELECT 说明查询结果,可以用*来表示所有字段,也可以直接写所要查询的字段名,多个字段名也要用英文的逗号隔开,在分组或计算查询中还可以使用如SUM(),COUNT(),A VG(),MAX(),MIN()这些函数进行运算,还可以在排序后用TOP短语来取查询结果的前几条记录,用AS短语对结果字段重新命名;FROM 说明查询的数据源,一般写表名,多个表名用英文的逗号隔开,也可以对所用到的表进行重新命名(如学生st 将学生表重新命名成st表);WHERE 说明查询条件,一般写条件表达式也就是逻辑表达式;GROUP BY说明分组字段此短语后可跟写HA VING短语用来说明分组后的条件;ORDER BY说明排序字段,可以用ASC(升序)和DESC(降序)来说明排序方式;INTO 说明查询去各,可以用TABLE或DBF(表)、CURSOR(临时表)、ARRAY(数组)三短语中一个来说明查询去向的类型。
考点1 简单查询1简单查询简单查询是由SELECT和FROM短语构成的无条件查询,或由SELECT,FROM和WHERE短语构成的条件查询。
2简单的连接查询连接是关系的基本操作之一,连接查询是一种基于多个关系的查询。
3嵌套查询嵌套查询所要求的结果出自一个关系,但关系的条件却涉及多个关系。
其内层基本上也是一个SELECT-FROM-WHERE查询语句。
这种简单嵌套查询,可使用谓词IN或NOT IN 来判断在外层的查询条件中是否包含内层查询的结果。
考点2 特殊运算符号1 BETWEEN…AND…含义:该查询的条件是在……范围之内,相当于用AND连接的一个逻辑表达式。
2 LIKE含义:它是一个字符串匹配运算符,与之搭配使用的通配符包括“*”和“?”。
VFP中select - sql命令及示例

select - sql命令功能从一个或多个表中检索数据。
语法SELECT [ALL | DISTINCT] [TOP nExpr [PERCENT]][Alias.]Select_Item [AS Column_Name][, [Alias.]Select_Item [AS Column_Name] ...]FROM [FORCE][DatabaseName!]Table [[AS]Local_Alias][[INNER | LEFT [OUTER] | RIGHT [OUTER] | FULL [OUTER] JOIN DatabaseName!]Table [[AS]Local_Alias][ON JoinCondition…][[INTO Destination]| [TO FILE FileName [ADDITIVE] | TO PRINTER [PROMPT]| TO SCREEN]][PREFERENCE PreferenceName][NOCONSOLE][PLAIN][NOWAIT][WHERE JoinCondition [AND JoinCondition ...][AND | OR FilterCondition [AND | OR FilterCondition ...]]][GROUP BY GroupColumn [,GroupColumn ...]][HAVING FilterCondition][UNION [ALL]SELECT命令][ORDER BY Order_Item [ASC | DESC] [,Order_Item [ASC | DESC] ...]] 参数SELECT在 SELECT 子句中指定在查询结果中包含的字段、常量和表达式。
ALL查询结果中包含所有行 ( 包括重复值 )。
ALL 是默认设置。
DISTINCT在查询结果中剔除重复的行。
注意每一个 SELECT 子句只能使用一次 DISTINCT。
sql select用法

sql select用法
SQL Select用法
1. SELECT子句:
SELECT子句用于从表或视图中检索信息,可以检索一列或多列,也可以指定各种条件,按特定的顺序来检索信息。
语法:
SELECT列名称 FROM表名称 WHERE 条件
例如:
SELECT LastName FROM Employees WHERE FirstName = 'John' 上面的语句将从员工表中检索出所有姓名为John的员工的名称 2. DISTINCT子句
DISTINCT 子句可以用于从结果集中筛选出不同的值。
例如,您可以使用该子句返回指定表中特定列的唯一值。
语法:
SELECT DISTINCT列名称 FROM表名称 WHERE 条件
例如:
SELECT DISTINCT LastName FROM Employees WHERE FirstName = 'John'
上面的语句将返回John名字拥有的所有不同的姓氏。
3. ORDER BY 子句
ORDER BY 子句用于按照指定列的升序或降序排列检索出的数据,默认情况下,ORDER BY 子句会按照升序排列数据。
语法:
SELECT列名称 FROM表名称 WHERE 条件 ORDER BY 列名称[ASC | DESC]
例如:
SELECT LastName FROM Employees WHERE FirstName = 'John' ORDER BY LastName DESC
上面的语句将按照John的姓氏的倒序排列数据。
在VFP中如何巧用Select_SQL查询
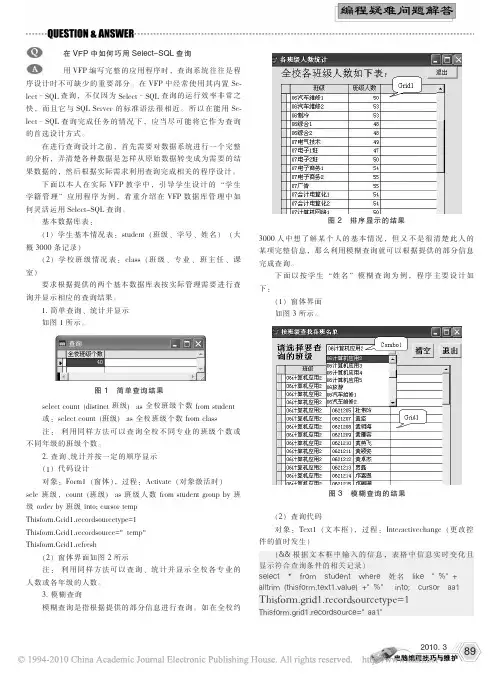
当然利用 Selቤተ መጻሕፍቲ ባይዱct–SQL 查询还可以完成更复杂的查询设计, 同时还能把查询的结果以不同的文件格式保存或直接输出到打 印机。
(作者: 杜丽平)
图 4 精确查询结果
(2) 查询代码设计 1) 对象: Form1 (窗体), 过程: Active (对象激活时) (&& 在组合框中添加各班级名称信息) bo1.style=0 bo1.rowsourcetype=3 bo1.rowsource=" sele dist 班 级 from student order by 班级 into; cursor Combo1" 2) 对 象 :Combo1(组 合 框 ),过 程 :InteractiveChange(更 改 控 件的值时发生) (&& 根 据 组 合 框 中 选 择 的 对 象 在 指 定 表 格 中 显 示 查 找 到 的记录) sele * from student where 班 级 ==bo1.displayvalue into cursor aa1 Thisform.grid1.recordsourcetype=1 Thisform.grid1.recordsource=" aa1" With ThisForm.Grid1 .ColumnCount = 3 .Column1.Width = 100 .Column2.Width = 50 .Column3.Width = 80
在VFP中如何巧用Select-SQL查询

要 求 根 据 提 供 的两 个 基 本 数 据 库 表 按 实 际 管 理 需 要 进 行 查
询 并 显 示 相 应 的查 询 结 果 。 1 简单 查 询 、统 计 并 显示 . 如图 l 所示 。
择班 要级
( )窗 体 界 面 1
如 图 3所 示 。
查
计豆 矶厦崩3
5 5
lt Q e —S L查 询 完 成 任 务 的 情 况 下 ,应 当尽 可 能 将 它 作 为 查 询 c
的首 选 设 计 方 式 。 在 进 行 查 询 设计 之 前 ,首 先 需 要 对 数 据 系统 进 行 一 个 完 整 的分 析 ,弄 清 楚各 种 数 据 是 怎 样 从 原 始 数 据 转 变 成 为 需 要 的结 果 数 据 的 ,然 后 根据 实 际需 求 利 用 查 询 完成 相 关 的程 序 设 计 。
《
在V P 如何巧用SIt Q 查询 F中 ecS L e-
用 V P编 写 完 整 的应 用 程 序 时 ,查 询 系统 往 往 是 程 F
序 设 计 时 不可 缺少 的重 要 部 分 。 在 V P中经 常使 用其 内置 S — F e
全 校各班 数如下 厂 级人 表:—一
班级
某 项 完整 信 息 ,那 么 利 用 模 糊查 询 就 可 以 根据 提 供 的部 分 信 息 完 成查 询 。
( ) 学 校 班 级 情 况 表 :cas ( 级 、专 业 、班 主 任 、课 2 ls 班
室)
请Байду номын сангаас
选 的 下 面 以按 学 生 “ 名 ” 模 糊 查 询 为 例 ,程 序 主 要 设 计 如 姓
或 :slc c u tf 级 1 s 校 班 级 个 数 f m c s ee t o n 班 a 全 r l s o a 注 : 利 用 同 样 方 法 可 以 查 询 全 校 不 同 专 业 的 班 级 个 数 或 不 同年 级 的班 级 个 数 。
vf结构化查询语言之SELECT讲解

SQL数据查询
3.统计查询
• 对数据表中数值型数据的查询结果进行统计 • 统计功能用VFP提供的库函数实现
函数名称
功能
返回值
统计一列中值Biblioteka 个数 Count(*)记录总数 Count(字段)字段不为空 的个数 计算一列值的总和 计算一列值的平均值 求某字段的最大值 求某字段的最小值
COUNT([DISTINCT] *|字段名) SUM(字段名) AVG(字段名) MAX(字段名) MIN(字段名)
第四章
结构化查询语言SQL
兴隆职教中心
詹亚萍
SQL
一、SQL的基本概况
1、SQL(structure Query Language)结构化查询语言,
是关系数据库的标准语言,所有关系数据库管理系统都支 持。 2、SQL功能: 数据的查询 :是SQL的核心,SELECT 命令
数据的定义
数据的操作 数据的控制
SQL数据查询
二、SQL数据查询
1、简单查询(单表查询)
格式: SELECT [ALL | DISCINCT ] [*] | <字段名> [AS <列标题>]…; FROM <表名> 功能:从指定的表或视图中查询记录数据 说明:
DISTINCT:指定输入结果时无重复记录
ALL:代表全部记录,ALL也是默认值 * :表示显示表中全部字段的信息 AS 列标题:可为某字段指定显示的别名 FROM <表名>:指定要查询的数据的表
SELECT * FROM 学籍 WHERE 年龄 IN (17,18,19)
SQL数据查询
⑥空值: IS NULL 、IS NOT NULL 功能:用来判断某字段值是否为空值 例:查询成绩表中,数学缺考学生的信息(数学成绩为空) SELECT * FROM 成绩 WHERE 数学 IS NULL
vfp中select语句用法
SQL
FoxPro支持在Select子句中使用用户定义函数。但是由于在其它系统中不支持用户定义函数。因此在开发 可能移植的系统时不要使用用户自定义函数。
Select
Select子句中的通配符
*(星号)只能使用在字段串列参数中。 代表来源数据库中所有的字段。 如果select是在二个以上的数据库中进行 查询的,则要在号码前加上数据库别名。
另一种情况是文字数据中正好包含有星号、百分号、下划线(例如:软件部__业务组),此时可使用关键
字ESCAPE告诉SQL哪一个字符是常数字符而非通配符。例如:
select company from customer
where company like"%\_%" escape"\"
此时escape所指定字符(即\)后的那一个字段(此处为下划线_)将被视为常数字符而非通配符。
当SQL遇到DISTINCT关键字时,即建立一个中间表。然后以SELECT子句中的所有字段建立一个唯一索引,
然后将索引用于中间表,并把索引中的记录放入查询结果中。这样就消去了重复记录,但是当SELECT子句中
的字段很多时,这一过程会很慢。
用WHERE子句说明选择记录的条件
通常查询并不希望取出所有记录,而只是希望查出满足一定条件的记录,要做到这一点可以使用 句。WHERE子句把满足条件的记录作为查询结果。
*是SQL中的三个通配符之一(其它两个是和_ ,将在以后讨论),*只能出现在Select子句中,通配符
前可以用别名修饰,在此情况下表示要查询指定工作区中的全部字段•同时还可以给出其它字段名•如:
Select销售表•*,客户表•客户代码,客户表.客户名称;FROM销售表,客户表;
VF中常用SQL命令使用方法
VF中常用SQL命令使用方法SQL(结构化查询语言)是关系型数据库管理系统中最常用的查询语言。
在VF中,使用SQL命令可以对数据库进行增删改查等操作。
以下是VF中常用的SQL命令使用方法:1.创建表格(CREATETABLE):用于创建数据库中的表格。
语法如下:```sqlCREATE TABLE table_namecolumn1 data_type,column2 data_type,...```例如:```sqlCREATE TABLE customersid INT PRIMARY KEY,name VARCHAR(50),age INT,email VARCHAR(100)```2.插入数据(INSERTINTO):用于向表格中插入新的数据。
语法如下:```sqlINSERT INTO table_name (column1, column2, ...)VALUES (value1, value2, ...);```例如:```sqlINSERT INTO customers (id, name, age, email)```3.更新数据(UPDATE):用于更新表格中的数据。
语法如下:```sqlUPDATE table_nameSET column1 = value1, column2 = value2, ...WHERE condition;```例如:```sqlUPDATE customersSET age = 26WHERE id = 1;```4.删除数据(DELETEFROM):用于从表格中删除数据。
语法如下:```sqlDELETE FROM table_name WHERE condition;```例如:```sqlDELETE FROM customers WHERE id = 1;```5.查询数据(SELECT):用于从表格中查询数据。
语法如下:```sqlSELECT column1, column2, ...FROM table_nameWHERE condition;```例如:```sqlSELECT * FROM customers WHERE age > 25;```6.排序数据(ORDERBY):用于按照指定列对查询结果进行排序。
vf结构化查询语言之SELECT讲解
SQL数据查询
• 练习:
• 2.在成绩表中要求按“总分”降序排列,并查询前3名学 生的记录,命令是 : • SELECT * TOP 3 FROM 成绩表 ORDER BY 总分 DESC • 3.在学生信息表按班级升序显示学号,姓名,出生日期, 住校否字段。 • SELECT 学号,姓名,出生日期,住校否 FROM 学生信 息表 ORDER BY 班级 ASC • 4.在学生表中按学号升序,班级降序显示学号和入学成绩 • SELECT 学号,入学成绩 FORM 学生表 ORDER BY 学 号 ASC,班级 DESC
SQL数据查询
• • • • • • • • • • 5.输出部分结果 格式: Select * TOP n [PERCENT] FROM…… Where…… Order by…… 功能: 显示满足条件的前几条记录。 说明:TOP短语一般跟在*号的后面。 TOP短语要与ORDER BY短语同时使用才有效。 不带PERCENT参数时,说明显示前n条记录;使 用PERCENT参数时,说明显示查询结果中前百 分之多少的记录。
在ORDER BY 中,排序项可以用输出字段或排列序号表示
SQL数据查询
例2 :查询“学籍”表中“学号”,“姓名”、“性别”、“出生日期”、 “年龄”和“专业”字段内容,按从年龄字段升序输出。
计算年龄可以用表达式: YEAR(DATE())-YEAR(出生日期)
SELECT 学号,姓名,性别,出生日期,; year(date())-year(出生日期)as 年龄,专业 ; FROM 学籍; ORDER BY 5 DESC 或ODER BY 年龄 DESC
SQL数据查询
二、SQL数据查询
1、简单查询(单表查询)
VFP第4章SQL的数据查询功能
查询的分类
1.条件查询:找出满足条件的记录; 2.分组查询:查询结果按列名或列名组合分组; 3.投影查询:查询对象的基本情况; 4.统计查询:在原数据表的基础上,经统计计算 后,输出统计结果; 5.联接查询:利用多表数据得到查询结果。
1.条件查询 利用WHERE<条件>子句在数据表中找出满足条 件的记录。常用的比较运算符。
此查询也可以写成: SELECT 姓名,入校总分; FROM 学生; WHERE 入校总分>(SELECT MAX(入校总分); FROM 学生; WHERE 性别='男'); AND 性别='女'
7.查询结果的排序 使用ORDER BY子句可以对查询结果排序,系统 默认为升序。ORDER BY子句必须出现在其他子句 之后。 例:查询选修了课程C140的学生学号和成绩,并按 成绩降序排列。 SELECT 学号,成绩; FROM 选课; WHERE 课程号="c140"; ORDER BY 成绩 DESC
例:查询选修.DBF中课程号为“c120”、“c140”、 “c150”、“c160”的平均成绩在80分以上的课程的 学生平均分。 SELECT 课程号,AVG(成绩) AS 平均分; FROM 选课 WHERE 课程号; IN('c120','c140','c150','c160'); GROUP BY 课程号 HAVING AVG(成绩)>=80
例:查询选修了“数据库”或“电子商务”课程的 学生学号、姓名、选课名称及成绩。 本例涉及三个表。WHERE子句中有两个联接条件 和一个筛选条件。 SELECT 学生.学号,姓名,课程名,成绩; FROM 学生,课程,选课; WHERE 学生.学号=选课.学号; AND 选课.课程号=课程.课程号; AND (课程名='数据库' OR 课程名='电子商务')