
数据结构练习题及答案 清华出版社
《数据结构》模拟题
2010年7月
一、单选题(每空2分,共10分)
1、队列的删除操作是在()进行。
A.队首B.队尾C.队前D.对后
2、当利用大小为N 的数组顺序存储一个栈时,假定用top = = N表示栈空,则退栈时,用()语句修改top指针。
A.top++; B.top=0; C.top--; D.top=N;
3、由权值分别为3,6,7,2,5的叶子结点生成一棵哈夫曼树,它的带权路径长度为()。
A.51 B.23 C.53 D.74
4、在一棵二叉树中,第4层上的结点数最多为()。
A.31 B.8 C.15 D.16
5、向堆中插入一个元素的时间复杂度为()。
A.O(log2n) B.O(n) C.O(1) D.O(nlog2n)
二、填空题(每空1分,共20分)
1、数据的逻辑结构被分为____________、___________、____________和____________四种。
2、若对一棵二叉树的结点编号从1开始顺序编码,按顺序存储,把编号为1的结点存储到
a[1]中,其余类推,则a[i]元素的左孩子元素为______,右孩子元素为_____,双亲元素
(i>0)为________。
3、从一个栈删除元素时,首先取出,然后再前移一位。
4、后缀表达式“2 10 + 5 * 6 – 9 /”的值为。
5、假定一棵树的广义表表示为A(B(C(D,E),F,G(H,I,J)),K),则度为3、2、1、0的结点数分别为
______、______、______和______个。
6、在一个具有n个顶点的无向完全图中,包含有________条边,在一个具有n个顶点的有
向完全图中,包含有________条边。
7、在索引表中,若一个索引项对应主表中的一条记录,则称此索引为________索引,若对
应主表中的若干条记录,则称此索引为________索引。
8、对于二分查找所对应的判定树,它既是一棵_ ____,又是一棵_____ __ ___。
三、运算题(每小题5分,共10分)
1、1、空堆开始依次向堆中插入线性表(64,52, 12,48,45,26)中的每个元素,请以线性表的
形式给出每插入一个元素后堆的状态。
(为小根堆)
2、在一份电文中共使用五种字符:A,G,F,U,Y,Z,它们的出现频率依次为12,9,18,7,14,11,求出每个字符的哈夫曼编码。
四、阅读算法,回答问题(每小题5分,共20分)
1、void AA (LNode * HL,const ElemType & item)
{
LNode * newptr=new Lnode ;
newptr->data=item;
LNode *p=HL;
while ( p->next!=HL )
p=p->next;
newptr->next=HL;
p->next=newptr;
}
对于结点类型为LNode的单链表,以上算法的功能为:
2、void BB(List &L)
{
int i=0;
while (i<
{
int j=i+1;
while (j<
{
if[j] = =[i])
{
for (int k=j+1;k<;k++)
[k-1]=[k];
;
}
else j++;
}
i++;
}
}
以上算法的功能为:
3、void CC(BTreeNode * & BST )
{
ElemType a[6 ]={45,23,78,35,77,25};
BST=NULL;
for( int i=0,i<6;i++)
Insert(BST , a[i]);
}
调用该算法后,生成的二叉搜索数的中序序列为:
4、void DD ( )
{
ElemType A[ ]={1,3,5,7,9,2,4,6,8,10},B[10];
TwoMerge(A, B,0,4,9);
for ( int i=0; i<10; i++)
c out<<B[i]<<” “;
cout<<endl;
}
调用该算法后,输出结果为:
五、算法填空,在画有横线的地方填写合适的内容(10分)。
利用单链表进行数据排序。
void LinkSort (ElemType a[ ],int n)
{
LNode * head=new LNode;
InitList (head);
int i;
for (i=0;i<n;i++)
Insert(head, a[i]);
LNode * p=head->next;
i=0;
while ( )
{
a[i++]=p->data;
}
ClearList (head);
}
六、编写算法(10分)
编写一个非递归算法,在稀疏有序索引表中二分查找出给定值K所对应的索引项,即索引值刚好大于等于K的索引项,返回该索引项的start域的值,若查找失败则返回-1。
《数据结构》模拟题答案及评分标准
(供参考)
一、单选题(每空2分,共10分)
1、A
2、A
3、A
4、B 5 、A
二、填空题(每空1分,共20分)
1、顺序结构、链接结构、索引结构、散列结构
2、2i+1、2i+2、⎣⎦
1)/2
-
(i3、栈顶元素、栈顶指针4、6 5、2、2、0、7
6、n(n-1)/2 、n(n-1)
7、稠密、稀疏
8、二叉搜索树、理想平衡树
三、运算题(每小题5分,共10分)
1、(64)
(52,64)
(12,64,52)
(12,48,52,64)
(12,45,52,64,48)
(12,45,26,64,48,52)
2、A:111 G:011 F:10
U:010 Y:00 Z:110
(或0、1 相反)
四、阅读算法,回答问题(每小题5分,共20分)
1、向单链表的末尾添加一个元素。
2、删除线性表中所有重复的元素。
3、23 25 35 45 77 78
4、1 2 3 4 5 6 7 8 9 10
五、算法填空,在画有横线的地方填写合适的内容(10分)。
p!=NULL
p=p->next;
delete head;
六、编写算法(10分)
int Binsch(IndexList B, int m, IndexKeyType K)
{
int low=0, high=m-1;
while (low<= high)
{
int mid=(low+high)/2;
if (K= =B[mid]. index )
return B[mid].start;
else if (K<B[mid].index)
high=mid-1;
else
low=mid+1;
}
if (low<m) return B[low].start;
else return –1;
}。
数据结构答案(清华大学出版)
若是N维数组,其中任一元素的地址该如何计算? 若是 维数组,其中任一元素的地址该如何计算? 维数组 低维优先的地址计算公式,该式称为n维数组的映像函数: 低维优先的地址计算公式,该式称为n维数组的映像函数: 优先的地址计算公式
n
0)+ Loc(j1,j2,…jn)=LOC(0,0, 0)+i =1 j )=LOC(0,0,…0)
a11 a12 … a1n ^
… …
am1 am2 … amn ^
^ 注:数组的运算参见下一节实例(稀疏矩阵的转置) 数组的运算参见下一节实例(稀疏矩阵的转置)
13
5.3 矩阵的压缩存储
讨论: 讨论: 1. 什么是压缩存储? 什么是压缩存储? 若多个数据元素的值都相同 则只分配一个元素值的存储空间, 值都相同, 若多个数据元素的值都相同,则只分配一个元素值的存储空间, 且零元素不占存储空间。 且零元素不占存储空间。 2. 所有二维数组(矩阵)都能压缩吗? 所有二维数组(矩阵)都能压缩吗? 未必,要看矩阵是否具备以上压缩条件。 未必,要看矩阵是否具备以上压缩条件。 3. 什么样的矩阵具备以上压缩条件? 什么样的矩阵具备以上压缩条件? 一些特殊矩阵,如:对称矩阵,对角矩阵,三角矩阵,稀疏矩 一些特殊矩阵, 对称矩阵,对角矩阵,三角矩阵, 阵等。 阵等。 4. 什么叫稀疏矩阵? 什么叫稀疏矩阵 稀疏矩阵? 矩阵中非零元素的个数较少(一般小于5% 5%) 矩阵中非零元素的个数较少(一般小于5%) 重点介绍稀疏矩阵的压缩和相应的操作。 重点介绍稀疏矩阵的压缩和相应的操作。
8
无论规定行优先或列优先, 无论规定行优先或列优先,只要知道以下三要素便可随时求出 任一元素的地址(这样数组中的任一元素便可以随机存取! 任一元素的地址(这样数组中的任一元素便可以随机存取!): ①开始结点的存放地址(即基地址) 开始结点的存放地址(即基地址) 维数和每维的上、下界; ②维数和每维的上、下界; ac1,c2 … ac1,d2 ③每个数组元素所占用的单元数 Amn= … aij … ad1,c2 … ad1,d2 则行优先存储时的地址公式为: 行优先存储时的地址公式为: 存储时的地址公式为 LOC(aij)=LOC(ac1,c2)+[(i-c1)*(d2-c2+1)+j-c2)]*L , aij之前的 数组基址 a 本行前面的
数据结构(C语言版清华大学出版社)-章课后部分答案
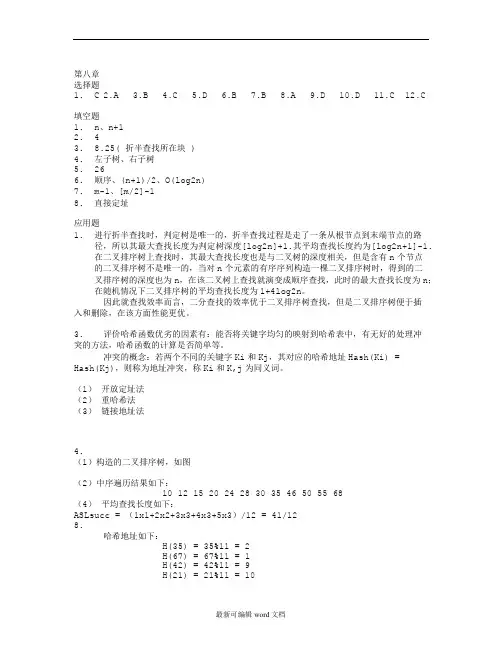
第八章选择题1. C2.A3.B4.C5.D6.B7.B8.A9.D 10.D 11.C 12.C填空题1.n、n+12. 43.8.25( 折半查找所在块 )4.左子树、右子树5.266.顺序、(n+1)/2、O(log2n)7.m-1、[m/2]-18.直接定址应用题1.进行折半查找时,判定树是唯一的,折半查找过程是走了一条从根节点到末端节点的路径,所以其最大查找长度为判定树深度[log2n]+1.其平均查找长度约为[log2n+1]-1.在二叉排序树上查找时,其最大查找长度也是与二叉树的深度相关,但是含有n个节点的二叉排序树不是唯一的,当对n个元素的有序序列构造一棵二叉排序树时,得到的二叉排序树的深度也为n,在该二叉树上查找就演变成顺序查找,此时的最大查找长度为n;在随机情况下二叉排序树的平均查找长度为1+4log2n。
因此就查找效率而言,二分查找的效率优于二叉排序树查找,但是二叉排序树便于插入和删除,在该方面性能更优。
3. 评价哈希函数优劣的因素有:能否将关键字均匀的映射到哈希表中,有无好的处理冲突的方法,哈希函数的计算是否简单等。
冲突的概念:若两个不同的关键字Ki和Kj,其对应的哈希地址Hash(Ki) =Hash(Kj),则称为地址冲突,称Ki和K,j为同义词。
(1)开放定址法(2)重哈希法(3)链接地址法4.(1)构造的二叉排序树,如图(2)中序遍历结果如下:10 12 15 20 24 28 30 35 46 50 55 68(4)平均查找长度如下:ASLsucc = (1x1+2x2+3x3+4x3+5x3)/12 = 41/128.哈希地址如下:H(35) = 35%11 = 2H(67) = 67%11 = 1H(42) = 42%11 = 9H(21) = 21%11 = 10H(29) = 29%11 = 7H(86) = 86%11 = 9H(95) = 95%11 = 7H(47) = 47%11 = 3H(50) = 50%11 = 6H(36) = 36%11 = 3H(91) = 91%11 = 3第九章选择题1. D2.C3.B4.D5.C6.B7.A8.A9.D 10.D填空题1.插入排序、交换排序、选择排序、归并排序2.移动(或者交换)3.归并排序、快速排序、堆排序4.保存当前要插入的记录,可以省去在查找插入位置时的对是否出界的判断5.O(n)、O(log2n)6.直接插入排序或者改进了的冒泡排序、快速排序7.Log2n、n8.完全二叉树、n/29.1510.{12 38 25 35 50 74 63 90}应用题11.(1)Shell排序(步长为5 3 1)每趟的排序结果初始序列为100 87 52 61 27 170 37 45 61 118 14 88 32步长为5的排序14 37 32 61 27 100 87 45 61 118 170 88 52步长为3的排序结果14 27 32 52 37 61 61 45 88 87 170 100 118步长为1的排序结果14 27 32 37 45 52 61 61 87 88 100 118最后结果14 27 32 37 45 52 61 61 87 88 100 118 170(2)快速排序每趟的排序结果如图初始序列100 87 52 61 27 170 37 45 61 118 14 88 32第一趟排序[32 87 52 61 27 88 37 45 61 14]100[118 170]第二趟排序[14 27]32[61 52 88 37 45 61 87]100 118[170]第三趟排序14[27]32[45 52 37]61[88 61 87]100 118[170]第四趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]第五趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]最后结果14[27]32[37]45[52]61[61]87 88 100 118[170](3)二路归并排序每趟的排序结果初始序列[100][87][52][61][27][170][37][45][61][118][14][88][32]第一趟归并[87 100][52 61][27 170][37 45][61 118][14 88][32]第二趟归并[52 61 87 100][27 37 45 170][14 61 88 118][32]第三趟归并排序[27 37 45 52 61 87 100 170][14 32 61 88 118]第四趟归并排序[14 27 32 37 45 52 61 61 87 88 100 118 170]最后结果14 27 32 37 45 52 61 61 87 88 100 118 17012.采用快速排序时,第一趟排序过程中的数据移动如图:算法设计题1.分析:为讨论方便,待排序记录的定义为(后面各算法都采用此定义):#define MAXSIZE 100 /* 顺序表的最大长度,假定顺序表的长度为100 */ typedef int KeyType; /* 假定关键字类型为整数类型 */typedef struct {KeyType key; /* 关键字项 */OtherType other; /* 其他项 */}DataType; /* 数据元素类型 */typedef struct {DataType R[MAXSIZE+1]; /* R[0]闲置或者充当哨站 */int length; /* 顺序表长度 */}sqList; /* 顺序表类型 */设n个整数存储在R[1..n]中,因为前n-2个元素有序,若采用直接插入算法,共要比较和移动n-2次,如果最后两个元素做一个批处理,那么比较次数和移动次数将大大减小。
数据结构 清华大学杨剑版答案

第1章 绪论一.填空题1. 数据元素,数据元素之间关系2. 集合结构,线性结构,树型结构,图型结构3. 有穷性,确定性,可行性4. 数据元素,关系,基本操作5. 逻辑结构,存储结构,运算6.时间,空间二.单项选择题三.判断题四.名词解释数据:客观事物的符号表示,在计算机科学中指所有能输入计算机中并被计算机处理的符号总称。
整数、浮点数、字符串、声音、图像。
数据元素:数据元素是数据的基本单位,在计算机程序中通常被作为一个整体进行考虑和处理。
数据元素有时也被称为元素、结点、顶点、记录等。
一个数据元素可由若干个数据项(Data Item)组成。
数据结构:数据结构是相互之间存在一种或多种特定关系的数据元素的集合。
主要描述的是数据元素之间的逻辑关系、数据在计算机系统中的存储方式和数据的运算三个方面的内容,即数据的逻辑结构、存储结构和数据的操作集合。
逻辑结构:数据的逻辑结构独立于计算机,是数据本身所固有的特性。
物理结构:数据的物理结构又称为存储结构(Storage Structure),是数据在计算机中的表示(又叫映像)和存储,包括数据元素的表示和存储以及数据元素之间关系的表示和存储。
算法:算法(Algorithm )是指在有限的时间范围内,为解决某一问题而采取的方法和步骤的准确完整的描述,它是一个有穷的规则序列,这些规则决定了解决某一特定问题的一系列运算。
算法的时间复杂度:规模为n 的算法的执行时间,称为时间复杂度(time complexity )。
五.应用题1. (n+3)(n-2)/2解析:外循环i 的取值范围是1到n-2,内循环j 的取值范围是n 到i 。
当i=1时,内循环变量j 从n 变化到1,x=x+1将执行n 次;当i=2时,内循环变量j 从n 变化到2,x=x+1将执行n-1次;依次类推,当i=n-2时,内循环变量j 从n 变化到n-2,x=x+1将执行3次;所以语句x=x+1的总的执行次数为:3+4+…+n-1+n=(n+3)(n-2)/2次。
数据结构(C语言版)9-12章练习 答案 清华大学出版社
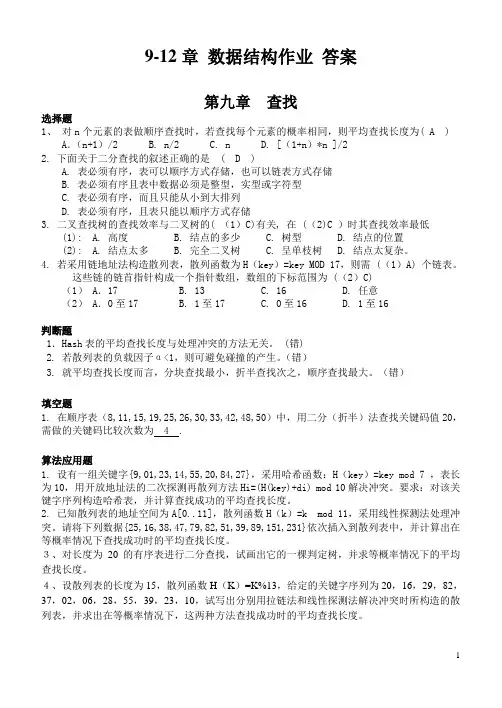
9-12章数据结构作业答案第九章查找选择题1、对n个元素的表做顺序查找时,若查找每个元素的概率相同,则平均查找长度为( A )A.(n+1)/2 B. n/2 C. n D. [(1+n)*n ]/22. 下面关于二分查找的叙述正确的是 ( D )A. 表必须有序,表可以顺序方式存储,也可以链表方式存储B. 表必须有序且表中数据必须是整型,实型或字符型C. 表必须有序,而且只能从小到大排列D. 表必须有序,且表只能以顺序方式存储3. 二叉查找树的查找效率与二叉树的( (1)C)有关, 在 ((2)C )时其查找效率最低(1): A. 高度 B. 结点的多少 C. 树型 D. 结点的位置(2): A. 结点太多 B. 完全二叉树 C. 呈单枝树 D. 结点太复杂。
4. 若采用链地址法构造散列表,散列函数为H(key)=key MOD 17,则需 ((1)A) 个链表。
这些链的链首指针构成一个指针数组,数组的下标范围为 ((2)C) (1) A.17 B. 13 C. 16 D. 任意(2) A.0至17 B. 1至17 C. 0至16 D. 1至16判断题1.Hash表的平均查找长度与处理冲突的方法无关。
(错)2. 若散列表的负载因子α<1,则可避免碰撞的产生。
(错)3. 就平均查找长度而言,分块查找最小,折半查找次之,顺序查找最大。
(错)填空题1. 在顺序表(8,11,15,19,25,26,30,33,42,48,50)中,用二分(折半)法查找关键码值20,需做的关键码比较次数为 4 .算法应用题1. 设有一组关键字{9,01,23,14,55,20,84,27},采用哈希函数:H(key)=key mod 7 ,表长为10,用开放地址法的二次探测再散列方法Hi=(H(key)+di) mod 10解决冲突。
要求:对该关键字序列构造哈希表,并计算查找成功的平均查找长度。
2. 已知散列表的地址空间为A[0..11],散列函数H(k)=k mod 11,采用线性探测法处理冲突。
数据结构习题集答案(c版)(清华大学严蔚敏)
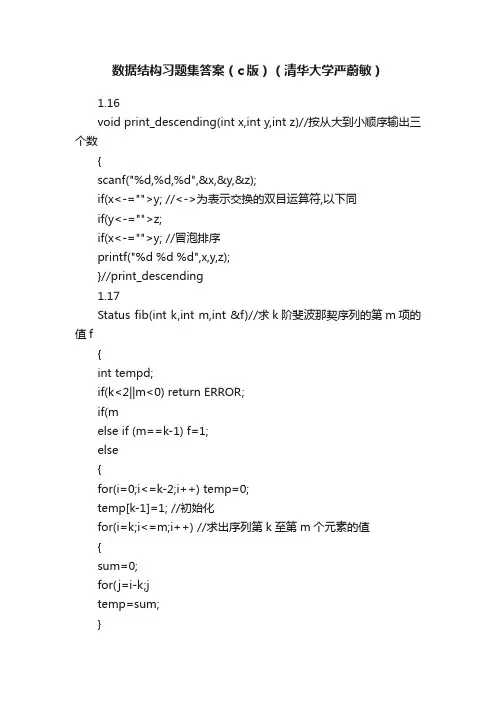
数据结构习题集答案(c版)(清华大学严蔚敏)1.16void print_descending(int x,int y,int z)//按从大到小顺序输出三个数{scanf("%d,%d,%d",&x,&y,&z);if(x<-="">y; //<->为表示交换的双目运算符,以下同if(y<-="">z;if(x<-="">y; //冒泡排序printf("%d %d %d",x,y,z);}//print_descending1.17Status fib(int k,int m,int &f)//求k阶斐波那契序列的第m项的值f{int tempd;if(k<2||m<0) return ERROR;if(melse if (m==k-1) f=1;else{for(i=0;i<=k-2;i++) temp=0;temp[k-1]=1; //初始化for(i=k;i<=m;i++) //求出序列第k至第m个元素的值{sum=0;for(j=i-k;jtemp=sum;}f=temp[m];}return OK;}//fib分析:通过保存已经计算出来的结果,此方法的时间复杂度仅为O(m^2).如果采用递归编程(大多数人都会首先想到递归方法),则时间复杂度将高达O(k^m).1.18typedef struct{char *sport;enum{male,female} gender;char schoolname; //校名为'A','B','C','D'或'E'char *result;int score;} resulttype;typedef struct{int malescore;int femalescore;int totalscore;} scoretype;void summary(resulttype result[ ])//求各校的男女总分和团体总分,假设结果已经储存在result[ ]数组中{scoretype score;i=0;while(result.sport!=NULL){switch(result.schoolname){case 'A':score[ 0 ].totalscore+=result.score;if(result.gender==0) score[ 0 ].malescore+=result.score;else score[ 0 ].femalescore+=result.score;break;case 'B':score.totalscore+=result.score;if(result.gender==0) score.malescore+=result.score;else score.femalescore+=result.score;break;……?……?……}i++;}for(i=0;i<5;i++){printf("School %d:\n",i);printf("T otal score of male:%d\n",score.malescore);printf("T otal score of female:%d\n",score.femalescore);printf("T otal score of all:%d\n\n",score.totalscore);}}//summary1.19Status algo119(int a[ARRSIZE])//求i!*2^i序列的值且不超过maxint{last=1;for(i=1;i<=ARRSIZE;i++){a[i-1]=last*2*i;if((a[i-1]/last)!=(2*i)) reurn OVERFLOW;last=a[i-1];return OK;}}//algo119分析:当某一项的结果超过了maxint时,它除以前面一项的商会发生异常.1.20void polyvalue(){float ad;float *p=a;printf("Input number of terms:");scanf("%d",&n);printf("Input the %d coefficients from a0 to a%d:\n",n,n);for(i=0;i<=n;i++) scanf("%f",p++);printf("Input value of x:");scanf("%f",&x);p=a;xp=1;sum=0; //xp用于存放x的i次方for(i=0;i<=n;i++){sum+=xp*(*p++);xp*=x;}printf("Value is:%f",sum);}//polyvalue2.10Status DeleteK(SqList &a,int i,int k)//删除线性表a中第i个元素起的k个元素{if(i<1||k<0||i+k-1>a.length) return INFEASIBLE;for(count=1;i+count-1<=a.length-k;count++) //注意循环结束的条件a.elem[i+count-1]=a.elem[i+count+k-1];a.length-=k;return OK;}//DeleteK2.11Status Insert_SqList(SqList &va,int x)//把x插入递增有序表va 中{if(va.length+1>va.listsize) return ERROR;va.length++;for(i=va.length-1;va.elem>x&&i>=0;i--)va.elem[i+1]=va.elem;va.elem[i+1]=x;return OK;}//Insert_SqList2.12int ListComp(SqList A,SqList B)//比较字符表A和B,并用返回值表示结果,值为正,表示A>B;值为负,表示A< p="">{for(i=1;A.elem||B.elem;i++)if(A.elem!=B.elem) return A.elem-B.elem;return 0;}//ListComp2.13LNode* Locate(LinkList L,int x)//链表上的元素查找,返回指针{for(p=l->next;p&&p->data!=x;p=p->next);return p;}//Locate2.14int Length(LinkList L)//求链表的长度{for(k=0,p=L;p->next;p=p->next,k++);return k;}//Length2.15void ListConcat(LinkList ha,LinkList hb,LinkList &hc)//把链表hb接在ha后面形成链表hc{hc=ha;p=ha;while(p->next) p=p->next;p->next=hb;}//ListConcat2.16见书后答案.2.17Status Insert(LinkList &L,int i,int b)//在无头结点链表L的第i个元素之前插入元素b{p=L;q=(LinkList*)malloc(sizeof(LNode));q.data=b;if(i==1){q.next=p;L=q; //插入在链表头部}else{while(--i>1) p=p->next;q->next=p->next;p->next=q; //插入在第i个元素的位置}}//Insert2.18Status Delete(LinkList &L,int i)//在无头结点链表L中删除第i个元素{if(i==1) L=L->next; //删除第一个元素else{p=L;while(--i>1) p=p->next;p->next=p->next->next; //删除第i个元素}}//Delete2.19Status Delete_Between(Linklist &L,int mink,int maxk)//删除元素递增排列的链表L 中值大于mink且小于maxk的所有元素{p=L;while(p->next->data<=mink) p=p->next; //p是最后一个不大于mink的元素if(p->next) //如果还有比mink更大的元素{q=p->next;while(q->datanext; //q是第一个不小于maxk的元素p->next=q;}}//Delete_Between2.20Status Delete_Equal(Linklist &L)//删除元素递增排列的链表L中所有值相同的元素{p=L->next;q=p->next; //p,q指向相邻两元素while(p->next){if(p->data!=q->data){p=p->next;q=p->next; //当相邻两元素不相等时,p,q都向后推一步}else{while(q->data==p->data){free(q);q=q->next;}p->next=q;p=q;q=p->next; //当相邻元素相等时删除多余元素}//else}//while}//Delete_Equal2.21void reverse(SqList &A)//顺序表的就地逆置{for(i=1,j=A.length;i<j;i++,j--)< p="">A.elem<->A.elem[j];}//reverse2.22void LinkList_reverse(Linklist &L)//链表的就地逆置;为简化算法,假设表长大于2 {p=L->next;q=p->next;s=q->next;p->next=NULL;{q->next=p;p=q;q=s;s=s->next; //把L的元素逐个插入新表表头}q->next=p;s->next=q;L->next=s;}//LinkList_reverse分析:本算法的思想是,逐个地把L的当前元素q插入新的链表头部,p为新表表头.2.23void merge1(LinkList &A,LinkList &B,LinkList &C)//把链表A 和B合并为C,A和B的元素间隔排列,且使用原存储空间{p=A->next;q=B->next;C=A;while(p&&q){s=p->next;p->next=q; //将B的元素插入if(s){t=q->next;q->next=s; //如A非空,将A的元素插入}p=s;q=t;}//while}//merge12.24void reverse_merge(LinkList &A,LinkList &B,LinkList &C)//把元素递增排列的链表A 和B合并为C,且C中元素递减排列,使用原空间{pa=A->next;pb=B->next;pre=NULL; //pa和pb分别指向A,B 的当前元素{if(pa->datadata||!pb){pc=pa;q=pa->next;pa->next=pre;pa=q; //将A的元素插入新表}else{pc=pb;q=pb->next;pb->next=pre;pb=q; //将B的元素插入新表}pre=pc;}C=A;A->next=pc; //构造新表头}//reverse_merge分析:本算法的思想是,按从小到大的顺序依次把A和B的元素插入新表的头部pc处,最后处理A或B的剩余元素.2.25void SqList_Intersect(SqList A,SqList B,SqList &C)//求元素递增排列的线性表A和B 的元素的交集并存入C中{i=1;j=1;k=0;while(A.elem&&B.elem[j]){if(A.elem<="" p="">if(A.elem>B.elem[j]) j++;if(A.elem==B.elem[j]){C.elem[++k]=A.elem; //当发现了一个在A,B中都存在的元素,i++;j++; //就添加到C中}}//while}//SqList_Intersect2.26void LinkList_Intersect(LinkList A,LinkList B,LinkList &C)//在链表结构上重做上题{p=A->next;q=B->next;pc=(LNode*)malloc(sizeof(LNode));while(p&&q){if(p->datadata) p=p->next;else if(p->data>q->data) q=q->next;else{s=(LNode*)malloc(sizeof(LNode));s->data=p->data;pc->next=s;pc=s;p=p->next;q=q->next;}}//whileC=pc;}//LinkList_Intersect2.27void SqList_Intersect_True(SqList &A,SqList B)//求元素递增排列的线性表A和B的元素的交集并存回A中{i=1;j=1;k=0;while(A.elem&&B.elem[j]){if(A.elem<="" p="">else if(A.elem>B.elem[j]) j++;else if(A.elem!=A.elem[k]){A.elem[++k]=A.elem; //当发现了一个在A,B中都存在的元素i++;j++; //且C中没有,就添加到C中}}//whilewhile(A.elem[k]) A.elem[k++]=0;}//SqList_Intersect_True2.28void LinkList_Intersect_True(LinkList &A,LinkList B)//在链表结构上重做上题{p=A->next;q=B->next;pc=A;while(p&&q){if(p->datadata) p=p->next;else if(p->data>q->data) q=q->next;else if(p->data!=pc->data){pc=pc->next;pc->data=p->data;p=p->next;q=q->next;}}//while}//LinkList_Intersect_True2.29void SqList_Intersect_Delete(SqList &A,SqList B,SqList C){i=0;j=0;k=0;m=0; //i指示A中元素原来的位置,m为移动后的位置while(i<a.length&&j<b.length&& k<c.length)<="" p="">{if(B.elem[j]<="" p="">else if(B.elem[j]>C.elem[k]) k++;else{same=B.elem[j]; //找到了相同元素samewhile(B.elem[j]==same) j++;while(C.elem[k]==same) k++; //j,k后移到新的元素while(i<a.length&&a.elem<same)< p="">A.elem[m++]=A.elem[i++]; //需保留的元素移动到新位置while(i<a.length&&a.elem==same) i++;="" p="" 跳过相同的元素<="">}}//whilewhile(i<a.length)< p="">A.elem[m++]=A.elem[i++]; //A的剩余元素重新存储。
数据结构习题集答案(c版)(清华大学 严蔚敏)
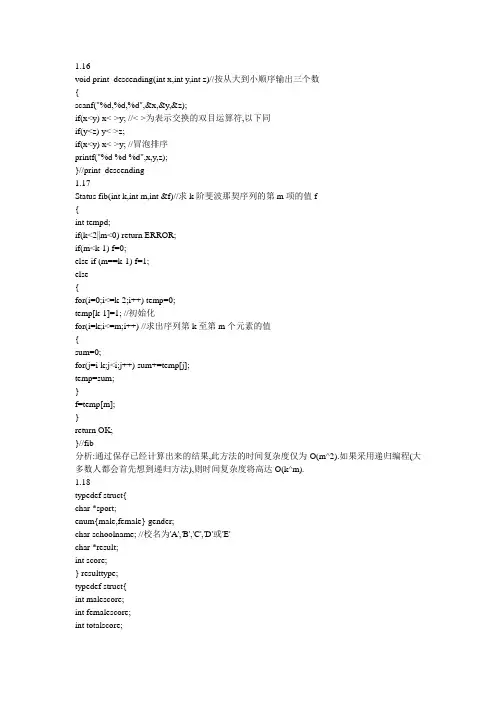
1.16void print_descending(int x,int y,int z)//按从大到小顺序输出三个数{scanf("%d,%d,%d",&x,&y,&z);if(x<y) x<->y; //<->为表示交换的双目运算符,以下同if(y<z) y<->z;if(x<y) x<->y; //冒泡排序printf("%d %d %d",x,y,z);}//print_descending1.17Status fib(int k,int m,int &f)//求k阶斐波那契序列的第m项的值f{int tempd;if(k<2||m<0) return ERROR;if(m<k-1) f=0;else if (m==k-1) f=1;else{for(i=0;i<=k-2;i++) temp=0;temp[k-1]=1; //初始化for(i=k;i<=m;i++) //求出序列第k至第m个元素的值{sum=0;for(j=i-k;j<i;j++) sum+=temp[j];temp=sum;}f=temp[m];}return OK;}//fib分析:通过保存已经计算出来的结果,此方法的时间复杂度仅为O(m^2).如果采用递归编程(大多数人都会首先想到递归方法),则时间复杂度将高达O(k^m).1.18typedef struct{char *sport;enum{male,female} gender;char schoolname; //校名为'A','B','C','D'或'E'char *result;int score;} resulttype;typedef struct{int malescore;int femalescore;int totalscore;} scoretype;void summary(resulttype result[ ])//求各校的男女总分和团体总分,假设结果已经储存在result[ ]数组中{scoretype score;i=0;while(result.sport!=NULL){switch(result.schoolname){case 'A':score[ 0 ].totalscore+=result.score;if(result.gender==0) score[ 0 ].malescore+=result.score;else score[ 0 ].femalescore+=result.score;break;case 'B':score.totalscore+=result.score;if(result.gender==0) score.malescore+=result.score;else score.femalescore+=result.score;break;……?……?……}i++;}for(i=0;i<5;i++){printf("School %d:\n",i);printf("Total score of male:%d\n",score.malescore);printf("Total score of female:%d\n",score.femalescore);printf("Total score of all:%d\n\n",score.totalscore);}}//summary1.19Status algo119(int a[ARRSIZE])//求i!*2^i序列的值且不超过maxint{last=1;for(i=1;i<=ARRSIZE;i++){a[i-1]=last*2*i;if((a[i-1]/last)!=(2*i)) reurn OVERFLOW;last=a[i-1];return OK;}}//algo119分析:当某一项的结果超过了maxint时,它除以前面一项的商会发生异常.1.20void polyvalue(){float ad;float *p=a;printf("Input number of terms:");scanf("%d",&n);printf("Input the %d coefficients from a0 to a%d:\n",n,n);for(i=0;i<=n;i++) scanf("%f",p++);printf("Input value of x:");scanf("%f",&x);p=a;xp=1;sum=0; //xp用于存放x的i次方for(i=0;i<=n;i++){sum+=xp*(*p++);xp*=x;}printf("Value is:%f",sum);}//polyvalue2.10Status DeleteK(SqList &a,int i,int k)//删除线性表a中第i个元素起的k个元素{if(i<1||k<0||i+k-1>a.length) return INFEASIBLE;for(count=1;i+count-1<=a.length-k;count++) //注意循环结束的条件a.elem[i+count-1]=a.elem[i+count+k-1];a.length-=k;return OK;}//DeleteK2.11Status Insert_SqList(SqList &va,int x)//把x插入递增有序表va中{if(va.length+1>va.listsize) return ERROR;va.length++;for(i=va.length-1;va.elem>x&&i>=0;i--)va.elem[i+1]=va.elem;va.elem[i+1]=x;return OK;}//Insert_SqList2.12int ListComp(SqList A,SqList B)//比较字符表A和B,并用返回值表示结果,值为正,表示A>B;值为负,表示A<B;值为零,表示A=B{for(i=1;A.elem||B.elem;i++)if(A.elem!=B.elem) return A.elem-B.elem;return 0;}//ListComp2.13LNode* Locate(LinkList L,int x)//链表上的元素查找,返回指针{for(p=l->next;p&&p->data!=x;p=p->next);return p;}//Locate2.14int Length(LinkList L)//求链表的长度{for(k=0,p=L;p->next;p=p->next,k++);return k;}//Length2.15void ListConcat(LinkList ha,LinkList hb,LinkList &hc)//把链表hb接在ha后面形成链表hc {hc=ha;p=ha;while(p->next) p=p->next;p->next=hb;}//ListConcat2.16见书后答案.2.17Status Insert(LinkList &L,int i,int b)//在无头结点链表L的第i个元素之前插入元素b {p=L;q=(LinkList*)malloc(sizeof(LNode));q.data=b;if(i==1){q.next=p;L=q; //插入在链表头部}else{while(--i>1) p=p->next;q->next=p->next;p->next=q; //插入在第i个元素的位置}}//Insert2.18Status Delete(LinkList &L,int i)//在无头结点链表L中删除第i个元素{if(i==1) L=L->next; //删除第一个元素else{p=L;while(--i>1) p=p->next;p->next=p->next->next; //删除第i个元素}}//Delete2.19Status Delete_Between(Linklist &L,int mink,int maxk)//删除元素递增排列的链表L中值大于mink且小于maxk的所有元素{p=L;while(p->next->data<=mink) p=p->next; //p是最后一个不大于mink的元素if(p->next) //如果还有比mink更大的元素{q=p->next;while(q->data<maxk) q=q->next; //q是第一个不小于maxk的元素p->next=q;}}//Delete_Between2.20Status Delete_Equal(Linklist &L)//删除元素递增排列的链表L中所有值相同的元素{p=L->next;q=p->next; //p,q指向相邻两元素while(p->next){if(p->data!=q->data){p=p->next;q=p->next; //当相邻两元素不相等时,p,q都向后推一步}else{while(q->data==p->data){free(q);q=q->next;}p->next=q;p=q;q=p->next; //当相邻元素相等时删除多余元素}//else}//while}//Delete_Equal2.21void reverse(SqList &A)//顺序表的就地逆置{for(i=1,j=A.length;i<j;i++,j--)A.elem<->A.elem[j];}//reverse2.22void LinkList_reverse(Linklist &L)//链表的就地逆置;为简化算法,假设表长大于2{p=L->next;q=p->next;s=q->next;p->next=NULL;while(s->next){q->next=p;p=q;q=s;s=s->next; //把L的元素逐个插入新表表头}q->next=p;s->next=q;L->next=s;}//LinkList_reverse分析:本算法的思想是,逐个地把L的当前元素q插入新的链表头部,p为新表表头.2.23void merge1(LinkList &A,LinkList &B,LinkList &C)//把链表A和B合并为C,A和B的元素间隔排列,且使用原存储空间{p=A->next;q=B->next;C=A;while(p&&q){s=p->next;p->next=q; //将B的元素插入if(s){t=q->next;q->next=s; //如A非空,将A的元素插入}p=s;q=t;}//while}//merge12.24void reverse_merge(LinkList &A,LinkList &B,LinkList &C)//把元素递增排列的链表A和B合并为C,且C中元素递减排列,使用原空间{pa=A->next;pb=B->next;pre=NULL; //pa和pb分别指向A,B的当前元素while(pa||pb){if(pa->data<pb->data||!pb){pc=pa;q=pa->next;pa->next=pre;pa=q; //将A的元素插入新表}else{pc=pb;q=pb->next;pb->next=pre;pb=q; //将B的元素插入新表}pre=pc;}C=A;A->next=pc; //构造新表头}//reverse_merge分析:本算法的思想是,按从小到大的顺序依次把A和B的元素插入新表的头部pc处,最后处理A或B的剩余元素.2.25void SqList_Intersect(SqList A,SqList B,SqList &C)//求元素递增排列的线性表A和B的元素的交集并存入C中{i=1;j=1;k=0;while(A.elem&&B.elem[j]){if(A.elem<B.elem[j]) i++;if(A.elem>B.elem[j]) j++;if(A.elem==B.elem[j]){C.elem[++k]=A.elem; //当发现了一个在A,B中都存在的元素,i++;j++; //就添加到C中}}//while}//SqList_Intersect2.26void LinkList_Intersect(LinkList A,LinkList B,LinkList &C)//在链表结构上重做上题{p=A->next;q=B->next;pc=(LNode*)malloc(sizeof(LNode));while(p&&q){if(p->data<q->data) p=p->next;else if(p->data>q->data) q=q->next;else{s=(LNode*)malloc(sizeof(LNode));s->data=p->data;pc->next=s;pc=s;p=p->next;q=q->next;}}//whileC=pc;}//LinkList_Intersect2.27void SqList_Intersect_True(SqList &A,SqList B)//求元素递增排列的线性表A和B的元素的交集并存回A中{i=1;j=1;k=0;while(A.elem&&B.elem[j]){if(A.elem<B.elem[j]) i++;else if(A.elem>B.elem[j]) j++;else if(A.elem!=A.elem[k]){A.elem[++k]=A.elem; //当发现了一个在A,B中都存在的元素i++;j++; //且C中没有,就添加到C中}}//whilewhile(A.elem[k]) A.elem[k++]=0;}//SqList_Intersect_True2.28void LinkList_Intersect_True(LinkList &A,LinkList B)//在链表结构上重做上题{p=A->next;q=B->next;pc=A;while(p&&q){if(p->data<q->data) p=p->next;else if(p->data>q->data) q=q->next;else if(p->data!=pc->data){pc=pc->next;pc->data=p->data;p=p->next;q=q->next;}}//while}//LinkList_Intersect_True2.29void SqList_Intersect_Delete(SqList &A,SqList B,SqList C){i=0;j=0;k=0;m=0; //i指示A中元素原来的位置,m为移动后的位置while(i<A.length&&j<B.length&& k<C.length){if(B.elem[j]<C.elem[k]) j++;else if(B.elem[j]>C.elem[k]) k++;else{same=B.elem[j]; //找到了相同元素samewhile(B.elem[j]==same) j++;while(C.elem[k]==same) k++; //j,k后移到新的元素while(i<A.length&&A.elem<same)A.elem[m++]=A.elem[i++]; //需保留的元素移动到新位置while(i<A.length&&A.elem==same) i++; //跳过相同的元素}}//whilewhile(i<A.length)A.elem[m++]=A.elem[i++]; //A的剩余元素重新存储。
清华大学数据结构试题及答案
清华大学数据结构试题及答案以下是清华大学数据结构试题及答案:试题一:1. 请解释什么是数据结构。
答案:数据结构是计算机科学中研究数据的组织、存储和管理方式的学科。
它涉及到数据的表示、操作以及与之相关的算法的设计和实现。
2. 请列举常见的数据结构类型。
答案:常见的数据结构类型包括数组、链表、栈、队列、树、图等。
3. 请解释什么是算法。
答案:算法是一系列解决特定问题的指令和计算步骤。
它描述了在给定输入的情况下,如何进行计算并产生所需输出。
4. 请列举一些常见的算法。
答案:常见的算法包括排序算法(如冒泡排序、插入排序、快速排序)、查找算法(如二分查找、哈希查找)、图算法(如深度优先搜索、广度优先搜索)等。
5. 请解释什么是时间复杂度和空间复杂度。
答案:时间复杂度是描述算法执行时间与输入规模之间的关系。
空间复杂度是描述算法所需内存空间与输入规模之间的关系。
试题二:1. 请给出数组和链表的区别。
答案:数组是一块连续的内存空间,元素在内存中按照索引顺序排列。
链表是由节点组成的数据结构,每个节点包含数据和指向下一个节点的指针。
2. 请解释什么是栈和队列。
答案:栈是一种后进先出(LIFO)的数据结构,只允许在栈顶进行插入和删除操作。
队列是一种先进先出(FIFO)的数据结构,允许在队尾插入数据,在队头删除数据。
3. 请给出树和图的区别。
答案:树是一种由节点和边组成的数据结构,每个节点可以有多个子节点。
图是一种由节点和边组成的数据结构,节点之间的关系可以是任意的,包括有向和无向边。
4. 请解释什么是哈希表。
答案:哈希表是一种通过哈希函数将键映射到特定位置的数据结构。
它能够快速地进行插入、删除和查找操作。
5. 请解释什么是递归。
答案:递归是一种通过调用自身的方法或函数来解决问题的编程技巧。
在递归过程中,问题会被拆分成一个或多个规模较小的子问题,直到达到基本情况。
以上就是清华大学数据结构试题及答案,希望对您有所帮助。
数据结构习题集答案解析_清华大学版
第1章 绪论1.1 简述下列术语:数据,数据元素、数据对象、数据结构、存储结构、数据类型和抽象数据类型。
解:数据是对客观事物的符号表示。
在计算机科学中是指所有能输入到计算机中并被计算机程序处理的符号的总称。
数据元素是数据的基本单位,在计算机程序常作为一个整体进行考虑和处理。
数据对象是性质相同的数据元素的集合,是数据的一个子集。
数据结构是相互之间存在一种或多种特定关系的数据元素的集合。
存储结构是数据结构在计算机中的表示。
数据类型是一个值的集合和定义在这个值集上的一组操作的总称。
抽象数据类型是指一个数学模型以及定义在该模型上的一组操作。
是对一般数据类型的扩展。
1.2 试描述数据结构和抽象数据类型的概念与程序设计语言中数据类型概念的区别。
解:抽象数据类型包含一般数据类型的概念,但含义比一般数据类型更广、更抽象。
一般数据类型由具体语言系统部定义,直接提供给编程者定义用户数据,因此称它们为预定义数据类型。
抽象数据类型通常由编程者定义,包括定义它所使用的数据和在这些数据上所进行的操作。
在定义抽象数据类型中的数据部分和操作部分时,要求只定义到数据的逻辑结构和操作说明,不考虑数据的存储结构和操作的具体实现,这样抽象层次更高,更能为其他用户提供良好的使用接口。
1.3 设有数据结构(D,R),其中{}4,3,2,1d d d d D =,{}r R =,()()(){}4,3,3,2,2,1d d d d d d r =试按图论中图的画法惯例画出其逻辑结构图。
解:1.4 试仿照三元组的抽象数据类型分别写出抽象数据类型复数和有理数的定义(有理数是其分子、分母均为自然数且分母不为零的分数)。
解:ADT Complex{ 数据对象:D={r,i|r,i 为实数} 数据关系:R={<r,i>} 基本操作: InitComplex(&C,re,im)操作结果:构造一个复数C ,其实部和虚部分别为re 和im DestroyCmoplex(&C)操作结果:销毁复数C Get(C,k,&e) 操作结果:用e 返回复数C 的第k 元的值 Put(&C,k,e) 操作结果:改变复数C 的第k 元的值为eIsAscending(C)操作结果:如果复数C 的两个元素按升序排列,则返回1,否则返回0IsDescending(C)操作结果:如果复数C的两个元素按降序排列,则返回1,否则返回0 Max(C,&e)操作结果:用e返回复数C的两个元素中值较大的一个Min(C,&e)操作结果:用e返回复数C的两个元素中值较小的一个}ADT ComplexADT RationalNumber{数据对象:D={s,m|s,m为自然数,且m不为0}数据关系:R={<s,m>}基本操作:InitRationalNumber(&R,s,m)操作结果:构造一个有理数R,其分子和分母分别为s和mDestroyRationalNumber(&R)操作结果:销毁有理数RGet(R,k,&e)操作结果:用e返回有理数R的第k元的值Put(&R,k,e)操作结果:改变有理数R的第k元的值为eIsAscending(R)操作结果:若有理数R的两个元素按升序排列,则返回1,否则返回0 IsDescending(R)操作结果:若有理数R的两个元素按降序排列,则返回1,否则返回0 Max(R,&e)操作结果:用e返回有理数R的两个元素中值较大的一个Min(R,&e)操作结果:用e返回有理数R的两个元素中值较小的一个}ADT RationalNumber1.5 试画出与下列程序段等价的框图。
清华大学数据结构试题及答案-格式整理版
一、单选题(每题 2 分,共20分)1.对一个算法的评价,不包括如下()方面的内容。
A.健壮性和可读性 B.并行性 C.正确性 D.时空复杂度2.在带有头结点的单链表HL中,要向表头插入一个由指针p指向的结点,则执行( )。
A. p->next=HL->next; HL->next=p;B. p->next=HL; HL=p;C. p->next=HL; p=HL;D. HL=p; p->next=HL;3对线性表,在下列哪种情况下应当采用链表表示?( )A.经常需要随机地存取元素B.经常需要进行插入和删除操作C.表中元素需要占据一片连续的存储空间D.表中元素的个数不变4.一个栈的输入序列为1 2 3,则下列序列中不可能是栈的输出序列的是( )A. 2 3 1B. 3 2 1C. 3 1 2D. 1 2 35. AOV网是一种()。
A.有向图 B.无向图 C.无向无环图 D.有向无环图6采用开放定址法处理散列表的冲突时,其平均查找长度()。
A.低于链接法处理冲突 B. 高于链接法处理冲突C.与链接法处理冲突相同 D.高于二分查找7.若需要利用形参直接访问实参时,应将形参变量说明为()参数。
A.值 B.函数 C.指针 D.引用8.在稀疏矩阵的带行指针向量的链接存储中,每个单链表中的结点都具有相同的()。
A.行号 B.列号 C.元素值 D.非零元素个数9.快速排序在最坏情况下的时间复杂度为()。
A.O(log2n) B.O(nlog2n) C.0(n) D.0(n2)10.从二叉搜索树中查找一个元素时,其时间复杂度大致为( )。
A. O(n)B. O(1)C. O(log2n)D. O(n2)二、运算题(每题6 分,共24分)1.数据结构是指数据及其相互之间的______________。
当结点之间存在M对N(M:N)的联系时,称这种结构为_____________________。
数据结构课后习题答案清华大学出版社殷人昆
}
friend ostream& operator<< (ostream&os, complex&ob ){
//友元函数:重载<<,将复数ob输出到输出流对象os中。
returnos << ob.Re << ( ob.Im >= 0.0 )?“+” : “-” <<fabs( ob.Im ) << “i”;
#include<iostream.h>
#include<math.h>
#include“complex.h”
complex&complex:: operator+ ( complex&ob ){
//重载函数:复数加法运算。
complex * result =newcomplex ( Re + ob.Re, Im + ob.Im );
算法和程序不同,程序可以不满足上述的特性(4)。例如,一个操作系统在用户未使用前一直处于“等待”的循环中,直到出现新的用户事件为止。这样的系统可以无休止地运行,直到系统停工。
此外,算法是面向功能的,通常用面向过程的方式描述;程序可以用面向对象方式搭建它的框架。
1-7设n为正整数,分析下列各程序段中加下划线的语句的程序步数。
i = 4时,i = 5,j = j + i = ( 4 + 1 + 2 + 3 ) + 5 = 5 +1 + 2 + 3 + 4,
……
i = k时,i = k + 1,j = j + i = ( k + 1 ) + ( 1 + 2 + 3 + 4 +…+ k ),