
数据库基本查询语句-SQL
第4章数据利器——SQL本章通过实例的方法引导读者快速掌握SQL的使用,从而能够利用【SQL Plus Worksheet】等工具,使用标准SQL语言完成对数据库数据的日常管理工作。
4.1节介绍SQL的概念、主要特点、使用SQL的工具、SQL如何访问数据表以及本书实例所使用的两个数据表。
4.2节介绍对单个数据表进行的查询操作。
4.3节介绍如何对多个数据表同时进行查询操作。
4.4节介绍稍复杂的嵌套查询。
4.5节介绍了最常用的查询函数。
4.6节介绍如何使使用SQL录入数据。
4.7节介绍了如何使用SQL删除数据。
4.8节介绍如何使用SQL更新数据。
4.1 SQL概述4.1.1 SQL是什么SQL(Structured Query Language,译为结构化查询语言)在关系型数据库中的地位就犹如英语在世界上的地位。
它是数据库系统的通用语言,利用它,用户可以用几乎同样的语句在不同的数据库系统上执行同样的操作。
比如“select * from 数据表名”代表要从某个数据表中取出全部数据,在Oracle 9i、SQL Server 2000、Foxpro等关系型数据库中都可以使用这条语句。
SQL已经被ANSI(美国国家标准化组织)确定为数据库系统的工业标准。
SQL语言按照功能可以分为4大类。
数据查询语言DQL:查询数据。
数据定义语言DDL:建立、删除和修改数据对象。
数据操纵语言DML:完成数据操作的命令,包括查询。
数据控制语言DCL:控制对数据库的访问,服务器的关闭、启动等。
4.1.2 SQL的主要特点SQL语言简单易学、风格统一,利用简单的几个英语单词的组合就可以完成所有的功能。
在SQLPlus Worksheet环境下可以单独使用的SQL语句,几乎可以不加修改地嵌入到如VB、PB这样的前端开发平台上,利用前端工具的计算能力和SQL的数据库操纵能力,可以快速建立数据库应用程序。
4.1.3 Oracle 9i 使用SQL 的工具在Oracle 9i 中为使用SQL 语言提供了两个主要的工具。
【SQL Plus 】【SQLPlus Worksheet 】两种工具在使用上功能都相同,但在可操作性上,【SQLPlus Worksheet 】更适合初学者。
因此,本书重点介绍后者的使用。
4.1.4 SQL 中访问数据表的方法在SQL 语言中访问数据表是通过“用户名.数据表”的形式来进行的。
比如在Oracle 9i 数据库服务器安装过程中,默认建立有scott 用户,该用户对dept 数据表和emp 数据表有数据查询的权限,因此访问数据表的语句为select * from scott.emp 。
当然,如果用户是用scott 用户本身登录的,则访问数据表的语句可以简化为select * from emp ,实质是一样的。
在本章的实例中,我们以数据库系统管理员system 、口令manager 登录数据库,访问数据必须采用select * from scott.emp 的形式。
即使是用户本身登录后访问属于自己的数据表,我们也推荐使用“用户名.数据表”的形式来访问数据表以清楚地反映数据表的有权用户信息。
4.1.5 两个范例数据表在读者没有学习如何创建数据表,如何创建用户,如何将用户赋予对数据表的访问权限之前,我们以数据库已经建立的两个范例数据表为例来介绍。
(1)启动【SQLPlus Worksheet 】(2)在【命令编辑区】输入语句“desc scott.emp ”,然后单击【执行】按钮,出现如图4.1所示的emp 数据表结构。
【参见光盘文件】:\第4章\4.1\415-1.sql。
图4.1 scott.emp 数据表结构desc ,describe 命令的简化形式,作用是显示数据表的结构。
使用形式:“desc 数据表名”。
(3)在【命令编辑区】输入“desc scott.dept”,然后单击【执行】按钮,出现如图4.2所示的scott.dept数据表结构。
【参见光盘文件】:\第4章\4.1\415-2.sql。
图4.2 scott.dept数据表结构接下来我们以实际查询例子来介绍数据查询的语法,读者可以参照配套光盘的实例跟随本书执行同样的操作。
4.2 用SQL进行单表查询单表查询是相对多表查询而言的,指从一个数据表中查询数据。
4.2.1 查询所有的记录在【命令编辑区】执行输入“select * from scott.emp”,然后单击【执行】按钮,出现如图4.3所示的emp数据表所有记录。
【参见光盘文件】:\第4章\4.2\421.sql。
图4.3 查询emp数据表所有记录select * from 数据表,这里的“*”代表数据表中所有的字段。
4.2.2 查询所有记录的某些字段在【命令编辑区】输入“select empno,ename,job from scott.emp”,然后单击【执行】按钮,将显示emp数据表的empno、ename和job字段,如图4.4所示。
【参见光盘文件】:\第4章\4.2\422.sql。
图4.4 查询emp数据表的empno、ename和job字段select 字段名1, 字段名2,…… from 数据表,将显示某些特定的字段,注意这里的字段名之间的逗号是英文状态下的逗号。
4.2.3 查询某些字段不同记录在图4.4所示的job字段中,可以发现有相同的数据,为了查询有多少种不同的job,在【命令编辑区】输入“select distinct job from scott.emp”,然后单击【执行】按钮,出现如图4.5所示的结果。
【参见光盘文件】:\第4章\4.2\423.sql。
图4.5 查询不同的job字段select distinct 字段名 from 数据表,这里的“distinct”保留字指在显示时去除相同的记录,与之对应的是“all”将保留相同的记录,默认为“all”。
4.2.4 单条件的查询(1)在【命令编辑区】输入“select empno,ename,job from scott.emp where job=’MANAGER’”,然后单击【执行】按钮,出现如图4.6所示的字符型字段条件查询的结果,查询的是job为MANAGER的记录。
【参见光盘文件】:\第4章\4.2\424-1.sql。
图4.6 查询满足字符型字段条件的记录(2)在【命令编辑区】输入“select empno,ename,sal from scott.emp where sal<=2500”,然后单击【执行】按钮,出现如图4.7所示的数字型字段条件查询的结果,查询的是满足sal 小于等于2500的记录。
【参见光盘文件】:\第4章\4.2\424-2.sql。
图4.7 查询满足数字型字段条件的记录where可以指定查询条件,如果是指定字符型字段查询条件,形式为字段名运算符'字符串';如果是指定数字型字段查询条件,形式为字段名运算符'字符串'。
单条件查询使用的比较运算符如表4.1所示。
【参见光盘文件】:\第4章\4.2\table41.sql。
表4.1 比较运算符名称实例=(等于)select * from scott.emp where job=’MANAGER’;select * from scott.emp where sal=1100;续表 名称实例select * from scott.emp where job!=’MANAGER’;!= (不等于)select * from scott.emp where sal!=1100;select * from scott.emp where job^=’MANAGER’;^=(不等于)select * from scott.emp where sal^=1100;select * from scott.emp where job<>’MANAGER’;<>(不等于)select * from scott.emp where sal<>1100;select * from scott.emp where sal<2000;<(小于)select * from scott.emp where job<’MANAGER’;select * from scott.emp where sal>2000;>(大于)select * from scott.emp where job>’MANAGER’;select * from scott.emp where sal<=2000;<=(小于等于)select * from scott.emp where job<=’MANAGER’;select * from scott.emp where sal>=2000;>=(大于等于)select * from scott.emp where job>=’MANAGER’;select * from scott.emp where sal in (2000,1000,3000);in(列表)select * from scott.emp where job in (’MANAGER’,’CLERK’);select * from scott.emp where sal not in (2000,1000,3000);not in(不在列表)select * from scott.emp where job not in (’MANAGER’,’CLERK’);select * from scott.emp where sal between 2000 and 3000;between(介于之间)select * from scott.emp where job between’MANAGER’ and ’CLERK’;not betweenselect * from scott.emp where sal not between 2000 and 3000;(不介于之间) select * from scott.emp where job not between’MANAGER’ and ’CLERK’;like(模式匹配)select * from scott.emp where job like ’M%’;select * from scott.emp where job like ’M__’;not likeselect * from scott.emp where job not like ’M%’;(模式不匹配) select * from scott.emp where job not like ’M__’;Is nullselect * from scott.emp where sal is null;(是否为空) select * from scott.emp where job is null;is not null(是否为select * from scott.emp where sal is not null;空)select * from scott.emp where job is not null;like和not like适合字符型字段的查询,%代表任意长度的字符串,_下划线代表一个任意的字符。
SQL基础复习03--数据查询SQL语句(单表查询)
SQL基础复习03--数据查询SQL语句(单表查询)参考教材《数据库系统:原理、设计与编程(MOOC版)》,陆鑫张凤荔陈安龙终于到查询这⼀块了。
3.4 数据查询SQL语句3.4.1 查询语句基本结构SELECT [ALL/DISTINCT] <⽬标列>[,<⽬标列>...][INTO <新表>]FROM <表名>[,<表名>...][WHERE <条件表达式>][GROUP BY <列名> [HAVING <条件表达式>]ORDER BY <列名> [ASC/DESC]];SELECT语句由多种字句组成:1. SELECT⼦句,⽤来指明从数据库表中需要查询的⽬标列。
ALL是默认操作,获取所有满⾜条件的数据⾏;DISTINCT⽤来去掉结果集中的重复数据⾏;<⽬标列>为被查询表的指定列名,可以有多个。
2. INTO⼦句,⽤来将被查询的结果集数据插⼊新表。
3. FROM⼦句,⽤来指定被查询的数据来⾃哪个表或哪些表。
多表⽤逗号分隔。
4. WHERE⼦句,⽤来给出查询的检索条件,多个条件之间可以⽤AND、OR进⾏连接。
5. GROUP BY⼦句,⽤来对查询结果进⾏分组,并进⾏分组统计等处理,在分组中,还可以使⽤HAVING关键词定义分组条件。
6. ORDER BY⼦句,⽤来对查询结果集进⾏排序。
ASC当然是升序,DESC是降序。
默认为ASC。
从SELECT语句的操作结果看,<⽬标列>实现对关系表的投影操作,WHERE <条件表达式>实现对关系表的元组选择操作。
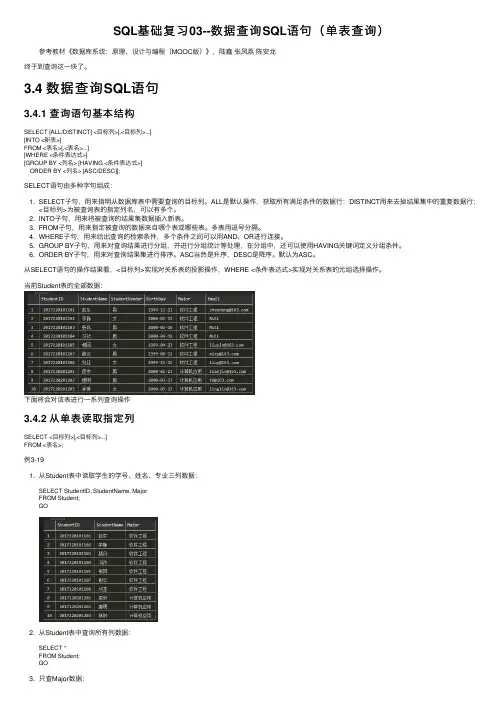
当前Student表的全部数据:下⾯将会对该表进⾏⼀系列查询操作3.4.2 从单表读取指定列SELECT <⽬标列>[,<⽬标列>...]FROM <表名>;例3-191. 从Student表中读取学⽣的学号、姓名、专业三列数据:SELECT StudentID, StudentName, MajorFROM Student;GO2. 从Student表中查询所有列数据:SELECT *FROM Student;GO3. 只查Major数据:SELECT MajorFROM Student;GO倘若只想查出不同的专业名称,可以消除重复⾏,⽤DISTINCT:SELECT DISTINCT MajorFROM Student;GO3.4.3 从单表读取指定⾏SELECT *FROM <表名>WHERE <条件表达式>;例3-20从Student表中读取专业为“软件⼯程”,性别为“男”的学⽣数据:SELECT *FROM StudentWHERE Major='软件⼯程' AND StudentGender='男';GO3.4.4 从单表读取指定⾏和列SELECT <⽬标列> [,<⽬标列>...]FROM <表名>WHERE <条件表达式>;例3-21从Student表中读取专业为“软件⼯程”,性别为“男”的学⽣的学号、姓名、性别、专业四列的数据:SELECT StudentID, StudentName, StudentGender, MajorFROM StudentWHERE Major='软件⼯程' AND StudentGender='男';GO3.4.5 WHERE⼦句条件在WHERE⼦句条件中,可以⽤BETWEEN...AND关键词来限定列值范围,还可以⽤关键字LIKE与通配符来限定查询范围,NOT LIKE⽤于给出不在范围的条件。
《数据库》第七章 基本SQL查询

8
Inspur Education
从表中选择多个列
要查看数据库中所有图书的名称和出版日期
SELECT bookname,pubdate
5
Inspur Education
选择表中的所有数据
显示客户customers表中所有的数据
SELECT * FROM books;
在SELECT后面键入*号
6
Inspur Education
从表中选择一列 2-1
在Oracle中,可以只在结果中返回特定的列。SELECT语 句中选择特定列被称为“投影(projection)”。可以 选择表中的一列,也可以选择多个列或者是所有的列。
示例:查询所有BOOKNAME列以“j”开头的书本。
SELECT * FROM books WHERE bookname LIKE 'j%';
17
Inspur Education
WHERE子句——连接运算符
在WHERE子句中可以使用连接运算符将各个表达式关联起 来,组成复合判断条件。常用的连接运算符有AND和OR。
INSERT INTO books (isbn, bookname, pubdate, quantity, bcost, bretail, bcategory)
VALUES (2, 'a语言', to_date('2017-10-8', 'yyyy-mm-dd'), null, '40', '68', 'computer');
数据库常用sql语句有哪些
数据库常用sql语句有哪些数据库常用sql语句有哪些结构化查询语言简称SQL,是一种特殊目的的编程语言,是一种数据库查询和程序设计语言,用于存取数据以及查询、更新和管理关系数据库系统。
下面是店铺整理的数据库常用sql语句有哪些,欢迎大家分享。
数据库常用sql语句Student(S#,Sname,Sage,Ssex) 学生表Course(C#,Cname,T#) 课程表SC(S#,C#,score) 成绩表Teacher(T#,Tname) 教师表问题:1、查询“001”课程比“002”课程成绩高的所有学生的学号;select a.S# from (select s#,score from SC where C#='001') a,(select s#,scorefrom SC where C#='002') bwhere a.score>b.score and a.s#=b.s#;2、查询平均成绩大于60分的同学的学号和平均成绩;select S#,avg(score)from scgroup by S# having avg(score) >60;3、查询所有同学的学号、姓名、选课数、总成绩;select Student.S#,Student.Sname,count(SC.C#),sum(score)from Student left Outer join SC on Student.S#=SC.S#group by Student.S#,Sname4、查询姓“李”的老师的个数;select count(distinct(Tname))from Teacherwhere Tname like '李%';5、查询没学过“叶平”老师课的同学的学号、姓名;select Student.S#,Student.Snamefrom Studentwhere S# not in (select distinct( SC.S#) from SC,Course,Teacher where SC.C#=Course.C# and Teacher.T#=Course.T# and Teacher.Tname='叶平');6、查询学过“001”并且也学过编号“002”课程的同学的学号、姓名;select Student.S#,Student.Sname from Student,SC where Student.S#=SC.S# and SC.C#='001'and exists( Select * from SC as SC_2 where SC_2.S#=SC.S# and SC_2.C#='002');7、查询学过“叶平”老师所教的所有课的同学的学号、姓名;select S#,Snamefrom Studentwhere S# in (select S# from SC ,Course ,Teacher where SC.C#=Course.C# and Teacher.T#=Course.T# and Teacher.Tname='叶平' group by S# having count(SC.C#)=(select count(C#) from Course,Teacher where Teacher.T#=Course.T# and Tname='叶平'));8、查询课程编号“002”的成绩比课程编号“001”课程低的所有同学的学号、姓名;Select S#,Sname from (select Student.S#,Student.Sname,score ,(select score from SC SC_2 where SC_2.S#=Student.S# and SC_2.C#='002') score2 from Student,SC where Student.S#=SC.S# and C#='001') S_2 where score2<score;9、查询所有课程成绩小于60分的同学的学号、姓名;select S#,Snamefrom Studentwhere S# not in (select Student.S# from Student,SC whereS.S#=SC.S# and score>60);10、查询没有学全所有课的同学的学号、姓名;select Student.S#,Student.Snamefrom Student,SCwhere Student.S#=SC.S# group by Student.S#,Student.Sname having count(C#) <(select count(C#) from Course);11、查询至少有一门课与学号为“1001”的同学所学相同的同学的学号和姓名;select S#,Sname from Student,SC where Student.S#=SC.S# and C# in select C# from SC where S#='1001';12、查询至少学过学号为“001”同学所有一门课的其他同学学号和姓名;select distinct SC.S#,Snamefrom Student,SCwhere Student.S#=SC.S# and C# in (select C# from SC where S#='001');13、把“SC”表中“叶平”老师教的课的成绩都更改为此课程的平均成绩;SC set score=(select avg(SC_2.score)from SC SC_2where SC_2.C#=SC.C# ) from Course,Teacher where Course.C#=SC.C# and Course.T#=Teacher.T# and Teacher.Tname='叶平');14、查询和“1002”号的同学学习的课程完全相同的其他同学学号和姓名;select S# from SC where C# in (select C# from SC where S#='1002')group by S# having count(*)=(select count(*) from SC where S#='1002');15、删除学习“叶平”老师课的SC表记录;Delect SCfrom course ,Teacherwhere Course.C#=SC.C# and Course.T#= Teacher.T# and Tname='叶平';16、向SC表中插入一些记录,这些记录要求符合以下条件:没有上过编号“003”课程的同学学号、2、号课的平均成绩;Insert SC select S#,'002',(Select avg(score)from SC where C#='002') from Student where S# not in (Select S# from SC where C#='002');17、按平均成绩从高到低显示所有学生的“数据库”、“企业管理”、“英语”三门的课程成绩,按如下形式显示:学生ID,,数据库,企业管理,英语,有效课程数,有效平均分SELECT S# as 学生ID,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='004') AS 数据库,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='001') AS 企业管理,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='006') AS 英语,COUNT(*) AS 有效课程数, AVG(t.score) AS 平均成绩FROM SC AS tGROUP BY S#ORDER BY avg(t.score)18、查询各科成绩最高和最低的分:以如下形式显示:课程ID,最高分,最低分SELECT L.C# As 课程ID,L.score AS 最高分,R.score AS 最低分FROM SC L ,SC AS RWHERE L.C# = R.C# andL.score = (SELECT MAX(IL.score)FROM SC AS IL,Student AS IMWHERE L.C# = IL.C# and IM.S#=IL.S#GROUP BY IL.C#)ANDR.Score = (SELECT MIN(IR.score)FROM SC AS IRWHERE R.C# = IR.C#GROUP BY IR.C#);19、按各科平均成绩从低到高和及格率的百分数从高到低顺序SELECT t.C# AS 课程号,max(ame)AS 课程名,isnull(AVG(score),0) AS 平均成绩,100 * SUM(CASE WHEN isnull(score,0)>=60 THEN 1 ELSE 0 END)/COUNT(*) AS 及格百分数FROM SC T,Coursewhere t.C#=course.C#GROUP BY t.C#ORDER BY 100 * SUM(CASE WHEN isnull(score,0)>=60 THEN 1 ELSE 0 END)/COUNT(*) DESC20、查询如下课程平均成绩和及格率的百分数(用"1行"显示): 企业管理(001),马克思(002),OO&UML (003),数据库(004)SELECT SUM(CASE WHEN C# ='001' THEN score ELSE 0 END)/SUM(CASE C# WHEN '001' THEN 1 ELSE 0 END) AS 企业管理平均分,100 * SUM(CASE WHEN C# = '001' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '001' THEN 1 ELSE 0 END) AS 企业管理及格百分数,SUM(CASE WHEN C# = '002' THEN score ELSE 0END)/SUM(CASE C# WHEN '002' THEN 1 ELSE 0 END) AS 马克思平均分,100 * SUM(CASE WHEN C# = '002' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '002' THEN 1 ELSE 0 END) AS 马克思及格百分数,SUM(CASE WHEN C# = '003' THEN score ELSE 0 END)/SUM(CASE C# WHEN '003' THEN 1 ELSE 0 END) AS UML平均分,100 * SUM(CASE WHEN C# = '003' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '003' THEN 1 ELSE 0 END) AS UML及格百分数,SUM(CASE WHEN C# = '004' THEN score ELSE 0 END)/SUM(CASE C# WHEN '004' THEN 1 ELSE 0 END) AS 数据库平均分,100 * SUM(CASE WHEN C# = '004' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '004' THEN 1 ELSE 0 END) AS 数据库及格百分数FROM SC21、查询不同老师所教不同课程平均分从高到低显示SELECT max(Z.T#) AS 教师ID,MAX(Z.Tname) AS 教师姓名,C.C# AS 课程ID,MAX(ame) AS 课程名称,AVG(Score) AS 平均成绩FROM SC AS T,Course AS C ,Teacher AS Zwhere T.C#=C.C# and C.T#=Z.T#GROUP BY C.C#ORDER BY AVG(Score) DESC22、查询如下课程成绩第 3 名到第 6 名的学生成绩单:企业管理(001),马克思(002),UML (003),数据库(004)[学生ID],[学生姓名],企业管理,马克思,UML,数据库,平均成绩SELECT DISTINCT top 3SC.S# As 学生学号,Student.Sname AS 学生姓名 ,T1.score AS 企业管理,T2.score AS 马克思,T3.score AS UML,T4.score AS 数据库,ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0) as 总分FROM Student,SC LEFT JOIN SC AS T1ON SC.S# = T1.S# AND T1.C# = '001'LEFT JOIN SC AS T2ON SC.S# = T2.S# AND T2.C# = '002'LEFT JOIN SC AS T3ON SC.S# = T3.S# AND T3.C# = '003'LEFT JOIN SC AS T4ON SC.S# = T4.S# AND T4.C# = '004'WHERE student.S#=SC.S# andISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0)NOT IN(SELECTDISTINCTTOP 15 WITH TIESISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0)FROM scLEFT JOIN sc AS T1ON sc.S# = T1.S# AND T1.C# = 'k1'LEFT JOIN sc AS T2ON sc.S# = T2.S# AND T2.C# = 'k2'LEFT JOIN sc AS T3ON sc.S# = T3.S# AND T3.C# = 'k3'LEFT JOIN sc AS T4ON sc.S# = T4.S# AND T4.C# = 'k4'ORDER BY ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0) DESC);23、统计列印各科成绩,各分数段人数:课程ID,课程名称,[100-85],[85-70],[70-60],[<60]SELECT SC.C# as 课程ID, Cname as 课程名称,SUM(CASE WHEN score BETWEEN 85 AND 100 THEN 1 ELSE 0 END) AS [100 - 85],SUM(CASE WHEN score BETWEEN 70 AND 85 THEN 1 ELSE 0 END) AS [85 - 70],SUM(CASE WHEN score BETWEEN 60 AND 70 THEN 1 ELSE 0 END) AS [70 - 60],SUM(CASE WHEN score < 60 THEN 1 ELSE 0 END) AS [60 -] FROM SC,Coursewhere SC.C#=Course.C#GROUP BY SC.C#,Cname;24、查询学生平均成绩及其名次SELECT 1+(SELECT COUNT( distinct 平均成绩)FROM (SELECT S#,AVG(score) AS 平均成绩FROM SCGROUP BY S#) AS T1WHERE 平均成绩 > T2.平均成绩) as 名次,S# as 学生学号,平均成绩FROM (SELECT S#,AVG(score) 平均成绩FROM SCGROUP BY S#) AS T2ORDER BY 平均成绩 desc;25、查询各科成绩前三名的记录:(不考虑成绩并列情况)SELECT t1.S# as 学生ID,t1.C# as 课程ID,Score as 分数FROM SC t1WHERE score IN (SELECT TOP 3 scoreFROM SCWHERE t1.C#= C#ORDER BY score DESC)ORDER BY t1.C#;26、查询每门课程被选修的学生数select c#,count(S#) from sc group by C#;27、查询出只选修了一门课程的全部学生的学号和姓名select SC.S#,Student.Sname,count(C#) AS 选课数from SC ,Studentwhere SC.S#=Student.S# group by SC.S# ,Student.Sname having count(C#)=1;28、查询男生、女生人数Select count(Ssex) as 男生人数 from Student group by Ssex having Ssex='男';Select count(Ssex) as 女生人数 from Student group by Ssex having Ssex='女';29、查询姓“张”的学生名单SELECT Sname FROM Student WHERE Sname like '张%';30、查询同名同性学生名单,并统计同名人数select Sname,count(*) from Student group by Sname having count(*)>1;;31、1981年出生的学生名单(注:Student表中Sage列的类型是datetime)select Sname, CONVERT(char (11),DATEPART(year,Sage)) asagefrom studentwhere CONVERT(11),DATEPART(year,Sage))='1981';32、查询每门课程的平均成绩,结果按平均成绩升序排列,平均成绩相同时,按课程号降序排列Select C#,Avg(score) from SC group by C# order by Avg(score),C# DESC ;33、查询平均成绩大于85的所有学生的学号、姓名和平均成绩select Sname,SC.S# ,avg(score)from Student,SCwhere Student.S#=SC.S# group by SC.S#,Sname having avg(score)>85;34、查询课程名称为“数据库”,且分数低于60的`学生姓名和分数Select Sname,isnull(score,0)from Student,SC,Coursewhere SC.S#=Student.S# and SC.C#=Course.C# and ame='数据库'and score<60;35、查询所有学生的选课情况;SELECT SC.S#,SC.C#,Sname,CnameFROM SC,Student,Coursewhere SC.S#=Student.S# and SC.C#=Course.C# ;36、查询任何一门课程成绩在70分以上的姓名、课程名称和分数;SELECT distinct student.S#,student.Sname,SC.C#,SC.scoreFROM student,ScWHERE SC.score>=70 AND SC.S#=student.S#;37、查询不及格的课程,并按课程号从大到小排列select c# from sc where scor e<60 order by C# ;38、查询课程编号为003且课程成绩在80分以上的学生的学号和姓名;select SC.S#,Student.Sname from SC,Student where SC.S#=Student.S# and Score>80 and C#='003';39、求选了课程的学生人数select count(*) from sc;40、查询选修“叶平”老师所授课程的学生中,成绩最高的学生姓名及其成绩select Student.Sname,scorefrom Student,SC,Course C,Teacherwhere Student.S#=SC.S# and SC.C#=C.C# and C.T#=Teacher.T# and Teacher.Tname='叶平' and SC.score=(select max(score)from SC where C#=C.C# );41、查询各个课程及相应的选修人数select count(*) from sc group by C#;42、查询不同课程成绩相同的学生的学号、课程号、学生成绩select distinct A.S#,B.score from SC A ,SC B whereA.Score=B.Score and A.C# <>B.C# ;43、查询每门功成绩最好的前两名SELECT t1.S# as 学生ID,t1.C# as 课程ID,Score as 分数FROM SC t1WHERE score IN (SELECT TOP 2 scoreFROM SCWHERE t1.C#= C#ORDER BY score DESC)ORDER BY t1.C#;44、统计每门课程的学生选修人数(超过10人的课程才统计)。
查看数据表信息的sql语句
查看数据表信息的sql语句SQL语句是结构化查询语言(Structured Query Language)的缩写,是用于查询、操作和管理数据库的语言。
数据库管理系统(DBMS)的用户可以使用SQL语句对数据库进行操作。
在数据库中,表格是最基本的组成单元。
为了查看表格中的信息,需要使用SQL语句。
以下是查看数据表信息的SQL语句:1. 查看表格列信息语法:SELECT COLUMN_NAME, DATA_TYPE, IS_NULLABLE,COLUMN_DEFAULTFROM INFORMATION_SCHEMA.COLUMNSWHERE TABLE_NAME = '表格名称';描述:此语句将显示表格的所有列信息,包括列名称、数据类型、是否允许为NULL和默认值。
2. 查看表格索引信息语法:SHOW INDEXES FROM 表格名称;描述:此语句将显示表格的所有索引信息,包括索引名称、索引类型、列名称和索引顺序。
3. 查看表格大小信息语法:SELECT table_name AS "Table",Round(((data_length + index_length) / 1024 / 1024), 2) AS "Size (MB)"FROM information_schema.TABLESWHERE table_schema = '数据库名称'AND table_name = '表格名称';描述:此语句将显示表格的大小信息,以MB为单位。
它基于表格的数据长度、索引长度和数据库中表格的位置计算。
以上是SQL语句中最常用的查看数据表信息的语句。
使用SQL语句可以帮助数据库管理人员更轻松地查看表格信息,从而更好地理解和操作数据库。
为了有效地使用这些语句,需要了解SQL 语句和数据库管理系统的基本知识。
通过研究数据库管理系统和SQL 语句,您可以更好地管理您的数据,并提高数据处理的效率。
基础sql语句
基础sql语句1. SELECT: 用于查询表中的数据,可以使用通配符(*)表示所有列或者指定列名。
例子:SELECT * FROM table_name;2. FROM: 用于指定查询的数据来源,即需要查询哪张表。
例子:SELECT * FROM table_name;3. WHERE: 用于筛选满足条件的数据行,可以使用比较运算符(>,<,=,!=,>=,<=)等。
例子:SELECT * FROM table_name WHEREcolumn_name >= 10;4. ORDER BY: 用于将查询结果按照某个列进行排序,可以指定升序或降序(ASC或DESC)。
例子:SELECT * FROM table_name ORDER BYcolumn_name ASC;5. GROUP BY: 用于将查询结果按照某个列进行分组,通常使用聚合函数(SUM,COUNT,AVG,MAX,MIN)进行数据计算。
例子:SELECT column_name, COUNT(*) FROM table_name GROUP BY column_name;6. LIMIT: 用于限制查询结果的数量,只返回前几条数据。
例子:SELECT * FROM table_name LIMIT 10;7. JOIN: 用于将多张表按照共同的字段进行连接,可以有多种连接方式(INNER JOIN,LEFT JOIN,RIGHT JOIN,FULL OUTER JOIN)。
例子:SELECT * FROM table1 LEFT JOIN table2 ONtable1.column_name = table2.column_name.。
MySQL基本SQL语句之单表查询、多表查询和子查询

一、简单查询:基本语法:SELECT*FROMtb_name;查询全部SELECTfield1,field2FROMtb_name;投影SELECT[DISTINCT]*FROMtb_nameWHEREqualification;选择说明:FROM子句:要查询的关系表、多个表、其它SELECT语句WHERE子句:布尔关系表达式,主要包含如下这几类表达式:比较:=、>、>=、<=、<逻辑关系:ANDORNOTBETWEEN...AND...:在两个值之间LIKE‘’%:任意长度任意字符_:任意单个字符REGEXP,RLIKE:正则表达式,此时索引无效INISNULLISNOTNULL如下查询本博客的wp-links和wp_posts表:mysql>select*fromwp_links;查询全部mysql>selectlink_name,link_urlfromwp_links;投影+-------------------+--------------------------------------+|link_name|link_url|+-------------------+--------------------------------------+|腾讯微博|/toxingwang||新浪微博|/gz100ww||51CTO技术博客|/|+-------------------+--------------------------------------+10rowsinset(0.00sec)mysql>selectID,post_title,post_datefromwp_posts where ID>1290andpost_status='publish';选择+------+----------------------------------------------------------------+----------------------+|ID|post_title|post_date|+------+----------------------------------------------------------------+----------------------+|1291|【转】HP3PAR存储概念之三|2013-08-2917:21:27||1298|【转】HP3PAR存储概念之四|2013-08-2917:22:33||1351|【转】XenDesktop5.5+vSphere5创建虚拟机报错|2013-09-0417:41:26||1357|linux下强大的网络工具Netcat|2013-09-0922:26:45||1360|MySQL常用命令、技巧和注意事项|2013-09-2011:04:15||1369|【转】数据库设计原理知识--B树、B-树、B+树、B*树都是什么|2013-09-2112:30:18||1379|MySQL基本SQL语句之常用管理SQL|2013-09-2112:39:23|+------+----------------------------------------------------------------+---------------------+7rowsinset(0.01sec)对查询结果排序:ORDERBYfield_name{ASC|DESC}如下:mysql>selectID,post_title,post_datefromwp_postswhereID>1290andpost_status='publish'ORDERby ID;##升序,ID是排序的字段mysql>selectID,post_title,post_datefromwp_postswhereID>1290andpost_status='publish'ORDERby ID DES C;##降序字段别名:ASselectcol_name AS COL_Aliases…:对字段使用别名selectcol_name,…fromtb_nameAStb_Aliases…:对表使用别名如下:mysql>selectpost_title AS文章标题fromwp_postswhereID>1290andpost_status='publish';+----------------------------------------------------------------+|文章标题|+----------------------------------------------------------------+|【转】HP3PAR存储概念之三||【转】HP3PAR存储概念之四||【转】XenDesktop5.5+vSphere5创建虚拟机报错||linux下强大的网络工具Netcat||MySQL常用命令、技巧和注意事项||【转】数据库设计原理知识--B树、B-树、B+树、B*树都是什么||MySQL基本SQL语句之常用管理SQL|+----------------------------------------------------------------+7rowsinset(0.02sec)##还可以这样:mysql>select3+2ASSUM;+-----+|SUM|+-----+|5|+-----+1rowinset(0.00sec)LIMIT子句:LIMIT[offset,]Count如下:mysql>selectID,post_title,post_datefromwp_postswhereID>1290andpost_status='publish'limit5;+------+--------------------------------------------------+---------------------+|ID|post_title|post_date|+------+--------------------------------------------------+---------------------+|1291|【转】HP3PAR存储概念之三|2013-08-2917:21:27||1298|【转】HP3PAR存储概念之四|2013-08-2917:22:33||1351|【转】XenDesktop5.5+vSphere5创建虚拟机报错|2013-09-0417:41:26||1357|linux下强大的网络工具Netcat|2013-09-0922:26:45||1360|MySQL常用命令、技巧和注意事项|2013-09-2011:04:15|+------+--------------------------------------------------+---------------------+5rowsinset(0.01sec)mysql>selectID,post_title,post_datefromwp_postswhereID>1290andpost_status='publish'limit2,3;##红色部分(逗号前的数字)表示偏移量+------+--------------------------------------------------+---------------------+|ID|post_title|post_date|+------+--------------------------------------------------+---------------------+|1351|【转】XenDesktop5.5+vSphere5创建虚拟机报错|2013-09-0417:41:26||1357|linux下强大的网络工具Netcat|2013-09-0922:26:45||1360|MySQL常用命令、技巧和注意事项|2013-09-2011:04:15|+------+--------------------------------------------------+---------------------+3rowsinset(0.00sec)聚合:SUM(),MIN(),MAX(),AVG(),COUNT(),括号中为字段名mysql>select sum(ID)fromwp_posts;计算和mysql>select min(ID)fromwp_posts;查早最小的mysql>select max(ID)fromwp_posts;查找最大的mysql>select avg(ID)fromwp_posts;平均值mysql>select count(ID)fromwp_posts;计数分组:GROUPBY,一般配合聚合运算使用如下:mysql>select count(post_status)AS各状态数量,post_statusAS状态名称fromwp_posts groupby post_status;+-----------------+--------------+|各状态数量|状态名称|+-----------------+--------------+|1|auto-draft||9|draft||251|inherit||238|publish||2|trash|+-----------------+--------------+5rowsinset(0.01sec)注意:可以使用HAVING qualification将GROUPBY的结果再次过滤,用法同where二、多表查询连接:交叉连接:笛卡尔乘积自然连接:将两张表某字段中相等连接起来,如下mysql>,students.Age,ame,students.GenderFROMstudents,coursesWHER Estudents.CID1=courses.CID;+--------------+------+------------------+--------+|Name|Age|Cname|Gender|+--------------+------+------------------+--------+|GuoJing|19|TaiJiquan|M||YangGuo|17|TaiJiquan|M||DingDian|25|Qishangquan|M||HuFei|31|Wanliduxing|M||HuangRong|16|Qianzhuwandushou|F||YueLingshang|18|Wanliduxing|F||ZhangWuji|20|Hamagong|M||Xuzhu|26|TaiJiquan|M|+--------------+------+------------------+--------+8rowsinset(0.00sec)外连接:左外连接:left_tbLEFTJOINright_tbON...:以左表为标准mysql>,ameFROMstudentsASs LEFTJOIN coursesASc ON s.CID1=c.CID; +--------------+--------------------+|Name|Cname|+--------------+--------------------+|GuoJing|TaiJiquan||YangGuo|TaiJiquan||DingDian|Qishangquan||HuFei|Wanliduxing||HuangRong|Qianzhuwandushou||YueLingshang|Wanliduxing||ZhangWuji|Hamagong||Xuzhu|TaiJiquan||LingHuchong|NULL||YiLin|NULL|+--------------+--------------------+10rowsinset(0.00sec)右外连接:left_tbRIGHTJOINright_tbON...:以右表为标准mysql>,ameFROMstudentsASs RIGHTJOIN coursesASc ON s.CID1=c.CID; +--------------+--------------------+|Name|Cname|+--------------+--------------------+|GuoJing|TaiJiquan||YangGuo|TaiJiquan||DingDian|Qishangquan||HuFei|Wanliduxing||HuangRong|Qianzhuwandushou||YueLingshang|Wanliduxing||ZhangWuji|Hamagong||Xuzhu|TaiJiquan||NULL|Yiyangzhi||NULL|Jinshejianfa||NULL|Qiankundanuoyi||NULL|Pixiejianfa||NULL|Jiuyinbaiguzhua|+--------------+--------------------+13rowsinset(0.01sec)自连接:本表中不同字段间进行连接mysql>ASstudent,ASteacherFROMstudentsASc,studentsASsWHEREc.TID=s.SID; +-----------+-------------+|student|teacher|+-----------+-------------+|GuoJing|DingDian||YangGuo|GuoJing||DingDian|ZhangWuji||HuFei|HuangRong||HuangRong|LingHuchong|+-----------+-------------+5rowsinset(0.02sec)注意:使用了别名三、子查询:一个查询中嵌套另外一个查询如下:在students表中查询年龄大于平均年龄的学生mysql>SELECTName,AgeFROMstudentsWHEREAge>(SELECTAVG(Age)FROMstudents);+-------------+------+|Name|Age|+-------------+------+|DingDian|25||HuFei|31||Xuzhu|26||LingHuchong|22|+-------------+------+4rowsinset(0.08sec)子查询注意事项:•比较操作中使用子查询:子查询只能返回单个值;•IN():使用子查询;•在FROM中使用子查询;联合查询:UNION,将两个查询的结果合并mysql>(SELECTName,AgeFROMstudents)UNION(SELECTTname,AgeFROMtutors); +--------------+------+|Name|Age|+--------------+------+|GuoJing|19||YangGuo|17||DingDian|25||HuFei|31||HuangRong|16||YueLingshang|18||ZhangWuji|20||HuYidao|42||NingZhongze|49|+--------------+------+19rowsinset(0.00sec)。
数据库SQL查询语句
一、简单查询语句1. 查看表结构SQL>DESC emp;2. 查询所有列SQL>SELECT * FROM emp;3. 查询指定列SQL>SELECT empmo, ename, mgr FROM emp;SQL>SELECT DISTINCT mgr FROM emp; 只显示结果不同的项4. 查询指定行SQL>SELECT * FROM emp WHERE job='CLERK';5. 使用算术表达式SQL>SELECT ename,sal*13+nvl(comm,0) FROMemp;nvl(comm,1)的意思是,如果comm中有值,则nvl(comm,1)=comm; comm中无值,则nvl(comm,1)=0。
SQL>SELECT ename, sal*13+nvl(comm,0) year_sal FROM emp; (year_sal为别名,可按别名排序)SQL>SELECT * FROM emp WHERE hiredate>'01-1月-82';6. 使用like操作符(%,_)%表示一个或多个字符,_表示一个字符,[charlist]表示字符列中的任何单一字符,[^charlist]或者[!charlist]不在字符列中的任何单一字符。
SQL>SELECT * FROM emp WHERE ename like 'S__T%';7. 在where条件中使用InSQL>SELECT * FROM emp WHERE job IN ('CLERK','ANAL YST');8. 查询字段内容为空/非空的语句SQL>SELECT * FROMemp WHERE mgr IS/IS NOT NULL;9. 使用逻辑操作符号SQL>SELECT * FROM emp WHERE (sal>500 or job='MANAGE') and ename like 'J%';10. 将查询结果按字段的值进行排序SQL>SELECT * FROM emp ORDER BY deptno, sal DESC; (按部门升序,并按薪酬降序)二、复杂查询1. 数据分组(max,min,avg,sum,count)SQL>SELECT MAX(sal),MIN(age),A VG(sal),SUM(sal) from emp;SQL>SELECT * FROM emp where sal=(SELECT MAX(sal) from emp));SQL>SELEC COUNT(*) FROM emp;2. group by(用于对查询结果的分组统计)和having子句(用于限制分组显示结果)SQL>SELECT deptno,MAX(sal),A VG(sal) FROM emp GROUP BY deptno;SQL>SELECT deptno, job, A VG(sal),MIN(sal) FROM emp group by deptno,job having A VG(sal)<2000;对于数据分组的总结:a. 分组函数只能出现在选择列表、having、order by子句中(不能出现在where中)b. 如果select语句中同时包含有group by, having, order by,那么它们的顺序是group by, having, order by。
sqlyog查询语句
sqlyog查询语句SQLYog是一款常用的MySQL数据库管理工具,它提供了丰富的查询语句功能来方便用户进行数据查询和操作。
下面列举了10个符合标题内容的SQLYog查询语句,以帮助读者更好地理解和使用该工具。
1. 查询某张表中的所有列名:```SHOW COLUMNS FROM table_name;```2. 查询某张表的所有记录:```SELECT * FROM table_name;```3. 查询某张表的前N条记录:```SELECT * FROM table_name LIMIT N;```4. 查询某张表中满足条件的记录:```SELECT * FROM table_name WHERE condition;```5. 查询某张表中满足条件的记录,并按照指定的列进行排序:```SELECT * FROM table_name WHERE condition ORDER BY column_name;```6. 查询某张表中满足条件的记录,并统计符合条件的记录数:```SELECT COUNT(*) FROM table_name WHERE condition;```7. 查询某张表中满足条件的记录,并计算指定列的平均值:```SELECT AVG(column_name) FROM table_name WHERE condition;```8. 查询某张表中满足条件的记录,并计算指定列的最大值:```SELECT MAX(column_name) FROM table_name WHERE condition;```9. 查询某张表中满足条件的记录,并计算指定列的最小值:```SELECT MIN(column_name) FROM table_name WHERE condition;```10. 查询某张表中满足条件的记录,并计算指定列的总和:```SELECT SUM(column_name) FROM table_name WHERE condition;```以上是一些常用的SQLYog查询语句,通过这些语句可以灵活地查询和操作数据库中的数据。
sql server查询数据库语句
sql server查询数据库语句
在 SQL Server 中,可以使用`SELECT`语句来查询数据库中的数据。
以下是一个示例的SQL 查询语句,用于从名为`Employees`的表中选取员工的信息:
```sql
SELECT *
FROM Employees
WHERE DepartmentID = 123 AND JobTitle LIKE '%经理%'
ORDER BY HireDate DESC;
```
这个查询语句的功能如下:
- `SELECT *`:从`Employees`表中选择所有列。
- `FROM Employees`:指定要查询的表名为`Employees`。
- `WHERE DepartmentID = 123 AND JobTitle LIKE '%经理%'`:筛选出部门 ID 为 123 并且职位标题中包含"经理"的员工。
- `ORDER BY HireDate DESC`:根据员工的雇佣日期降序排列结果。
请注意,上述查询语句仅为示例,你可以根据自己的需求进行修改和扩展。
你可以添加更多的条件、选择不同的列、使用聚合函数、连接其他表等来获取所需的数据库信息。
如果你有特定的查询需求或需要更详细的帮助,请提供更多的上下文和具体要求,我将尽力为你提供更准确的回复。
SQL的数据查询功能之一---查询语句的基本结构
查询功能是SQL语言的核心功能,是数据库中使用得最多的操作,也是最复杂的一个语句。
一、查询语句的基本结构
一般格式为:
SELECT [ALL|DISTINCT]<目标列表达式>[,<目标列表达式>]...
FROM <表名或视图名>[,<表名或视图名>] ...
[WHERE <条件表达式>]
[GROUP BY <分组依据列>]
[HA VING <条件表达式>]
[ORDER BY <排序依据列> [ASC|DESC]];
整个SELECT语句的含义是:根据WHERE子句的条件表达式,从FROM子句指定的基本表或视图中找出满足条件的元组,再按SELECT子句中的目标列表达式,选出元组中的属性值形成结果表。
如果有GROUP 子句,则将结果按<分组依据列>的值进行分组,该属性列值相等的元组为一个组,每个组产生结果表中的一条记录。
通常会在每组中作用集函数。
如果GROUP子句带HA VING短语,则只有满足指定条件的组才予输出。
如果有ORDER子句,则结果表还要按<排序依据列>的值的升序或降序排序。