
Oracle中having、group by的用法
Having这个是用在聚合函数的用法。
当我们在用聚合函数的时候,一般都要用到GROUP BY 先进行分组,然后再进行聚合函数的运算。
运算完后就要用到HAVING 的用法了,就是进行判断了,例如说判断聚合函数的值是否大于某一个值等等。
select customer_name,sum(balance)from balancegroup by customer_namehaving balance>200; yc_rpt_getneworder by 、group by 、having的用法区别order by 从英文里理解就是行的排序方式,默认的为升序。
order by 后面必须列出排序的字段名,可以是多个字段名。
group by 从英文里理解就是分组。
必须有“聚合函数”来配合才能使用,使用时至少需要一个分组标志字段。
什么是“聚合函数”?像sum()、count()、avg()等都是“聚合函数”使用group by 的目的就是要将数据分类汇总。
一般如:select 单位名称,count(职工id),sum(职工工资) form [某表]group by 单位名称这样的运行结果就是以“单位名称”为分类标志统计各单位的职工人数和工资总额。
在sql命令格式使用的先后顺序上,group by 先于 order by。
select 命令的标准格式如下:SELECT select_list[ INTO new_table ]FROM table_source[ WHERE search_condition ][ GROUP BY group_by_expression ][ HAVING search_condition ]1. GROUP BY 是分组查询, 一般 GROUP BY 是和聚合函数配合使用group by 有一个原则,就是 select 后面的所有列中,没有使用聚合函数的列,必须出现在 group by 后面(重要)例如,有如下数据库表:A B1abc1bcd1asdfg如果有如下查询语句(该语句是错误的,原因见前面的原则)select A,B from table group by A该查询语句的意图是想得到如下结果(当然只是一相情愿)A Babc1bcdasdfg右边3条如何变成一条,所以需要用到聚合函数,如下(下面是正确的写法): select A,count(B) as 数量 from table group by A这样的结果就是A 数量1 32. Havingwhere 子句的作用是在对查询结果进行分组前,将不符合where条件的行去掉,即在分组之前过滤数据,条件中不能包含聚组函数,使用where条件显示特定的行。
having 子句的作用是筛选满足条件的组,即在分组之后过滤数据,条件中经常包含聚组函数,使用having 条件显示特定的组,也可以使用多个分组标准进行分组。
having 子句被限制子已经在SELECT语句中定义的列和聚合表达式上。
通常,你需要通过在HAVING子句中重复聚合函数表达式来引用聚合值,就如你在SELECT语句中做的那样。
例如:SELECT A COUNT(B) FROM TABLE GROUP BY A HAVING COUNT(B)>2Grouping 的用法:指示是否聚合 group by 列表中的指定表达式。
在结果集中,如果 Grouping 返回 1 ,表示聚合;如果 Grouping 返回 0 ,表示非聚合。
如果指定了 Group by ,那么只能用在 Select , Having , Order by 中。
注释:GROUPING 用于区分标准空值和由 ROLLUP 、 CUBE 或 GROUPING SETS 返回的空值。
作为 ROLLUP 、 CUBE 或 GROUPING SETS 操作结果返回的 NULL 是 NULL 的特殊应用。
它在结果集内作为列的占位符,表示全体。
举例:CREATE TABLE tt ( 产地 CHAR ( 8), 水果 CHAR ( 8), 重量 INT )INSERT tt VALUES ( ' 北方 ' , ' 香蕉 ' , 3)INSERT tt VALUES ( ' 北方 ' , ' 水蜜桃 ' , 2)INSERT tt VALUES ( ' 南方 ' , ' 桔子 ' , 3)INSERT tt VALUES ( ' 北方 ' , ' 水蜜桃 ' , 5)INSERT tt VALUES ( ' 南方 ' , ' 香蕉 ' , 3)INSERT tt VALUES ( ' 南方 ' , ' 水蜜桃 ' , 6)INSERT tt VALUES ( ' 北方 ' , ' 桔子 ' , 8)selectCASE WHEN ( GROUPING ( 产地 ) = 1) THEN ' 总计 ' ELSE ISNULL ( 产地 , 'UNKNOWN' )END AS 产地 ,CASE WHEN ( GROUPING ( 水果 ) = 1) THEN ' 小计 ' ELSE ISNULL ( 水果 , 'UNKNOWN' )END AS 产地 ,SUM ( 重量 ) 总重量FROM TTGROUP BY 产地 , 水果WITH ROLLUP结果:/************************北方 桔子 8北方 水蜜桃 7北方 香蕉 3北方 小计 18南方 桔子 3南方 水蜜桃 6南方 香蕉 3南方 小计 12总计 小计 30*************************/GROUPING(字段)=1的是对应字段汇总的GROUPING(字段)=0的是对应字段原来的明细的信息oracle Rollup 和 Cube用法Oracle的GROUP BY语句除了最基本的语法外,还支持ROLLUP和CUBE 语句。
如果是ROLLUP(A, B, C)的话,首先会对(A、B、C)进行GROUP BY,然后对(A、B)进行GROUP BY,然后是(A)进行GROUP BY,最后对全表进行GROUP BY操作。
如果是GROUP BY CUBE(A, B, C),则首先会对(A、B、C)进行GROUP BY,然后依次是(A、B),(A、C),(A),(B、C),(B),(C),最后对全表进行GROUP BY操作。
grouping_id()可以美化效果:Oracle的GROUP BY语句除了最基本的语法外,还支持ROLLUP和CUBE 语句。
除本文内容外,你还可参考:分析函数参考手册: /post/419/33028分析函数使用例子介绍:/post/419/44634SQL> create table t as select * from dba_indexes; 表已创建。
SQL> select index_type, status, count(*) from t group by index_type, status;INDEX_TYPE STATUS COUNT(*)--------------------------- -------- ----------LOB VALID 51NORMAL N/A 25NORMAL VALID 479CLUSTER VALID 11下面来看看ROLLUP和CUBE语句的执行结果。
SQL> select index_type, status, count(*) from t group by rollup(index_type, status);INDEX_TYPE STATUS COUNT(*)--------------------------- -------- ----------LOB VALID 51LOB 51NORMAL N/A 25NORMAL VALID 479NORMAL 504CLUSTER VALID 11CLUSTER 11566已选择8行。
SQL> select index_type, status, count(*) from t group by cube(index_type, status);INDEX_TYPE STATUS COUNT(*)--------------------------- -------- ----------566N/A 25VALID 541LOB 51LOB VALID 51NORMAL 504NORMAL N/A 25NORMAL VALID 479CLUSTER 11CLUSTER VALID 11已选择10行。
查询结果不是很一目了然,下面通过Oracle提供的函数GROUPING来整理一下查询结果。
SQL> select grouping(index_type) g_ind, grouping(status) g_st, index_type, status, count(*)2 from t group by rollup(index_type, status) order by 1, 2;G_IND G_ST INDEX_TYPE STATUS COUNT(*)---------- ---------- --------------------------- -------- ----------0 0 LOB VALID 510 0 NORMAL N/A 250 0 NORMAL VALID 4790 0 CLUSTER VALID 110 1 LOB 510 1 NORMAL 5040 1 CLUSTER 111 1 566已选择8行。
这个查询结果就直观多了,和不带ROLLUP语句的GROUP BY相比,ROLLUP 增加了对INDEX_TYPE的GROUP BY统计和对所有记录的GROUP BY统计。
就是说,如果是ROLLUP(A, B, C)的话,首先会对(A、B、C)进行GROUP BY,然后对(A、B)进行GROUP BY,然后是(A)进行GROUP BY,最后对全表进行GROUP BY操作。
下面看看CUBE语句。
SQL> select grouping(index_type) g_ind, grouping(status) g_st, index_type, status, count(*)2 from t group by cube(index_type, status) order by 1, 2;G_IND G_ST INDEX_TYPE STATUS COUNT(*)---------- ---------- --------------------------- -------- ----------0 0 LOB VALID 510 0 NORMAL N/A 250 0 NORMAL VALID 4790 0 CLUSTER VALID 110 1 LOB 510 1 NORMAL 5040 1 CLUSTER 111 0 N/A 251 0 VALID 5411 1 566已选择10行。
oracle 聚合筛出函数

oracle 聚合筛出函数在Oracle数据库中,聚合函数用于对一组值执行计算,并返回单个值。
以下是一些常用的Oracle聚合函数:1.SUM: 返回某列的总和。
sqlSELECT SUM(column_name) FROM table_name;2.AVG: 返回某列的平均值。
sqlSELECT AVG(column_name) FROM table_name;3.MIN: 返回某列的最小值。
sqlSELECT MIN(column_name) FROM table_name;4.MAX: 返回某列的最大值。
sqlSELECT MAX(column_name) FROM table_name;5.COUNT: 返回某列的值的数量。
sqlSELECT COUNT(column_name) FROM table_name;6.GROUP BY: 与聚合函数一起使用,根据一个或多个列对结果集进行分组。
sqlSELECT column1, COUNT(*)FROM table_nameGROUP BY column1;7.HAVING: 与GROUP BY一起使用,用于过滤聚合函数的结果。
通常在HAVING子句中使用的条件是在GROUP BY子句中使用的条件的超集。
sqlSELECT column1, COUNT(*)FROM table_nameGROUP BY column1HAVING COUNT(*) > 10;8.STDDEV: 返回某列的标准偏差。
9.VARIANCE: 返回某列的方差。
10.FIRST_VALUE, LAST_VALUE: 返回在结果集中的第一行或最后一行的列值。
通常与ROWNUM或PARTITION BY子句一起使用。
11.NTH_VALUE: 返回结果集中的第N行的列值。
同样,通常与ROWNUM或PARTITION BY子句一起使用。
12.LISTAGG: 将来自多个行的值组合成一个字符串,通常在GROUP BY子句中使用。
oracle group by 用法
oracle group by 用法在Oracle数据库中,GROUP BY语句是一个非常有用的功能,可以用来按照指定的列对查询结果进行汇总和聚合。
用GROUP BY可以实现数据的分组统计,解决许多分析数据的复杂问题。
GROUP BY 的基本语法如下:SELECT列1,列2,列3,...,列nFROM表名GROUPBY列1,列2,列3,...,列n;GROUPBY语句可以在SELECT语句中使用,用来将结果集按照指定的列进行分组,然后对每个组进行聚合计算,比如求和、计数、最大值、最小值等。
GROUPBY语句的主要作用是把相同值归为一组,然后对每组数据进行汇总操作。
在查询语句中,GROUPBY语句必须放在WHERE子句之后,ORDERBY子句之前。
例如,如果想要统计每个部门的销售额,需要使用SQL语句:SELECT dept_id, SUM(sales_amount) as total_salesFROM salesGROUP BY dept_id;上述SQL语句将sales表按照部门ID分组,然后通过SUM函数计算每个部门的销售额总和,查询结果包含每个部门的ID和销售额总和。
GROUPBY语句可以同时对多个列进行分组,例如:SELECT dept_id, year, SUM(sales_amount) as total_salesFROM salesGROUP BY dept_id, year;上述SQL语句将sales表按照部门和年份分组,然后通过SUM函数计算每个部门每年的销售额总和,查询结果包含每个部门的ID、年份和销售额总和。
在使用GROUPBY语句时,还可以配合使用聚合函数来进行计算。
常见的聚合函数包括COUNT、SUM、AVG、MAX、MIN等。
例如:SELECT dept_id, COUNT(某) as total_orders, MAX(sales_amount) as ma某_salesFROM salesGROUP BY dept_id;上述SQL语句将sales表按照部门分组,然后通过COUNT函数计算每个部门的订单总量,通过MAX函数计算每个部门的最高销售额,查询结果包含每个部门的ID、订单总量和最高销售额。
oracle中having用法

oracle中having用法tHAVING是Oracle数据库管理系统(DBMS)中使用的一种SQL运算符,它接收一个表达式作为参数,用于对SQL SELECT语句中的组合查询结果进行其他过滤,以缩小搜索范围,从而使查询简洁并降低系统开销。
跟WHERE子句一样,HAVING子句也是在SELECT语句中必不可少的一部分,它们都可以定义查询结果中所需要的记录,但是它们之间有很大的区别。
首先,WHERE子句用于从表中选择特定行,而HAVING子句用于从组中选择特定行。
同时,WHERE子句只能过滤结果的每个记录,而HAVING可以过滤结果中的每个分组。
例如,假设某个表中有三列:名字,性别和年龄。
使用WHERE子句,我们可以查询出所有20岁的男性:SELECT字,别,龄FROM名 WHERE别 = 男 AND龄 = 20;有时,我们不仅想找出20岁的男性,还想查找出所有年龄大于20岁的男性,我们就需要使用HAVING子句,它可以将查询结果按其分组进行过滤:SELECT字,别,龄FROM名WHERE别 = 男GROUP BY别HAVING龄 > 20;除了这些基本的用法,HAVING子句也可以与其他SQL句子结合使用,例如,我们可以使用HAVING子句计算某个表中每个年龄段的男性人数:SELECT龄段, COUNT(*) AS 男性人数FROM名WHERE别=男GROUP BY龄段HAVING COUNT(*) > 10;此外,HAVING子句也可以帮助我们查询出最大值或最小值,例如,我们可以使用它查询某个班级中最年轻和最年长的学生:SELECT MAX(年龄) AS 最高年龄 MIN(年龄) AS 最低年龄FROM名GROUP BY级HAVING MAX(年龄) > 20;最后,HAVING子句也可以和SUM,AVG等聚合函数结合使用,例如,我们可以查询某一班级中平均年龄大于20岁的班级:SELECT AVG(年龄)FROM名GROUP BY级HAVING AVG(年龄) > 20;通过以上的例子可以看出,HAVING子句被广泛应用于复杂的查询,它可以根据组查询出有效的数据,除此之外,它还可以过滤掉无用的信息。
教你如何使用group by语句查询数据库
教你如何使用group by 语句查询数据库Oracle中group by在select 语句中可以使用group by 子句将行划分成较小的组,然后,使用聚组函数返回每一个组的汇总信息。
什么是聚组函数呢?如下:聚组函数又称聚合函数:(A VG、COUNT、SUM、MIN、MAX、GROUPING、STDEV、STDEVP、V AR 和V ARP)另外,可以使用having子句限制返回的结果集。
group by 子句可以将查询结果分组,并返回行的汇总;也可以在select语句from之后加入where子句对查询前的记录进行筛选。
现在有一个疑问:where和having都可以约束查询出来的记录,有什么区别呢?主要的区别是where是对查询前的记录进行筛选,只要不满足where里边需要的条件,都不参加后续的分组统计运算。
而having里边约束的是在符合条件的记录中进行结果的筛选,如语句:having SUM(AA)>100,就是查询出总和大于100的记录。
Oracle 按照group by 子句中指定的表达式的值分组查询结果。
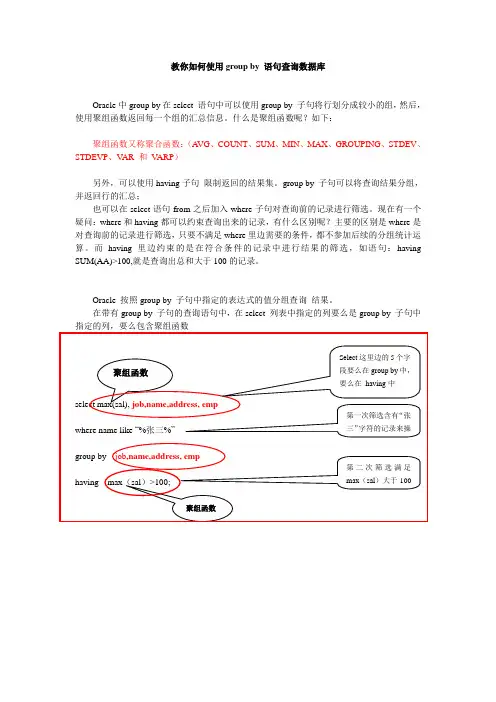
在带有group by 子句的查询语句中,在select 列表中指定的列要么是group by 子句中指定的列,要么包含聚组函数查询语句的select 和group by ,having 子句是聚组函数唯一出现的三个地方,在whereselectorder by deptno;当在gropu by 子句中使用having 子句时,查询结果中只返回满足having条件的组。
在一个sql语句中可以有where子句和having子句。
having 与where 子句类似,均用于设置限定条件where 子句的作用是在对查询结果进行分组前,将不符合where条件的行去掉,即在分组之前过滤数据,条件中不能包含聚组函数,使用where条件显示特定的行。
having 子句的作用是筛选满足条件的组,即在分组之后过滤数据,条件中经常包含聚组函数,使用having 条件显示特定的组,也可以使用多个分组标准进行分组。
oracle统计个数的函数

Oracle统计个数的函数在Oracle数据库中,有几个特定的函数可以用于统计个数。
这些函数可以用于计算满足特定条件的行数或返回不同值的个数。
以下是一些常用的统计个数的函数:•COUNT()•COUNT(DISTINCT)•SUM(CASE WHEN … THEN …)•GROUP BY和HAVING子句下面将详细解释每个函数的定义、用途和工作方式。
1. COUNT()定义: COUNT()函数用于计算满足特定条件的行数。
用途: COUNT()函数可以用于计算表中满足特定条件的行数,也可以用于计算表中的所有行数。
工作方式: COUNT()函数的语法如下:COUNT(expression)其中,expression是要计算行数的列或表达式。
COUNT()函数返回一个整数,表示满足条件的行数。
如果不指定expression,COUNT()函数将计算表中的所有行数。
如果指定expression,COUNT()函数将计算满足expression条件的行数。
示例:-- 计算表中的所有行数SELECT COUNT(*) FROM employees;-- 计算满足特定条件的行数SELECT COUNT(*) FROM employees WHERE salary > 5000;2. COUNT(DISTINCT)定义: COUNT(DISTINCT)函数用于计算不同值的个数。
用途: COUNT(DISTINCT)函数可以用于计算表中某列的不同值的个数。
工作方式: COUNT(DISTINCT)函数的语法如下:COUNT(DISTINCT expression)其中,expression是要计算不同值个数的列或表达式。
COUNT(DISTINCT)函数返回一个整数,表示不同值的个数。
示例:-- 计算表中某列的不同值个数SELECT COUNT(DISTINCT department_id) FROM employees;3. SUM(CASE WHEN … THEN …)定义:SUM(CASE WHEN … THEN …)函数用于根据条件计算列的和。
group_by和having的用法

group_by和having的⽤法#encoding: utf-8from sqlalchemy import create_engine,Column,Integer,String,Float,func,and_,or_,Enumfrom sqlalchemy.ext.declarative import declarative_basefrom sqlalchemy.orm import sessionmakerfrom random import randintHOSTNAME = '127.0.0.1'PORT = 3306DATABASE = 'first_sqlalchemy'USERNAME = 'root'PASSWORD = '123456'#dialect+driver://username:password@host:port/databaseDB_URI = "mysql+pymysql://{username}:{password}@{host}:{port}/" \"{db}?charset=utf8".format(username=USERNAME,password=PASSWORD,host=HOSTNAME,port=PORT,db=DATABASE) engine = create_engine(DB_URI)Base = declarative_base(engine)# Session = sessionmaker(engine)# session = Session()session = sessionmaker(engine)() #Session(**local_kw)class User(Base):__tablename__ = 'user'id = Column(Integer,primary_key=True,autoincrement=True)username = Column(String(50),unique=True,nullable=False)age = Column(Integer,default=0)gender = Column(Enum('male','female','secret'),default='male')# Base.metadata.drop_all()## Base.metadata.create_all()## user1 = User(username='⼩⼀',age=17,gender='male')# user2 = User(username='⼩⼆',age=18,gender='male')# user3 = User(username='⼩三',age=19,gender='male')# user4 = User(username='⼩四',age=20,gender='female')# user5 = User(username='⼩五',age=21,gender='female')# user6 = User(username='⼩六',age=22,gender='male')## session.add_all([user1,user2,user3,user4,user5,user6])# mit()#⽤group_by根据年龄来分组result = session.query(User.gender,func.count(User.id)).group_by(User.gender)print(result)'''SELECT user.gender AS user_gender, count(user.id) AS count_1FROM user GROUP BY user.gender'''#⽤group_by和having⼀起⽤ret = session.query(User.gender,func.count(User.id)).group_by(User.gender).having(User.age>20)print(ret)'''SELECT user.gender AS user_gender, count(user.id) AS count_1, user.age AS user_ageFROM user GROUP BY user.genderHAVING user.age > %(age_1)s'''。
Oracle数据库中的GROUPBY与HAVING
Oracle数据库中的GROUPBY与HAVING⼀、GROUP BYGROUP BY语句⽤来与聚合函数(aggregate functions such as COUNT, SUM, AVG, MIN, or MAX.)联合使⽤来得到⼀个或多个列的结果集。
语法如下:SELECT column1, column2, ... column_n, aggregate_function (expression)FROM tablesWHERE predicatesGROUP BY column1, column2, ... column_n;举例⽐如说我们有⼀个学⽣表格(student),包含学号(id),课程(course),分数(score)等等多个列,我们想通过查询得到每个学⽣选了⼏门课程,此时我们就可以联合使⽤COUNT函数与GROUP BY语句来得到这⼀结果SELECT id, COUNT(course) as numcourseFROM studentGROUP BY id因为我们是使⽤学号来进⾏分组的,这样COUNT函数就是在以学号分组的前提下来实现的,通过COUNT(course)就可以计算每⼀个学号对应的课程数。
注意因为聚合函数通过作⽤于⼀组数据⽽只返回⼀个单个值,因此,在SELECT语句中出现的元素要么为⼀个聚合函数的输⼊值,要么为GROUP BY语句的参数,否则会出错。
例如,对于上⾯提到的表格,我们做⼀个这样的查询:SELECT id, COUNT(course) as numcourse, scoreFROM studentGROUP BY id此时查询便会出错,错误提⽰如下:Column ‘student.score' is invalid in the select list because it is not contained in either an aggregate function or the GROUP BY clause.出现以上错误的原因是因为⼀个学⽣id对应多个分数,如果我们简单的在SELECT语句中写上score,则⽆法判断应该输出哪⼀个分数。
Oracle中分组查询groupby用法规则详解
Oracle中分组查询groupby⽤法规则详解Oracle中group by⽤法在select 语句中可以使⽤group by ⼦句将⾏划分成较⼩的组,⼀旦使⽤分组后select操作的对象变为各个分组后的数据,使⽤聚组函数返回的是每⼀个组的汇总信息。
使⽤having⼦句限制返回的结果集。
group by ⼦句可以将查询结果分组,并返回⾏的汇总信息Oracle 按照group by ⼦句中指定的表达式的值分组查询结果。
在带有group by ⼦句的查询语句中,在select 列表中指定的列要么是group by ⼦句中指定的列,要么包含聚组函数 select max(sal),job emp group by job; (注意max(sal),job的job并⾮⼀定要出现,但有意义) 查询语句的select 和group by ,having ⼦句是聚组函数唯⼀出现的地⽅,在where ⼦句中不能使⽤聚组函数。
select deptno,sum(sal)from emp where sal>1200group by deptnohaving sum(sal)>8500order by deptno;当在gropu by ⼦句中使⽤having ⼦句时,查询结果中只返回满⾜having条件的组。
在⼀个sql语句中可以有where⼦句和having⼦句。
having 与where ⼦句类似,均⽤于设置限定条件 where ⼦句的作⽤是在对查询结果进⾏分组前,将不符合where条件的⾏去掉,即在分组之前过滤数据,条件中不能包含聚合函数,使⽤where条件显⽰特定的⾏。
having ⼦句的作⽤是筛选满⾜条件的组,即在分组之后过滤数据,条件中经常包含聚合函数,使⽤having 条件显⽰特定的组,也可以使⽤多个分组标准进⾏分组。
使⽤order by排序时order by⼦句置于group by 之后并且 order by ⼦句的排序标准不能出现在select查询之外的列。
oracle中having用法
oracle中having用法Oracle数据库管理系统(RDBMS)是一种功能强大的关系型数据库管理系统,其中HAVING语句作为SQL语句中的一个重要组成部分,有着很重要的作用。
本文首先介绍HAVING语句的概念和定义,然后介绍它的特性,接着介绍它的使用,最后还介绍几个关于它的应用实例。
一、HAVING语句的概念和定义HAVING语句是SQL语言的一部分,它的定义是:HAVING子句为单独的SQL语句,用于对组或者结果集筛选数据,并且仅当在具有GROUP BY的语句中,才可以使用HAVING子句。
它可以使用条件来指定特定的行或者元组,仅当满足行内的某个条件时才被选出,从而满足一定的要求。
二、HAVING语句的特性(1)HAVING语句不能用于单独的SQL语句。
它只能与GROUP BY 语句一起使用,并且它一般出现在GROUP BY句之后;(2)HAVING语句可以搭配一个或多个条件条件,从而实现对组或者结果集的筛选;(3)HAVING语句只能搭配分组之后出现的列,不能搭配没有分组的原始表中的列。
三、HAVING语句的使用(1)HAVING语句语法HAVING句的语法结构如下:SELECT段列表FROM[WHERE或表达式][GROUP BY段列表]HAVING或表达式其中,HAVING句中可以定义一个或多个列或表达式,从而对GROUP BY子句组出来的结果进行筛选。
(2)HAVING语句实例实例1:查找商品表中的的商品名称和单价,价格大于10元的商品SELECT品名称,价FROM品表WHERE价>10;实例2:查找商品表中的商品名称、单价和价格分组,仅筛选出价格大于10元的商品SELECT品名称,价FROM品表GROUP BY价HAVING价>10;四、HAVING语句的应用实例(1)查找商品表中价格小于十元的商品SELECT品名称,价FROM品表WHERE价<10;(2)查找每个分组下价格大于50元的商品SELECT品名称,价FROM品表GROUP BY价HAVING价>50;(3)查找每个分组下单价大于30元且库存量小于200的商品 SELECT品名称,价FROM品表GROUP BY价HAVING价>30 AND存量<200;总结:本文首先介绍了HAVING语句的概念和定义,接着介绍了它的特性和使用,最后还介绍了几个关于HAVING语句的应用实例。
oracle group by 后取不为空的一条记录
oracle group by 后取不为空的一条记录在使用Oracle数据库时,我们经常会遇到需要对数据进行分组并筛选出满足条件的记录的情况。
其中,使用GROUP BY子句可以将数据按照指定的列进行分组,而在GROUP BY子句之后,我们可以使用HAVING子句来进一步筛选出满足条件的记录。
然而,在使用GROUP BY子句后,有时我们可能会遇到一种情况,即在分组后的结果集中,需要取出每组中不为空的一条记录。
本文将介绍如何使用Oracle的GROUP BY子句后取不为空的一条记录。
在Oracle中,我们可以使用聚合函数来对分组后的数据进行计算。
常见的聚合函数有SUM、COUNT、AVG、MAX和MIN等。
而在使用GROUP BY子句后,我们可以使用HAVING子句来筛选出满足条件的记录。
例如,我们可以使用HAVING COUNT(*) > 0来筛选出分组后的结果集中,满足条件的记录。
然而,如果我们想要取出每组中不为空的一条记录,我们可以使用Oracle的ROW_NUMBER()函数结合子查询来实现。
首先,我们可以使用ROW_NUMBER()函数为每组数据分配一个行号,然后在子查询中,我们可以使用ROW_NUMBER()函数的结果来筛选出每组中的一条记录。
具体的步骤如下:首先,我们需要使用GROUP BY子句对数据进行分组。
例如,假设我们有一个名为employee的表,其中包含员工的ID、姓名和工资信息。
我们可以使用以下语句对工资进行分组:```SELECT salary, COUNT(*)FROM employeeGROUP BY salary;```接下来,我们可以使用ROW_NUMBER()函数为每组数据分配一个行号。
我们可以在查询中使用ROW_NUMBER() OVER (PARTITION BY ...)语句来实现。
其中,PARTITION BY子句用于指定分组的列。
例如,我们可以使用以下语句为每个工资分组分配一个行号:```SELECT salary, ROW_NUMBER() OVER (PARTITION BY salary ORDER BY salary) AS row_numFROM employeeGROUP BY salary;```在上述语句中,我们使用了PARTITION BY salary来指定按照工资进行分组,并使用ORDER BY salary来指定按照工资进行排序。