
Oracle的Insert、Update、Delete等DML操作速度的提高
在Oracle数据库中,Insert、Update、Delete三个操作是对数据库中的数据进行插入、更新以及删除。
在进行这些操作时,如果数据库中的记录比较多时,则所需要的时间比较长。
如需要利用一个Update语句更新大量记录时,即使更新的内容很简单,如只是将价格提升10%,但是仍然需要花费比较成的时间。
所以从某种程度上来说,进行这些操作时其执行速度跟内容的大小关系不大,反而跟记录的多少却有很大的关系。
那么在Oracle数据库中,能否采取一些措施来提高这些操作的速度呢?为此笔者有如下两个建议,希望对大家有所帮助。
建议一:在执行这些操作时不向重做日志中写东西。
在执行更新、插入、删除操作时,默认情况下,其在更新数据的同时,也会像重做日志文件中记录这些改变。
如利用Update语句将数据库中产品的价格提高10%时。
数据库会更改这些价格,同时也会在重做日志中记录这些改变。
显然,更新一个数据,数据库要进行两项工作。
为此,当更新所涉及到的记录比较多时,这个更新操作就可能要耗费比较长的时间。
此时,可能需要更新内容本身字符的多少,跟其更新的效率并不具有很大的联系。
其执行的速度主要跟其更新所涉及到的记录数量有关。
为此,有时候在追求其更快的执行速度时,我们往往需要在这些语句中加入一个nologging选项。
如在使用Update语句更新价格信息时,加上这个Nologging选项就可以显著提高其执行的速度。
更新操作所涉及到的记录越多,其效果越明显。
那么这个可选项到底有什么作用呢?顾名思义,这个参数就是告诉数据库系统,在执行这个操作的时候,不要忘重做日志中记录相关的信息。
也就是说,此时数据库系统只需要做一件工作即可,至需要更改数据,而不会产生重做日志文件。
在理想的状态下,这么设置可以将这些操作的速度提高一倍。
所以在进行大规模的更新、删除、插入记录等操作时,笔者往往建议大家加上这个可选项,以提高执行的速度。
不过如果采用这个可选项的话,也有一个缺点。
因为其不会产生重做日志,所以如果数据更新失败或者出现其他一些意外故障,就不能够利用重做日志来恢复数据。
为此如果对于数据的准确性要求非常苛刻的话,采用这种方式来提高这些操作的执行速度,可能并不是一种合理的方法。
其是以牺牲数据的安全性来获取性能上的改进。
虽然这些操作出现故障的几率比较少见,但是在使用这个可选项时,数据库管理员必须要了解这个风险。
在可能的情况下,即使做好风险的评估与预防。
建议二:调整重做日志的大小来提高执行速度。
上面这种方法由于不产生重做日志,虽然提高了执行的速度,但是也带来了一定的安全风险。
那么是否有两全其美的方法呢,即能够提高执行速度,又能够保障数据的安全呢?在Oracle数据库中就有这么一个两全其美的方法。
就是调整重做日志的大小来提高执行速度。
来具体讲解这个方案时,笔者要强调的是此时数据库仍然会产生重做日志。
为此其效果没有上面这种方法好。
但是其可以保障数据的安全,在出现问题时,仍然可以利用重做日志来恢复数据。
所以说,这是在安全与速度之间实现了一个均衡。
在对记录进行大批量的更新时,在重做日志中产生相关的记录会花费比较多的时间。
其实这个时间也可以分为两个部分。
一是往重做日志中记录相关信息的时间;二是重做日志进行切换的时间。
在Oracle数据库的联机重做日志中,往往同时有多个重做日志文件。
当某个重做日志文件满时,则会将后续的记录写到下一个重做日志文件中。
但是在写入之前,其需要对这个即将被覆盖的重做日至进行归档,也就是进行备份。
在这个备份的时候,Update等更新操作不得不进行等待。
要等待其归档完成之后,再继续进行更新并产生重做记录。
也就是说,联机重做日志只有在被归档后才能够被覆盖,在这个归档的过程中,其他相关的操作必须等待,直到有可能的联接重做日志。
为此,如果这个重做日志的文件比较小,而利用Update更新的记录又比较多时,此时就可能需要使用多个重做日志文件来保存这些更改信息。
此时就需要进行多次等待才行。
那么就无形之中增加了这个操作的执行时间。
所以,经常需要对数据库进行大容量的更新、删除或者插入记录等操作的,最好能够调整这个重做日志文件的大小,以减少重做日志归档的等待时间,提高数据库的性能。
在调整这个重做日志文件之前,数据库管理员最好能够先确认一下,这个重做日志文件归档的频率。
如果归档的频率比较高,那么增加重做日志文件的大小,往往可以明显的提高数据库的性能,特别是插入、删除、更新等操作的效率。
那么该如何来判断这个重做日志文件归档是否频繁呢?在Oracle数据库中有比较多的方法。
其实重做日志文件就跟普通的文件相同,其也有更新时间等属性。
为此在操作系统上,可以对比几个重做日志文件的更新时间,来判断其归档的频率是否频繁。
另外在Oracle数据库中还有一个动态视图,名字为v$log_history。
在这个视图中存放着重做日至切换的相关记录。
如数据库管理员可以查询最近50个重做日志的切换记录,看看其相关的时间有多长,从而来判断这个重做日志的切换是正常的,还是太过于频繁。
一般情况下,只要增加这个重做日志文件的容量,就可以为大批量的更新、删除等操作提供比较大的重做日志空间。
此时执行一个大批量的更新操作时,可能只需要使用一个重做日志文件即可。
此时,在重做日志上所花的时间,就是只有产生重做记录的那部分时间,而没有重做日志切换归档时的等待时间。
所以,经过类似的调整之后,往往可以在很大程度上提高数据库的性能。
另外还有一种可行的方法是,不调整重做日志文件的大小,而是增加重做日志文件的数目。
如此也可以在频繁的日志切换过程中提供足够的日志空间。
不过笔者还是倾向与增加重做日志文件的容量来解决这个问题。
不过重做日志文件也并不是越大越好。
重做日志文件越大,其归档的时间也就越长。
俗话说,过之而不及。
有时候这反而会给数据库的安全与性能带来负面的影响。
根据笔者的经验,笔者认为这个重做日志文件切换的时间间隔最好能够在30分钟-40分钟之间。
因为现在即使再复杂的更新或者删除操作,基本上可以在这个时间内完成。
否则的话,可能就是语句方面有问题,需要对SQL语句进行优化。
所以将这个日志归档的时间间隔确定在这个时间范围之内是合理的。
作为合格的数据库管理员,需要持续追踪这个日志切换的时间间隔。
可以通过查看两个连续重做日志文件之间的更新时间间隔或者数据库系统的日志切换记录来查看这个日志切换的频率。
当调整完重做日志文件的大小之后,数据库管理员仍然需要在一段时间内追踪这个日志切换的频率。
以判断调整后的重做日志文件是否能够实现既定的目标。
如果效果不明显的话,可能还需要再次调整这个重做日志文件的大小。
Oracle数据库管理员可以使用ALTER DATABASE ADD LOGFILE语句来创建比较大的日志文件。
注意此时需要及时将比较小的日志文件删除。
否则的话,大小重做日志文件混用,并不能够起到预计的效果。
为此在调整日志文件大小时一般的步骤就是先创建多个大日志文件,然后再将小日志文件删除。
一般情况下,在删除小日志文件过程中,最好不要通过删除重做日志文件组来实现。
也就是说,在原有的重做日志文件组下面,建立大的重做日志文件;然后只删除小的重做日志文件。
即重做日志文件组仍然保持不变。
改变的只是其内部的重做日志成员而已。
五、DML操作汇总
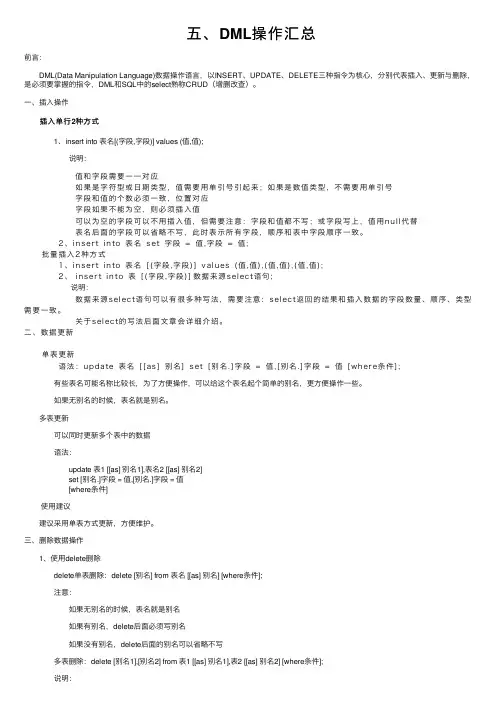
五、DML操作汇总前⾔: DML(Data Manipulation Language)数据操作语⾔,以INSERT、UPDATE、DELETE三种指令为核⼼,分别代表插⼊、更新与删除,是必须要掌握的指令,DML和SQL中的select熟称CRUD(增删改查)。
⼀、插⼊操作 插⼊单⾏2种⽅式 1、insert into 表名[(字段,字段)] values (值,值); 说明: 值和字段需要⼀⼀对应 如果是字符型或⽇期类型,值需要⽤单引号引起来;如果是数值类型,不需要⽤单引号 字段和值的个数必须⼀致,位置对应 字段如果不能为空,则必须插⼊值 可以为空的字段可以不⽤插⼊值,但需要注意:字段和值都不写;或字段写上,值⽤n u l l代替 表名后⾯的字段可以省略不写,此时表⽰所有字段,顺序和表中字段顺序⼀致。
2、i n s er t i n to表名s et 字段=值,字段=值; 批量插⼊2种⽅式 1、i n s er t i n to表名[(字段,字段)]v al u es(值,值),(值,值),(值,值); 2、i n s er t i n to表[(字段,字段)]数据来源s el ect语句;、 说明: 数据来源s el ect语句可以有很多种写法,需要注意:s el ect返回的结果和插⼊数据的字段数量、顺序、类型需要⼀致。
关于s el ect的写法后⾯⽂章会详细介绍。
⼆、数据更新 单表更新 语法:u pdate 表名[[as]别名]s et [别名.]字段=值,[别名.]字段=值[wh er e条件]; 有些表名可能名称⽐较长,为了⽅便操作,可以给这个表名起个简单的别名,更⽅便操作⼀些。
如果⽆别名的时候,表名就是别名。
多表更新 可以同时更新多个表中的数据 语法: update 表1 [[as] 别名1],表名2 [[as] 别名2] set [别名.]字段 = 值,[别名.]字段 = 值 [where条件] 使⽤建议 建议采⽤单表⽅式更新,⽅便维护。
Oracle之DML语句

Oracle之DML语句Oracle数据库的DML表数据的操作有三种:① insert (插⼊);② update(更新);③ delete(删除)。
为了将Oracle数据库的测试数据保持完整,我们队数据库的表emp进⾏复制到另外⼀张表上。
--创建以张新表,将数据拷贝到新表temp中。
create table temp as select*from emp;--复制表结构create table temp2 as select*from emp where1=2; --同样也⾏!--insert 插⼊--写法1insert into temp2(empno,ename,job,mgr,hiredate,sal,comm,deptno)values (9527,'Bob','SALESMAN',null,sysdate,1,null,10);select*from temp2;insert into temp2(empno,ename,job,mgr,hiredate,sal,comm,deptno)values (1024,'Aillen','SALESMAN',9527,sysdate,1000,100,10);--写法2 省略了指定的列名,顺序不能改变,按照表结构插⼊insert into temp2 values (1025,'SuperDrew','MANAGER',1024,sysdate,8000,200,10);--写法3insert into temp2 (empno,ename,job) values(1027,'Drew','KING');--直接将查询结构插⼊表中insert into temp2 (select*from emp);insert into temp2(empno,ename) values(1217,'Naike')--update 更新--将10部门的员⼯薪资加 $100select*from temp2;update temp2 set sal=sal+100where deptno=10;select*from temp2;--将所有员⼯的⼯资都改成1000?update temp2 set sal =1000;--delete 删除删除要注意要加where条件select*from temp2;--删除部门编号为20的所有员⼯delete from temp2 where deptno=20;delete from temp2;--清空表⽆需提交事务,效率也⾼truncate table temp2;-----------drop database orcl---谨慎使⽤!⼩⼼数据库⾥的实例数据将被清空!。
数据库实验报告 三DML练习

一、题目DML练习:UPDATA、DELETE、INSERT相关操作。
二、调试运行结果截图1、UPDATA(1)更新表S中的数据使AGE+1更新前UPDA TE SSET AGE=AGE+1更新后(2)用一张表去更新另一张表的数据UPDA TE TMP_SSSSET SNAME=S.SNAMEFROM SWHERE S.S#=TMP_SSS.S#UPDA TE TMP_SSSSET SNAME=(SELECT SNAMEFROM SWHERE S.S#=TMP_SSS.S#)SELECT*FROM TMP_SSS(3)把女同学的成绩提高10%U PDA TE SCSET GRADE=GRADE*1.1WHERE S#IN(SELECT S#FROM SWHERE SEX='女')SELECT*FROM SC(4)当课程低于该课程平均成绩是提高5%UPDA TE SCSET GRADE=GRADE+1.05WHERE C#='042083'AND GRADE<(SELECT A VG(GRADE)FROM SC WHERE C#='042083')SELECT*FROM SC2、DELETE(1)删除表的S#='040405028'行删前DELETE FROM SWHERE S#='040405028'删后(2)把课程名为“操作系统”的成绩从表SC中删除DELETE FROM SCWHERE C#IN(SELECT C#FROM CWHERE CNAME='操作系统')(3)把SC表中成绩大于C#='042096'平均分的同学的成绩删除删前DELETE FROM SCWHERE GRADE>(SELECT A VG(GRADE)FROM SCWHERE C#='042096');删后(4)删除基本表SCDELETE FROM SC3、INSERT(1)在新建的基本表SS中插入数据INSERT INTO SS( S#,SNAME,SEX,AGE )V ALUES('200510405301','张一二','男','20')(2)在基本表SC中连续插入3个元组INSERT INTO SCV ALUES('000000','0000','85'),('111111','1111','90'),('222222','2222','60')SELECT*FROM SC(3)在基本表SC中把平均分大于80的男生的学号和平均成绩存入另外一个已存在的基本表S_GRADE中INSERT INTO S_GRADE(S#,A VG_GRADE)SELECT S#,A VG(GRADE)FROM SCWHERE S#IN(SELECT S#FROM SWHERE SEX='男')GROUP BY S#HA VING A VG(GRADE)>60SELECT*FROM S_GRADE。
数据库面试题及答案

数据库面试题及答案在数据库领域的面试中,常常会遇到各种各样的问题。
这些问题涵盖了数据库的基本概念、SQL语言、数据库设计、性能优化等方面。
本文将为您详细介绍一些常见的数据库面试题及其答案,以帮助您在面试中更好地表现自己。
1. 什么是数据库的事务(transaction),并描述ACID特性。
答:事务是数据库中一系列操作的逻辑单位,要么全部执行成功,要么全部失败回滚。
ACID特性包括原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和持久性(Durability)。
2. 请解释一下SQL语言中的DDL、DML和DQL的概念。
答:DDL(Data Definition Language)用于定义数据库的结构或模式,如CREATE、ALTER和DROP等操作。
DML(Data Manipulation Language)用于操作数据库中的数据,如INSERT、UPDATE和DELETE等操作。
DQL(Data Query Language)用于查询数据库中的数据,如SELECT等操作。
3. 什么是数据库索引,以及为什么要使用索引?答:数据库索引是一种特殊的数据结构,用于加速对数据库表中数据的查询。
使用索引可以减少查询数据的IO消耗,提高查询效率。
索引的创建需要占用额外的存储空间,并在数据变更时维护索引,因此需要权衡存储空间和查询性能之间的关系。
4. 请简要介绍关系数据库设计中的三大范式。
答:第一范式(1NF)要求字段具有原子性,即每个字段的值不可再分。
第二范式(2NF)要求表中的非主键字段完全依赖于主键,不能存在部分依赖。
第三范式(3NF)要求表中的非主键字段与主键字段不存在传递依赖。
5. 如何进行数据库性能优化?答:数据库性能优化可以从多个方面入手。
首先,合理设计数据库结构,包括表、索引和关联等。
其次,编写高效的SQL查询语句,避免全表扫描和重复查询。
再次,定期优化数据库的配置参数,如缓冲区大小、连接数等。
数据库系统工程师招聘笔试题与参考答案(某大型国企)

招聘数据库系统工程师笔试题与参考答案(某大型国企)一、单项选择题(本大题有10小题,每小题2分,共20分)1、以下哪种数据库系统不支持行级锁?A. OracleB. MySQL(InnoDB引擎)C. SQL ServerD. SQLite答案:D解析:• A. Oracle数据库支持多种锁,包括行级锁,用于提供高并发性的数据访问。
• B. MySQL的InnoDB存储引擎支持行级锁,这有助于在多用户环境下提高性能和并发性。
• C. SQL Server也支持行级锁,以便在数据库操作中提供更细粒度的锁定和更高的并发性。
• D. SQLite的默认锁定机制是表级锁,而不是行级锁。
这意味着当对表进行写操作时,会锁定整个表,这可能会限制并发性。
2、在SQL中,若要实现“如果某个字段值不存在,则插入新记录;否则,更新该记录”的功能,以下哪种方法最适用于多数数据库系统?A. 使用IF-ELSE逻辑在应用程序代码中控制B. 使用MERGE语句(如果数据库支持)C. 先执行SELECT查询判断,再根据结果执行INSERT或UPDATED. 使用ON DUPLICATE KEY UPDATE(仅限于MySQL)答案:B解析:• A. 虽然可以在应用程序代码中实现此逻辑,但这样做会使数据库操作与应用程序代码紧密耦合,降低代码的可移植性和可维护性。
• B. MERGE语句(也称为UPSERT语句)允许在单个语句中执行INSERT和UPDATE 操作,根据是否存在特定条件(如主键或唯一索引冲突)来决定是插入新记录还是更新现有记录。
这种方法既高效又易于管理,适用于支持MERGE语句的数据库系统。
• C. 这种方法虽然可以实现所需功能,但需要通过两次与数据库的交互(一次SELECT,一次INSERT或UPDATE)来完成,增加了网络延迟和数据库负载。
• D. ON DUPLICATE KEY UPDATE是MySQL特有的语法,用于处理主键或唯一索引冲突时的记录更新,但它不是跨数据库系统的通用解决方案。
oracleparallel用法

Oracle Parallel用法介绍Oracle Parallel是Oracle数据库提供的一种功能,可以使数据库的查询和操作在多个处理单元上并行执行,从而提高性能和吞吐量。
本文将详细探讨Oracle Parallel的用法,包括如何配置和使用。
配置1.首先,确保数据库的版本满足Oracle Parallel的要求。
从OracleDatabase 11g开始,Oracle Parallel就内置在数据库中。
2.确认数据库是否已启用并行功能。
可以通过执行以下查询语句来检查:SELECT * FROM v$option WHERE parameter = 'Parallel Server'3.如果Parallel Server参数的值为TRUE,则表示数据库已启用并行功能。
如果为FALSE,则需要在数据库初始化参数文件中启用并行功能。
可以使用文本编辑器打开参数文件,找到以下行并编辑之:parallel_max_servers=164.在上述示例中,16是并行服务器的数量,可以根据实际需求进行调整。
修改完成后,保存参数文件并重启数据库。
使用并行查询并行查询是使用Oracle Parallel最常见的用法之一。
通过并行查询,可以将一个大型查询任务分割成多个子任务,并在多个处理单元上并行执行,从而加快查询速度。
以下是使用并行查询的步骤:1.创建并行查询的表。
在创建表时,可以使用PARALLEL关键字指定并行属性:CREATE TABLE employees (id NUMBER,name VARCHAR2(50),age NUMBER) PARALLEL;2.设置并行度。
并行度决定了同时执行查询的并行进程数量。
可以通过ALTERTABLE语句来设置并行度:ALTER TABLE employees PARALLEL(DEGREE 4);3.编写并行查询语句。
在查询语句中使用PARALLEL关键字指定并行执行:SELECT * FROM employees PARALLEL;并行DML操作除了并行查询,Oracle Parallel还支持并行DML(数据操纵语言)操作,如INSERT、UPDATE和DELETE。
数据库面试题及答案
数据库⾯试题及答案1. 触发器的作⽤? 触发器是⼀种特殊的存储过程, 主要是通过时间来出发⽽被执⾏的. 它可以强化约束,来维护数据的完整性和⼀致性, 可以跟踪数据库内的操作从⽽不允许未经许可的更新和变化. 可以级联运算2. 什么是存储过程? ⽤什么来调⽤? 存储过程是⼀个预编译的SQL语句, 有点事允许模块化的设计, 只需要创建⼀次,就可以被多次调⽤,如果需要执⾏多次SQL,那么存储过程的速度更快. 可以⽤命令对象来调⽤存储过程. 可以供外部程序调⽤, 如java程序3. 存储过程的有优缺点? 优点: 存储过程是⼀个预编译的SQL语句, 执⾏效率⾼ 放在数据库中,直接调⽤,减少⽹络通信 安全性⾼ 可重复使⽤ 缺点: 移植性差4. 存储过程与函数的区别? 存储过程: 在数据库中完成指定的增删改查操作 申明: procedure 函数: 在编程语⾔中进⾏任务的处理 申明: function5. 索引的作⽤? 和他的优点缺点是什么? 索引就是⼀种特殊的查询表, 数据库的搜索可以利⽤它加速对数据的检索. 类似于现实⽣活中的⽬录. 不需要查找整本书就可以找到想要的结果.6. 什么样的字段适合建⽴索引? 唯⼀, 不为空, 经常被查询的字段 7. 索引的类型有哪些? 逻辑上: 单⾏索引,多⾏索引,唯⼀索引,⾮唯⼀索引,函数索引,域索引. 物理上: 分区索引, ⾮分区索引 B-tree: 正常性B树 反转型B树 bitmap位图索引8. 什么是事务? 什么是锁? 事务就是被绑在⼀起作为⼀个逻辑⼯作单元的SQL语句分组, 如果任何⼀个语句操作失败那么整个操作就会失败, 会回滚到之前的状态.要么全部执⾏, 要么⼀个都不执⾏. 锁: DBMS中, 锁是实现事务的关键.9. 什么叫视图? 游标是什么? 视图就是⼀种虚拟的表, 具有和物理表相同的功能. 可以对视图进⾏增改查操作, 视图通常是⼀个表或多个表的⾏或列的⼦集 游标是遍历结果集的⼀个指针, ⽤来逐条处理数据10. 视图的优缺点? 优点: 对数据的选择性访问 ⽤户可以通过简单的查询从复杂查询中得到结果 维护数据的独⽴性 对相同的数据产⽣不同的视图 缺点: 性能11. 列举⼏种表连接的⽅式,有什么区别? 左连接: 左边为主表表数据全部显⽰, 匹配表的不匹配部分不显⽰ 右连接: 右边为主表表数据全部显⽰, 匹配表的不匹配部分不显⽰ 内连接: 只有两个元素表相匹配的才能在结果集中显⽰ 全外连接: 连接中的不匹配的数据全部会显⽰出来 交叉连接: 笛卡尔乘积, 显⽰的结果是连接表数的乘积12. 主键和外键的区别? 主键在本表中是唯⼀的,不为空的, 外键可以重复和为空. 外键和另外⼀张表相关联, 不能创建对应表中不存在的外键.13. 在数据库中查询语句速度很慢, 如何优化? 建⽴索引 减少表之间的关联 优化SQL语句 简化查询字段14. 数据库三范式是什么? 第⼀范式: 列不可再分 第⼆范式: ⾏可以唯⼀区分, 主键约束 第三范式: 表的⾮主属性不能依赖其他表的⾮主属性外键约束15. union和union all有什么不同? union会删掉重复的记录, union all不会16. varchar2和varchar有什么区别? varchar2是Oracle⾃⼰开发的, ⽬前varchar2和varchar是同义词, 关键点是varchar是可变长度的, 可以根据实际的长度来存储17. oracle和mysql的区别? 库函数不同 Oracle是⽤表空间来管理的, mysql不是 SQL语句不同 分页查询不同18. oracle语句有多少类型? DDL, DML, DCL DDL: 建表,建数据库,建⽴约束,修改约束,权限修改 DML: insert, update, delete DCL: 管理⽤户权限19. oracle的分页查询语句? select * from table where row_num between 1 and 10;20. 从数据库中随机选择50条? select * from (select * from example order by dbms_random.random) where rownum <= 50;21. order by与group by的区别? order by是排序查询 group by是分组查询 having只能在group by之后, 使⽤group by查询的语句需要使⽤聚合函数22. commit在哪⾥会运⽤? Oracle的commit就是DML语句提交数据. 在未提交之前你的操作都是保存在内存中, 没有更新到物理内存中. 执⾏commit从⽤户⾓度来讲就是更新到物理⽂件了. 事实上commit还写⼊了⽇志⽂件23. ⾏转列, 列转⾏怎么转? 使⽤decode函数, 或者使⽤case when语句24. 什么是PL/SQL? PL/SQL是⼀种程序语⾔,叫做过程化SQL语⾔, PL/SQL是对oracle数据库对SQL语句的扩展. 在普通的SQL语句的使⽤上增加了编程语⾔的特点. 通过逻辑判断,循环等操作来实现复杂的功能或者计算. PL/SQL只有Oracle数据库有, mySQL现在不⽀持PL/SQL25. 序列的作⽤? Oracle使⽤序列来⽣成唯⼀的编号, ⽤来处理⼀个表中的⾃增字段.26. 表和视图的关系? 视图其实就是⼀条查询语句, ⽤于显⽰⼀个或多个表或其他视图中的数据, 表就是关系型数据库中实际存储数据⽤的.27. oracle基本数据类型? 字符串 char nchar varchar varchar2 nvarchar2 数字 number integer 浮点 binary_float binary_double float ⽇期时间 date timestamp 字符块 blob clob nclob bfile28. truncate与delete的区别? delete table: 删除内容, 不删除定义, 不释放空间 truncate: 删除内容和定义,释放空间29. oracle获取系统时间? select to_char(sysdate,"yyyy-MM-dd") from dual30. oracle如何去重? 使⽤distinct关键字。
Oracle期末考试复习题
oracle复习题一、填空题:1. Oracle EnterpriseManager是一个基于B/S的框架系统。
2.Oracle数据库的存储结构分为物理结构和逻辑结构。
3.在游标或者游标变量打开后还没有进行第一次提取时,%found属性为null。
4. 在oracle中已commit或rollback作为上一个事务的结束标志及下一个新事物开始的标志。
5. DML表示数据操作语言,主要的DML有SELECT,INSERT,UPDATE,DELETE. 6.索引的主要目标是提高访问的速度。
7.在Oracle database 10g 系统中,可以使用DBCA工具和CREATE DATEBASE命令两种方式创建数据库。
8. 命令Startup nomount只能启动数据库实例,但不能装载和打开数据库。
9.在输入URL进入Oracle Enterprice Manager Database Control 的时候,必须指出ip地址和端口号。
10.在登录Oracle Enterprice Manager Database Control时,连接身份有两种选择,分别为normal和sysdba。
二、选择题:1.当Oracle服务器启动时,下列哪种文件不是必须装入内存的()。
DA. 数据文件B. 控制文件C. 日志文件D. 归档日志文件2. 在Oracle中,当用户要执行SELECT语句时,下列哪个进程从磁盘获得用户需要的数据()。
BA.用户进程 B. 服务器进程 C. 日志写入进程(LGWR) D. 检查点进程(CKPT)3. 在Oracle数据库的逻辑结构中有以下组件:A 表空间;B 数据块;C 区;D段;这些组件从大到小依次是()。
BA. A→B→C→DB. A→D→C→BC. A→C→B→DD. D→A→C→B4. (B )可以从过程返回多个值。
A. 使用IN参数B. 使用OUT参数C. 使用指针D. 不能5.PL/SQL为内存耗尽时,预定义了(C )异常。
oracle并行用法
oracle并行用法
Oracle并行指的是在Oracle数据库中同时执行多个操作,从而提高数据库性能和并发能力。
1. 并行查询:在一个查询语句中使用并行提示(/*+ PARALLEL(表名, 并行度) */)来指定要并行执行的操作。
并
行度决定了查询在多个并行执行进程之间的划分,可以根据系统的硬件资源和查询的复杂度来决定并行度的设置。
2. 并行DML:在执行大量的数据修改操作(如insert、update、delete)时,可以通过并行DML来加速操作。
通过设置PARALLEL DML参数(如PARALLEL_DEGREE_POLICY和PARALLEL_MIN_PERCENT)来控制并行DML的行为。
3. 并行DDL:在执行一些DDL操作(如创建表、重建索引、
分区表等)时,可以使用并行DDL来加速操作。
通过设置PARALLEL DDL参数(如PARALLEL_DEGREE_POLICY)
来控制并行DDL的行为。
4. 并行服务器:Oracle数据库中有一个专门的服务器进程(Parallel Query Slaves)来执行并行操作。
可以通过设置PARALLEL_MAX_SERVERS参数来控制并行服务器的数量,以适应系统的并行需求。
5. 并行提示:在查询语句中使用串行提示(/*+
NO_PARALLEL(表名) */)来取消并行执行的操作。
这样可以
在某些情况下临时禁止并行执行,以便进行调试或性能比较等
操作。
需要注意的是,并行执行可能会增加系统的负载和资源消耗,因此在使用并行功能时需要根据实际情况进行合理调整,避免对系统性能造成过大的影响。
DML数据操作语言
DML数据操作语⾔DML(Data Manipulation Language):数据操作语⾔,⽤来定义数据库记录(数据); INSERT、 UPDATE、 DELETEDML是对表中的数据进⾏增、删、改的操作。
1、INSERT语句⽤于向表中插⼊新记录语法:INSERT INTO table_name VALUES (value1,value2,value3,...) # ⽆需指定列名可以插⼊多⾏VALUESINSERT INTO table_name (column1,,column2,column3,...) VALUES (value1,value2,value3,...) # 需要指定插⼊的列名⽰例# ⽆需指定列名mysql> insert into user values (1,"张三",25,"男");Query OK, 1 row affected (0.00 sec)# 查询数据mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | 男 |+------+--------+------+--------+1 row in set (0.01 sec)# 插⼊多条数据mysql> insert into user values (3,"赵武",25,"男"),(4,"⼩六",20,"男");Query OK, 2 rows affected (0.00 sec)Records: 2 Duplicates: 0 Warnings: 0mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | ⼥ || 2 | 李四 | 30 | ⼥ || 3 | 赵武 | 25 | 男 || 4 | ⼩六 | 20 | 男 |+------+--------+------+--------+4 rows in set (0.00 sec)# 指定具体列名mysql> insert into user (id,name) values (2,"李四");Query OK, 1 row affected (0.00 sec)# 查询数据mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | 男 || 2 | 李四 | NULL | NULL |+------+--------+------+--------+2 rows in set (0.00 sec)2、UPDATE语句⽤于更新表中的记录语法UPDATE table_name SET column1=value1,column2=value2,...UPDATE table_name SET column1=value1,column2=value2,... WHERE some_column=some_value ⽰例# ⽆条件修改所有数据mysql> update user set gender="⼥";Query OK, 2 rows affected (0.00 sec)Rows matched: 2 Changed: 2 Warnings: 0mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | ⼥ || 2 | 李四 | NULL | ⼥ |+------+--------+------+--------+2 rows in set (0.00 sec)# 带条件修改数据mysql> update user set age=30 where id=2;Query OK, 1 row affected (0.01 sec)Rows matched: 1 Changed: 1 Warnings: 0mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | ⼥ || 2 | 李四 | 30 | ⼥ |+------+--------+------+--------+2 rows in set (0.01 sec)3、DELETE语句⽤于删除表中的记录语法DELETE FROM table_name # 删除表中所有数据DELETE FROM table_name WHERE column=value # 根据条件删除mysql> delete from user where name="赵武";Query OK, 1 row affected (0.01 sec)mysql> select * from user;+------+--------+------+--------+| id | name | age | gender |+------+--------+------+--------+| 1 | 张三 | 25 | ⼥ || 2 | 李四 | 30 | ⼥ || 4 | ⼩六 | 20 | 男 |+------+--------+------+--------+3 rows in set (0.00 sec)4、TRUNCATE语句truncate的作⽤是清空表或者说是截断表,只能作⽤于表语法truncate table tab_name #删除数据,并保留表结构,⼜会⾃动缩减数据⽂件的⼤⼩truncate tab_nametruncate与drop,delete的对⽐truncate与drop是DDL语句,执⾏后⽆法回滚;delete是DML语句,可回滚。