
SPSS 17.0 神经网络分析中文版使用指南
“保姆级”操作教程 手把手教你SPSS分析数据实战这也太方便了吧

保姆级操作教程 | 手把手教你SPSS分析数据实战这也太方便了吧数据分析是现代社会研究中不可或缺的一部分。
而SPSS作为一款功能强大且易于使用的统计分析软件,受到了许多研究人员和学生的青睐。
本文将手把手教你如何使用SPSS进行数据分析,让你的研究工作更加高效和准确。
步骤1:导入数据首先,打开SPSS软件并点击菜单栏上的“文件”选项。
然后选择“打开”并浏览你存储数据集的位置。
选择相应的数据文件,并点击“打开”。
现在,你的数据集就已经成功导入。
步骤2:查看数据在导入数据后,你可以通过点击菜单栏上的“数据视图”选项来查看数据。
在数据视图中,你可以浏览和编辑数据。
如果你想查看数据的统计摘要信息,可以点击菜单栏上的“变量视图”选项。
步骤3:数据清理在进行数据分析之前,你需要对数据进行清理。
这包括处理缺失值、异常值和离群值等。
SPSS提供了一系列用于数据清理的功能,例如删除无效数据、替换缺失值等。
你可以使用菜单栏上的“转换”选项来执行这些操作。
步骤4:选择统计分析方法在进行数据清理后,接下来需要选择合适的统计分析方法。
SPSS提供了多种常用的统计分析方法,例如描述统计、相关分析、回归分析、t检验等。
你可以根据自己的研究目的和数据类型选择相应的方法。
步骤5:进行统计分析一旦你选择了合适的统计分析方法,你可以点击菜单栏上的“分析”选项,并选择相应的分析方法。
然后,你需要选择要分析的变量,并设置相应的参数。
点击“确定”后,SPSS将自动进行统计分析,并生成相应的结果。
步骤6:解读结果进行完统计分析后,你需要对分析结果进行解读。
SPSS会生成各种统计指标和图表,用于帮助你理解数据。
你可以查看参数估计值、置信区间、显著性水平等信息,并根据这些结果进行推断和判断。
步骤7:报告和呈现结果最后,你需要将分析结果进行报告和呈现。
SPSS提供了生成报告和图表的功能,你可以根据需要选择相应的样式和格式。
在报告中,你可以总结分析结果、提出结论,并展示相关的图表和图形。
SPSS—神经网络

神经网络
使用这两种方法的任何一种,您可以将数据拆分成训 练集、测试集、验证集。训练集用来估计网络参数。 测试集用来防止过度训练。验证样本用来单独评估最 终的网络,它将应用于整个数据集和新数据。
第5页,共22页。
多层感知器实例分析
首先产生随机数来选择样本数据集,选菜单‘转换 (Transform)---随机数生成器(Random Number Generators)’---弹出对话框如图1---选择‘设置起点 (Set Starting Point )’---选中‘固定值(Fixed Value)’---填入9191972,然后单击确定(OK)。
第3页,共22页。
神经网络
SPSS神经网络,包括多层感知器(MLP)或者径 向基函数(RBF)两种方法。 这两种方法都是有 监督的学习技术-也就是说,他们根据输入的数 据映射出关系。这两种方法都采用前馈结构,意 思是数据从一个方向进入,通过输入节点、隐藏 层最后进入输出节点。你对过程的选择受到输入 数据的类型和网络的复杂程度的影响。此外,多 层感知器可以发现更复杂的关系,径向基函数的 速度更快。MLP可以发现更复杂的关系,而通常 来说RBF更快。
第12页,共22页。
多层感知器实例分析
图4
第13页,共22页。
多层感知器实例分析
单击‘输出(Output)’标签,弹出如图5 选择‘ROC曲线(ROC Curve)’,‘累积增益曲线 (Cumulative Gains Chart)’,‘增益图(Lift Chart )’,‘观察预测值(Prdicted by Observed Chart)’,去掉‘图表(Diagram)’。最后选择‘自 变量重要性分析(Independent Variable Import Analysis)’选项栏。然后,单击‘确定(OK)’按钮 进行分析。
spss statistics base 17.0 说明书

而且,SPSS Statistics能使分析连续型数据的准备 工作简单易行。可视化分段使您轻松地创建数据分段 (例如,把收入分为以10,000为间距的分段,或对年 龄分组)。数据通道(data pass)呈现的直方图智能 化地帮助您设置分段的具体间隔点。您还可以自动地 为分段设置值标签(例如,“21-30”)。
快捷轻松地为分析做数据准备 进行数据分析之前,您需要准备数据以便分析。
SPSS Statistics Base包含的众多技术和功能特性使数据 准备简单易行。下面只对SPSS Statistics Base几个显著 的数据管理特性的进行简要描述。
利用SPSS Statistics Base,您可以轻松地实现数据 字典的建立(例如,值标签和变量类型),并且利用 定义数据属性工具可使分析前进行的数据准备工作更 加快捷!SPSS Statistics会呈现数值列表以及对这些数 值的计数,以便您添加这些信息。一旦建立了数据字 典,您就可以利用复制数据字典的工具来应用它。数 据字典可以作为模板来应用,所以您可以将其应用到 其它数据文件或同一数据文件的其它变量。
■ 导出结果为PDF格式: – 可以生成是否生成页码以及大纲 – 可以改变是否固定字体 – 自动化生成报告语法
■ 使用语句,容易打开/保存和新建输出文件 ■ 通过滑动鼠标浏览输出结果 ■ 在不同输出语言中切换(例如,由中文和
英语输出中转换) ■ 利用脚本功能
– 建立、编辑和保存脚本 – 建立定制的界面 – 指定工具栏图标和菜单项的功能 – 自动执行脚本以响应特定事件 – 支持Python 2.5使脚本生成更容易、更
使用SPSS (SPSS17.0中文版)统计软件的统计分析操作方法之欧阳地创编
植物的若干性状测定与统计使用SPSS(SPSS17.0中文版)统计软件的统计分析操作方法
时间:2021.03.04 创作:欧阳地
峰哥
(昆明学院园艺二班)
摘要:使用SPSS(SPSS17.0中文版)统计软件的统计分析操作对大学生统计数据分析极为重要,但大多学生不会使用SPSS,而且培训使用软件操作费用昂贵,为了方便学生学习,做了一个简单的操作SPSS(SPSS17.0中文版)统计软件的方法。
关键字:使用SPSS 统计软件操作简单的操作SPSS
1.打开SPSS17.0中文版
2.选择,
3.打开自己的数据如“”
5.选择“品种”和“茎粗”的数据
点开SPSS窗口→点击“”→单击→修
改菜单名“”
6.单击“”→“”→“”
7.单击“”→“”
8.单击“”→“”
9.单击“”→→→
→→
→
10.单击“”→→→
11.单击
“”→→→
12.单击“”
13.单击鼠标右键→→→→
→→,
完成!!“”,如下图顺序操作!!
同样的方法再做其他数据!!如下图一样复制进行操作!!!
时间:2021.03.04 创作:欧阳地。
SPSS神经网络模型

SPSS神经⽹络模型实验⽬的 学会使⽤SPSS的简单操作,掌握神经⽹络模型。
实验要求 使⽤SPSS。
实验内容 (1)创建多层感知器⽹络,使⽤多层感知器评估信⽤风险,银⾏信贷员需要能够找到预⽰有可能拖⽋贷款的⼈的特征来识别信⽤风险的⾼低。
(2)实现神经⽹络预测模型,使⽤径向基函数分类电信客户。
实验步骤 (1)创建多层感知器⽹络,分析⽰例——使⽤多层感知器评估信⽤风险,银⾏信贷员需要能够找到预⽰有可能拖⽋贷款的⼈的特征来识别信⽤风险的⾼低。
详细见bankloan.sav⽂件。
SPSS操作,点击【转换】→【随机数⽣成器】,在打开的对话框中,勾选【设置起点】,点击【估计值】,值设为“9191972”,单击【确定】。
【转换】→【计算变量】,在打开的对话框中,把“partion”输⼊【⽬标变量】。
在【数字表达式】中输⼊表达式(2*RV.BERNOULLI(0.7)-1),单击【确定】。
点击【分析】→【神经⽹络】→【多层感知器】,在打开的对话框中,把如图⽰的变量选⼊相应的地⽅。
【分区】,点击【使⽤分区变量来分配个案】,并把“partion”选⼊【分区变量】中。
点击【输出】,勾选想要输出的图表,点击【保存】,单击【确定】。
运⾏结果,个案处理摘要个案数百分⽐样本训练49971.3%坚持20128.7%有效700100.0%排除150总计850⽹络信息输⼊层因⼦1Level ofeducation协变量1Age in years2Years withcurrent employer3Years at currentaddress4Householdincome inthousands5Debt to income5Debt to incomeratio (x100)6Credit card debtin thousands7Other debt inthousands单元数a12协变量的重新标度⽅法隐藏层隐藏层数1隐藏层 1 中的单元数a4激活函数输出层因变量1单元数2激活函数误差函数a. 排除偏差单元模型摘要训练交叉熵误差156.605不正确预测百分⽐15.6%使⽤的中⽌规则超出最⼤时程数(100)训练时间0:00:00.25坚持不正确预测百分⽐25.4%因变量:Previously defaulted分类样本实测预测No Yes正确百分⽐训练No3472892.5% Yes507459.7%Yes507459.7%总体百分⽐79.6%20.4%84.4%坚持No1231986.6% Yes322745.8%总体百分⽐77.1%22.9%74.6%因变量:Previously defaulted曲线下⽅的区域区域Previously defaulted No.907Yes.907代码:1 COMPUTE partion=2*RV.BERNOULLI(0.7)-1.2 EXECUTE.3 *Multilayer Perceptron Network.4 MLP default (MLEVEL=N) BY ed WITH age employ address income debtinc creddebt othdebt5 /RESCALE COVARIATE=STANDARDIZED6 /PARTITION VARIABLE=partion7 /ARCHITECTURE AUTOMATIC=YES (MINUNITS=1 MAXUNITS=50)8 /CRITERIA TRAINING=BATCH OPTIMIZATION=SCALEDCONJUGATE LAMBDAINITIAL=0.00000059 SIGMAINITIAL=0.00005 INTERVALCENTER=0 INTERVALOFFSET=0.5 MEMSIZE=100010 /PRINT CPS NETWORKINFO SUMMARY CLASSIFICATION11 /PLOT NETWORK ROC GAIN LIFT PREDICTED12 /SAVE PREDVAL PSEUDOPROB13 /STOPPINGRULES ERRORSTEPS= 1 (DATA=AUTO) TRAININGTIMER=ON (MAXTIME=15) MAXEPOCHS=AUTO14 ERRORCHANGE=1.0E-4 ERRORRATIO=0.00115 /MISSING USERMISSING=EXCLUDE .多层神经⽹络 (1)实现神经⽹络预测模型,分析⽰例——使⽤径向基函数分类电信客户,具体见telco.sav。
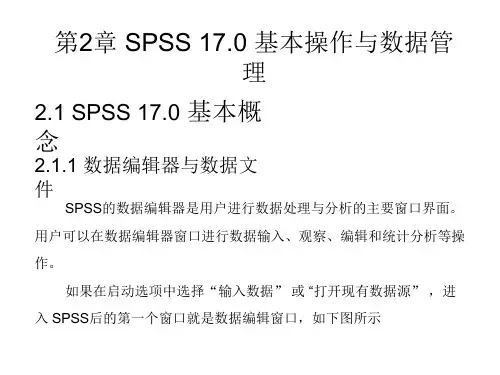
第2章 SPSS 17.0 基本操作与数据管理
(2)字符型:
字符型编变量由字符串组成,可以包含数字、字母和一些特殊符号。字符型变 量的默认长度为8,大于8个字符的称为长字符型变量,少于8个字符的称为短字
符型变量,字符型变量最长为32767个字符。他不能参与运算,区分大小写字母。
(3)日期型: 日期型变量用于表示日期和时间,他有29种不同的日期和时间格式,不能参与运算 ,要参与必须通过日期函数进行转换。 如:1-12-2009、29.12.99等
2.1.2 常量、变量、操作符和表达 一 、 常量与变量 式
1.SPSS常量 SPSS中的常量在一定阶段内其取值不随观测而改变的值。有3种类型 (1)数值型: 数据型常量是一个数值。他有两种书写方式: 一是普通书写方式,如:53、74.2等; 二是科学计数书写方式,其使用指数表示数值,通常用于表示贴别大 或特别小的数值。如:1.2E+05 表示1.2×10⁵ (2)字符型: 字符型常量是被单引号或双引号括起来的一串字符。如果本身带有单 引号或半个单引号,则必须使用双引号括起来。 如:beijing 处理时用双引号扩起来,即“beijing” (3)日期型: 按特定格式存储日期数据 ,一般使用较少 格式很多,如:20-AUG-1999
(2)比较表达式
比较表达式是利用关系运算符建立起的两个变量间的比较关系,要求相 互比较的两个量类型一致,他的结果一般逻辑型。
如:x=2,则表达式“x>0”为真,系统返回1(true)。
(3)逻辑表达式
逻辑表达式由逻辑运算符、逻辑型的变量或取值为逻辑型的比较表达式 构成。他的值为逻辑型常量。如:对于表达式“true AND true” 系统 返回“true ” , “true OR false” 系统返回“true ” 。
SPSS神经网络
汇报人:
单击输入目录标题 SPSS神经网络概述 SPSS神经网络的实现过程 SPSS神经网络的优势和局限性
SPSS神经网络与其他模型的比较
SPSS神经网络的案例分析
添加章节标题
SPSS神经网络概述
定义和原理
SPSS神经网络: 一种基于SPSS软 件的神经网络模型 用于处理复杂的非 线性问题
适用场景: SPSS神经网络 适用于非线性、 复杂的数据而决 策树和逻辑回归 则适用于线性、 简单的数据。
模型性能: SPSS神经网络 的性能通常优于 决策树和逻辑回 归但在某些情况 下决策树和逻辑 回归的性能可能
更好。
模型解释性: SPSS神经网络 的解释性较差而 决策树和逻辑回 归的解释性较好。
网络设计
选择激活函数:Sigmoid、 Tnh 、ReLU等
确定网络结构:输入层、隐 藏层、输出层
设定网络参数:学习率、批 次大小、迭代次数等
训练网络:使用训练数据集 进行训练调整网络参数以优
化模型性能
训练和优化
Байду номын сангаас
数据预处理:清洗、标准 化、归一化等
模型构建:选择合适的神 经网络模型如多层感知器、 卷积神经网络等
添加标题
添加标题
添加标题
添加标题
金融领域:风险评估、投资决策等
交通领域:自动驾驶、交通流量预 测等
面临的挑战和机遇
挑战:数据量巨大需要更高效 的算法和硬件支持
挑战:模型复杂度高需要更先 进的优化算法
机遇:人工智能技术的快速发 展为SPSS神经网络提供了更 广阔的应用空间
机遇:大数据时代的到来为 SPSS神经网络提供了更多的 数据资源和应用场景
使用SPSS统计软件进行数据分析入门指南
使用SPSS统计软件进行数据分析入门指南第一章:SPSS统计软件简介SPSS(Statistical Package for the Social Sciences,社会科学统计软件包)是一款专门用于数据分析和统计建模的软件工具。
它提供了一系列的数据处理、描绘和统计分析方法,可用于解决各种统计学问题。
本章将介绍SPSS软件的基本概念和功能,并指导读者进行安装和设置。
1.1 SPSS软件的背景和发展历程1.2 SPSS软件的版本和特点1.3 安装SPSS软件1.4 设置SPSS软件的语言和界面1.5 SPSS数据文件的格式和类型1.6 打开、保存和关闭SPSS数据文件第二章:SPSS数据管理与数据清洗数据分析的第一步是数据的收集和管理。
本章将介绍如何在SPSS软件中进行数据的导入、清洗和变换,以确保数据的质量和准确性。
2.1 导入数据文件2.2 数据类型和变量属性设置2.3 缺失值处理2.4 数据的筛选与排序2.5 数据的变换与合并2.6 数据文件的导出和备份第三章:SPSS数据描述统计分析在进行深入的数据分析之前,首先需要对数据进行描述和总结,以获得对数据分布和特征的初步了解。
本章将介绍SPSS如何进行数据的描述性统计分析和数据可视化。
3.1 数据的描述性统计量3.2 数据的频数和交叉分析3.3 数据的描述性图表3.4 数据的相关分析3.5 数据的因子分析3.6 数据的聚类分析第四章:SPSS统计推断分析统计推断分析是利用样本数据对总体进行推断的一种方法。
本章将介绍如何利用SPSS软件进行统计推断分析,并解释如何进行假设检验、方差分析和回归分析等常用的统计方法。
4.1 参数统计分析与假设检验4.2 方差分析与多元方差分析4.3 相关与回归分析4.4 判别分析与逻辑回归分析4.5 非参数统计分析方法4.6 多元统计分析方法第五章:SPSS高级数据分析与报告生成在完成基本的数据分析后,可以进行一些更高级的操作和分析,以进一步深入了解数据的内在关系和结构。
SPSS17基本操作
SPSS17.0的基本操作入门操作数据的输入建立字段——输入数字——保存(分别在data view和variabe view下处理)数据的简单描述(n,最大值,最小值,平均值,方差)Descriptive Statistics→Descriptives→选择变量→ok(分组描述方法:Data→Split File→选择分组指标→ok→再进行上面分析)绘制直方图Graphs→Histogram→选择变量→ok统计分析(两个样本的均值比较-t检验)Analyze→Compare Mean→Independent-Samples T test→选择变量和分组变量→设置分组变量值→ok(结果如下)Independent Samples TestLevene's Test for Equality of Variances t-test for Equality of MeansF Sig. t df Sig. (2-tailed) Mean Difference Std. Error Difference 95% Confidence Interval of the DifferenceLower Upperx Equal variances assumed .032 .860 2.524 22 .019 .43629 .17288 .07777 .79482Equal variances not assumed 2.524 21.353 .020 .43629 .17286 .07716 .79542(1)方差齐性检验时F越小(p越大),就证明没有差异,就说明齐,这与方差分析均数时F越大约好相反。
F=MS组间/MS误差=(处理因素的影响+个体差异带来的误差)/个体差异带来的误差(2)统计显著性(sig)就是出现目前样本这结果的机率,即P=sig=0.860,sig越接近1越齐(3)df为自由度df=n-2=24-2=22(4) ∂=0.05数据编辑窗口的用法variable view下的设置,主要是name,lable,measure栏value是可以改关联数字代表的意义,可以定义三组类型,显示可以view /value lables Measure可以选三种类型:scale 标度测量Ordinal 有序测量,有序分类,有高低之分Nominal 名义测量,没有高低之分;例如:血型数据编辑操作的技巧(1)快速查找异常值极端值排序,右键排序(2)冻结数据表右键,pin selected coolumns(只能从左端开始冻结)(3)快速改变列位托(4)利用变量标签数据文件的处理data和transform菜单的应用Transforms(1)compute过程(赋值,条件赋值)新建自变量→transforms/compute→赋值一个→再制造条件if(2)count过程(定义缺失值,变量范围)Transforms/count→define values→定义缺失值,range变量范围(3)recode过程(根据原条件得到新的变量)Transforms/recode→different variable→填写新变量名→选择自变量→change→old and new values→定义条件和new values(4)rank cases过程(分组排序)Transforms/rank cases→选择自变量和分组变量DATA(1)sort case过程(排序)Data/sort case→选择变量→选择升序和降序(2)transpose(变量和记录的置换,即变量变成记录,记录变成变量)(3)restructure过程(重复测量模型中应用)Data/restructure→选择变换模型→选择ID变量(区分个体的变量)和index变量(区分次数变量)→ok(4)merge files过程(批量加载数据)纵向合并:添加新的自变量data→merge files→add cases (*表示当前数据集变量,+表示需加的数据集变量)横向合并:添加变量行data→merge files→add variables(5)aggregate过程(数据分类汇总)(6)split file(分组处理)技术技巧(1)二项分布累计概率Data/transform/compute→填入新变量名→functions中选择cdf.binom(q,n,p)(p是实际发生数,n总样本数,p总体发生数)SPSS结果窗口用法详解§4.1结果窗口元素介绍SPSS实际上提供了两个结果窗口--结果浏览窗口和结果草稿浏览窗口。
spss使用教程
spss使用教程SPSS(Statistical Package for the Social Sciences)是一款功能强大的统计分析软件,广泛应用于社会科学领域的数据处理和统计分析。
本篇文章将为您提供一份SPSS的使用教程,帮助您快速上手和掌握该软件的基本操作和常用功能。
一、数据准备在使用SPSS进行统计分析前,首先需要准备好待处理的数据。
SPSS支持的数据格式有多种,包括Excel、CSV、文本等。
确保您的数据文件中每列都有一个明确的变量名,并且每行代表一个完整的数据观测。
二、导入数据1. 打开SPSS软件,选择“文件”->“打开”->“数据”,然后浏览文件目录,选择您想要导入的数据文件,点击“打开”按钮。
2. 在打开数据对话框中,选择正确的数据格式,并指定数据所在的位置,点击“确定”按钮。
3. SPSS将会自动加载您的数据文件,并在主界面显示数据的内容。
三、数据清洗与整理在完成数据导入后,可能需要对数据进行清洗和整理,以保证数据的准确性和一致性。
1. 删除无效数据:使用“筛选”功能,过滤掉数据中的无效观测值或缺失数据。
2. 数据转换:例如将文本数据转换为数值型数据,或者对数值数据进行分组处理。
3. 数据整理:根据需要,可以将数据按照不同的变量进行排序、合并或拆分。
四、数据描述统计1. 统计量计算:选择“分析”->“描述统计”->“统计”,在统计对话框中选择您想要计算的统计量,如均值、标准差等。
2. 频数分布:选择“分析”->“描述统计”->“频数”,在频数对话框中选择需要进行频数统计的变量。
3. 图形展示:选择“图形”->“柱状图”或其他适合的图形类型,可视化显示数据的分布情况。
五、数据分析SPSS提供了多种数据分析功能,包括描述性统计、回归分析、方差分析、聚类分析等。
以下是一些常用的数据分析方法:1. 描述性统计:了解数据的基本分布情况,包括均值、标准差、最大值、最小值等。