
各种酶切位点的保护碱基
各种酶切位点的保护碱基
酶不同,所需要的酶切位点的保护碱基的数量也不同。
一般情况下,在酶切位点以外多出3个碱基即可满足几乎所有限制酶的酶切要求。
在资料上查不到的,我们一般都随便加3个碱基做保护。
寡核苷酸近末端位点的酶切
(Cleavage Close to the End of DNA Fragments
(oligonucleotides)
为了解不同内切酶对识别位点以外最少保护碱基数目的要求,NEB采用了一系列含识别序列的
短双链寡核苷酸作为酶切底物进行实验。
实验结果对于确定双酶切顺序将会有帮助(比如在多接头上切割位点很接近时),或者当切割位点靠近DNA末端时也很有用。
在本表中没有列出的酶,则通
常需在识别位点两端至少加上6个保护碱基,以确保酶切反应的进行。
实验方法:用Y[32P]ATP在T4多聚核苷酸激酶的作用下标记0.1A 260单位的寡核苷酸。
取1 Q
已标记了的寡核苷酸与20单位的内切酶,在20° C条件下分别反应2小时和20小时。
反应缓冲液含70 mM Tris-HCI (pH 7.6), 10 mM MgCI 2 , 5 mM DTT 及适量的NaCl 或KCI (视酶的具体要求而定)。
20%的PAGE (7 M尿素)凝胶电泳分析,经放射自显影确定酶切百分率。
本实验采用自连接的寡核苷酸作为对照。
若底物有较长的回文结构,切割效率则可能因为出现
发夹结构而降低。
2. 双酶切的问题
参看目录,选择共同的buffer。
其实,双酶切选哪种buffer是实验的结果,takara 公司从1979 年开始生产限制酶以来,做了大量的基础实验,也积累了很多经验,目录中所推荐的双酶切buffer
完全是依据具体实验结果得到的。
有共同buffer的,通常按照常规的酶切体系,在37 C进行同步酶切。
但BamH I在37 C下有时
表现出star活性,常用30 C单切。
两个酶切位点相邻或没有共同buffer的,通常单切,即先做一种酶切,乙醇沉淀,再做另一种酶
切。
3. 酶切底物DNA ,切不开
1 )底物DNA 上没有相应的限制酶识别位点,或酶切位点被甲基化。
2 )PCR 引物的酶切位点前没有保护碱基或引物合成有误,致使没有正确的酶切位点存在。
PCR 产物酶切前尽量进行精制以更换buffer 。
由于PCR 产物中带入的其它物质,会影响酶切,据报道,通常PCR 产物的添加量占总反应体积25% 以下没有问题。
3 )酶切条件的确认,包括反应温度和反应体系等。
同样的DNA ,同样量,用不同的限制酶切情况可能不同,由于DNA 的空间结构造成的。
同样的DNA ,不同的反应体系,酶切效果也可能不同,由于一些空间因素或不可测因素造成的。
4 )公司出售的限制酶都是液体状态,都是根据最佳反应体系配制了浓度,不可以再用buffer 稀释,因为酶浓度和活性之间不呈直线对应关系,酶浓度越稀,相对活性越低,并且越不稳定,有时便会出现底物DNA 不能被切断的现象。
不同公司的酶和buffer 不要交叉使用,否则可能会影响酶切效果。
5 )酶的识别位点上的碱基被甲基化。
可以选用不受甲基化影响的同裂酶,或将质粒DNA 转入甲基化酶欠损的宿主菌中,重新制备DNA ,也可以使用PCR 的方法对DNA 进行扩增,再做酶切。
常用的有XbaI 容易受甲基化影响,通常选用GM33 做宿主菌转化。
6 )底物不纯,含有限制酶阻害物质,影响酶切作用,需要重新纯化DNA 。
一般做乙醇沉淀纯化即可。
如果质粒中含盐或酚等,都会影响酶切效果。
4. DNA 经酶切后,电泳无带或出现smear 现象
DNA 或酶切试剂中混有DNase ,在一定的温度或缓冲液的作用下,激发DNase 的作用,将DNA 降解。
可以用DNA 上的其他酶,也可以用此酶切其他DNA 来检查问题所在。
如果质粒酶切出现此情况,首先将质粒做乙醇沉淀再酶切。
5. 甲基化酶
M.Alu I, M.Bam H I, M.RcoR I 不属于CG 甲基化,dam 甲基化,也不属于dcm 甲基化。
甲基化酶作用后,DNA 不能被相应的酶切断。
NEB酶切位点保护碱基

>90
10
>90
0
50
0
50
Sph I
GGCATGCC CATGCATGCATG ACATGCATGCATGT
0
0
0
25
10
50
Stu I
AAGGCCTT GAAGGCCTTC AAAAGGCCTTTT
>90
>90
>90
>90
>90
>90
Xba I Xho I Xma I
CTCTAGAG GCTCTAGAGC TGCTCTAGAGCA CTAGTCTAGACTAG
GGCGCGCC AGGCGCGCCT TTGGCGCGCCAA
CCCCGGGG CCCCCGGGGG TCCCCCGGGGGA
CGGATCCG CGGGATCCCG CGCGGATCCGCG
CAGATCTG GAAGATCTTC GGAAGATCTTCC
GGCGCGCC AGGCGCGCCT TTGGCGCGCCAA
0
0
0
0
0
0
0
0
75
>90
75
>90
Nhe I
GGCTAGCC CGGCTAGCCG CTAGCTAGCTAG
0
0
10
25
10
50
Not I
TTGCGGCCGCAA
0
0
ATTTGCGGCCGCTTTA
10
10
AAATATGCGGCCGCTATAAA
10
10
ATAAGAATGCGGCCGCTAAACTAT
25
90
保护碱基表全集文档
保护碱基表全集文档(可以直接使用,可编辑实用优质文档,欢迎下载)
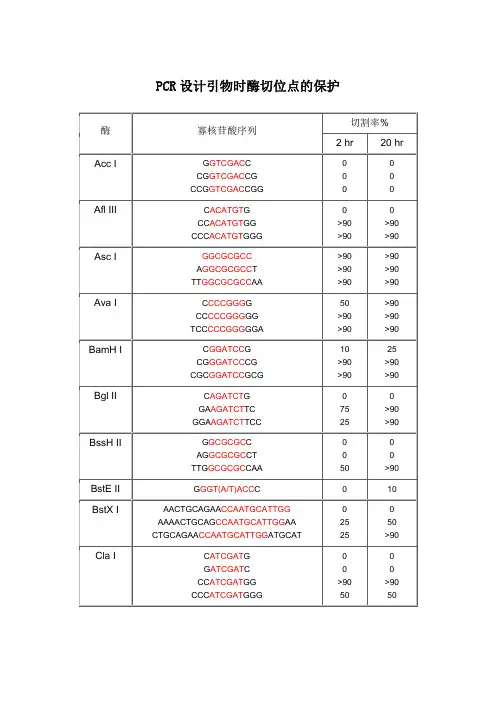
不同内切酶对识别位点以外最少保护碱基数目的要求PCR设计引物时酶切位点的保护碱基表1
PCR设计引物时酶切位点的保护碱基表2
在分子克隆实验中,有时我们会在待扩增的目的基因片段两端加上特定的酶切位点,用于后续的酶切和连接反应。
由于直接暴露在末端的酶切位点不容易直接被限制性核酸内切酶切开,因此在设计PCR引物时,人为的在酶切位点序列的5‘端外侧添加额外的碱基序列,即保护碱基,用来提高将来酶切时的活性。
添加保护碱基,需要考虑两个因素:一是碱基数目,一是碱基种类。
添加保护碱基时,最关心的应该是保护碱基的数目,而不是种类。
什么样的酶切位点,添加几个保护碱基,是有数据可以参考的,见附表。
添加什么保护碱基,如果严格点,是根据两条引物的Tm值和各引物的碱基分布及GC含量。
如果某条引物Tm值偏小,GC%较低,添加时多加G或C,反之亦反。
保护碱基列表
PCR设计引物时酶切位点的保护
注释:
1.如果要加在序列的5‘端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
2.切割率:正确识别并酶切的效率
3。
加保护碱基时最好选用切割率高时加的相应碱基。
PCR设计引物时酶切位点的保护碱基

PCR设计引物时酶切位点的保护
注释:
1.如果要加在序列的5‘端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
2.切割率:正确识别并酶切的效率
3.加保护碱基时最好选用切割率高时加的相应碱基。
一般情况下,普通的内切酶只加入两个保护碱基,其内切反应就可以正常进行;而有一类,仅仅只加入两个保护碱基,其内切反应就不能正常进行,这是因为内切酶不能正常结合DNA段上。
如NdeI就属这类,需要加入至少6个保护碱基,常用的HindIII也要三个。
添加什么保护碱基,如果严格点,是根据两条引物的Tm值和各引物的碱基分布及GC含量。
如果某条引物Tm值偏小,GC%较低,添加时多加G或C,反之亦反。
当在引物5’端添加酶切位点时要考虑:
a)该目的序列内部不得含有相同的酶切位点,这样的错误会给将来的克隆造成麻烦。
b)如果打算PCR 后直接酶切,不要忘了在酶切位点的外侧再加上保护碱基,不同的酶对于保护碱基的要求是不同的。
如果不设计保护碱基,则多半要用TA 克隆的方式连接到质粒上,这时要注意Taq 酶的选择,若想在目的序列上附加上并不存在的序列,如限制位点和启动子序列,可以加入到引物5'端而不影响特异性。
当计算引物Tm 值时并不包括这些序列,但是应该对其进行互补性和内部二级结构的检测。
保护碱基列表
0
0
75
>90
25
>90
0
0
0
0
50
>90
0
10
0
0
25
50
25
>90
0
0
0
0
>90
>90
50
50
>90
>90
>90
>90
>90
>90
>90
>90
>90
>90
>90
>90
2 精心整理,用心做精品
用心整理的精品 word 文档,下载即可编辑!!
Hind III
CAAGCTTG CCAAGCTTGG CCCAAGCTTGGG
GGAATTCC CGGAATTCCG CCGGAATTCCGG
GGGGCCCC AGCGGCCGCT TTGCGGCCGCAA
切割率%
2 hr
0 0 0
20 hr
0 0 0
0
0
>90
>90
>90
>90
>90
>90
>90
>90
>90
>90
50
>90
>90
>90
>90
>90
10
25
>90
>90
>90
>90
CACATGTG CCACATGTGG CCCACATGTGGG
GGCGCGCC AGGCGCGCCT TTGGCGCGCCAA
酶切位点保护性碱基
PCR设计引物时酶切位点的保护切割率%酶 寡核苷酸序列2 hr20 hrAcc I G GTCGAC CCG GTCGAC CGCCG GTCGAC CGG 0Afl III C ACATGT GCC ACATGT GGCCC ACATGT GGG>90>90>90>90Asc I GGCGCGCCA GGCGCGCC TTT GGCGCGCC AA >90>90>90>90>90>90Ava I C CCCGGG GCC CCCGGG GGTCC CCCGGG GGA50>90>90>90>90>90BamH I C GGATCC GCG GGATCC CGCGC GGATCC GCG10>90>9025>90>90Bgl II C AGATCT GGA AGATCT TCGGA AGATCT TCC7525>90>90BssH II G GCGCGC CAG GCGCGC CTTTG GCGCGC CAA50>90BstE II G GGT(A/T)ACC C010BstX I AACTGCAGAA CCAATGCATTGGAAAACTGCAG CCAATGCATTGG AACTGCAGAA CCAATGCATTGG ATGCAT252550>90Cla I C ATCGAT GG ATCGAT CCC ATCGAT GGCCC ATCGAT GGG>9050>9050EcoR I G GAATTC CCG GAATTC CGCCG GAATTC CGG >90>90>90>90>90>90Hae III GG GGCC CCAGC GGCC GCTTTGC GGCC GCAA >90>90>90>90>90>90Hind III C AAGCTT GCC AAGCTT GGCCC AAGCTT GGG1075Kpn I G GGTACC CGG GGTACC CCCGG GGTACC CCG>90>90>90>90Mlu I G ACGCGT CCG ACGCGT CG2550Nco I C CCATGG GCATG CCATGG CATG5075Nde I C CATATG GCC CATATG GGCGC CATATG GCGGGGTTT CATATG AAACCCGGAATTC CATATG GAATTCCGGGAATTC CATATG GAATTCCC7575>90>90Nhe I G GCTAGC CCG GCTAGC CGCTA GCTAGC TAG10102550Not I TT GCGGCCGC AAATTT GCGGCCGC TTTAAAATAT GCGGCCGC TATAAAATAAGAAT GCGGCCGC TAAACTATAAGGAAAAAA GCGGCCGC AAAAGGAAAA10102525101090>90Nsi I TGC ATGCAT GCACCA ATGCAT TGGTTCTGCAGTT10>90>90>90Pac I TTAATTAAG TTAATTAA CCC TTAATTAA GG 025>90Pme I GTTTAAACG GTTTAAAC CGG GTTTAAAC CCAGCTTT GTTTAAAC GGCGCGCCGG752550>90Pst I G CTGCAG CTGCA CTGCAG TGCAAA CTGCAG AACCAATGCATTGGAAAA CTGCAG CCAATGCATTGGAACTGCAG AACCAATGCATTGGATGCAT10>90>9010>90>90Pvu I C CGATCG GAT CGATCG ATTCG CGATCG CGA102510Sac I C GAGCTC G1010Sac II G CCGCGG CTCC CCGCGG GGA50>90Sal I GTCGAC GTCAAAAGGCCATAGCGGCCGC GC GTCGAC GTCTTGGCCATAGCGGCCGCGGACGC GTCGAC GTCGGCCATAGCGGCCGCGGAA10105075Sca I G AGTACT CAAA AGTACT TTT 10752575Sma I CCCGGGC CCCGGG GCC CCCGGG GGTCC CCCGGG GGA10>90101050>90Spe I G ACTAGT CGG ACTAGT CCCGG ACTAGT CCGCTAG ACTAGT CTAG 1010>90>905050Sph I G GCATGC CCAT GCATGC ATGACAT GCATGC ATGT102550Stu I A AGGCCT TGA AGGCCT TCAAA AGGCCT TTT >90>90>90>90>90>90Xba I C TCTAGA GGC TCTAGA GCTGC TCTAGA GCACTAG TCTAGA CTAG>907575>90>90>90Xho I C CTCGAG GCC CTCGAG GGCCG CTCGAG CGG10102575Xma I C CCCGGG GCC CCCGGG GGCCC CCCGGG GGGTCCC CCCGGG GGGA2550>9075>90>90注释:1.如果要加在序列的5’端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
酶切位点保护碱基(可编辑修改word版)

Cleavage Close to the End of DNA Fragments (oligonucleotides)To test the varying requirements restriction endonucleases have for the number of bases flanking their recognition sequences, a series of short, double-stranded oligonucleotides that contain the restriction endonuclease recognition sites (shown in red) were digested. This information may be helpful when choosing the order of addition of two restriction endonucleases for a double digest (a particular concern when cleaving sites close together in a polylinker), or when selecting enzymes most likely to cleave at the end of a DNA fragment.The experiment was performed as follows: 0.1 A260 unit of oligonucleotide was phosphorylated using T4 polynucleotide kinase and -[32P] ATP. 1 µg of 5´[32P]-labeled oligonucleotide was incubated at 20°C with 20 units of restriction endonuclease in a buffer containing 70 mM Tris-HCl (pH 7.6), 10 mM MgCl2, 5 mM DTT and NaCl or KCl depending on the salt requirement of each particular restriction endonuclease. Aliquots were taken at 2 hours and 20 hours and analyzed by 20% PAGE (7 M urea). Percent cleavage was determined by visual estimate of autoradiographs.As a control, self-ligated oligonucleotides were cleaved efficiently. Decreased cleavage efficiency for some of the longer palindromic oligonucleotides may be caused by the formation of hairpin loops.Cleavage Close to the End of DNA Fragments (linearized vector)Linearized vectors were incubated with the indicated enzymes (10 units/µg) for 60 minutes at the recommended incubation temperature and NEBuffer for each enzyme. Following ligation and transformation, cleavage efficiencies were determined by dividing the number of transformants from the digestion reaction by the number obtained from religation of the linearized DNA (typically 100-500 colonies) and subtracting from 100%. "Base Pairs from End" refers to the number of double-stranded base pairs between the recognition site and the terminus of the fragment; this number does not include the single- stranded overhang from the initial cut. Since it has not been demonstrated whether these single-stranded nucleotides contribute to cleavage efficiency, 4 bases should be added to the indicated numbers when designing PCR primers. Average efficiencies were rounded to the nearest whole number; experimental variation was typically within 10%. The numbers in parentheses refer to the number of independent trials for each enzyme tested (from Moreira, R. and Noren, C. (1995), Biotechniques, 19, 56-59).Note: As a general rule, enzymes not listed below require 6 bases pairs on either side of their recognition site to cleave efficiently.| A | B | E | H | K | M | N | P | S | X |。
保护碱基列表(基础教育)
PCR设计引物时酶切位点的保护酶寡核苷酸序列切割率%2 hr20 hrAcc I G GTCGAC CCG GTCGAC CGCCG GTCGAC CGG 0Afl III C ACATGT GCC ACATGT GGCCC ACATGT GGG>90>90>90>90Asc I GGCGCGCCA GGCGCGCC TTT GGCGCGCC AA >90>90>90>90>90>90Ava I C CCCGGG GCC CCCGGG GGTCC CCCGGG GGA50>90>90>90>90>90BamH I C GGATCC GCG GGATCC CGCGC GGATCC GCG10>90>9025>90>90Bgl II C AGATCT GGA AGATCT TCGGA AGATCT TCC7525>90>90BssH II G GCGCGC CAG GCGCGC CTTTG GCGCGC CAA50>90BstE II G GGT(A/T)ACC C010BstX I AACTGCAGAA CCAATGCATTGGAAAACTGCAG CCAATGCATTGG AACTGCAGAA CCAATGCATTGG ATGCAT252550>90Cla I C ATCGAT GG ATCGAT CCC ATCGAT GGCCC ATCGAT GGG>9050>9050EcoR I G GAATTC CCG GAATTC CGCCG GAATTC CGG >90>90>90>90>90>90Hae III GG GGCC CCAGC GGCC GCTTTGC GGCC GCAA >90>90>90>90>90>90Hind III C AAGCTT GCC AAGCTT GGCCC AAGCTT GGG1075Kpn I G GGTACC CGG GGTACC CCCGG GGTACC CCG>90>90>90>90Mlu I G ACGCGT CCG ACGCGT CG2550Nco I C CCATGG GCATG CCATGG CATG5075Nde I C CATATG GCC CATATG GGCGC CATATG GCGGGGTTT CATATG AAACCCGGAATTC CATATG GAATTCCGGGAATTC CATATG GAATTCCC7575>90>90Nhe I G GCTAGC CCG GCTAGC CGCTA GCTAGC TAG10102550Not I TT GCGGCCGC AAATTT GCGGCCGC TTTAAAATAT GCGGCCGC TATAAAATAAGAAT GCGGCCGC TAAACTATAAGGAAAAAA GCGGCCGC AAAAGGAAAA10102525101090>90Nsi I TGC ATGCAT GCACCA ATGCAT TGGTTCTGCAGTT10>90>90>90Pac I TTAATTAAG TTAATTAA CCC TTAATTAA GG 025>90Pme I GTTTAAACG GTTTAAAC CGG GTTTAAAC CCAGCTTT GTTTAAAC GGCGCGCCGG752550>90Pst I G CTGCAG CTGCA CTGCAG TGCAAA CTGCAG AACCAATGCATTGGAAAA CTGCAG CCAATGCATTGGAACTGCAG AACCAATGCATTGGATGCAT10>90>9010>90>90Pvu I C CGATCG GAT CGATCG ATTCG CGATCG CGA102510Sac I C GAGCTC G1010Sac II G CCGCGG CTCC CCGCGG GGA50>90Sal I GTCGAC GTCAAAAGGCCATAGCGGCCGC GC GTCGAC GTCTTGGCCATAGCGGCCGCGGACGC GTCGAC GTCGGCCATAGCGGCCGCGGAA10105075Sca I G AGTACT CAAA AGTACT TTT 10752575Sma I CCCGGGC CCCGGG GCC CCCGGG GGTCC CCCGGG GGA10>90101050>90Spe I G ACTAGT CGG ACTAGT CCCGG ACTAGT CCGCTAG ACTAGT CTAG 1010>90>905050Sph I G GCATGC CCAT GCATGC ATGACAT GCATGC ATGT102550Stu I A AGGCCT TGA AGGCCT TCAAA AGGCCT TTT >90>90>90>90>90>90Xba I C TCTAGA GGC TCTAGA GCTGC TCTAGA GCACTAG TCTAGA CTAG>907575>90>90>90Xho I C CTCGAG GCC CTCGAG GGCCG CTCGAG CGG10102575Xma I C CCCGGG GCC CCCGGG GGCCC CCCGGG GGGTCCC CCCGGG GGGA2550>9075>90>90注释:1.如果要加在序列的5‘端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
限制性内切酶酶切位点保护碱基
寡核苷酸近末端位点的酶切(Cleavage Close to the End of DNA Fragme nts (oligo nu cleotides))为了解不同内切酶对识别位点以外最少保护碱基数目的要求,NEB采用了一系列含识别序列的短双链寡核苷酸作为酶切底物进行实验。
实验结果对于确定双酶切顺序将会有帮助(比如在多接头上切割位点很接近时),或者当切割位点靠近DNA末端时也很有用。
在本表中没有列出的酶,则通常需在识别位点两端至少加上6个保护碱基,以确保酶切反应的进行。
实验方法:用r[32P]ATP在T4多聚核苷酸激酶的作用下标记0.1A260单位的寡核苷酸。
取1卩已标记了的寡核苷酸与20单位的内切酶,在20°C条件下分别反应2小时和20小时。
反应缓冲液含70 mM Tris-HCl (pH , 10 mM MgCI, 5 mM DTT 及适量的NaCI或KCI (视酶的具体要求而定)。
20%的PAGE(7 M尿素)凝胶电泳分析,经放射自显影确定酶切百分率。
本实验采用自连接的寡核苷酸作为对照。
若底物有较长的回文结构,切割效率则可能因为出现发夹结构而降低。
DNA合成,新链的延伸方向是573因此,需要在5端加上酶切位点,因为内切酶除了有特异的识别位点之外,还需多几个无需特异性的碱基提供一个platform让它可以结合上去,否则会掉下来.引物的结构就是(573):保护碱基+酶切位点+原来的引物序列首先要看目的基因中是否含有该酶切位点,只有没有的才可以选(小虾米酶切位点分析)。
其次,如果需要做表达,需要考虑起始密码子,防止移码突变DNA合成,新链的延伸方向是5T3因此,需要在5端加上酶切位点,因为内切酶除了有特异的识别位点之外,还需多几个无需特异性的碱基提供一个platform 让它可以结合上去,否则会掉下来.引物的结构就是(573):保护碱基+酶切位点+原来的引物序列•。
NEB酶切位点保护碱基
PCR设计引物时酶切位点的保护切割率%酶 寡核苷酸序列2 hr20 hrAcc I G GTCGAC CCG GTCGAC CGCCG GTCGAC CGG 0Afl III C ACATGT GCC ACATGT GGCCC ACATGT GGG>90>90>90>90Asc I GGCGCGCCA GGCGCGCC TTT GGCGCGCC AA >90>90>90>90>90>90Ava I C CCCGGG GCC CCCGGG GGTCC CCCGGG GGA50>90>90>90>90>90BamH I C GGATCC GCG GGATCC CGCGC GGATCC GCG10>90>9025>90>90Bgl II C AGATCT GGA AGATCT TCGGA AGATCT TCC7525>90>90BssH II G GCGCGC CAG GCGCGC CTTTG GCGCGC CAA50>90BstE II G GGT(A/T)ACC C010BstX I AACTGCAGAA CCAATGCATTGGAAAACTGCAG CCAATGCATTGG AACTGCAGAA CCAATGCATTGG ATGCAT252550>90Cla I C ATCGAT GG ATCGAT CCC ATCGAT GGCCC ATCGAT GGG>9050>9050EcoR ICG GAATTC CG CCG GAATTC CGG >90>90>90>90Hae III GG GGCC CCAGC GGCC GCTTTGC GGCC GCAA >90>90>90>90>90>90Hind III C AAGCTT GCC AAGCTT GGCCC AAGCTT GGG1075Kpn I G GGTACC CGG GGTACC CCCGG GGTACC CCG>90>90>90>90Mlu I G ACGCGT CCG ACGCGT CG2550Nco I C CCATGG GCATG CCATGG CATG5075Nde I C CATATG GCC CATATG GGCGC CATATG GCGGGGTTT CATATG AAACCCGGAATTC CATATG GAATTCCGGGAATTC CATATG GAATTCCC7575>90>90Nhe I G GCTAGC CCG GCTAGC CGCTA GCTAGC TAG10102550Not I TT GCGGCCGC AAATTT GCGGCCGC TTTAAAATAT GCGGCCGC TATAAAATAAGAAT GCGGCCGC TAAACTATAAGGAAAAAA GCGGCCGC AAAAGGAAAA10102525101090>90Nsi I TGC ATGCAT GCACCA ATGCAT TGGTTCTGCAGTT10>90>90>90Pac I TTAATTAAG TTAATTAA CCC TTAATTAA GG 025>90Pme IG GTTTAAAC CGG GTTTAAAC CC AGCTTT GTTTAAAC GGCGCGCCGG752550>90Pst I G CTGCAG CTGCA CTGCAG TGCAAA CTGCAG AACCAATGCATTGGAAAA CTGCAG CCAATGCATTGGAACTGCAG AACCAATGCATTGGATGCAT10>90>9010>90>90Pvu I C CGATCG GAT CGATCG ATTCG CGATCG CGA102510Sac I C GAGCTC G1010Sac II G CCGCGG CTCC CCGCGG GGA50>90Sal I GTCGAC GTCAAAAGGCCATAGCGGCCGC GC GTCGAC GTCTTGGCCATAGCGGCCGCGGACGC GTCGAC GTCGGCCATAGCGGCCGCGGAA10105075Sca I G AGTACT CAAA AGTACT TTT 10752575Sma I CCCGGGC CCCGGG GCC CCCGGG GGTCC CCCGGG GGA10>90101050>90Spe I G ACTAGT CGG ACTAGT CCCGG ACTAGT CCGCTAG ACTAGT CTAG 1010>90>905050Sph I G GCATGC CCAT GCATGC ATGACAT GCATGC ATGT102550Stu I A AGGCCT TGA AGGCCT TCAAA AGGCCT TTT >90>90>90>90>90>90Xba IGC TCTAGA GC TGC TCTAGA GCA CTAG TCTAGA CTAG >907575>90>90>90Xho I C CTCGAG GCC CTCGAG GGCCG CTCGAG CGG10102575Xma I C CCCGGG GCC CCCGGG GGCCC CCCGGG GGGTCCC CCCGGG GGGA2550>9075>90>90注释:1.如果要加在序列的5‘端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
(完整)保护碱基列表
(完整)保护碱基列表
编辑整理:
尊敬的读者朋友们:
这里是精品文档编辑中心,本文档内容是由我和我的同事精心编辑整理后发布的,发布之前我们对文中内容进行仔细校对,但是难免会有疏漏的地方,但是任然希望((完整)保护碱基列表)的内容能够给您的工作和学习带来便利。
同时也真诚的希望收到您的建议和反馈,这将是我们进步的源泉,前进的动力。
本文可编辑可修改,如果觉得对您有帮助请收藏以便随时查阅,最后祝您生活愉快业绩进步,以下为(完整)保护碱基列表的全部内容。
PCR设计引物时酶切位点的保护
注释:
1.如果要加在序列的5‘端,就在酶切位点识别碱基序列(红色)的5’端加上相应的碱基(黑色),相同如果要在3‘端加保护碱基,就在酶切位点识别碱基序列(红色)的3’端加上相应的碱基(黑色)。
2.切割率:正确识别并酶切的效率
3.加保护碱基时最好选用切割率高时加的相应碱基。