
eviews图像及结果分析
计量经济学软件包Eviews使用说明 页脚内容42 第4章 图形和统计量分析
EViews软件提供了序列(Series)和序列组(Group)等对象的各种视图、统计分析方法和过程。当序列对象中输入数据后,就可对序列对象中输入的数据进行统计分析,并且可以通过图、表等形式进行描述。本章将介绍序列和序列组对象图形的生成和描述性统计量及其检验。
4.1 图 形 对 象 图形(Graph)对象可以形成序列和序列组等对象的各种视图,如线图(Line)、散点图(Scatter)以及饼图(Pie)等。通过图形可以进一步观察和分析数据的变化趋势和规律。下面介绍图形对象的基本操作。
4.1.1 图形(Graph)对象的生成 图形对象也是工作文件中的基本对象之一。要生成图形对象需首先打开序列对象窗口或序列组对象窗口,选择对象窗口工具栏中的“View”|“Graph”选项。选择的对象类型不同,将弹出不同的窗口。如果在序列对象窗口下选择“View”|“Graph”选项,将弹出如图4-1所示的界面。 计量经济学软件包Eviews使用说明
页脚内容43 图4-1 序列窗口下图形对象的生成 此时“Graph”弹出的菜单中有6种图形可供选择。“Line”表示生成的是折线图,如图4-2所示,其横轴表示时间或序列的顺序,纵轴表示序列对象观测值的大小。“Area”表示生成面积图,其图形的形状与“Line”(折线图)相同,不同的是“Area”(面积图)曲线下方是被填满的,而“Line”(折线图)下方是空白。
图4-2 “Line”折线图 “Bar”表示为条形图,用条状的高度表示观测值的大小。“Spike”表示尖峰图,由竖线组成,每根竖线的高度代表观测值的大小。“Seasonal Stacked Line”表示生成的是季节性堆叠图,“Seasonal Split Line”计量经济学软件包Eviews使用说明 页脚内容44 表示生成的是季节性分割线。 如果在序列组(群)对象窗口下选择“View”|“Graph”选项,将弹出如图4-3所示的界面。这里有9种图形可供选择。其前4种与上面讲述的相同。
图4-3 序列组(群)窗口下图对象的生成 其中,“Scatter” 表示生成散点图。在“Scatter”弹出的菜单中有5个选项,分别是“Simple Scatter”(简单散点图)、“Scatter with Regression”(带有回归线的散点图)、“Scatter with Nearest Neighbor Fit”(近邻匹配散点图)、“Scatter with Kernel Fit”(核心匹配散点图)、“XY Pairs”(XY成对散点图)。当序列组中包含两个序列对象时,第一个序列对象的观测值构成散点图的横坐标,第二个序列对象的观测值构成散点图的纵坐标,如图4-4所示。当序列组中有三个以上的序列对象时,第一个序列对象构成散点图的横坐标,其余序列对象构成散点图的纵坐标。 计量经济学软件包Eviews使用说明
页脚内容45 图4-4 简单散点图(“Simple Scatter”) “XY line”表示X与Y的折线图,横纵坐标分别表示两个序列对象的观测值。“Error Bar”表示误差长条图,“High-Low”表示高低图,“Pie”表示饼图。
另外,在序列组(群)对象窗口下还可通过选择“View”|“Multiple Graphs”选项来生成图形。此时图形显示在不同的坐标系中,即每个序列对象各形成一个图形,并显示在同一个窗口中。
除上面介绍的在序列对象窗口中生成图对象外,还可以通过选择EViews主菜单中的“Quick”|“Graph”选项来生成。在“Graph”的菜单中选择图的类型,将弹出图4-5所示的文本框。在文本框内输入序列或序列组的名称,例如“fdi”,然后单击“OK”按钮,即可打开相应的图。此时所生成的图对象未被命名,单击图对象窗口中的“Name”按钮即可命名。
图4-5 生成图对象的文本框 计量经济学软件包Eviews使用说明
页脚内容46 4.1.2 图形的冻结 在上面所介绍的两种图对象生成方法中,通过“Quick”|“Graph”选项生成图形对象,单击图对象窗口工具栏中的“Name”选项,在弹出的对话框中输入该对象的名称,单击“OK”按钮后该对象即可被保存,并在工作文件窗口中显示图对象的图标。但直接在序列对象窗口中形成的图形未被保存,当序列对象中的观测值发生改变时,或当前工作文件的样本范围发生变化时,图形也将随之改变。
如果要保留所建立的图形,使之不随样本及观测值的改变而发生变化,则可以通过序列对象窗口中的“Freeze”键来冻结图形。EViews软件将被冻结的图形以一个图(Graph)对象的形式保存在工作文件中。当选择序列对象窗口中的“Freeze”键时,会弹出图对象窗口。其中有几个键值得关注,一个是“AddText”功能键,通过它可以将文字显示在图形中,并且可以选择显示的位置。一个是“Line/Shade”功能键,通过它可以改变图形的背景颜色,横纵坐标轴的线条类型和颜色等。还有一个是“Remove”功能键,可以用来删除图形中的一些附加要素。例如,将在图形中所建立的文字删除,应首先用鼠标单击所需删除的内容,使其被选中,然后单击“Remove”键,则文字即被删除。用同样的方法也可以删除为图形所设置的颜色等。
4.1.3 图形的复制 如果需要将图形保存到其他文件中,例如放在Word文档中,则选择图对象窗口中的“Proc”|“Copy”选项,然后在弹出的对话框中单击“OK”按钮。或者将鼠标移动到图形上,右击,在弹出的快捷菜单中选择“Copy”命令。再打开需要粘贴的文件,进行粘贴即可。 计量经济学软件包Eviews使用说明
页脚内容47 4.2 描述性统计量
EViews软件中包含一些基本的描述性统计量,有直方图、均值、方差、协方差、自相关等。本节主要介绍序列和序列组对象窗口下的描述性统计量及其检验。
4.2.1 描述性统计量概述 序列窗口下的描述性统计量和序列组窗口下的描述性统计量有所不同。在序列窗口下有4种描述性统计量,分别是“Histogram and Stats”(直方图和统计量)、“Stats Table”(统计表)、“Stats by Classification”(分类统计量)和“Boxplots by Classification”(箱线图/箱尾图分类)。序列组窗口下有3种描述性统计量,分别是“Common Sample”(普通样本)、“Individual Samples”(个体样本)和“Boxplots”(箱线图/箱尾图)。下面分别进行详细介绍。
(1) 序列窗口下的描述性统计量 在序列(Series)对象窗口下选择工具栏中的“View”|“Descriptive Statistics”(描述性统计量)选项,将出现4个选项。
第一个选项是“Histogram and Stats”(直方图和统计量),能显示序列对象的直方图和描述性统计量的值。下面以建立好的序列对象“fdi”为例来进行说明。
如图4-6所示,图的左侧显示的是该序列对象的直方图,为观测值的频率分布。右侧分三个部分,最上面显示的是序列对象的名称、样本的范围和样本数量。中间部分显示的是各统计量的值。其中,“Mean”表示均值,即序列对象观测值的平均值;“Median”表示中位数,即从小到大排列的序列对象观测值的中间值,是对序列分布中心的一个大致估计;“Maximum”和“Minimum”表示的是该序列观测值中的最计量经济学软件包Eviews使用说明 页脚内容48 大值和最小值;“Std.Dev”表示标准差,用来衡量序列观测值的离散程度。其计算公式为
NixxNi1)(
1
12 (4-1)
式中,σ为标准差,N为样本观测值个数,xi是样本观测值,x为样本均值。
图4-6 序列对象“fdi”的直方图分布形状和相关统计量的描述 “Skewness”表示偏度,用来衡量观测值分布偏离均值的状况。其计算公式为 31ˆ1Nixx
NSi
(4-2)
式中,ˆ是变量方差的有偏估计。当S=0时,序列的分布是对称的,如正态分布;当S >0时,序列分布为右偏;当S <0时,序列分布为左偏。例如图4-6中的偏度为1.422 500>0,所以我国的外商直接投资(fdi)的分布是不对称的,为右偏分布形态。
“Kurtosis”表示峰度,用来衡量序列分布的凸起状况。其计算公式为 计量经济学软件包Eviews使用说明 页脚内容49 41ˆ1Nixx
NKi
(4-3)
正态分布的K值为3,当K >3时,序列对象的分布凸起程度大于正态分布的凸起程度;当K <3时,序列对象的分布凸起程度要比正态分布小。例如,图4-6中的峰度为4.898 917 >3,外商直接投资(fdi)的分布呈尖峰状态。
最下方是JB(Jarque-Bera)统计量及其相应的概率(Probability)。JB统计量用来检验序列观测值是否服从正态分布,该检验的零假设为样本服从正态分布。在零假设下,JB统计量服从χ2(2)分布。根据第1章所介绍
的假设检验,P(Probability)值为拒绝原假设所犯第Ⅰ类错误的概率。在本例中P值接近于0,因而可在1%的显著性水平下拒绝零假设,即序列不服从正态分布。
第二个选项是“Stats Table”(统计表),它将描述性统计量值通过电子表格的形式显示在对象窗口中。 第三个选项是“Stats by Classification”(分类统计量),它将样本分为若干组后再对各组观测值分别进行描述统计。选择此项后将弹出如图4-7所示的对话框,其中包括三部分内容。在左边“Statistics”选项中勾选需要显示的统计量,其中“# of NAs”为无观测个数,“Observations”为观测值个数。在“Series/Group for classify”中输入需分类的序列或序列组对象名称,右侧“Output Layout”为输出结果的显示形式。选择好后单击“OK”按钮即可。
经济数据分析软件Eviews PPT

4. 多变量的协整检验:Johansen Cointegration test
5. 关于误差修正模型(ECM)
yt xt t 1
6. 经典回归模型的缺陷 (三)随机时间序列分析的AR(p), MA(q), ARMA(p,q)模型 练习:教材 P232(例8)、P240(例10) 、P281(例20)
要求结合实际问题确定研究对象建立计量经济学模型简单回归时间序列var写出完整的研究报告定性和定量分析相结合图表文字等独立完成报告不少于4000字最终模型对于非稳定变量构建协整回归模型和ecm模型
二、Eviews应用举例(回归模型的OLS估计)
1. 一元线性回归模型估计
2. 多元线性回归模型估计(多重共线性检验)
关键:以信息准则确定滞后值
七、向量自回归(VAR)模型估计
4. 脉冲响应函数和方差分解
VAR方程/impulse response 5. 有协整关系:VEC模型构建
workfile/objects/new objects/VAR quick/estimate/VAR 6. 预测 VAR(VEC)方程/procs/make model/solve 7. 小结 练习:教材 P243(例11)
3. 关于报告的编写
— 研究问题的说明
— 模型中变量选择和模型关系式设定 — 样本数据收集和说明
— 时间序列数据平稳性检验
— 参数估计和检验 — 最终模型(对于非稳定变量,构建协整回归模型和 ECM模型;如果构建的是VAR/VEC模型,应有Johansen 协整检验结果) — 预测和经济意义分析 — 结论、建议或评价
3. 多变量的协整检验:扩展的EG检验法 — 检验目的:同2。 — 在检验是否存在稳定的线性组合时,需通过设置一个 变量为被解释变量,其他变量为解释变量,进行OLS估 计。同时,检验残差序列是否平稳。 — 如果不平稳,则需更换被解释变量,进行同样的OLS 估计及相应的残差项检验。 — 当所有的变量都被作为被解释变量检验之后,仍不能 得到平稳的残差项序列,则认为这些变量间不存在协整。
Eviews 实验操作手册(部分)
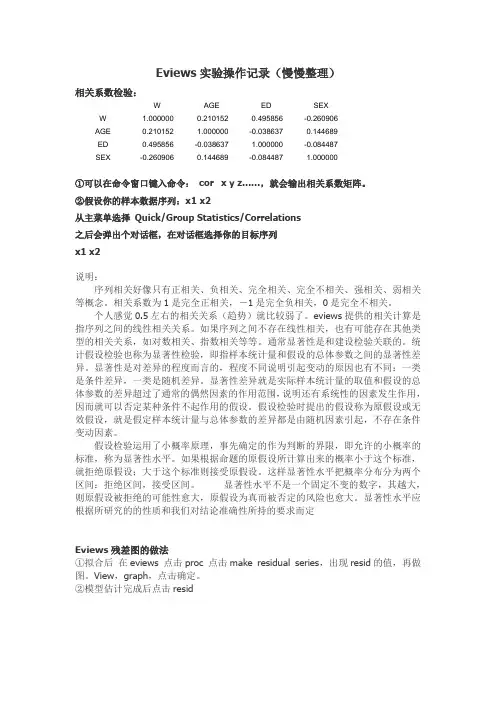
Eviews实验操作记录(慢慢整理)相关系数检验:W AGE ED SEXW 1.000000 0.210152 0.495856 -0.260906AGE 0.210152 1.000000 -0.038637 0.144689ED 0.495856 -0.038637 1.000000 -0.084487SEX -0.260906 0.144689 -0.084487 1.000000①可以在命令窗口键入命令:cor x y z……,就会输出相关系数矩阵。
②假设你的样本数据序列:x1 x2从主菜单选择Quick/Group Statistics/Correlations之后会弹出个对话框,在对话框选择你的目标序列x1 x2说明:序列相关好像只有正相关、负相关、完全相关、完全不相关、强相关、弱相关等概念。
相关系数为1是完全正相关,-1是完全负相关,0是完全不相关。
个人感觉0.5左右的相关关系(趋势)就比较弱了。
eviews提供的相关计算是指序列之间的线性相关关系。
如果序列之间不存在线性相关,也有可能存在其他类型的相关关系,如对数相关、指数相关等等。
通常显著性是和建设检验关联的。
统计假设检验也称为显著性检验,即指样本统计量和假设的总体参数之间的显著性差异。
显著性是对差异的程度而言的,程度不同说明引起变动的原因也有不同:一类是条件差异,一类是随机差异。
显著性差异就是实际样本统计量的取值和假设的总体参数的差异超过了通常的偶然因素的作用范围,说明还有系统性的因素发生作用,因而就可以否定某种条件不起作用的假设。
假设检验时提出的假设称为原假设或无效假设,就是假定样本统计量与总体参数的差异都是由随机因素引起,不存在条件变动因素。
假设检验运用了小概率原理,事先确定的作为判断的界限,即允许的小概率的标准,称为显著性水平。
如果根据命题的原假设所计算出来的概率小于这个标准,就拒绝原假设;大于这个标准则接受原假设。
这样显著性水平把概率分布分为两个区间:拒绝区间,接受区间。
详细EVIEWS面板数据分析操作37页PPT
25、学习是劳动,是充满思想的劳动。——乌申斯基
谢谢!
详细EVIEWS面板数据分析操作
31、园日涉以成趣,门虽设而常关。 32、鼓腹无所思。朝起暮归眠。 33、倾壶绝余沥,窥灶不见烟。
34、春秋满四泽,夏云多奇峰,秋月 扬明辉 ,冬岭 秀孤松 。 35、丈夫志四海,我愿不知老。
Hale Waihona Puke 21、要知道对好事的称颂过于夸大,也会招来人们的反感轻蔑和嫉妒。——培根 22、业精于勤,荒于嬉;行成于思,毁于随。——韩愈
计量经济学案例分析(Eviews操作)

美股行情对A股的影响性分析——标普500与沪深300相关性分析摘要:本文主要通过分析标准普尔500指数与沪深300指数的相关性,以标普500指数为解释变量,以沪深300指数为被解释变量,利用Eviews软件,使用其中的最小二乘法对其进行线性回归分析,最终得出方程。
并对其进行显著性检验(F,t)、异方差检验、自相关性检验来验证方程的可靠性。
然后解释方程的经济意义,并利用软件对未来指数变动进行预测。
最后在未来几天比较预测结果与实际两个指数的变化情况,验证实际应用情况。
关键词:标普500、沪深300、Eviews、显著性检验、异方差检验、自相关性检验。
一、研究背景1.全球化大环境在经济全球化不断深入发展的今天,全球资本市场,尤其是中美两个超级大国之间的资本流通,早已彼此嵌入,密不可分。
全世界早有不少学者对中美资本流通做了深入研究。
但美国股市发展早于中国十几年,其内部的资金也远远超过中国股市,美国股市的资本流动势必会对中国股市产生一定影响,这种影响不仅体现在情绪面,更反映在指数变动方向上。
2.对外开放资本市场的QFII政策Qualified Foreign Institutional Investor,作为一种过渡性制度安排,QFII制度是在资本项目尚未完全开放的国家和地区,实现有序、稳妥开放证券市场的特殊通道。
外资对中国股市的影响早已不可忽视,而美国市场的变动也一定程度会影响在中国股市外资的操作行为。
所以研究两个指数的变动是很有意义的。
二、数据1.数据选择沪深两个市场各自均有独立的综合指数和成份指数,这些指数不能用来反映沪深两市的整体情况,而沪深300指数则同时考虑了两市的交易情况,是中国A股市场的“晴雨表”。
标准普尔500指数英文简写为S&P 500 Index,是记录美国500家上市公司的一个股票指数。
与道琼斯指数等其他指数相比,标准普尔500指数包含的公司更多,因此风险更为分散,能够反映更广泛的市场变化。
eviews统计分析9-
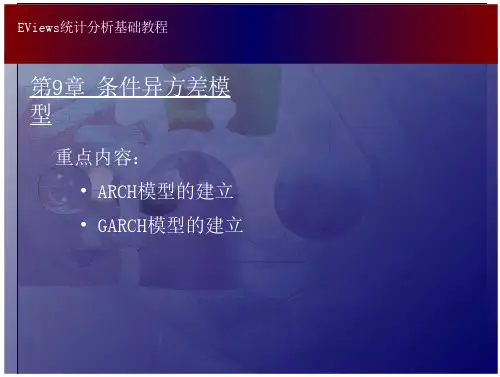
LM = n· R2
2 (q)
其中,n为样本数据的数量,R2为辅助回归的拟合优度值。
当给定显著性水平 和自由度q时,如果LM < 2 (q) 则接受
原假设H0,即残差不存在ARCH效应;如果LM > 2 (q) 则
拒绝原假设H0,即残差存在ARCH效应。
EViews统计分析基础教程
一、自回归条件异方差模型(ARCH)
在“Options”中输入ARCH和GARCH的阶数。
在“Variance”的编辑栏中可列出方差方程中的外生变量。
EViews统计分析基础教程
一、自回归条件异方差模型(ARCH)
3.ARCH模型的建立
Options选项卡
如果选中“Backcasting”(回推) 中的复选框,MA初始扰动项 和GARCH项中的初始预测方 差将使用回推(“Backcasting”) 方法确定初始值。
在EViews软件中,打开条件异方差的方程设定对话框,在 “Model”的下拉菜单中选择“EGARCH”项,同时 “Threshold”选项变为“Asymmetric”,在该编辑框中输入 1,表示EGARCH模型中含有一个非对称项。其他内容的设 定与GARCH(1,1)模型相同。然后单击“确定”按钮即 可得到EGARCH模型的估计结果。
EViews统计分析基础教程
本章小结:
• 掌握自回归条件异方差模型的原理 • 掌握ARCH、GARCH等模型的建立方法 • 了解ARCH-M、TARCH、EARCH模型
(2)残差平方的相关图(Q)检验法
从残差平方的相关图可以看出残差平方的序列直到指定 阶数的自相关(AC)和偏自相关(PAC)的系数。
通过残差平方的相关图可检验残差序列对象是否存在 ARCH效应。当自相关和偏自相关系数在所有滞后阶数都显 著为0时,残差序列不存在ARCH效应;当自相关和偏自相 关系数在所有滞后阶数都不显著为0时,残差序列存在 ARCH效应。
Eviews检验小结
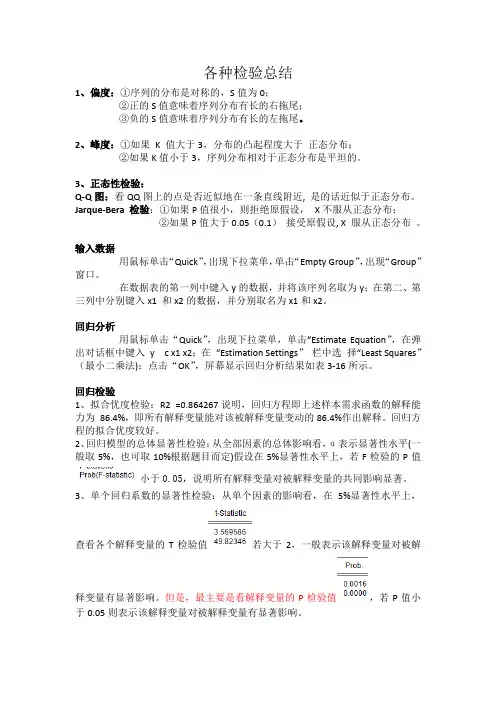
各种检验总结1、偏度:①序列的分布是对称的,S值为0;②正的S值意味着序列分布有长的右拖尾;③负的S值意味着序列分布有长的左拖尾。
2、峰度:①如果K 值大于3,分布的凸起程度大于正态分布;②如果K值小于3,序列分布相对于正态分布是平坦的。
3、正态性检验:Q-Q图:看QQ图上的点是否近似地在一条直线附近, 是的话近似于正态分布。
Jarque-Bera 检验:①如果P值很小,则拒绝原假设,X不服从正态分布;②如果P值大于0.05(0.1)接受原假设, X 服从正态分布。
输入数据用鼠标单击“Quick”,出现下拉菜单,单击“Empty Group”,出现“Group”窗口。
在数据表的第一列中键入y的数据,并将该序列名取为y;在第二、第三列中分别键入x1 和x2的数据,并分别取名为x1和x2。
回归分析用鼠标单击“Quick”,出现下拉菜单,单击“Estimate Equation”,在弹出对话框中键入y c x1 x2;在“Estimation Settings”栏中选择“Least Squares”(最小二乘法);点击“OK”,屏幕显示回归分析结果如表3-16所示。
回归检验1、拟合优度检验:R2 =0.864267说明,回归方程即上述样本需求函数的解释能力为86.4%,即所有解释变量能对该被解释变量变动的86.4%作出解释。
回归方程的拟合优度较好。
2、回归模型的总体显著性检验:从全部因素的总体影响看,α表示显著性水平(一般取5%,也可取10%根据题目而定)假设在5%显著性水平上,若F检验的P值小于0.05,说明所有解释变量对被解释变量的共同影响显著。
3、单个回归系数的显著性检验:从单个因素的影响看,在5%显著性水平上,查看各个解释变量的T检验值若大于2,一般表示该解释变量对被解释变量有显著影响。
但是,最主要是看解释变量的P检验值,若P值小于0.05则表示该解释变量对被解释变量有显著影响。
异方差检验:(1)判断1.图示法——残差的图示检验通过resid 与x的散布图判断,图形成喇叭状。
EVIEWS回归结果的理解
EVIEWS回归结果的理解在数据分析和经济研究中,EViews 是一款被广泛使用的统计软件,而回归分析则是其中非常重要的一个功能。
当我们运行回归分析后,得到的结果往往包含了丰富的信息,然而,要正确理解和解读这些结果却并非易事。
接下来,让我们一起深入探讨 EViews 回归结果的各个方面。
首先,我们来看回归系数。
回归系数是回归方程中自变量的系数,它表示当自变量变化一个单位时,因变量的平均变化量。
例如,如果我们研究收入(因变量)与教育年限(自变量)的关系,回归系数为500 ,这意味着教育年限每增加一年,平均来说收入会增加 500 元。
但需要注意的是,回归系数的大小和符号都有重要意义。
正的系数表示自变量与因变量正相关,负的系数则表示负相关。
同时,我们还要关注回归系数的显著性。
在 EViews 结果中,通常会给出 t 统计量和 p 值来检验回归系数的显著性。
如果 p 值小于我们设定的显著性水平(通常为 005 ),我们就可以认为该回归系数在统计上是显著的,也就是说,我们有足够的证据相信这个自变量对因变量的影响不是偶然的。
但如果 p 值大于显著性水平,那么我们就不能确定这个自变量对因变量有真正的影响。
除了单个回归系数,我们还要考虑整个回归方程的拟合优度。
常见的衡量指标是 Rsquared (决定系数),它的值介于 0 到 1 之间。
Rsquared 越接近 1 ,说明回归方程对数据的拟合程度越好,也就是说自变量能够较好地解释因变量的变化。
但需要注意的是,Rsquared 高并不一定意味着模型就是完美的,有可能存在过拟合的问题。
此外,还有调整后的 Rsquared 。
它考虑了模型中自变量的个数,对于比较包含不同数量自变量的模型具有重要意义。
一般来说,如果我们增加一个自变量,Rsquared 会增加,但调整后的 Rsquared 不一定增加。
只有当新增加的自变量能够显著提高模型的解释能力时,调整后的 Rsquared 才会增加。
Eviews回归分析输出结果指标解释
Eviews回归分析输出结果指标解释Variable 变量Coefficient系数Std. Error系数标准差t-Statistic Prob.双侧概率(P值)C 363.6891 62.45529 5.823191 0.0002七年级英语期末考试质量分析一、试卷分析:本次试卷的难易程度定位在面向大多数学生。
该份试卷紧扣教材,突出重点,注重对基础知识和基本技能的考查。
二、题型分析:1.单项选择单项选择题共15道小题,知识覆盖面较广,重点、难点和疑点比较突出,注重能力考查。
考查以动词为主,兼顾其它词类,并考查句法和语言点。
考查的方式突出了语境。
2.完形填空文章对学生的语言理解能力和综合运用能力提出了较高的要求,重点突出了对单复数和语言点的考查。
3.阅读理解本大题包括五篇文章,安排较合理,难度适中,既有日常生活的题材,又有表格图片解说,符合新课程的要求,体现新课程的理念。
根据《新课程标准》五级有关读的目标描述,问题符合“能找出文章中的主题,理解故事的情节…”等目标描述。
阅读体现新课标所倡导的任务型教学的理念。
通过阅读短文,主要考查学生根据所获取的信息解决实际问题的能力。
阅读的难度不很大,完成任务的环节也比较简洁。
4.书面表达书面表达中仿写与课本内容有着极大的相似之处,是对教材的深加工,做到了学以致用。
创新写作紧扣《课程标准》要求,结合《课程标准》有关写的目标描述,考查了学生综合应用语言的能力。
三、典型错误分析第一大题单项填空中,错误率较高。
主要问题是对单词没理解透,平时讲过的语法没记住,不能灵活应用。
交际运用失分较多,主要是课文掌握不到位。
书面表达中考生的主要错误有:1)在完成句子时不尊重原句的中文意思,改变了句意;2)不会用英语思考,用英语表达的能力较差;3)思路不清晰。
4)语言的基本功不扎实,病句较多;(5)书写习惯不好,卷面不整洁。
书面表达部分中常见错误形式:1.时态错误。
a.时态混淆 b.时态前后不一致 c. 主谓不一致2. 句子结构错误。
计量经济软件eviews使用指导及示例演示(收藏精品)
第一部分 Eviews简介Eviews是Econometrics Views的缩写,直译为计量经济学观察,通常称为计量经济学软件包。
1、Eviews是什么Eviews是美国QMS公司研制的在Windows下专门从事数据分析、回归分析和预测的工具。
使用Eviews可以迅速地从数据中寻找出统计关系,并用得到的关系去预测数据的未来值。
Eviews的应用范围包括:科学实验数据分析与评估、金融分析、宏观经济预测、仿真、销售预测和成本分析等。
Eviews是专门为大型机开发的、用以处理时间序列数据的时间序列软件包的新版本。
Eviews的前身是1981年第1版的Micro TSP。
目前最新的版本是Eviews4.0。
我们以Eviews3.1版本为例,介绍经济计量学软件包使用的基本方法和技巧。
虽然Eviews是经济学家开发的,而且主要用于经济学领域,但是从软件包的设计来看,Eviews的运用领域并不局限于处理经济时间序列。
即使是跨部门的大型项目,也可以采用Eviews进行处理。
Eviews处理的基本数据对象是时间序列,每个序列有一个名称,只要提及序列的名称就可以对序列中所有的观察值进行操作,Eviews允许用户以简便的可视化的方式从键盘或磁盘文件中输入数据,根据已有的序列生成新的序列,在屏幕上显示序列或打印机上打印输出序列,对序列之间存在的关系进行统计分析。
Eviews具有操作简便且可视化的操作风格,体现在从键盘或从键盘输入数据序列、依据已有序列生成新序列、显示和打印序列以及对序列之间存在的关系进行统计分析等方面。
Eviews具有现代Windows软件可视化操作的优良性。
可以使用鼠标对标准的Windows 菜单和对话框进行操作。
操作结果出现在窗口中并能采用标准的Windows技术对操作结果进行处理。
此外,Eviews还拥有强大的命令功能和批处理语言功能。
在Eviews的命令行中输入、编辑和执行命令。
在程序文件中建立和存储命令,以便在后续的研究项目中使用这些程序。
EVIEWS回归结果的理解
EVIEWS回归结果的理解一、回归结果的基本理解回归分析是一种常用的统计方法,用于研究两个或多个变量之间的关系。
在EVIEWS软件中,我们可以通过简单的操作进行回归分析,得到回归结果。
那么,如何理解这些回归结果呢?本文将从以下几个方面进行探讨:1.1 回归系数回归系数是回归模型中的一个关键参数,它表示了自变量与因变量之间的线性关系强度。
在EVIEWS中,我们可以通过查看回归系数表来了解各个自变量对因变量的影响程度。
一般来说,正系数表示正相关关系,即随着自变量的增加,因变量也随之增加;负系数表示负相关关系,即随着自变量的增加,因变量反而减少。
需要注意的是,回归系数并不是绝对值,而是相对于其他自变量的相对大小。
因此,我们需要综合考虑各个自变量的相对重要性,才能更好地理解回归结果。
1.2 置信区间和显著性水平置信区间是指在一定置信水平下,预测变量的真实值可能落在的范围内。
在EVIEWS中,我们可以通过设置置信水平来确定预测变量的范围。
显著性水平是指在假设检验中,拒绝原假设的概率。
在EVIEWS中,我们可以通过设置显著性水平来判断各个自变量是否对因变量有显著影响。
通常情况下,如果显著性水平低于某个设定值(如0.05),则认为该自变量对因变量有显著影响。
二、回归结果的解读2.1 模型拟合优度模型拟合优度是指回归模型对数据的拟合程度。
在EVIEWS中,我们可以通过查看F检验和R-squared值来评估模型拟合优度。
F检验用于检验回归模型的整体拟合效果,R-squared值用于衡量回归模型对数据的解释程度。
一般来说,F检验的p值越小,说明模型拟合效果越好;R-squared值越大,说明模型解释能力越强。
因此,我们需要综合考虑这两个指标来评价模型的质量。
2.2 多重共线性问题多重共线性是指自变量之间存在较高的相关性。
在EVIEWS中,我们可以通过查看方差膨胀因子(VIF)来检测多重共线性问题。
VIF值越大,说明多重共线性问题越严重。