
《计量经济学及Stata应用》
第 8 章 模型设定与数据问题 如果模型设定(model specification)不当,如解释变量选 择不当、测量误差、函数形式不妥等,则会出现“设定 误差”(specification error)。 数据本身也可能存在问题,比如多重共线性。
n→∞
增大。
8.3 建模策略:“由小到大”还是“由大到小”
“由小到大”(specific to general)的建模方式首先从最简 单的小模型开始,逐渐增加解释变量。但小模型很可能 存在遗漏变量,导致估计量不一致,t 检验、F 检验都将 失效,因此很难确定该如何取舍变量。
与此相反,“由大到小”(general to specific)的建模方式
例 在农学中将地块随机地分成三组(因为很难找到土壤 条件完全一样的地块),分别给予不同的施肥量,然后考 察施肥的效果。
在经济学中,“实验经济学”(experimental economics)所 做的实验基本上属于随机实验。
考虑以下回归模型:
8
y =α + β x + ε
其中, x是完全随机地决定的(比如,通过抛硬币或电 脑随机数)。由于 x与ε 相互独立,故Cov(x,ε ) = 0,因此无 论遗漏了多少解释变量,OLS 都是一致的。
{x2
,
,
xK
}
(即使用老鼠做实验,老鼠之间仍然有差异),
故无法进行严格的控制实验。
当代统计学之父费舍尔(Ronald Fischer)提出了随机实验 的概念。通常将实验人群(或个体)随机地分为两组,其
7
中“实验组”或“处理组”(treatment group)服用真药, 而“控制组”(control group,也称“对照组”)服用“安 慰药”(placebo)。
理实验中,对除 x1以外的因素{x2,, xK }全部控制不变,
单独让 x1变化,然后观察 y 变化的情况。
(2) 随机(控制)实验(randomized controlled experiment):
比如,医学上对新药 x1疗效的实验。由于参加实验者的 体质与生活方式不同,不可能完全控制所有其他因素
由于真实参数γ = 0,故可将模型写为 y =α + β x1 + γ x2 + ε 。
由于 x2 与 y 无关,故 x2 也与 y 的扰动项 ε 无关,即
Cov(x2, ε ) = 0 。 故 OLS 一 致 , 即 plimαˆ = α , plim βˆ = β ,
n→∞
n→∞
11
plimγˆ= γ= 0。但引入无关变量后,估计量βˆ 的方差一般会
第(ii)种方法:随机实验或自然实验。
实验方法是研究因果关系的有力工具。假设我们要研究
变 量 x1 是 否 导 致 y , 以 及 此 因 果 关 系 的 强 弱 。 假 定
{x1,
x2
,
,
xK }包含了所有可能影响
y
的因素。不同学科可
能依条件的不同而采用不同的实验方法,大致可以分为
以下几类。
6
(1) 控制实验(controlled experiment):比如,在理想的物
2
考虑以下两种情形:
(1) 遗漏变量 x2与解释变量 x1不相关,即Cov(x1, x2) = 0。 扰动项u 与解释变量 x1不相关,OLS 依然可一致地估计 β 。由于遗漏变量γ x2被归入扰动项u中,可能增大扰动项 的方差,影响 OLS 估计的精确度。
(2) 遗漏变量 x2与解释变量 x1相关,即Cov(x1, x2) ≠ 0。 OLS 不再一致,称其偏差为“遗漏变量偏差”(omitted variable bias)。
3
存在遗漏变量本身并不要紧;问题的关键是,被遗漏的 变量不能与包括在方程内的解释变量相关。 解决遗漏变量偏差的方法主要有: (i) 加入尽可能多的控制变量(control variable); (ii) 随机实验与自然实验; (iii) 工具变量法; (iv) 使用面板数据;
4
第(i)种方法:列出所有可能对被解释变量有影响的变 量,尽可能去收集数据。
如果有些变量无法获得,则需从理论上说明,遗漏变量 不会与解释变量相关,或相关性很弱。
例 李宏彬等(2012)通过就业调查数据,研究“官二代” 大学毕业生的起薪是否高于非官二代。
由于可能存在遗漏变量,该文包括了尽可能多的控制变 量,比如年龄、性别、城镇户口、父母收入、父母学历、
5
高考成绩、大学成绩、文理科、党员、学生会干部、兼 职实习经历、拥有技术等级证书等。
进一步,由于 x与ε 相互独立,故也满足小样本理论中的 严格外生性假定。因此,OLS 也是无偏的。
(3) 自 然 实 验 或 准 实 验 (natural experiment or quasi experiment):由于某些并非为了实验目的而发生的外部
9
突发事件,使得当事人仿佛被随机地分在了实验组或控 制组。比如,一个州通过了一个法律,但相邻的另一个 州没有通过这一法律。两个州的民众事先并不知道哪个 州会通过这个法律,因此无法进行自我选择住在哪个 州。这样,从考察这个法律的效果而言,可以近似地认 为民众是随机地选择住在哪个州的,或者随机地被分在 了哪个组,即实验组(通过法律)与控制组(没通过法律)。 这种情形被称为“自然实验”或“准实验”。
1
8.1 遗 漏 变 量 假设真实的模型为
y =α + β x1 + γ x2 + ε
其中,解释变量 x1, x2与扰动项ε 不相关,并省略了表示个 体的下标 i,比如 y应为 yi 。而实际估计的模型(estimated model)为
y =α + β x1 + u
则 遗 漏 变 量 (omitted variables) γ x2 被 归 入 新 扰 动 项 =u γ x2 + ε 中。
任何实证研究中几乎总是存在遗漏变量。一篇专业水准 的实证论文几乎总需要说明,它如何在存在遗漏变量的 情况下避免遗漏变量偏差。
10
8.2 无 关 变 量 假设真+ ε
其中,Cov(x1,ε ) = 0。而实际估计的模型为
y =α + β x1 + γ x2 + (ε − γ x2 )
《计量经济学基础与Stata应用》Stata常用命令
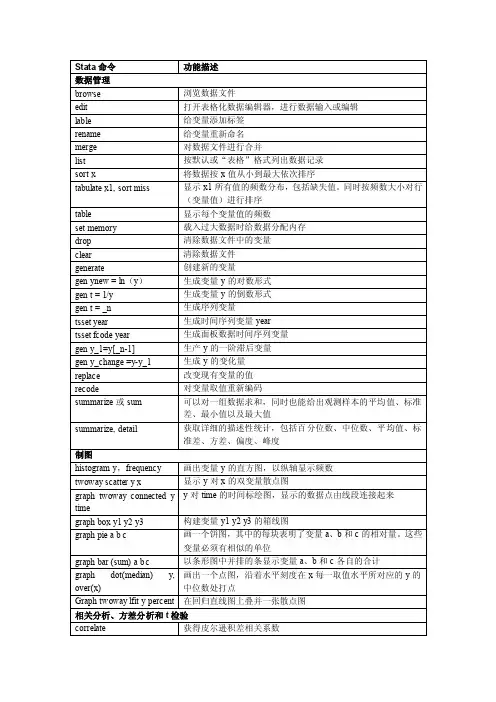
生成变量 y 的倒数形式 生成序列变量 生成时间序列变量 year 生成面板数据时间序列变量 生产 y 的一阶滞后变量 生成 y 的变化量 改变现有变量的值 对变量取值重新编码 可以对一组数据求和,同时也能 给出观测样本的平均 值、标准 差、最小值以及最大值
summarize, detail
获取详细的描述性统计,包括百 分位数、中位数、平 均值、标 准差、方差、偏度、峰度
Stata edit lable rename merge list sort x tabulate x1, sort miss
浏览数据文件 打开表格化数据编辑器,进行数据输入或编辑 给变量添加标签 给变量重新命名 对数据文件进行合并 按默认或“表格”格式列出数据记录 将数据按 x 值从小到最大依次排序 显示 x1 所有值的频数分布,包括缺失值。同时按频数大小对行 (变量值)进行排序
制图
histogram y,frequency twoway scatter y x graph twoway connected y
画出变量 y 的直方图,以纵轴显示频数 显示 y 对 x 的双变量散点图 y 对 time 的时间标绘图,显示的数据点由线段连接起来
time graph box y1 y2 y3 graph pie a b c
构建变量 y1 y2 y3 的箱线图 画一个饼图,其中的每块表明了变量 a、b 和 c 的相对量。这些 变量必须有相似的单位
graph bar (sum) a b c graph dot(median) y, over(x) Graph twoway lfit y percent
以条形图中并排的条显示变量 a、b 和 c 各自的合计 画出一个点图,沿着水平刻度在 x 每一取值水平所对应的 y 的 中位数处打点 在回归直线图上叠并一张散点图
计量经济学及Stata应用
“在Stata中,我们可以使用各种命令和功能来执行计量经济学分析,例如 regress命令、tobit命令、logit命令等等。” ——霍金斯
“在Stata中,我们可以使用各种功能来可视化我们的数据,例如 scatterplot、lineplot、barplot等等。” ——克莱因
“在Stata中,我们可以使用各种命令来处理缺失数据,例如mi impute、mi create、mi estimate等等。” ——福布斯
“计量经济学是一种工具,可以帮助我们理解和解释经济现象。” ——豪斯 曼
“计量经济学是一种研究工具,可以帮助我们理解经济数据的本质和特 征。” ——福布斯
“计量经济学可以帮助我们预测未来经济趋势,以及制定有效的经济政 策。” ——萨金特
“计量经济学是一种工具,可以帮助我们解决实际问题,如经济政策制定、商 业决策、投资决策等。” ——阿克洛夫
计量经济学及Stata应用
读书笔记
01 思维导图
03 精彩摘录 05 目录分析
目录
02 内容摘要 04 阅读感受 06 作者简介
思维导图
本书关键字分析思维导图
stata
读者
stata
应用
分析
模型
计量经济学
回归
这些
知识
包括
通过
计量经济 学
数据
介绍Biblioteka 可以面板应用
变量
内容摘要
内容摘要
《计量经济学及Stata应用》是一本全面介绍计量经济学知识和Stata应用的重要书籍。本书的 内容涵盖了计量经济学的各个方面,包括回归分析、时间序列分析、面板数据分析等,并通过 Stata软件的实例演示,帮助读者更好地理解和应用计量经济学知识。 本书第一章介绍了计量经济学的基础知识,包括变量的类型、数据的收集和处理、概率论和统计 学的基础知识。这些基础知识对于理解和应用计量经济学模型非常重要。 第二章到第五章介绍了回归分析的基本概念和各种模型,包括简单回归分析、多元回归分析、岭 回归分析和Lasso回归分析等。这些回归分析模型在Stata中都有相应的命令可以实现。通过这 些章节的学习,读者可以了解如何使用Stata进行数据的拟合和预测。 第六章和第七章介绍了时间序列分析和面板数据分析的基本概念和模型,包括ARMA模型、VAR模 型、固定效应模型和随机效应模型等。这些模型在Stata中同样有相应的命令可以完成。
-第4章-一元线性回归-计量经济学及Stata应用
© 陈强,2015年,《计量经济学及Stata应用》,高等教育出版社。
第4章一元线性回归4.1 一元线性回归模型为什么在青少年时期要选择上学?除了满足好奇心、求知欲及个人成长外,一个重要原因是教育能提高未来的收入水平。
如何从理论上解释教育投资的回报率(returns to schooling)?12Mincer (1958)提出基于效用最大化的理性选择模型:个体选择多上一年学,则需推迟一年挣钱(另需交学费);为弥补其损失,市场均衡条件要求给予受教育多者更高的未来收入。
由此可得工资对数与教育年限的线性关系:ln w s αβ=+ (4.1)ln w 为工资对数,s 为教育年限(schooling),而α与β为参数。
α为截距项,表示当教育年限为0时的工资对数水平,因为ln 0w αβα=+⋅=。
3β为斜率,表示教育年限对工资对数的边际效应,即每增加一年教育,将使工资增加百分之几,因为对方程(4.1)两边求导可得ln dw wd w w w ds ds sβ∆==≈∆ (4.2)教育年限只是影响工资的因素之一。
严格来说,方程(4.1)应为ln w s αβ=++其他因素 (4.3)将其他因素记为ε,则有ln w s αβε=++(4.4)方程(4.4)即劳动经济学(labor economics)中著名的明瑟方程(the Mincer equation)的基本形式(Mincer, 1974)。
但多上一年学,究竟能使未来收入提高百分之几?这取决于参数β的取值。
明瑟模型并未提供关于α与β具体取值的信息。
对于这种定量问题(quantitative question),只有通过数据才能给出定量回答(quantitative answer)。
需要用计量经济学方法,通过样本数据来估计未知参数α与β。
4明瑟模型推断工资对数与教育年限为线性关系,此预言是否与现实数据相符?使用数据集grilic.dta来考察,此数据集包括758位美国年轻男子的教育投资回报率数据。
计量经济分析及stata应用

计量经济分析及stata应用计量经济学是一门研究经济理论和经济数据之间关系的学科。
它的目的是通过使用统计方法和经济理论来分析经济现象,并得出关于经济模型和政策的结论。
Stata是一个广泛使用的计量经济学软件包,它提供了许多工具和算法,可以帮助研究人员进行经济数据的分析和模型估计。
在计量经济分析中,我们首先需要收集和整理经济数据。
这些数据可以是时间序列数据,如GDP、通货膨胀率等,也可以是截面数据,如个人收入、教育水平等。
一旦数据准备就绪,我们可以开始对其进行描述性统计,以了解数据的基本特征,如平均值、标准差、最大值和最小值等。
接下来,我们可以使用计量经济模型来研究变量之间的关系。
最常见的模型是线性回归模型,它可以分析自变量与因变量之间的线性关系。
例如,我们可能希望了解教育水平对个人收入的影响。
我们可以构建一个回归模型,其中教育水平是自变量,个人收入是因变量。
通过估计回归模型的系数,我们可以得出关于教育水平对个人收入的影响的结论。
为了得出可靠的结论,我们需要进行统计推断。
我们需要检验模型的显著性,以确定自变量是否对因变量有统计上的重要影响。
常用的检验方法包括t检验和F 检验。
另外,我们还可以进行样本外预测,以测试模型的预测能力。
在使用Stata进行计量经济分析时,我们可以使用命令来进行各种操作。
例如,我们可以使用"summarize"命令来计算描述性统计量,使用"regress"命令来估计回归模型的系数,使用"test"命令来进行假设检验,使用"predict"命令来进行样本外预测等等。
此外,Stata还提供了一些图形工具,可以帮助我们更好地理解数据和模型。
总之,计量经济分析及其在Stata中的应用是经济学研究中的重要组成部分。
通过合理地选择经济模型和使用适当的统计方法,我们可以从经济数据中提取有关经济现象和政策的重要信息。
计量经济学及stata应用操作
计量经济学及stata应用操作计量经济学是经济学中的一门重要的子领域,它研究如何运用数理统计方法来解决经济学中的问题,尤其是通过建立经济模型并利用实际数据进行分析和验证。
它的目标是通过利用观测数据来检验经济理论,并得出有关经济现象和政策的科学结论。
在实践中,研究者通常使用专门的计量经济学软件来进行数据处理和分析。
其中,Stata是一种非常常用的软件工具,它提供了丰富的数据处理、模型估计和统计推断等功能,被广泛应用于计量经济学研究中。
在Stata中,常用的数据处理操作包括数据导入、数据清洗和数据转换。
数据导入是将外部数据文件导入Stata中进行后续分析的过程,可以通过多种格式导入,如Excel、CSV、SPSS等。
数据清洗是对导入的数据进行检查、修正和删除异常值等处理,确保数据的质量和可靠性。
数据转换是将原始数据转换成可用于模型估计和分析的格式,如变量类型转换、数据排序和合并等。
在Stata中进行计量经济分析的核心操作是建立经济模型、估计模型参数和进行统计推断。
建立经济模型包括选择适当的经济理论和模型结构,并设定模型中的自变量、因变量和控制变量等。
估计模型参数是利用观测数据来计算模型中的系数估计值,常用的方法包括最小二乘法、极大似然法和仪器变量法等。
统计推断是对模型的估计结果进行显著性检验和置信区间估计,以评估模型的可靠性和经济意义。
除了基本的计量经济学操作外,Stata还提供了丰富的高级功能,如面板数据分析、时间序列分析和计量计算等。
面板数据分析用于处理多个个体在多个时间点上的数据,考虑到个体和时间的固定效应和随机效应。
时间序列分析用于处理时间依赖的数据,如趋势、周期和季节性等。
计量计算是利用估计结果进行经济政策评估和预测分析,如计量影响评估、决策树分析和蒙特卡洛模拟等。
总之,计量经济学及其在Stata中的应用操作是经济学研究中不可或缺的一部分。
它通过建立经济模型、估计参数和进行统计推断来解决实际问题,Stata作为一种常用的计量经济学软件提供了丰富的功能和工具,使得研究者可以方便、快捷地进行数据处理、模型估计和统计推断,从而得出准确和可靠的经济研究结论。
30PPT-第15章-如何做实证研究-计量经济学及Stata应用
© 陈强,2015年,《计量经济学及Stata应用》,高等教育出版社。
第15章如何做实证研究15.1 什么是论文应如何应用计量经济学于实证研究(empirical research)?撰写实证论文有哪些步骤与注意事项?经济学研究大致可分为两类,即理论研究与实证研究。
理论研究通过建立数学模型,来解释现实世界的经济现象。
1理论模型虽可告诉变量之间的可能关系,但无法提供这种关系的作用系数。
这种理论关系是否成立,仍需通过现实数据检验。
实证研究主要通过收集样本数据,使用统计推断的方法,估计并检验变量之间的因果关系,或进行预测。
根据理论研究与实证研究的区别,经济学论文可大体分为理论论文与实证论文两大类。
有些论文既提出新理论,又进行实证检验;但这种论文篇幅较长,比较少见。
理论论文也可援引实证数据或经济现象作为佐证。
2实证论文也可包含简单的理论框架。
理论论文需要理论上的创见,更困难;故本科毕业论文一般都是实证论文。
究竟什么是论文?论文就是对新的..研究成果的汇报。
刚起步研究的学生,面临着从学习知识(学生)到创造知识(研究者)的转型。
3论文与散文不同,后者可表达某种情感,或记录一些事情。
经济学论文须用严谨的数理逻辑或统计推断,一步一步得到结论,每个环节都须丝丝入扣、经得起推敲;不能随便发表议论,或轻率下结论。
论文贵在创新,其价值主要在于原创性(originality)或新颖性(novelty),即对于已有文献的边际贡献(marginal contribution),参见图15.1。
本科论文不要求有太多创新,但至少应有一点点创新;不能是“山寨版”或抄袭。
4实证研究的步骤:准备阶段、选题、探索性研究、收集数据、建立计量模型、选择计量方法、解释回归结果、论文写作、与同行交流、提交论文或投稿。
515.2 准备阶段要开始真正的研究,需要一系列的准备工作。
首先,必须掌握一定的经济理论,以获得观察经济现象的必要视角(perspective)、参照系(reference或benchmark)与分析工具(analytical tools)。
第7章 异方差 计量经济学及Stata应用
© 陈强,2015年,《计量经济学及Stata应用》,高等教育出版社。
第7章 异方差现实的数据千奇百怪,常不符合古典模型的某些假定。
从本章开始,逐步放松古典模型的各项假定。
7.1 异方差的后果“条件异方差”(conditional heteroskedasticity),简称“异方差”(heteroskedasticity),是违背球型扰动项假设的一种情形,即条件εX依赖于i,而不是常数2σ。
方差Var(|)i在异方差的情况下:(1) OLS 估计量依然无偏、一致且渐近正态。
因为在证明这些性质时,并未用到“同方差”的假定。
(2) OLS 估计量方差ˆVar(|)βX 的表达式不再是21()σ-'X X ,因为2Var(|)σ≠εX I 。
使用普通标准误的t 检验、F 检验失效。
(3) 高斯-马尔可夫定理不再成立,OLS 不再是BLUE(最佳线性无偏估计)。
在异方差的情况下,本章介绍的“加权最小二乘法”才是BLUE 。
为直观理解OLS 不是BLUE ,考虑一元回归i i i y x αβε=++。
假设Var(|)i εX 是解释变量i x 的增函数,即i x 越大则Var(|)i εX 越大,参见图7.1。
图7.1 异方差示意图OLS 回归线在i x 较小时可以较精确地估计,而在i x 较大时则难以准确估计。
方差较大的数据包含的信息量较小,但OLS却对所有数据等量齐观进行处理;故异方差的存在使得OLS的效率降低。
“加权最小二乘法”(Weighted Least Square,WLS)通过对不同数据所包含信息量的不同进行相应的处理以提高估计效率。
比如,给予信息量大的数据更大的权重。
计量经济学所指的“异方差”都是“条件异方差”,而非“无条件异方差”。
比如,大样本理论要求样本数据为平稳过程,而平稳过程的方差不变。
大样本理论是否已经假设同方差?关键要区分无条件方差(unconditional variance)与条件方差(conditional variance)。
高级计量经济学及stata应用
高级计量经济学及stata应用介绍本文旨在全面、详细、完整且深入地探讨高级计量经济学及Stata应用的主题,从理论到实践,帮助读者深入了解该领域并有效运用Stata进行数据分析。
以下将从以下几个方面展开讨论:1.数理统计的基本概念和应用领域2.高级计量经济学的发展及重要方法3.Stata在高级计量经济学中的应用方法4.经济数据分析实例数理统计的基本概念和应用领域1.1 概念数理统计是以概率论为基础,应用数学和统计学的方法研究统计规律,并应用这些规律来描述、分析和解释各种统计问题的一门学科。
它通过收集、整理、分析实际数据,得到统计定律,为决策提供科学依据。
1.2 应用领域数理统计在各个学科领域都有广泛的应用,特别是在经济学中。
它可以帮助经济学家分析经济现象,进行经济预测,评估政策效果等。
同时,数理统计也应用于医学研究、社会学调查、心理学实验设计等领域。
高级计量经济学的发展及重要方法2.1 发展历程高级计量经济学是计量经济学的一个分支,强调经济理论与计量方法的结合,通过数学模型和统计分析来研究经济现象。
该领域自20世纪50年代以来迅速发展,经历了计量经济学基本理论的建立、计量经济学模型的发展和计量经济学方法的创新等阶段。
2.2 重要方法在高级计量经济学中,有一些方法被广泛应用,如面板数据模型、时间序列分析、计量经济学中的工具变量等。
这些方法可以帮助研究者解决经济学中的内生性问题、数据相关性问题等。
Stata在高级计量经济学中的应用方法3.1 简介Stata是一种常用的经济数据分析软件,可以对数据进行清洗、处理、分析和可视化等操作。
它强大的计量经济学功能使其成为高级计量经济学研究的重要工具。
3.2 Stata的基本操作在使用Stata进行高级计量经济学研究时,需要掌握一些基本操作。
包括数据导入、数据处理、模型估计等。
此外,Stata还提供了丰富的统计命令和图表功能,可以帮助研究者进行详细的数据分析和结果展示。
PPT-第12章-面板数据-计量经济学及Stata应用
如果仅考虑个体固定效应,称为“单向固定效应”(One-way FE)。
有时为节省参数(比如,时间维度T 较大),可引入时间趋势项, 以替代上述(T 1)个时间虚拟变量:
yit xit zi t ui it (12.12)
xit 可以随个体及时间而变(time-varying)。
扰动项由(ui it ) 两部分构成,称为“复合扰动项”(composite
error term)。
不可观测的随机变量ui 是代表个体异质性的截距项,即“个体效 应”(individual effects)。
9
it 为随个体与时间而改变的扰动项,称为“idiosyncratic error”。 一般假设{it}为独立同分布,且与ui 不相关。
8
这种模型称为“个体效应模型”(individual-specific effects model):
yit xit zi ui it (i 1, ,n; t 1, ,T ) (12.1)
zi为不随时间而变(time invariant)的个体特征( zit zi , t ),比如性 别;
反之,则称为“非平衡面板”(unbalanced panel)。主要关注平衡 面板,但在本章第 11 节讨论非平衡面板。
3
面板数据的主要优点如下。
(1) 有助于解决遗漏变量问题: 遗漏变量常由不可观测的个体差异或“异质性”(heterogeneity) 造成(比如个体能力)。 如果个体差异“不随时间而改变”(time invariant),则面板数据 提供了解决遗漏变量问题的又一利器。
如果T 较大,n较小,则称为“长面板”(long panel)。
计量经济学基础与STATA应用
计量经济学基础与STATA应用基本概念经典假设1、模型为线性;多项式、对数、倒数、对数倒数、含有时间趋势2、X为变量;3、残差序列条件均值为0;4、残差序列条件方差齐性,即同方差;5、残差序列之间无自相关性;6、残差序列与解释变量不相关;7、解释变量之间不存在完全的线性关系;8、残差序列服从正态分布;残差正态性检验1、残差直方图:histogram e, norm freq2、利用偏度系数和峰度系数:sktest3、正态概率图:问题检验与解决多重共线性完全多重共线性:参数无法唯一确定,方差无穷大;不完全多重共线性:方差增大诊断方法:1、模型判定系数R方值高而具有显着的t值得变量少2、解释变量之间有高度的两两相关3、检查偏相关4、辅助回归5、病态指数6、方差膨胀因子VIF补救方法:1、利用先验信息2、横截面数据与时间序列数据并用3、剔除变量有可能出现模型的设定偏误4、变量替换一阶差分:可能使得残差存在一定的相关性、比率:可能使得残差不再同方差5、补充新的数据6、在多项式回归中降低共线性异方差原因:1、按照边错边改边学习模型,人们在学习的过程中,其行为误差随着时间的延长而减少;2、数据采集技术的改进3、异常值出现4、回归模型的设定不正确,如遗漏重要变量5、回归元的分布呈偏态,如收入6、不正确的数据变换或函数变换7、横截面数据中更为常见问题:系数依旧无偏,估计方差增大,t值变小,从而导致本来显着地回归系数变成了统计不显着诊断方法:1、图解法:残差平方对y预测值或某一解释变量2、帕克检验:先用OLS产生残差,再用残差平方对X回归,系数显着就有异方差;3、格莱泽检验:先用OLS产生残差,用残差的绝对值对X的各种变换回归;4、戈德菲尔德-匡特检验:先将X的观测值按升序排列,略去居中的c个观测,将前后分成两组分别回归得到各自的残差平方和,做F检验5、布劳殊-培干-戈弗雷检验BPG检验:先回归得到残差平方和,计算残差平方和的均值,构造pi=ui2/均值,用pi对全部或部分X做回归,得到ESS,做卡方检验:estat hettest6、怀特检验White检验:回归得到残差平方和,用残差平方和对X和X方和X交叉项做回归,得到R方,对nR2做卡方检验:estat imtest,white7、寇因克-巴塞特检验KB检验:残差平方和对预测Y平方做回归解决:当方差已知,WLS当方差未知,误差方差正比于X2,两边除以X误差方差正比于X,两边除以根号X误差方差正比于Y均值的平方,两边除以Y均值进行对数转换;注意:一个好的模型,绝不会因为异方差性的原因而被抛弃;只有在问题严重的时候,误差方差不相等的问题才值得去修正;当模型参数的最大方差OLS估计比最小方差GLS估计的10倍还大时,问题才是严重的;自相关Covui, uj =0来源:1、惯性:如GDP、价格指数2、设定偏误,应含而未含变量,不正确的函数形式3、蛛网现象:如供给价格的反应要滞后一个时期,今年种植的作物受去年流行的价格影响4、滞后效应:5、数据的编造问题:OLS估计量仍是无偏线性的,方差估计错误诊断方法:1、图解法:残差对时间,残差对残差滞后2、游程检验:runtest3、德宾-沃森检验DW检验:0-dl拒绝正自相关,dl-du无决定域,du-2-4-du不拒绝、4-du-4-dl无决定域、4-dl-4拒绝负自相关:dwstat4、布劳殊-戈弗雷检验:BG检验LM检验解决:如果AR1,ρ已知:在t-1期乘以ρ,再用t期减掉ρ未知:需估计,一般ρ=1-d/2或直接做ut对ut-1回归;修正OLS标准误的尼威-韦斯特方法:只对大样本有效,对小样本可能不适合;如果样本足够大,同时存在自相关和异方差的情况,由此方法得到的修正标准误被称为HAChetero- and auto corr-consistentNewey-West standard errors:newey y x , lag1模型设定偏误选取解释变量的偏误:遗漏相关变量如果遗漏变量与进入变量相关,估计量在小样本下有偏,大样本下不一致,方差有偏;如果遗漏变量与进入变量无关,估计量无偏一致,但常数项估计有偏,随机项方差估计有偏导致系数方差估计有偏,多选无关变量参数估计量无偏一致,误差方差估计正确,但参数估计量的方差大于正确情况,从而使对参数进行统计推断的精度下降模型函数形式不正确或不恰当的偏误测量误差的偏误因变量存在测量误差的后果是参数估计量的标准误变大,参数估计及其方差仍无偏;解释变量存在测量误差使得解释变量与误差项相关,OLS估计有偏非一致随机误差项设定形式不正确的偏误有偏;诊断方法:1、检验模型是否有无关变量:对显着性检验,t或F2、对遗漏变量和错误函数形式检验:残差图示或XY图、拉姆齐Ramseyreset检验regressionspecification error test:estat ovtest3、德宾-沃森检验:不断增加变量,查看dw统计量变化信息准则AIC SIC越低的模型就越好,模型拟合度无显着差异的前提下虚拟变量如果一个模型中的解释变量全部都是虚拟变量:方差分析模型ANOVA如果解释变量中既有定量变量又有虚拟变量:协方差分析模型ANCOVAChow test:F=(RRRR−RRRRR)/RRRRRR/(R1+R2−2R)Structural change定性响应回归模型线性概率模型LPM:ui非正态但OLS点估计仍无偏;ui异方差,模型两边除以根号p1-p即权重为Yhat1-Yhat对数单位模型Logit模型:Li=ln(RR1−RR)=R+RR+R同样存在异方差,两边同乘以根号weightwight=NiPihat1-Pihat注意估计的系数要变成expcoe概率单位模型Probit模型:Ii=α+βXiPi=1√2RR−R2/2RRRR−∞对Probit模型解释:Pi=F(α+βXi)=F(Ii)RRRRRR=R(R+RRR)RLPM LOGIT PROBIT 三者系数间关系R RRRRRR≈0.625R RRRRRR RRR≈0.25R RRRRR,不含截距R RRR≈0.25R RRRRR+0.5,含截距Tobit模型:以购买住房为例,对因变量不仅想知道有或是没有,还要清楚一个消费者相对于其收入花在购房上的金额;出现一个问题:如果一个消费者不买住房就得不到这类消费者的住房支出数据;假设有两组消费者,一组n1,有关于他们的解释变量和因变量购房上的费用的信息;另一组n2,关于他们的信息只有解释变量的信息没有因变量的信息,截取样本;截取回归模型,限值回归模型;面板数据FD一阶差分法对两时期面板数据作政策分析:reg ychange xchangeFE固定效应估计:基于除时间均值变量的混合OLS估计量被称为固定效应估计量或组内估计量;当T=2时,FE和FD的估计值及其全部检验统计量都完全一样当T大于等于3时,FE和FD的估计量都是无偏一致的,但有所不同;当uit无序列相关时,固定效应法比一阶差分法更有效;如果uit是一个随机游走即很强的正序列相关,那么一阶差分法更好;当T很大时,尤其当N还不是很大时,使用固定效应估计量必须保持警惕;而一阶差分仍可用;RE随机效应模型:Yit=β0+β1Xit+ai+uitFE和FD都认为ai与一个或多个Xi相关;但在随机效应模型里,ai是零均值的因为加入常数项,ai与任何一个解释变量在任何时期都无关;由于固定效应容许ai与Xi任意相关,而随机效应则不然,估计其他条件不变效应,FE更好;若关键解释变量不随时间变化,就不能用FE估计其对Y的影响;相当常见的是,研究者同事使用FE和RE然后规范地检验时变解释变量系数的统计显着差别;决定使用FE还是RE的关键在于,能否合理地假定ai与所有Xi都无关;BP检验考察使用随机效应还是混合OLS估计;BP检验的零假设是对所有i,ai=0;P值越小,越拒绝原假设,得到随机效应模型优于混合OLS估计的结论;Hausman检验的原假设是RE和FE没有本质差异即可以使用RE;如果原假设被拒绝,结论就是随机效应模型不合适;Xtreg,feestimates store fixedxtreg,rehausman fixed工具变量法y=β0+β1x+ucov(x,u)≠0假定有一个可观测的变量z,满足:cov(z,u)=0cov(z,x)≠0该工具变量与所替代的解释变量高度相关;工具变量与模型的随机干扰项不相关;选取的工具变量与模型中其他解释变量不相关;Ivreg y x=iv内生性检验:首先采用OLS估计怀疑内生性的变量的约简型方程,预测残差,然后将残差添加至原模型中做OLS估计,判断残差参数的显着程度,若显着则有内生性;检验过度识别约束:检验工具变量与误差项不相关,如果有不止一个IV,就能有效地检验他们中的一部分是否与结构误差不相关;过度识别约束的数目就是额外的工具变量数目;1、用2SLS估计结构方程,得到2SLS残差;2、将残差对所有外生变量回归,得到R方;3、在所有IV都与残差不相关的虚拟假设下,nR方服从卡方q分布,q为模型之外工具变量减去内生解释变量数目;如果超过显着水平临界值,就拒绝原假设,可推断至少部分IV不是外生的;联立方程模型变量:内生变量:它的参数由方程组的联立解得到,在联立方程模型中,既做因变量,又可以作为解释变量外生变量:本身不受模型系统的影响前定变量:外生变量和滞后内生变量识别:内生变量个数M,给定方程中内生变量个数m,前定变量个数K,给定方程中前定变量个数k阶条件:必要非充分条件,K-k=m-1恰好识别,大于过度识别秩条件:充分必要条件,若方程能被识别,则必须从其他方程所含而该方程未含的主变量的系数矩阵中找到至少一个非零的M-1,M-1行列式,即秩为M-1;如果模型中不存在联立性问题,OLS估计量是一致有效的,而是用2SLS或IV将给出一致非有效的估计量;Hausman联立性问题检验:1、作Y1对X1和X2的回归,得到Y1的估计值Y1hat和残差uhat;2、作Y2对Y1hat和uhat的回归并对uhat的系数做t检验,如果显着,就不拒绝联立性的假设;递归模型可以用OLS,如Y1t=β10+γ11X1t+γ12X2t+u1tY2t=β20+β21Y1t+γ21X1t+γ22X2t+u2tY3t=β30+β31Y1t+β32Y2t+γ31X1t+γ32X2t+u3t恰好识别方程的估计:间接最小二乘法ILS:算出简化式,用OLS过度识别方程的估计:2SLS。