
Oracle正则表达式函数
当您了解了这种稍显神秘的语言的基础构建程序块时,正则表达式将成为您的工 具包的不可缺少的一部分(不仅在 SQL 环境下也在其它的编程语言环境下)。为 了使您的各个模式正确,虽然尝试和错误有时是必须的,但正则表达式的简洁和
--创建表 create table fzq (
id varchar(4), value varchar(10)
); --数据插入 insert into fzq values ('1','1234560'); insert into fzq values ('2','1234560'); insert into fzq values ('3','1b3b560'); insert into fzq values ('4','abc'); insert into fzq values ('5','abcde'); insert into fzq values ('6','ADREasx'); insert into fzq values ('7','123 45'); insert into fzq values ('8','adc de'); insert into fzq values ('9','adc,.de'); insert into fzq values ('10','1B'); insert into fzq values ('10','abcbvbnb'); insert into fzq values ('11','11114560'); insert into fzq values ('11','11124560'); --regexp_like
正则表达式的实际应用
您不仅可以在队列中使用正则表达式,还可以在使用 SQL 操作符或函数的任何 地方(比如说在 PL/SQL 语言中)使用正则表达式。您可以编写利用正则表达式 功能的触发器,以验证、生成或提取值。
接下来的例子演示了您如何能够在一次列检查约束条件中应用 REGEXP_LIKE 操作符来进行数据验证。它在插入或更新时检验正确的社会保险号码格式。如 123-45-6789 和 123456789 之类格式的社会保险号码对于这种列约束条件是可 接受的值。有效的数据必须以三个数字开始,紧跟着一个连字符,再加两个数字 和一个连字符,最后又是四个数字。另一种表达式只允许 9 个连续的数字。竖 线符号 (|) 将各个选项分开。
ALTER TABLE students ADD CONSTRAINT stud_ssn_ck CHECK (REGEXP_LIKE(ssn, '^([[:digit:]]{3}-[[:digit:]]{2}-[[:digit:]]{4}|[[:digit:]]{9})$'))
由 ^ 和 $ 指示的开头或结尾的字符都是不可接受的。确保您的正则表达式没有 分成多行或包含任何不必要的空格,除非您希望格式如此并相应地进行匹配。
数据有效性, 重复词的辨认, 无关的空白检测,或者分解多个正则组成的字符串, 可以 用来检查电话号码的有效性, 邮政编码,E-mail 地址, 社保号码,IP 地址, 文件名和路 径, 等等。甚至可以用来模式定位,如 HTML 的标签,数字, 日期,或者任何模式匹配的 字符或者代替他们的模式
在 Oracle 10g 中使用正则表达式
什么是正则表达式? 正则表达式由一个或多个字符和/或者字符元, 最简单的形式由字符组成, 像正则表达
式 cat,被解释为字符 c 后面跟着 a 和 t, 这样的模式匹配字符串有 cat, location 和 catalog.
字符元为 Oracle 怎么处理正则表达式提供了运算规则。 如果, 你了解了各种字符元的意 思, 你就明白正则表达式在处理独立和代替文本字符方面是多么的强大.
为了控制正则表达式可以使用 Oracle 中新的 REGEXP_LIKE, REGEXP_INSTR, 和 REG_EXP_REPLACE 函数, 你将会看到这些函数怎样增强了 LIKE, INSTR, SUBSTR 和 REPLACE 函数的功能. 实际上,和已经存在的函数呵操作相似
/* ORACLE 中的支持正则表达式的函数主要有下面四个: 1,REGEXP_LIKE :与 LIKE 的功能相似 2,REGEXP_INSTR :与 INSTR 的功能相似 3,REGEXP_SUBSTR :与 SUBSTR 的功能相似 4,REGEXP_REPLACE :与 REPLACE 的功能相似 它们在用法上与 Oracle SQL 函数 LIKE、INSTR、SUBSTR 和 REPLACE 用法相 同, 但是它们使用 POSIX 正则表达式代替了老的百分号(%)和通配符(_)字符。 POSIX 正则表达式由标准的元字符(metacharacters)所构成: '^' 匹配输入字符串的开始位置,在方括号[]表达式中使用,此时它表示不接受 该字符集合。 '$' 匹配输入字符串的结尾位置。如果设置了 RegExp 对象的 Multiline 属性, 则 $ 也匹配 '\n' 或 '\r'。 '.' 匹配除换行符之外的任何单字符。 '?' 匹配前面的子表达式零次或一次。 '+' 匹配前面的子表达式一次或多次。 '*' 匹配前面的子表达式零次或多次。 '|' 指明两项之间的一个选择。例子'^([a-z]+|[0-9]+)$'表示所有小写字母或数字 组合成的字符串。
强大是不容置疑的。
后向引用对替换、格式化和代替值非常有用,并且您可以用它们来查找相邻出现 的值。接下来的例子显示了使用 REGEP_SUBSTR 函数来查找任意被空格隔 开的重复出现的字母数字值。显示的结果给出了识别重复出现的单词 is 的子字 符串。
SELECT REGEXP_SUBSTR( 'The final test is is the implementation', '([[:alnum:]]+)([[:space:]]+)/1') AS substr FROM dual SUBSTR -----is is
SELECT REGEXP_REPLACE( 'Ellen Hildi Smith', '(.*) (.*) (.*)', '/3, /1 /2') FROM dual REGEXP_REPLACE('EL -----------------Smith, Ellen Hildi
该 SQL 语句显示了用圆括号括住的三个单独的子表达式。每一个单独的子表达 式包含一个匹配元字符 (.),并紧跟着 * 元字符,表示任何字符(除换行符之 外)都必须匹配零次或更多次。空格将各个子表达式分开,空格也必须匹配。圆 括号创建获取值的子表达式,并且可以用 /digit 来引用。第一个子表达式被赋 值为 /1 ,第二个 /2,以此类推。这些后向引用被用在这个函数的最后一个参 数 (/3, /1 /2) 中,这个函数有效地返回了替换子字符串,并按期望的格式来 排列它们(包括逗号和空格)。 详细说明了该正则表达式的各个组成部分。
12 rows selected
正则表达式的一个有用的特性是能够存储子表达式供以后重用;这也被称为后向 引用 。它允许复杂的替换功能,如在新的位置上交换模式或显示重复出现的单 词或字母。子表达式的匹配部分保存在临时缓冲区中。缓冲区从左至右进行编号, 并利用 /digit 符号进行访问,其中 digit 是 1 到 9 之间的一个数字,它匹配 第 digit 个子表达式,子表达式用一组圆括号来显示。 接下来的例子显示了通过按编号引用各个子表达式 将姓名 Ellen Hildi Smith 转变为 Smith, Ellen Hildi。
'( )' 标记一个子表达式的开始和结束位置。 '[]' 标记一个中括号表达式。 '{m,n}' 一个精确地出现次数范围,m=<出现次数<=n,'{m}'表示出现 m 次, '{m,}'表示至少出现 m 次。 \num 匹配 num,其中 num 是一个正整数。对所获取的匹配的引用。
字符簇: [[:alpha:]] 任何字母。 [[:digit:]] 任何数字。 [[:alnum:]] 任何字母和数字。 [[:space:]] 任何白字符。 [[:upper:]] 任何大写字母。 [[:lower:]] 任何小写字母。 [[:punct:]] 任何标点符号。 [[:xdigit:]] 任何 16 进制的数字,相当于[0-9a-fA-F]。 各种操作符的运算优先级 \转义符 (), (?:), (?=), [] 圆括号和方括号 *, +, ?, {n}, {n,}, {n,m} 限定符 ^, $, anymetacharacter 位置和顺序 | */
--查询 value 中以 1 开头 60 结束的记录并且长度是 7 位 select * from fzq where value like '1____60'; select * from fzq where regexp_like(value,'1....60'); --查询 value 中以 1 开头 60 结束的记录并且长度是 7 位并且全部是数字的记录。 --使用 like 就不是很好实现了。 select * from fzq where regexp_like(value,'1[0-9]{4}60'); -- 也可以这样实现,使用字符集。 select * from fzq where regexp_like(value,'1[[:digit:]]{4}60'); -- 查询 value 中不是纯数字的记录 select * from fzq where not regexp_like(value,'^[[:digit:]]+$'); -- 查询 value 中不包含任何数字的记录。 select * from fzq where regexp_like(value,'^[^[:digit:]]+$'); --查询以 12 或者 1b 开头的记录.不区分大小写。 select * from fzq where regexp_like(value,'^1[2b]','i'); --查询以 12 或者 1b 开头的记录.区分大小写。 select * from fzq where regexp_like(value,'^1[2B]'); -- 查询数据中包含空白的记录。 select * from fzq where regexp_like(value,'[[:space:]]'); --查询所有包含小写字母或者数字的记录。 select * from fzq where regexp_like(value,'^([a-z]+|[0-9]+)$'); --查询任何包含标点符号的记录。 select * from fzq where regexp_like(value,'[[:punct:]]'); /* 理解它的语法就可以了。其它的函数用法类似。 */
Oracle正则表达式汇总
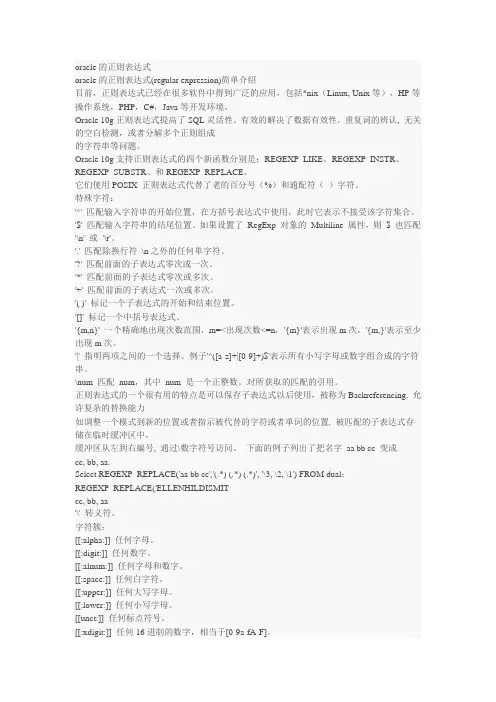
oracle的正则表达式oracle的正则表达式(regular expression)简单介绍目前,正则表达式已经在很多软件中得到广泛的应用,包括*nix(Linux, Unix等),HP等操作系统,PHP,C#,Java等开发环境。
Oracle 10g正则表达式提高了SQL灵活性。
有效的解决了数据有效性,重复词的辨认, 无关的空白检测,或者分解多个正则组成的字符串等问题。
Oracle 10g支持正则表达式的四个新函数分别是:REGEXP_LIKE、REGEXP_INSTR、REGEXP_SUBSTR、和REGEXP_REPLACE。
它们使用POSIX 正则表达式代替了老的百分号(%)和通配符(_)字符。
特殊字符:'^' 匹配输入字符串的开始位置,在方括号表达式中使用,此时它表示不接受该字符集合。
'$' 匹配输入字符串的结尾位置。
如果设置了RegExp 对象的Multiline 属性,则$ 也匹配'\n' 或'\r'。
'.' 匹配除换行符\n之外的任何单字符。
'?' 匹配前面的子表达式零次或一次。
'*' 匹配前面的子表达式零次或多次。
'+' 匹配前面的子表达式一次或多次。
'( )' 标记一个子表达式的开始和结束位置。
'[]' 标记一个中括号表达式。
'{m,n}' 一个精确地出现次数范围,m=<出现次数<=n,'{m}'表示出现m次,'{m,}'表示至少出现m次。
'|' 指明两项之间的一个选择。
例子'^([a-z]+|[0-9]+)$'表示所有小写字母或数字组合成的字符串。
\num 匹配num,其中num 是一个正整数。
对所获取的匹配的引用。
正则表达式的一个很有用的特点是可以保存子表达式以后使用,被称为Backreferencing. 允许复杂的替换能力如调整一个模式到新的位置或者指示被代替的字符或者单词的位置. 被匹配的子表达式存储在临时缓冲区中,缓冲区从左到右编号, 通过\数字符号访问。
regexp_substr用法

regexp_substr用法regexp_substr是一个在Oracle数据库中常用的函数,用于在字符串中匹配指定的正则表达式并返回匹配的子串。
具体使用方法如下:SELECT regexp_substr(字符串, 正则表达式, 开始位置, 匹配子串位置) FROM 表名;其中,字符串为需要匹配的字符串,正则表达式为需要使用的正则表达式,开始位置为匹配开始的位置,匹配子串位置为期望匹配的子串位置。
例如,要在字符串“1a2b3c”中匹配字母和数字,可以使用以下语句:SELECT regexp_substr('1a2b3c', '[[:alnum:]]+', 1, level) FROM dual CONNECT BY regexp_substr('1a2b3c', '[[:alnum:]]+', 1, level) IS NOT NULL;该语句会返回以下结果:1a2bc接下来,我将使用该函数来生成一个长度为700字左右,由列表划分的中文文字示例:在很多时候,我们需要通过代码来完成字符串的处理任务,例如根据规则进行匹配、提取、替换等操作。
而在Oracle数据库中,可以使用regexp_substr函数来轻松地处理字符串。
以下是一些常见的正则表达式示例:- 匹配字母和数字:[[:alnum:]]+- 匹配纯数字:[[:digit:]]+- 匹配纯字母:[[:alpha:]]+- 匹配纯汉字:[\u4e00-\u9fa5]+- 匹配邮箱地址:[a-z0-9._%+-]+@[a-z0-9.-]+\.[a-z]{2,}在匹配的过程中,我们可以使用开始位置和匹配子串位置两个参数来指定匹配的区域。
例如,如果我们需要从一个字符串中仅仅提取出前5个数字,那么可以使用以下语句:SELECT regexp_substr('1a2b3c4d5e6f', '[[:digit:]]+', 1, 1) FROM dual;该语句会返回以下结果:12345通过这些例子,我们可以发现regexp_substr函数的强大之处。
oracle replace正则

oracle replace正则Oracle是一种关系数据库管理系统,它提供了许多强大的功能和工具来处理和管理数据。
其中一个常用的功能是使用正则表达式进行字符串替换。
在本文中,我们将探讨如何在Oracle中使用正则表达式的replace函数来进行字符串替换。
replace函数是Oracle数据库中的一个内置函数,它用于将一个字符串中的指定子字符串替换为另一个字符串。
正则表达式是一种强大的模式匹配工具,可以用于在字符串中查找和替换符合特定模式的子字符串。
通过结合replace函数和正则表达式,我们可以轻松地在Oracle数据库中进行复杂的字符串替换操作。
让我们来了解一下replace函数的基本语法。
它接受三个参数:原字符串、要替换的子字符串和用于替换的新字符串。
下面是replace 函数的基本语法:replace(原字符串, 要替换的子字符串, 用于替换的新字符串)例如,假设我们有一个包含日期的字符串,我们想将其中的日期格式从"YYYY-MM-DD"改为"MM/DD/YYYY"。
我们可以使用replace函数和正则表达式来实现这个目标。
下面是具体的SQL查询语句:SELECT REPLACE(原字符串, '(\d{4})-(\d{2})-(\d{2})', '\2/\3/\1') FROM 表名;在上面的查询语句中,我们使用了正则表达式'(\d{4})-(\d{2})-(\d{2})'来匹配日期格式"YYYY-MM-DD"。
其中,'\d{4}'表示四个数字,'\d{2}'表示两个数字。
通过使用括号将这些正则表达式括起来,我们可以在替换字符串中引用它们。
'\2'表示第二个括号中匹配的子字符串,'\3'表示第三个括号中匹配的子字符串,'\1'表示第一个括号中匹配的子字符串。
oracle模糊查询正则
oracle模糊查询正则
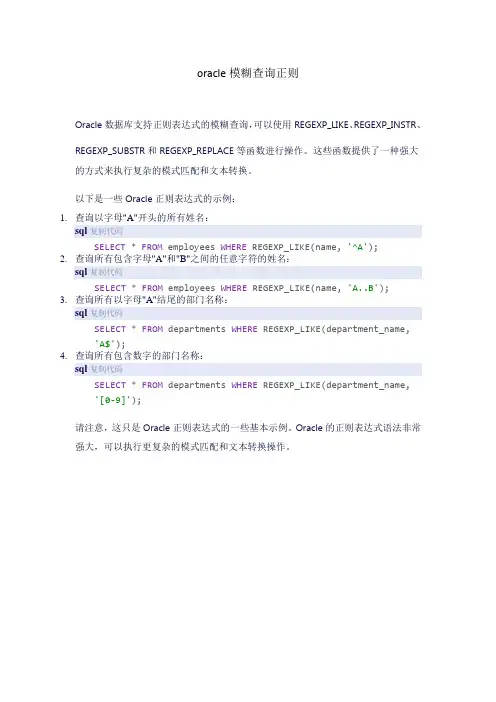
Oracle数据库支持正则表达式的模糊查询,可以使用REGEXP_LIKE、REGEXP_INSTR、REGEXP_SUBSTR和REGEXP_REPLACE等函数进行操作。
这些函数提供了一种强大的方式来执行复杂的模式匹配和文本转换。
以下是一些Oracle正则表达式的示例:
1.查询以字母"A"开头的所有姓名:
sql复制代码
SELECT * FROM employees WHERE REGEXP_LIKE(name, '^A');
2.查询所有包含字母"A"和"B"之间的任意字符的姓名:
sql复制代码
SELECT * FROM employees WHERE REGEXP_LIKE(name, 'A..B');
3.查询所有以字母"A"结尾的部门名称:
sql复制代码
SELECT * FROM departments WHERE REGEXP_LIKE(department_name,
'A$');
4.查询所有包含数字的部门名称:
sql复制代码
SELECT * FROM departments WHERE REGEXP_LIKE(department_name,
'[0-9]');
请注意,这只是Oracle正则表达式的一些基本示例。
Oracle的正则表达式语法非常强大,可以执行更复杂的模式匹配和文本转换操作。
Oracle正则表达式使用示例
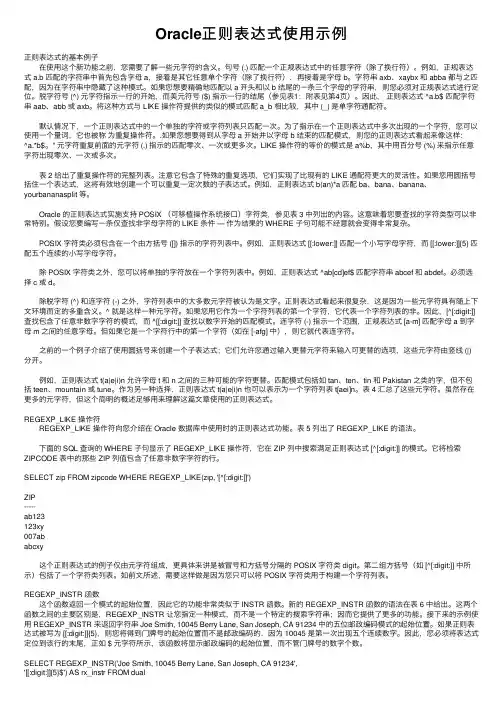
Oracle正则表达式使⽤⽰例正则表达式的基本例⼦ 在使⽤这个新功能之前,您需要了解⼀些元字符的含义。
句号 (.) 匹配⼀个正规表达式中的任意字符(除了换⾏符)。
例如,正规表达式 a.b 匹配的字符串中⾸先包含字母 a,接着是其它任意单个字符(除了换⾏符),再接着是字母 b。
字符串 axb、xaybx 和 abba 都与之匹配,因为在字符串中隐藏了这种模式。
如果您想要精确地匹配以 a 开头和以 b 结尾的⼀条三个字母的字符串,则您必须对正规表达式进⾏定位。
脱字符号 (^) 元字符指⽰⼀⾏的开始,⽽美元符号 ($) 指⽰⼀⾏的结尾(参见表1:附表见第4页)。
因此,正则表达式 ^a.b$ 匹配字符串 aab、abb 或 axb。
将这种⽅式与 LIKE 操作符提供的类似的模式匹配 a_b 相⽐较,其中 (_) 是单字符通配符。
默认情况下,⼀个正则表达式中的⼀个单独的字符或字符列表只匹配⼀次。
为了指⽰在⼀个正则表达式中多次出现的⼀个字符,您可以使⽤⼀个量词,它也被称为重复操作符。
.如果您想要得到从字母 a 开始并以字母 b 结束的匹配模式,则您的正则表达式看起来像这样:^a.*b$。
* 元字符重复前⾯的元字符 (.) 指⽰的匹配零次、⼀次或更多次。
LIKE 操作符的等价的模式是 a%b,其中⽤百分号 (%) 来指⽰任意字符出现零次、⼀次或多次。
表 2 给出了重复操作符的完整列表。
注意它包含了特殊的重复选项,它们实现了⽐现有的 LIKE 通配符更⼤的灵活性。
如果您⽤圆括号括住⼀个表达式,这将有效地创建⼀个可以重复⼀定次数的⼦表达式。
例如,正则表达式 b(an)*a 匹配 ba、bana、banana、yourbananasplit 等。
Oracle 的正则表达式实施⽀持 POSIX (可移植操作系统接⼝)字符类,参见表 3 中列出的内容。
这意味着您要查找的字符类型可以⾮常特别。
假设您要编写⼀条仅查找⾮字母字符的 LIKE 条件 — 作为结果的 WHERE ⼦句可能不经意就会变得⾮常复杂。
oracle regexp_replace用法

oracle regexp_replace用法Oracle regexp_replace() 函数用于将匹配正则表达式的内容替换为指定的值。
语法如下:```regexp_replace(text, pattern, replacement)```其中,`text` 是要替换的文本,`pattern` 是匹配正则表达式的字符串,` replacement` 是要替换成的实际值。
下面是一些示例:### 替换所有匹配正则表达式的内容要将整个文本替换为 `hello`,可以使用以下语法:```regexp_replace("world.txt", ".*.txt", "hello")```这将替换文件中所有以 ." 开头且后跟一个扩展名的子串(即"world.txt")的内容,变成 `hello.txt`。
### 只替换匹配正则表达式的部分要将文本 `hello` 替换为 `world`,可以使用以下语法:```regexp_replace("world.txt", "(.*.txt)", "($1)")```这将查找文件中所有以 ." 开头且后跟一个扩展名的子串(即"world.txt")的内容,并将查找到的值替换为 `$1`,也就是 "world" 本身。
### 使用限定符进行分组使用 `(` 和 `)` 限定符进行分组,可以将匹配正则表达式的内容分组并分别替换。
例如:```regexp_replace("world.txt", "(.*.txt)", "(($1))" )```这将替换文件中所有以 ." 开头且后跟一个扩展名的子串(即"world.txt")的内容,并将查找到的值替换为 `(($1))` 中的内容,即 "world" 和 ." 分别替换为 $1 和 $1。
oracle 正则判断韩文
oracle 正则判断韩文
在Oracle 中,可以使用正则表达式来判断是否包含韩文字符。
以下是一个简单的例子,演示如何在Oracle SQL 中使用正则表达式进行韩文判断:
```sql
SELECT column_name
FROM your_table
WHERE REGEXP_LIKE(column_name, '[가-힣]');
```
在这个例子中:
- `column_name` 是你希望进行判断的列名。
- `your_table` 是你希望查询的表名。
正则表达式`[가-힣]` 表示匹配韩文字符的范围,包括了从'가' 到'힣' 的所有字符。
如果在指定的列中包含韩文字符,那么这条记录将被检索出来。
请注意,韩文字符的Unicode 范围是U+AC00 到U+D7A3,所以正则表达式中使用了这个范围来进行匹配。
如果你需要更精确的匹配,可以根据实际需求进行调整。
需要注意的是,Oracle 的正则表达式功能可能会因数据库版本而有所不同,因此请确保你的数据库版本支持`REGEXP_LIKE` 函数。
在较早的Oracle 版本中,你可能需要使用`REGEXP_INSTR`、`REGEXP_SUBSTR` 或其他相关函数来实现类似的功能。
Oracle的REGEXP_REPLACE函数简单用法(2021-02-03)
Oracle的REGEXP_REPLACE函数简单⽤法(2021-02-03)使⽤场景:REGEXP_REPLACE让你搜索的字符串的正则表达式模式REPLACE函数的功能。
默认情况下,该函数返回source_char与replace_string取代了正则表达式模式的每个实例。
返回的字符串是在相同的字符集source_char。
语法:1 REGEXP_REPLACE(source_char, pattern [, replace_string [, position [, occurrence [, match_parameter ] ] ] ] )参数:1.source_char:搜索值的字符表达式。
这通常是⼀个字符列,可以是任何数据类型CHAR,VARCHAR2,NCHAR,NVARCHAR2,CLOB或NCLOB。
2.pattern :正则表达式Value Description^匹配字符串的开头。
如果与match_parameter ' m '⼀起使⽤,它将匹配表达式中任何地⽅的⾏开头。
$匹配字符串的结尾。
如果与match_parameter ' m '⼀起使⽤,它将匹配表达式中任何地⽅的⾏尾。
*匹配零个或多个.+匹配⼀个或多个出现.匹配零次或⼀次出现..匹配任何字符,除了空.|像“或”⼀样⽤于指定多个选择。
[ ]⽤于指定⼀个匹配列表,当您试图匹配列表中的任何⼀个字符时。
[^ ]⽤于指定⼀个⾮匹配列表,在该列表中,您试图匹配除列表中的字符以外的任何字符。
( )⽤于将表达式分组为⼦表达式。
{m}匹配m乘以。
{m,}匹配⾄少m次。
{m,n}匹配⾄少m次,但不超过n次。
\n n是1到9之间的⼀个数字。
匹配在遇到\n之前在()中找到的第n个⼦表达式。
[..]匹配⼀个可以多于⼀个字符的排序规则元素。
[::]匹配字符类。
[==]匹配等价类。
\d匹配⼀个数字字符.\D匹配⼀个⾮数字字符.\w匹配包括下划线的任何单词字符.\W匹配任何⾮单词字符.\s匹配任何空⽩字符,包括空格、制表符、换页符等等.\S匹配任何⾮空⽩字符.\A匹配字符串的开头或换⾏符之前的字符串结尾。
Oracle正则表达式语法与应用
(例如:’^1[3-8][0-9]{9}$’)
普通字符
包括所有的大小写字母、数字以及一些标点符号
元字符(特殊字符)
就是一些有特殊含义的字符,例如 ^ 代表匹配输入字 符串的开始位置(在[]中表示否定),$ 代表匹配输入 字符串的结束位置
常用元字符
. 匹配除换行符之外的任何单字符
查询value中以1开头60结束的记录,并且长度是7位,
并且全部是数字(使用like就不好实现了)
select * from test where regexp_like(value,'1[0-9]{4}60'); 或者使用字符类:'1[[:digit:]]{4}60'
Regexp_like实例应用二
Regexp_like实例应用一
查询value中以1开头60结尾的记录,并且长度是7位 select * from test where value like ‘1____60’; select * from test where regexp_like(values,’1….60’);
(这种简单查询两种方式都能简单实现)
正则表达式概述
定义:
正则表达式是对字符串操作的一种逻辑公式,就 是用事先定义好的一些特定字符组合成一个“规则字 符串”,这个“规则字符串”可以用来检索符合这个 规则的其他字符串。 特点: 一、灵活性和功能性非常强 二、可用简单方式达到字符串的复杂控制 三、对于刚接触的人来说,比较晦涩难懂
正则表达式的组成
Oracle中的正则表达式
Oracle 的正规表达式还支持 POSIX字符类。这意味着
要查找的字符类型可以非常特别。例如要查找不含字 母的字符串,如果用like的话可能非常复杂,但正则 表达式可以轻松解决(‘^[^[:alpha:]]+$’)。 POSIX 字符类必须包含在一个由方括号 ([]) 指示的字 符列表中。例如,正规表达式 [[:lower:]] 匹配一个小 写字母字符,而 [[:lower:]]{5} 匹配五个连续的小写字 母字符。
oracle将字符串转列的函数
oracle将字符串转列的函数Oracle数据库中可以使用正则表达式函数`REGEXP_SUBSTR`来将字符串转换成列。
这个函数可以根据指定的模式从字符串中提取子串,并且可以指定提取的开始位置和提取的次数。
下面是一个示例:假设有一个包含逗号分隔的字符串"apple,orange,banana,grape",我们想要将这个字符串拆分成四列,分别是水果1、水果2、水果3和水果4。
可以使用如下的SQL语句来实现:sql.SELECT.REGEXP_SUBSTR('apple,orange,banana,grape', '[^,]+', 1, 1) AS fruit1,。
REGEXP_SUBSTR('apple,orange,banana,grape', '[^,]+', 1,2) AS fruit2,。
REGEXP_SUBSTR('apple,orange,banana,grape', '[^,]+', 1, 3) AS fruit3,。
REGEXP_SUBSTR('apple,orange,banana,grape', '[^,]+', 1, 4) AS fruit4。
FROM dual;在这个例子中,`REGEXP_SUBSTR`函数的第一个参数是要处理的字符串,第二个参数是用来匹配子串的正则表达式模式,第三个参数是开始匹配的位置,第四个参数是指定匹配的次数。
通过这种方式,我们可以将字符串转换成多列数据。
除了`REGEXP_SUBSTR`函数外,还可以使用其他的字符串处理函数,比如`SUBSTR`、`INSTR`等来实现字符串转列的功能。
具体使用哪个函数取决于具体的需求和场景。