
多元统计分析实验报告
---------------------------------------------------------------最新资料推荐------------------------------------------------------多元统计分析实验报告实验一实验名称时间 2014-12-31 地点 S3-204对应分析一、实验目的及要求对应分析是你也降维的思想以达到减化数据结构的目的,凤的研究广泛用于定义属性变量构成的列联表利用对应分析方法分析问卷中教育程度与网上购物支付方式之间的相互关系。
二、实验环境 SPSS 19.0window 7 系统三、实验内容及实验步骤(实践内容、设计思想与实现步骤)实验题目:通过分析问卷数据,绘制如下的教育程度与网上购物支付方式的交叉表,运用对应分析方法研究教育程度与网上购物所选择的支付方式之间的相关性,及揭示不同人群网上购物的特征等问题。
设计思想:实现步骤:2 原假设:1 : 2 > [( ? 1)( ? 1)]1.在变量视窗中录入 3 个变量,用 edu 表示【教育程度】,用 fangshi 表示【在网上购物时采用什么样的支付方式】,用 pinshu 表示【频数】;如图所示:1/ 162.先对数据进行预处理。
执行【数据】→【加权个案】命令,弹出【加权个案】对话框。
选中【加权个案】按钮,把【频数】放入【频率变量】框中,点击【确定】按钮完成。
3.打开主窗口,选择菜单栏中的【分析】→【降维】→【对应分析】命令,弹出【对应分析】对话框。
4.将【教育程度】导入【行】,将【在网上购物时采用什么样的支付方式】导入【列】。
5. 单击【定义范围(D)】,打开【对应分析:定义行范围】对话框;定义行变量分类全距最小值为 1,最大值为 4,单击【更新】;点击【继续】,返回【对应分析】对话框;同方法打开【对应分析:定义列范围】对话框;定义列变量全距最小值为 1,最大值为 5,单击【更新】;6. 单击【统计量】打开【对应分析:统计量】对话框;选择【行轮廓表】,【列轮廓表】;单击【继续】,返回【对应分析】对话框,7.选择【绘制】→【对应分析:图】对话框,选择【散点图】中的【行点】、【列点】选择【线图】中的【已转换的行类别】、【已转换的列类别】,单击【继续】,返回【对应分析】对话框。
8.单击【确定】按钮,完成设置并执行列联表分析。
四、调试过程及实验结果(详细记录实验在调试过程中出现的问题及解决方法。
记录实验的结果) SPSS 实验结果及分析:上表显示了在 32155 名被调查者中,大多数消费者在网上购物时选择第三方支付和网上---------------------------------------------------------------最新资料推荐------------------------------------------------------ 银行支付,在网上购物的消费人群以大学本科生相对最多。
3/ 16“行简要表”是用对应表中相应位置的数据除以每一行的有效边际,显示了各频数在各行方向上的百分比。
由表可以看到,消费者在网上购物时选择“第三方支付”所占的比例最高,为 36.3% ,使用除问卷设计以外付款方式的较少,为0.9%。
表中最后一行的“质量”值即为。
“列简要表”是用对应表中相应位置的数据除以每一列的有效边际,显示了各频数在各列方向上的百分比。
由表可以看到,选择网上购物的消费者中“高中-中专及以下”人群所占的比例最高,为 30.6% ,表中最后一列的“质量”值即为。
摘要表给出了总惯量、 2 值及每一维度(公共因子)所解释的总惯量的百分比信息。
由表可知总惯量为 0.008, 2 = 250.999,有关系式:250.999 = 0.008 ×32155,可以清楚地看出总惯量与 2 值之间的关系,同时说明总惯量描述了列联表行与列之间总的相关关系。
且由表可看到 = 0.0000 < 0.05,因此拒绝原假设,认为行变量和列变量有显著的相关性。
该表显示了行变量各分类降维的情况,其中:表中第三、第四列是行变量各类别在第 1、第 2 个因子上的因子载荷,它们将成为分布图中的数据点的坐---------------------------------------------------------------最新资料推荐------------------------------------------------------ 标;第六、七列是行变量各分类对第 1、2 个因子值差异的影响程度;第八、九列是第 1、第 2 因子对行变量各分类差异的解释程度。
“教育程度的行点”是教育程度在第 1、第 2 因子上载荷的散点图,借助该图可分析教育水平各类间的差异性;可以看出,这些类别可以分别自成一类;“行和列点图”是教育程度和网购支付方式的对应分布图,借助该图可分析不同教育程度人群选择网购支付方式之间的倾向性。
五、教师评价成绩评定教师评语5/ 16实验二实验名称时间 2014-12-31 地点 S3-204多选题交叉分析一、实验目的及要求在市场调查问卷中,总会设计一部分多项选择题,而对于多选题也是问卷分析的关键一步,通过分析问卷中的多选题并绘制交叉分析发现社会生活中许多问题间的关系。
二、实验环境 SPSS 19.0window 7 系统三、实验内容及实验步骤(实践内容、设计思想与实现步骤)实验题目:通过 SPSS 软件分析多选题“请问您目前所拥有的数码产品有哪些?”设计思想在统计分析中一般采用频数分析, SPSS 提供了专门的多选题频数分析统计分析功能,即通过多重响应分析。
实现步骤: 1.建立多重响应项集:选择菜单栏中的【分析】→【多重响应】→定义变量集。
【将变量编码为】中选择【二分法】计数值为 1,在【定义多重响应集:名称】中定义 A,单击【添加】最后单击【关闭】,如图所示:2.多重响应项集的频数分析:选择菜单栏中的【分析】→【多重响应】→ 【频率】,在【多响应频率】对话框中将 A 移入【表格】单击确定,绘制相应的对应频率表。
3.多重响应项集的交叉表分析:选择菜单栏中的【分析】→【多重响应】→【交叉表】,将【多响应集】中的 A 移入【行】,“教育程度”移入【列】,【定义范围(G)】中填入最小值 1,最大值 4,单击【确定】完成。
---------------------------------------------------------------最新资料推荐------------------------------------------------------ 四、调试过程及实验结果(详细记录实验在调试过程中出现的问题及解决方法。
记录实验的结果)SPSS 实验结果及分析:上表主要显示样本是否有系统缺失,此表可知,共有 6 个缺失值,有效率接近 100%。
表中给出了个案的响应率和普及率,响应率18.1% = 17615/97355,即目前已经拥有数码产品为笔记本的人员在所有响应中(所有 1 的次数)的比例;而普及率 70.7%=17615/249,在有效样本中的比例。
我们选择用柱形图表达数据效果:7/ 16上表是教育程度与目前已经拥有的数码产品之间的交叉表,由表可以看出大学本科生所拥有的数码产品数及种类在被调查者中居多,这与我国目前国民教育程度的事实基本吻合。
表中还显示了全国数码产品的实用情况,目前笔记本电脑和台式电脑使用者较多,国家信息化科技化程度较高。
五、教师评价成绩评定教师评语实验三实验名称时间2015-1-2 地点 S3-204主成分分析一、实验目的及要求通过运用主成分分析降维的思想,研究如何通过原始变量的少数几个线性组合来解释原始变量的绝大部分信息,即在损失较少信息的情况下,研究我校大学生消费水平的影响因素。
---------------------------------------------------------------最新资料推荐------------------------------------------------------ 二、实验环境 SPSS 19.0window 7 系统三、实验内容及实验步骤(实践内容、设计思想与实现步骤)实验题目:调查我校大学生消费情况问卷中,设计对学生的消费水平的影响因素有每月伙食费、通讯费、娱乐费、学习费、购买服饰及配饰费和网购费,通过主成分分析方法处理该数据,以期望用少数变量描述我校大学生消费水平的影响因素。
实现步骤: 1.选择菜单栏中的【分析】→【描述统计】→【描述性】命令,弹出【描述性】对话框。
将需要分析的变量选入【变量】对话框,选择【将标准化得分零存为变量(Z)】。
2.选择菜单栏中的【分析】→【降维】→【因子分析】命令,弹出【因子分析】对话框,将要分析的变量选入了【变量】对话框。
3.单击【描述】按钮,选择【【原始分析结果】和【KMO 和 Bartlelt 的球形度检验】,单击【继续】。
4.单击【抽取】按钮,选择【未旋转的因子解】和【碎石图】,单击【继续】。
5.单击【确定】按钮,完成设置并执行列联表分析。
四、调试过程及实验结果(详细记录实验在调试过程中出现的问题及解决方法。
记录实验的结果)SPSS 实验结果及分析:表给出了每个原始变量中提取的信息,给出了采用主成分方法提取因子后各变量的共同9/ 16度,包括各变量对应的初始共同度和抽取因子以后的再生共同度。
---------------------------------------------------------------最新资料推荐------------------------------------------------------ 表的第一行为相关系数矩阵,第二部分是假设相关系数为零的单侧显著性检验概率矩阵。
由表可以看出,每学习费与通讯费、学习费与购买服饰配饰之间有相关关系。
上表显示了各主成分解释原始变量总方差的情况,SPSS 默认保留特征根大于 1 的主成分,但由于特征根大于 1 提取信息较少所以本题选择保留特征根大于 0.5 的主成分。
本题中保留了 5 个主成分,这 5 个主成分集中了原始 6 个变量信息的 93.749%,可见效果比较好。
2.4492.449 + 1.029 + 0.912 + 0.667 + 0.569 + 0.375 等于特征值的和 p = 4。
11/ 16表给出了标准化原始变量用求得的主成分线性表示的近似表达式: 1 = (0.3521 + 0.6782 + 0.7513 + 0.2314 + 0.7655 + 0.8146 )/√ 2 = (0.6181 ? 0.0062 + 0.0243 + 0.7194 ? 0.2785 ? 0.2276 )/√ 3 = (?0.641 ? 0.1982 ? 0.0173 + 0.6504 + 0.1575 + 0.1266 )/√ 4 = (02761 ? 0.6592 ? 0.0733 ? 0.0494 + 0.3305 + 0.2016 )/√ 5 = (0.0901 + 0.2552 ? 0.6513 + 0.0714 + 0.2325 + 0.1126 )/√ 表中的第 i 列的每个元素分别除以第 i 个特征根的平方根√ ,就可以得到主成分分析的第i个主成分的系数。
多元统计数据分析报告(3篇)
第1篇一、引言随着大数据时代的到来,数据量急剧增加,传统的统计分析方法已无法满足复杂数据关系的挖掘需求。
多元统计分析作为一种处理多个变量之间关系的方法,在社会科学、自然科学、工程技术等领域得到了广泛应用。
本报告旨在通过对某研究项目的多元统计分析,揭示变量之间的关系,为决策提供科学依据。
二、研究背景与目的本研究以某企业员工绩效评估数据为研究对象,旨在通过多元统计分析方法,探究员工绩效与个人特质、工作环境等因素之间的关系,为企业人力资源管理部门提供决策支持。
三、数据与方法1. 数据来源本研究数据来源于某企业员工绩效评估系统,包括员工的基本信息、个人特质、工作环境、绩效评分等。
2. 研究方法本研究采用以下多元统计分析方法:(1)描述性统计分析:对员工绩效、个人特质、工作环境等变量进行描述性统计分析,了解数据的分布情况。
(2)相关分析:分析变量之间的线性关系,找出相关系数较大的变量对。
(3)因子分析:将多个变量归纳为少数几个因子,揭示变量之间的内在关系。
(4)聚类分析:将员工根据绩效、个人特质、工作环境等因素进行分类,分析不同类别员工的特点。
(5)回归分析:建立员工绩效与个人特质、工作环境等因素之间的回归模型,分析各因素对绩效的影响程度。
四、数据分析结果1. 描述性统计分析通过对员工绩效、个人特质、工作环境等变量的描述性统计分析,得出以下结论:(1)员工绩效评分呈正态分布,平均绩效评分为75分。
(2)个人特质得分集中在中等水平,其中创新能力得分最高,稳定性得分最低。
(3)工作环境得分普遍较高,其中工作压力得分最低。
2. 相关分析通过对员工绩效、个人特质、工作环境等变量进行相关分析,得出以下结论:(1)绩效与创新能力、稳定性、工作环境等因素呈正相关。
(2)创新能力与稳定性呈负相关。
3. 因子分析通过对员工绩效、个人特质、工作环境等变量进行因子分析,得出以下结论:(1)提取了3个因子,分别对应创新能力、稳定性、工作环境。
多元统计分析 实验报告

多元统计分析实验报告1. 引言多元统计分析是一种用于研究多个变量之间关系的统计方法。
在实验中,我们使用了多元统计分析方法来探索一组数据中的变量之间的关系。
本报告将介绍我们的实验设计、数据收集和分析方法以及结果和讨论。
2. 实验设计为了进行多元统计分析,我们设计了一个实验,收集了一组相关变量的数据。
我们选择了X、Y和Z这三个变量作为我们的研究对象。
为了获得准确的结果,我们采用了以下实验设计:1.确定研究目的:我们的目标是探索X、Y和Z之间的关系,并确定它们之间是否存在任何相关性。
2.数据收集:我们通过调查问卷的方式收集了一组数据。
我们请参与者回答与X、Y和Z相关的问题,以获得关于这些变量的定量数据。
3.数据整理:在收集完数据后,我们将数据进行整理,将其转化为适合多元统计分析的格式。
我们使用Excel等工具进行数据整理和清洗。
4.数据验证:为了确保数据的准确性,我们对数据进行验证。
我们检查数据的有效性,比较数据之间的一致性,并排除任何异常值。
3. 数据分析在数据收集和整理完毕后,我们使用了一些常见的多元统计分析方法来分析我们的数据。
以下是我们使用的方法和步骤:1.描述统计分析:我们首先对数据进行了描述性统计分析。
我们计算了X、Y和Z的均值、标准差、最大值和最小值等。
这些统计量帮助我们了解数据的基本特征。
2.相关性分析:接下来,我们进行了相关性分析,以确定X、Y和Z之间是否存在相关关系。
我们计算了变量之间的相关系数,并绘制了相关系数矩阵。
这帮助我们确定变量之间的线性关系。
3.回归分析:为了更进一步地研究X、Y和Z之间的关系,我们进行了回归分析。
我们建立了一个多元回归模型,通过回归方程来预测因变量。
同时,我们还计算了回归系数和R方值,以评估模型的拟合度和预测能力。
4. 结果和讨论根据我们的实验设计和数据分析,我们得出了以下结果和讨论:1.描述统计分析结果显示,X的平均值为x,标准差为s;Y的平均值为y,标准差为s;Z的平均值为z,标准差为s。
多元统计实验报告
多元统计实验报告一、实验目的多元统计分析是统计学的一个重要分支,它能够处理多个变量之间的复杂关系。
本次实验的主要目的是通过实际操作和数据分析,深入理解多元统计分析的基本原理和方法,并掌握其在实际问题中的应用。
二、实验数据本次实验使用了一组来自某市场调研公司的数据集,包含了消费者的年龄、性别、收入、消费习惯等多个变量,共计_____个样本。
三、实验方法1、主成分分析(PCA)主成分分析是一种降维方法,它通过将多个相关变量转换为一组较少的不相关变量(即主成分),来简化数据结构并提取主要信息。
2、因子分析因子分析用于发现潜在的公共因子,这些因子能够解释多个观测变量之间的相关性。
3、聚类分析聚类分析将数据对象分组,使得同一组内的对象具有较高的相似性,而不同组之间的对象具有较大的差异性。
四、实验过程1、数据预处理首先,对原始数据进行了清洗和预处理,包括处理缺失值、异常值和数据标准化等操作,以确保数据的质量和可用性。
2、主成分分析使用统计软件进行主成分分析,计算出特征值、贡献率和累计贡献率。
根据特征值大于 1 的原则,确定了保留的主成分个数。
通过主成分载荷矩阵,解释了主成分的实际意义。
3、因子分析运用因子分析方法,提取公共因子,并通过旋转因子载荷矩阵,使得因子的解释更加清晰和具有实际意义。
计算因子得分,用于进一步的分析和应用。
4、聚类分析采用 KMeans 聚类算法,根据选定的变量对样本进行聚类。
通过不断调整聚类中心和重新分配样本,最终得到了较为合理的聚类结果。
五、实验结果与分析1、主成分分析结果提取了_____个主成分,它们累计解释了_____%的方差。
第一个主成分主要反映了_____,第二个主成分主要与_____相关,以此类推。
这为我们理解数据的主要结构提供了重要的线索。
2、因子分析结果成功提取了_____个公共因子,它们能够较好地解释原始变量之间的相关性。
每个因子所代表的潜在因素也得到了清晰的解释,有助于深入了解消费者的行为特征和市场结构。
多元统计实验报告

多元统计实验报告多元统计实验报告导言在现代科学研究中,多元统计方法被广泛应用于数据分析和模式识别等领域。
本次实验旨在通过多元统计方法探索变量之间的关系,并研究其对研究对象的影响。
实验设计我们选择了一个实验样本,包括100名大学生。
我们收集了他们的性别、年龄、身高、体重、学业成绩和运动习惯等多个变量。
通过对这些变量进行统计分析,我们希望能够了解它们之间的关系,并且进一步推断这些变量对大学生的影响。
数据预处理在进行多元统计分析之前,我们首先需要对数据进行预处理。
我们对缺失值进行了处理,使用均值填充了缺失的数据。
然后,我们进行了数据标准化,以消除不同变量之间的量纲差异。
主成分分析我们首先进行了主成分分析(PCA),以降低数据维度并寻找主要的变量。
通过PCA,我们得到了三个主成分,它们分别解释了总方差的70%、20%和10%。
这表明我们可以用这三个主成分来代表原始数据的大部分信息。
聚类分析接下来,我们进行了聚类分析,以研究样本之间的相似性和差异性。
我们使用了K-means算法,并将样本分为三个簇。
通过观察每个簇的特征,我们发现第一个簇主要包括男性、年龄较大、身高较高、体重较重、学业成绩较好和较少运动的大学生;第二个簇主要包括女性、年龄较小、身高较矮、体重较轻、学业成绩一般和较多运动的大学生;第三个簇则包括了男女性别各半、年龄、身高、体重、学业成绩和运动习惯都相对均衡的大学生。
相关分析为了研究变量之间的相关性,我们进行了相关分析。
我们发现学业成绩与年龄和身高之间存在较强的正相关关系,而与体重和运动习惯之间存在较弱的负相关关系。
这表明学业成绩可能受到年龄和身高的正向影响,而受到体重和运动习惯的负向影响。
回归分析最后,我们进行了回归分析,以探究变量对学业成绩的影响。
我们选择了年龄、身高、体重和运动习惯作为自变量,学业成绩作为因变量。
通过回归分析,我们得到了一个显著的回归模型,解释了学业成绩的40%的方差。
其中,年龄和身高对学业成绩有正向影响,而体重和运动习惯对学业成绩有负向影响。
多元统计课程实验报告
一、实验背景随着社会经济的发展和科学技术的进步,数据量日益庞大,如何从大量数据中提取有价值的信息,成为统计学研究的热点问题。
多元统计分析作为统计学的一个重要分支,通过对多个变量之间的关系进行分析,为决策者提供有力的数据支持。
本实验旨在通过实际操作,让学生熟练掌握多元统计分析方法,提高数据分析能力。
二、实验目的1. 掌握多元统计分析的基本概念和方法;2. 学会运用多元统计分析方法解决实际问题;3. 提高数据分析能力,为后续课程打下坚实基础。
三、实验内容本次实验以某城市居民消费数据为例,运用多元统计分析方法对其进行分析。
四、实验步骤1. 数据导入首先,将实验数据导入统计软件(如SPSS、R等)。
本实验采用SPSS软件,数据集包含以下变量:(1)收入(y):居民年收入;(2)教育程度(x1):居民最高学历;(3)年龄(x2):居民年龄;(4)家庭人口(x3):家庭人口数量;(5)住房面积(x4):家庭住房面积。
2. 描述性统计分析对数据集进行描述性统计分析,包括各变量的均值、标准差、最大值、最小值等。
3. 相关性分析运用皮尔逊相关系数、斯皮尔曼等级相关系数等方法,分析变量之间的相关关系。
4. 主成分分析运用主成分分析方法,提取主要成分,降低数据维度。
5. 聚类分析运用K-means聚类分析方法,将居民划分为不同的消费群体。
6. 随机森林回归分析运用随机森林回归分析方法,预测居民收入。
五、实验结果与分析1. 描述性统计分析根据描述性统计分析结果,可知居民年收入、教育程度、年龄、家庭人口、住房面积的平均值、标准差、最大值、最小值等。
2. 相关性分析通过相关性分析,发现收入与教育程度、年龄、家庭人口、住房面积之间存在显著的正相关关系。
3. 主成分分析根据主成分分析结果,提取出两个主成分,累计方差贡献率为84.95%,可以解释大部分的变量信息。
4. 聚类分析通过K-means聚类分析,将居民划分为3个消费群体。
多元统计分析——典型相关分析实验报告
多元统计分析实验报告课程名称多元统计分析实验成绩实验内容典型相关分析指导老师姓名专业班级一、实验目的典型相关分析(Canonical correlation)又称规则相关分析,用以分析两组变量间关系的一种方法;两个变量组均包含多个变量,所以简单相关和多元回归的解惑都是规则相关的特例。
典型相关将各组变量作为整体对待,描述的是两个变量组之间整体的相关,而不是两个变量组个别变量之间的相关。
本文旨在通过分析农业基础用品投入量与农产品产量数据,利用典型相关分析分析两者的关系,同时达到熟练使用SPSS软件进行典型相关分析操作的目的。
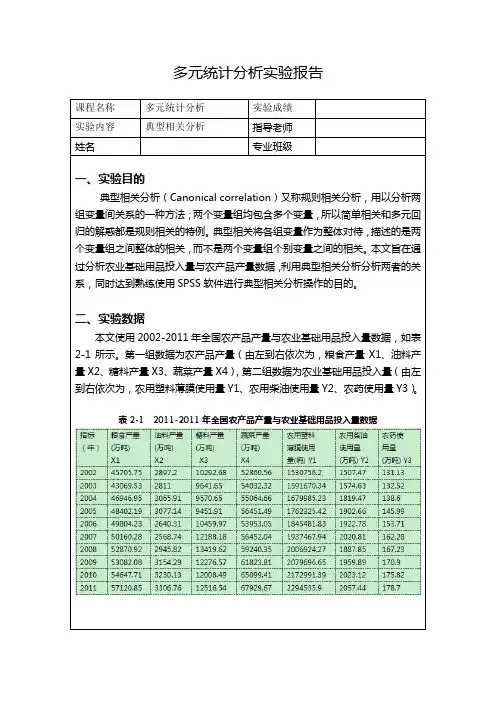
二、实验数据本文使用2002-2011年全国农产品产量与农业基础用品投入量数据,如表2-1所示。
第一组数据为农产品产量(由左到右依次为,粮食产量X1、油料产量X2、糖料产量X3、蔬菜产量X4),第二组数据为农业基础用品投入量(由左到右依次为,农用塑料薄膜使用量Y1、农用柴油使用量Y2、农药使用量Y3)。
表2-1 2011-2011年全国农产品产量与农业基础用品投入量数据由于cancorr不能读取中文名称,所以变量名均需为英文名。
将表2-1数据转换为能够进行典型相关分析形式的数据,如表2-2所示。
表2-2 典型相关分析数据(农产品产量与农业基础用品投入量数据)三、实验过程SPSS 16.0并未提供典型相关分析的交互窗口,只能直接在syntax editor 窗口呼叫SPSS的CANCORR程序来执行分析。
选择【File】—【New】—【Syntax】,弹出Syntax对话框,在对话框中写入调用Cancorr程序,如图3-1所示。
图3-1 Syntax窗口调用CONCORR函数四、实验结果表4-1为第一组数据,即农产品产量之间的相关关系表。
从表中可以看出,粮食产量(X1)与蔬菜产量(X4)有较高的相关关系,相关系数高达0.9035;粮食产量(X1)与糖料产量(X3)相关关系也较大,相关系数为0.8081;油料产量(X2)与蔬菜产量(X4)的相关关系较大,为0.7442。
SPSS多元统计分析实验报告
实 验 课名称:SPSS统计分析
实验项目名称:多元线性回归分析
专 业 名 称:统计学
班 级:
学 号:
学 生 姓 名:
教 师 姓 名:
2014年12月20日
组别同组同学
实验日期2014年12月20日 实验名称多元统计分析
一、实验名称:
多元统计分析
二、实验目的和要求:
通过运用SPSS软件的多元统计分析揭示主管性格与雇员对其整体满意度之间的关系掌握多元统计分析的原理及建模过程。
六、实验结果与分析
通过以上建模和检验过程,最后得到的符合实际且具有统计意义的方程为:Y=0.78X1,即雇员对主管的满意程度只与主管处理雇员的抱怨有关,且成正相关。
七、讨论和回答问题及体会:
1.通过学习,我掌握了多元线性回归的基本原理和步骤,并学会运用SPSS软件进行处理该类问题和比较熟练地分析结果。
设随机变量y与一般变量x1,x2……xk的线性回归模型为:
y=β0+β1*x1+β2*x2+……+βk*xk+ε
其中β0,β1,β2……+βk是k+1个未知参数,β0称为回归常数,β1,β2……+βk称为回归系数,y称为被解释变量;x1,x2……xk称为解释变量。通过最小二乘法估算出各系数,并测定方程的拟合程度、检验回归方程和回归系数的显著性,得到最后的方程。
3运用SPSS软件进行多元分析对模型进行整理,比较调整的R系数、方差分析表、回归分析结果(各系数机器t检验等)、共显性检验等统计方法,得出结果。
四、实验仪器与设备:
SPSS软件、兼容SPSS软件的电脑一台、老师给的数据素材。
五、实验原理:
多元线性回归模型是一元线性回归模型的扩展,其基本原理与一员线性回归模型类似,计算公式如下:
实验报告-因子分析(多元统计)精选全文
精选全文完整版可编辑修改实验报告主成分分析(综合性实验)(Principal component analysis)实验原理:主成分分析利用指标之间的相关性,将多个指标转化为少数几个综合指标,从而达到降维和数据结构简化的目的。
这些综合指标反映了原始指标的绝大部分信息,通常表示为原始指标的某种线性组合,且综合指标间不相关。
利用矩阵代数的知识可求解主成分。
实验题目一:将彩色胶卷在显影液下处理后在不同情形下曝光,然后通过红、绿、蓝三种滤色片并在高、中、低三种密度下进行测量,每个胶卷有高红、高绿、高蓝、中红、…、低蓝等九个指标(分别记为X1-X9九个变量)。
试验了108个胶卷,由数据已算得如下协差阵:(S2a1)177 179 95 96 53 32 -7 -4 -3419 245 131 181 127 -2 1 4302 60 109 142 4 4 11158 102 42 4 3 2137 96 4 5 6128 2 2 834 31 3339 3948实验要求:(1)试从协差阵出发进行主成分分析;(2)计算方差累积贡献率;(3)作Scree图,并结合(2)的结果确定主成分的个数;(4)试对结果进行解释。
实验题目二:下表中给出了不同国家及地区的男子径赛记录:(t8a6)Country 100m(s) 200m(s)400m(s)800m(min)1500m(min)5000m(min)10,000m(min)Marathon(mins)Argentina 10.39 20.81 46.84 1.81 3.7 14.04 29.36 137.72 Australia 10.31 20.06 44.84 1.74 3.57 13.28 27.66 128.3 Austria 10.44 20.81 46.82 1.79 3.6 13.26 27.72 135.9 Belgium 10.34 20.68 45.04 1.73 3.6 13.22 27.45 129.95 Bermuda 10.28 20.58 45.91 1.8 3.75 14.68 30.55 146.62 Brazil 10.22 20.43 45.21 1.73 3.66 13.62 28.62 133.13 Burma 10.64 21.52 48.3 1.8 3.85 14.45 30.28 139.95 Canada 10.17 20.22 45.68 1.76 3.63 13.55 28.09 130.15 Chile 10.34 20.8 46.2 1.79 3.71 13.61 29.3 134.03 China 10.51 21.04 47.3 1.81 3.73 13.9 29.13 133.53 Columbia 10.43 21.05 46.1 1.82 3.74 13.49 27.88 131.35 Cook Islands 12.18 23.2 52.94 2.02 4.24 16.7 35.38 164.7 Costa Rica 10.94 21.9 48.66 1.87 3.84 14.03 28.81 136.58 Czechoslovakia 10.35 20.65 45.64 1.76 3.58 13.42 28.19 134.32 Denmark 10.56 20.52 45.89 1.78 3.61 13.5 28.11 130.78 Dominican Republic 10.14 20.65 46.8 1.82 3.82 14.91 31.45 154.12 Finland 10.43 20.69 45.49 1.74 3.61 13.27 27.52 130.87 France 10.11 20.38 45.28 1.73 3.57 13.34 27.97 132.3 German (D.R.) 10.12 20.33 44.87 1.73 3.56 13.17 27.42 129.92 German (F.R.) 10.16 20.37 44.5 1.73 3.53 13.21 27.61 132.23 Great Brit.& N. Ireland 10.11 20.21 44.93 1.7 3.51 13.01 27.51 129.13 Greece 10.22 20.71 46.56 1.78 3.64 14.59 28.45 134.6 Guatemala 10.98 21.82 48.4 1.89 3.8 14.16 30.11 139.33 Hungary 10.26 20.62 46.02 1.77 3.62 13.49 28.44 132.58 India 10.6 21.42 45.73 1.76 3.73 13.77 28.81 131.98Indonesia 10.59 21.49 47.8 1.84 3.92 14.73 30.79 148.83 Ireland 10.61 20.96 46.3 1.79 3.56 13.32 27.81 132.35 Israel 10.71 21 47.8 1.77 3.72 13.66 28.93 137.55 Italy 10.01 19.72 45.26 1.73 3.6 13.23 27.52 131.08 Japan 10.34 20.81 45.86 1.79 3.64 13.41 27.72 128.63 Kenya 10.46 20.66 44.92 1.73 3.55 13.1 27.38 129.75 Korea 10.34 20.89 46.9 1.79 3.77 13.96 29.23 136.25 D.P.R Korea 10.91 21.94 47.3 1.85 3.77 14.13 29.67 130.87 Luxembourg 10.35 20.77 47.4 1.82 3.67 13.64 29.08 141.27 Malaysia 10.4 20.92 46.3 1.82 3.8 14.64 31.01 154.1 Mauritius 11.19 22.45 47.7 1.88 3.83 15.06 31.77 152.23 Mexico 10.42 21.3 46.1 1.8 3.65 13.46 27.95 129.2 Netherlands 10.52 20.95 45.1 1.74 3.62 13.36 27.61 129.02 New Zealand 10.51 20.88 46.1 1.74 3.54 13.21 27.7 128.98 Norway 10.55 21.16 46.71 1.76 3.62 13.34 27.69 131.48 Papua New Guinea 10.96 21.78 47.9 1.9 4.01 14.72 31.36 148.22 Philippines 10.78 21.64 46.24 1.81 3.83 14.74 30.64 145.27 Poland 10.16 20.24 45.36 1.76 3.6 13.29 27.89 131.58 Portugal 10.53 21.17 46.7 1.79 3.62 13.13 27.38 128.65 Rumania 10.41 20.98 45.87 1.76 3.64 13.25 27.67 132.5 Singapore 10.38 21.28 47.4 1.88 3.89 15.11 31.32 157.77 Spain 10.42 20.77 45.98 1.76 3.55 13.31 27.73 131.57 Sweden 10.25 20.61 45.63 1.77 3.61 13.29 27.94 130.63 Switzerland 10.37 20.46 45.78 1.78 3.55 13.22 27.91 131.2 Taipei 10.59 21.29 46.8 1.79 3.77 14.07 30.07 139.27 Thailand 10.39 21.09 47.91 1.83 3.84 15.23 32.56 149.9 Turkey 10.71 21.43 47.6 1.79 3.67 13.56 28.58 131.5 USA 9.93 19.75 43.86 1.73 3.53 13.2 27.43 128.22 USSR 10.07 20 44.6 1.75 3.59 13.2 27.53 130.55Western Samoa 10.82 21.86 49 2.02 4.24 16.28 34.71 161.83 (数据来源:1984年洛杉机奥运会IAAF/AFT径赛与田赛统计手册)实验要求:(1)试求主成分,并对结果进行解释;(2)试用方差累积贡献率和Scree图确定主成分的个数;(3)计算各国第一主成分的得分并排名。
多元统计分析实验报告(精选多篇)
多元统计分析实验报告(精选多篇)第一篇:多元统计分析实验报告多元统计分析得实验报告院系:数学系班级:13级 B 班姓名:陈翔学号:20131611233 实验目得:比较三大行业得优劣性实验过程有如下得内容:(1)正态性检验;(2)主体间因子,多变量检验a;(3)主体间效应得检验;(4)对比结果(K 矩阵);(5)多变量检验结果;(6)单变量检验结果;(7)协方差矩阵等同性得Box 检验a,误差方差等同性得Levene 检验 a;(8)估计;(9)成对比较,多变量检验;(10)单变量检验。
实验结果:综上所述,我们对三个行业得运营能力进行了具体得比较分析,所得数据表明,从总体来瞧,信息技术业要稍好于电力、煤气及水得生产与供应业以及房地产业。
1。
正态性检验Kolmogorov-SmirnovaShapir o—Wilk 统计量 df Sig.统计量df Sig、净资产收益率。
113 35、200*。
978 35。
677 总资产报酬率。
121 35、200*。
964 35、298 资产负债率。
086 35。
200*.962 35、265 总资产周转率.180 35、006。
864 35。
000流动资产周转率、164 35、018.88535、002 已获利息倍数、28135.000。
55135、000 销售增长率.103 35、200*。
949 35、104 资本积累率。
251 35。
000、655 35。
000 *。
这就是真实显著水平得下限。
a。
Lilliefors显著水平修正此表给出了对每一个变量进行正态性检验得结果,因为该例中样本中n=35<2000,所以此处选用 Shapiro—W ilk 统计量。
由 Sig。
值可以瞧到,总资产周转率、流动资产周转率、已获利息倍数及资本积累率均明显不遵从正态分布,因此,在下面得分析中,我们只对净资产收益率、总资产报酬率、资产负债率及销售增长率这四个指标进行比较,并认为这四个变量组成得向量遵从正态分布(尽管事实上并非如此)。
多元统计分析 实验报告
多元统计分析实验报告多元统计分析实验报告一、引言多元统计分析是一种研究多个变量之间关系的统计方法,可以帮助我们更全面地了解数据集中的信息。
本实验旨在通过多元统计分析方法,探索不同变量之间的关系,并分析其对研究结果的影响。
二、数据收集与处理在本实验中,我们收集了一份关于学生学业成绩的数据集。
数据集包括学生的性别、年龄、家庭背景、学习时间、考试成绩等多个变量。
为了方便分析,我们对数据进行了清洗和预处理,包括删除缺失值、标准化处理等。
三、描述性统计分析在进行多元统计分析之前,我们首先对数据进行了描述性统计分析。
通过计算各变量的均值、标准差、最小值、最大值等统计量,我们对数据的整体情况有了初步的了解。
例如,我们发现男生和女生的平均成绩存在差异,家庭背景与学习时间之间存在一定的相关性等。
四、相关性分析为了探索不同变量之间的关系,我们进行了相关性分析。
通过计算各个变量之间的相关系数,我们可以了解它们之间的线性关系强弱。
通过绘制相关系数矩阵的热力图,我们可以直观地观察到各个变量之间的相关性。
例如,我们发现学习时间与考试成绩之间存在较强的正相关关系,而年龄与考试成绩之间的相关性较弱。
五、主成分分析主成分分析是一种常用的降维方法,可以将多个相关变量转化为少数几个无关的主成分。
在本实验中,我们应用主成分分析方法对数据进行了降维处理。
通过计算各个主成分的解释方差比例,我们可以确定保留的主成分个数。
通过绘制主成分得分图,我们可以观察到不同变量在主成分上的贡献程度。
例如,我们发现第一主成分主要与学习时间和考试成绩相关,而第二主成分主要与家庭背景和性别相关。
六、聚类分析聚类分析是一种将样本按照相似性进行分类的方法,可以帮助我们发现数据集中的潜在模式和群体。
在本实验中,我们应用聚类分析方法对学生进行了分类。
通过选择适当的聚类算法和距离度量,我们可以将学生分为不同的群体。
通过绘制聚类结果的散点图,我们可以观察到不同群体之间的差异。