
hadoop常用命令
所有hadoop命令均由hadoop主目录下bin/hadoop脚本引发,部分在bin/hadoop 一、HADOOP的启动与关闭 sh ./sbin/start-all.sh --启动 (注意启动环境,必须从hadoop主目录) sh ./sbin/stop-all.sh bin/Hadoopversion 查看版本http://localhost:50070 (localhost也可是master的ip) jps //OS级查看hadoop进程 二、文件操作 Hadoop fs 选项(应用较广,包括本地文件系统),推荐hdfs对应命令dfs bin/hdfs dfsadmin –report//查看节点运行状态 bin/hdfs dfs -mkdir /t2//在hdfs根目录创建子目录t2 bin/hdfs dfs -ls ///列出目录 bin/hdfs dfs -put /hadoop/hadoop/test4178.txt /t2 //上传本地文件到HDFS的T2 bin/hdfs dfs -get /t3/test2 /下载test2到本地根目录位置相反 bin/hdfs dfs -cat /t2/test2 //显示文件内容 bin/hadoop fs -put /hadoop/hadoop/test4178.txt /t2 //cp本地文件到HDFS的T2 bin/hdfs dfs -rmdir /t2//删除非空目录 bin/hdfs dfs -rm /t2/test2//删除文件, bin/hdfs dfs –rm -r /t2//删除目录及其下所有文件, bin/hadoop dfs -cat /ctom4178/test4178.txt
1、列出所有Hadoop Shell支持的命令 $ bin/hadoop fs -help 2、显示关于某个命令的详细信息 $ bin/hadoop fs -help command-name 3、用户可使用以下命令在指定路径下查看历史日志汇总 $ bin/hadoop job -history output-dir 这条命令会显示作业的细节信息,失败和终止的任务细节。 4、关于作业的更多细节,比如成功的任务,以及对每个任务的所做的尝试次数等可以用下面的命令查看 $ bin/hadoop job -history all output-dir 5、格式化一个新的分布式文件系统: $ bin/hadoop namenode -format 6、在分配的NameNode上,运行下面的命令启动HDFS: $ bin/start-dfs.sh bin/start-dfs.sh脚本会参照NameNode上${HADOOP_CONF_DIR}/slaves文件的内容,在所有列出的slave上启动DataNode守护进程。 7、在分配的JobTracker上,运行下面的命令启动Map/Reduce: $ bin/start-mapred.sh bin/start-mapred.sh脚本会参照JobTracker上${HADOOP_CONF_DIR}/slaves文件的内容,在所有列出的slave上启动TaskTracker守护进程。 8、在分配的NameNode上,执行下面的命令停止HDFS: $ bin/stop-dfs.sh bin/stop-dfs.sh脚本会参照NameNode上${HADOOP_CONF_DIR}/slaves文件的内容,在所有列出的slave上停止DataNode守护进程。 9、在分配的JobTracker上,运行下面的命令停止Map/Reduce: $ bin/stop-mapred.sh bin/stop-mapred.sh脚本会参照JobTracker上${HADOOP_CONF_DIR}/slaves文件的内容,在所有列出的slave上停止TaskTracker守护进程。
DFSShell 10、创建一个名为 /foodir 的目录 $ bin/hadoop dfs -mkdir /foodir 11、创建一个名为 /foodir 的目录 $ bin/hadoop dfs -mkdir /foodir 12、查看名为 /foodir/myfile.txt 的文件内容 $ bin/hadoop dfs -cat /foodir/myfile.txt
DFSAdmin 13、将集群置于安全模式 $ bin/hadoop dfsadmin -safemode enter 14、显示Datanode列表 $ bin/hadoop dfsadmin -report 15、使Datanode节点 datanodename退役 $ bin/hadoop dfsadmin -decommission datanodename 16、bin/hadoop dfsadmin -help 命令能列出所有当前支持的命令。比如: * -report:报告HDFS的基本统计信息。有些信息也可以在NameNode Web服务首页看到。 * -safemode:虽然通常并不需要,但是管理员的确可以手动让NameNode进入或离开安全模式。 * -finalizeUpgrade:删除上一次升级时制作的集群备份。 17、显式地将HDFS置于安全模式 $ bin/hadoop dfsadmin -safemode 18、在升级之前,管理员需要用(升级终结操作)命令删除存在的备份文件 $ bin/hadoop dfsadmin -finalizeUpgrade 19、能够知道是否需要对一个集群执行升级终结操作。 $ dfsadmin -upgradeProgress status 20、使用-upgrade选项运行新的版本 $ bin/start-dfs.sh -upgrade 21、如果需要退回到老版本,就必须停止集群并且部署老版本的Hadoop,用回滚选项启动集群 $ bin/start-dfs.h -rollback 22、下面的新命令或新选项是用于支持配额的。前两个是管理员命令。 * dfsadmin -setquota ... 把每个目录配额设为N。这个命令会在每个目录上尝试,如果N不是一个正的长整型数,目录不存在或是文件名,或者目录超过配额,则会产生错误报告。 * dfsadmin -clrquota ... 为每个目录删除配额。这个命令会在每个目录上尝试,如果目录不存在或者是文件,则会产生错误报告。如果目录原来没有设置配额不会报错。 * fs -count -q ... 使用-q选项,会报告每个目录设置的配额,以及剩余配额。如果目录没有设置配额,会报告none和inf。 23、创建一个hadoop档案文件 $ hadoop archive -archiveName NAME * -archiveName NAME 要创建的档案的名字。 src 文件系统的路径名,和通常含正则表达的一样。 dest 保存档案文件的目标目录。 24、递归地拷贝文件或目录 $ hadoop distcp srcurl 源Url desturl 目标Url
25、运行HDFS文件系统检查工具(fsck tools) 用法:hadoop fsck [GENERIC_OPTIONS] [-move | -delete | -openforwrite] [-files [-blocks [-locations | -racks]]] 命令选项描述 检查的起始目录。 -move 移动受损文件到/lost+found -delete 删除受损文件。 -openforwrite 打印出写打开的文件。 -files 打印出正被检查的文件。 -blocks 打印出块信息报告。 -locations 打印出每个块的位置信息。 -racks 打印出data-node的网络拓扑结构。 26、用于和Map Reduce作业交互和命令(jar) 用法:hadoop job [GENERIC_OPTIONS] [-submit ] | [-status ] | [-counter ] | [-kill ] | [-events <#-of-events>] | [-history [all] ] | [-list [all]] | [-kill-task] | [-fail-task ] 命令选项描述 -submit 提交作业 -status 打印map和reduce完成百分比和所有计数器。 -counter 打印计数器的值。 -kill 杀死指定作业。 -events <#-of-events>打印给定范围内jobtracker接收到的事件细节。 -history [all] -history 打印作业的细节、失败及被杀死原因的细节。更多的关于一个作业的细节比如 成功的任务,做过的任务尝试等信息可以通过指定[all]选项查看。 -list [all] -list all 显示所有作业。-list只显示将要完成的作业。 -kill-task 杀死任务。被杀死的任务不会不利于失败尝试。
Hadoop中 常用端口说明和相关配置文件

Hadoop中常用端口说明和相关配置文件Hadoop是一个开源的分布式处理系统,可以对大规模数据进行高效的存储和处理。
在Hadoop中,有许多常用的端口和相关配置文件,这些端口和文件对于Hadoop集群的运行非常重要。
本文将详细介绍Hadoop中常用的端口说明和相关配置文件。
一、Hadoop常用端口说明1. Namenode端口:默认端口为8020,是Hadoop集群中的主节点,存储有HDFS的元数据信息,命令行中通过hdfs://<namenode-ip>:8020/访问HDFS。
Namenode的端口负责管理整个集群中文件块的元数据信息,由于这些信息比较重要,建议使用安全的方式进行访问和管理。
2. Datanode端口:默认端口为50010,是Hadoop集群中的从节点,存储有HDFS的数据块。
Datanode的端口用于管理数据块,当文件需要进行读写操作时,客户端会向Namenode请求相应数据块的位置信息,然后直接通过Datanode端口进行读写操作。
3. Secondary Namenode端口:默认端口为50090,是Hadoop集群中的辅助节点,不存储实际数据,但能够定期备份主节点的元数据信息,避免因Namenode节点失效而导致Hadoop集群无法访问。
4. JobTracker端口:默认端口为8021,是Hadoop中的工作节点,负责处理MapReduce任务。
JobTracker的端口负责监控整个Hadoop集群中的运行情况,以及处理MapReduce任务的分配和管理。
5. TaskTracker端口:默认端口为50060,是Hadoop中的工作节点,负责处理MapReduce任务。
TaskTracker的端口负责处理实际的MapReduce任务,将计算结果返回给JobTracker进行处理。
二、Hadoop相关配置文件1. core-site.xml:这个配置文件是Hadoop的核心配置文件之一,主要用于配置Hadoop集群的全局属性。
hdfs distcp用法
hdfs distcp用法
`hdfs distcp`是`Hadoop`生态系统中用于在不同`HDFS`集群之间或同一集群的不同节点之间复制数据的命令行工具。
其用法如下:
```bash
hadoop distcp OPTIONS (source_path...) < target_path>
```
其中常用的选项有:
- `-append`:拷贝文件时支持对现有文件进行追加写操作。
- `-async`:异步执行`distcp`拷贝任务。
- `-bandwidth <arg>`:对每个`Map`任务的带宽限速。
- `-delete`:删除相对于源端,目标端多出来的文件。
- `-diff <arg>`:通过快照`diff`信息进行数据的同步。
- `-overwrite`:以覆盖的方式进行拷贝,如果目标端文件已经存在,则直接覆盖。
- `-p <arg>`:拷贝数据时,扩展属性信息的保留,包括权限信息、块大小信息等。
在实际使用时,请根据需求选择合适的选项和源、目标路径。
大数据_hadoop_分布式文件系统
2.HDFS
HDFS(Hadoop Distributed File System)是Hadoop项目 的核心子项目,是Hadoop主要应用的一个分布式文件系统。 注:HDFS只是Hadoop抽象文件系统的一个实例,还包括本地 文件系统、HFTP、S3等。
一、Hadoop文件系统
1.Hadoop文件系统
二、HDFS简介
1.HDFS
HDFS是基于流数据模式访问和处理超大文件的需求而开 发的,它可以运行于廉价的商用服务器上。
2.HDFS的主要特点:
(1)处理超大文件 实际应用中,HDFS已经用来存储PB级的数据了。 (2)流式的访问数据 运行在HDFS上的应用程序必须流式地访问他们的数据集。 HDFS的设计适合批量处理,而不是用户交互式的。重点是数 据吞吐量(通常分析任务都会涉及数据集的大部分数据不适合低延迟数据访问
HDFS是为了处理大型数据集分析任务,主要是为了达到 高的数据吞吐量而设计的,这就要求可能以高延迟为代价。 注:对于低延迟的访问需求,HBase是更好地选择。
(2)无法高效存储大量小文件 Hadoop中由namenode负责将文件系统中的元数据存储在 内存中,因此文件系统存储的文件总数受限于namenode的内 存容量。当存储大量的小文件时,会大大增加namenode的工 作压力,检索处理元数据所需的时间就会很长。
四、HDFS的基本操作
1.HDFS命令行操作
可以通过命令行接口和HDFS进行交互。
(1)下面以单机上运行Hadoop、执行单机伪分布为 例:
在单机伪分布中需要修改两个配置属性: ① 修改属性: 令 =hdfs://localhost/ 注:hadoop默认使用HDFS文件系统;在本机localhost运行 HDFS,其端口默认采用8020.
大数据技术基础实验报告-HDFS常用操作命令
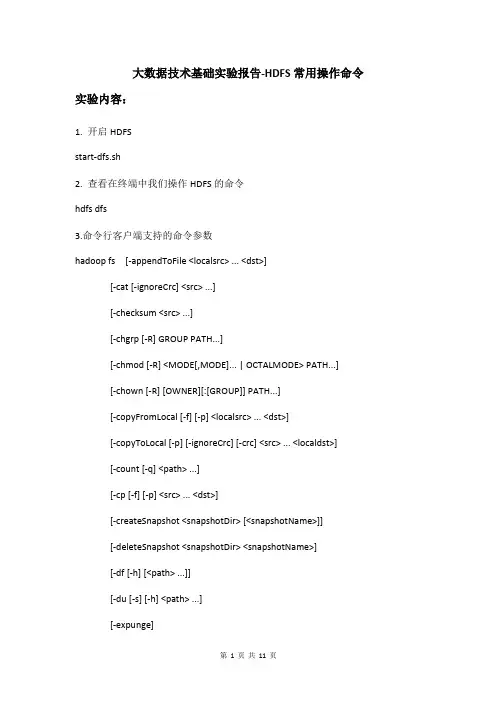
大数据技术基础实验报告-HDFS常用操作命令实验内容:1. 开启HDFSstart-dfs.sh2. 查看在终端中我们操作HDFS的命令hdfs dfs3.命令行客户端支持的命令参数hadoop fs [-appendToFile <localsrc> ... <dst>][-cat [-ignoreCrc] <src> ...][-checksum <src> ...][-chgrp [-R] GROUP PATH...][-chmod [-R] <MODE[,MODE]... | OCTALMODE> PATH...][-chown [-R] [OWNER][:[GROUP]] PATH...][-copyFromLocal [-f] [-p] <localsrc> ... <dst>][-copyToLocal [-p] [-ignoreCrc] [-crc] <src> ... <localdst>][-count [-q] <path> ...][-cp [-f] [-p] <src> ... <dst>][-createSnapshot <snapshotDir> [<snapshotName>]][-deleteSnapshot <snapshotDir> <snapshotName>][-df [-h] [<path> ...]][-du [-s] [-h] <path> ...][-expunge][-get [-p] [-ignoreCrc] [-crc] <src> ... <localdst>][-getfacl [-R] <path>][-getmerge [-nl] <src> <localdst>][-help [cmd ...]][-ls [-d] [-h] [-R] [<path> ...]][-mkdir [-p] <path> ...][-moveFromLocal <localsrc> ... <dst>][-moveToLocal <src> <localdst>][-mv <src> ... <dst>][-put [-f] [-p] <localsrc> ... <dst>][-renameSnapshot <snapshotDir> <oldName> <newName>][-rm [-f] [-r|-R] [-skipTrash] <src> ...][-rmdir [--ignore-fail-on-non-empty] <dir> ...][-setfacl [-R] [{-b|-k} {-m|-x <acl_spec>} <path>]|[--set <acl_spec> <path>]] [-setrep [-R] [-w] <rep> <path> ...][-stat [format] <path> ...][-tail [-f] <file>][-test -[defsz] <path>][-text [-ignoreCrc] <src> ...][-touchz <path> ...][-usage [cmd ...]]图中显示很多命令选项信息,以上截图补全,下面的表格能够完整的列出了支持的命令选项。
hdfs常用的shell命令

hdfs常用的shell命令HDFS是Hadoop的分布式文件系统,它是在大规模集群上存储大数据的最佳选择。
像任何其他文件系统一样,HDFS也提供用于管理文件和目录的shell命令。
在这篇文章中,我们将确切地看到一些常用的HDFS shell命令以及它们应如何使用。
1. 创建目录在HDFS中创建目录是一个非常简单的过程。
为此,您需要使用`mkdir`命令,其语法如下:```hdfs dfs -mkdir <directory path>```在上述命令中,“-mkdir”指定创建目录的命令,“directory path”是带有一个HDFS路径的目录的名称。
例如,如果要在HDFS中创建一个名为“newdir”的新目录,则运行以下命令:```hdfs dfs -mkdir /newdir```2. 上传文件上传本地文件到HDFS非常容易。
为此,您需要使用`put`命令,其语法如下:```hdfs dfs -put <local file> <directory path>```在上述命令中,“-put”指定上传文件的命令,“local file”是本地文件的名称和位置,“directory path”是目标HDFS目录的名称和路径。
例如,要将本地文件“localfile.txt”上传到HDFS目录“/remotedir”,请运行以下命令:```hdfs dfs -put localfile.txt /remotedir```3. 下载文件从HDFS下载文件也很容易。
为此,您需要使用`get`命令,其语法如下:```hdfs dfs -get <hdfs file> <local directory>```在上述命令中,“-get”指定下载文件的命令,“hdfs file”是要下载的文件的路径和名称,“local directory”是在本地系统上保存文件的目录。
hdfs合并小文件命令

hdfs合并小文件命令
HDFS中的小文件会占用过多的NameNode内存,因此需要合并小文件以减轻NameNode的负担。
以下是HDFS合并小文件的常用命令:
使用Hadoop自带的FileMerge工具:
lua
Copy code
hadoop jar /path/to/hadoop/share/hadoop/tools/lib/hadoop-streaming.jar \
-Dmapreduce.job.reduces=1 \
="FileMerge: merge small files" \
-input /path/to/small/files \
-output /path/to/output/file
其中,/path/to/hadoop/share/hadoop/tools/lib/hadoop-streaming.jar是Hadoop自带的文件合并工具路径,/path/to/small/files是需要合并的小文件路径,/path/to/output/file是合并后的输出文件路径。
使用HDFS的getmerge命令:
lua
Copy code
hdfs dfs -getmerge /path/to/small/files /path/to/output/file
其中,/path/to/small/files是需要合并的小文件路径,/path/to/output/file是合并后的输出文件路径。
需要注意的是,在使用这些命令合并小文件时,如果小文件数量过多或文件较大,可能会导致任务执行时间过长或任务失败。
因此,需要根据实际情况进行调整。
Hadoop核心概念及入门
Hadoop核⼼概念及⼊门HadoopHadoop背景什么是HADOOPHADOOP是apache旗下的⼀套开源软件平台HADOOP提供利⽤服务器集群,根据⽤户的⾃定义业务逻辑,对海量数据进⾏分布式处理,HADOOP的核⼼组件有:HDFS(分布式⽂件系统)、YARN(运算资源调度系统)、MAPREDUCE(分布式运算编程框架),⼴义上来说,HADOOP通常是指⼀个更⼴泛的概念——HADOOP⽣态圈HADOOP产⽣背景HADOOP最早起源于Nutch。
Nutch的设计⽬标是构建⼀个⼤型的全⽹搜索引擎,包括⽹页抓取、索引、查询等功能,但随着抓取⽹页数量的增加,遇到了严重的可扩展性问题——如何解决数⼗亿⽹页的存储和索引问题。
2003年、2004年⾕歌发表的两篇论⽂为该问题提供了可⾏的解决⽅案。
——分布式⽂件系统(GFS),可⽤于处理海量⽹页的存储——分布式计算框架MAPREDUCE,可⽤于处理海量⽹页的索引计算问题。
Nutch的开发⼈员完成了相应的开源实现HDFS和MAPREDUCE,并从Nutch中剥离成为独⽴项⽬HADOOP,到2008年1⽉,HADOOP成为Apache顶级项⽬,迎来了它的快速发展期。
HADOOP在⼤数据、云计算中的位置和关系云计算是分布式计算、并⾏计算、⽹格计算、多核计算、⽹络存储、虚拟化、负载均衡等传统计算机技术和互联⽹技术融合发展的产物。
借助IaaS(基础设施即服务)、PaaS(平台即服务)、SaaS(软件即服务)等业务模式,把强⼤的计算能⼒提供给终端⽤户。
现阶段,云计算的两⼤底层⽀撑技术为“虚拟化”和“⼤数据技术”⽽HADOOP则是云计算的PaaS层的解决⽅案之⼀,并不等同于PaaS,更不等同于云计算本⾝。
HADOOP⽣态圈以及各组成部分的简介HDFS:分布式⽂件系统MAPREDUCE:分布式运算程序开发框架HIVE:基于⼤数据技术(⽂件系统+运算框架)的SQL数据仓库⼯具HBASE:基于HADOOP的分布式海量数据库ZOOKEEPER:分布式协调服务基础组件Mahout:基于mapreduce/spark/flink等分布式运算框架的机器学习算法库Oozie:⼯作流调度框架Sqoop:数据导⼊导出⼯具Flume:⽇志数据采集框架分布式系统概述注:由于⼤数据技术领域的各类技术框架基本上都是分布式系统,因此,理解hadoop、storm、spark等技术框架,都需要具备基本的分布式系统概念什么是分布式分布式系统是由⼀组通过⽹络进⾏通信、为了完成共同的任务⽽协调⼯作的计算机节点组成的系统。
实验4 HDFS常用操作
实验报告封面课程名称: Hadoop大数据处理课程代码: JY1124任课老师:陈宁穗实验指导老师: 陈宁穗实验报告名称:实验4 HDFS常用操作学生姓名:学号:教学班:递交日期:签收人:我申明,本报告内的实验已按要求完成,报告完全是由我个人完成,并没有抄袭行为。
我已经保留了这份实验报告的副本。
申明人(签名):实验报告评语与评分:评阅老师签名:一、实验名称:HDFS常用操作二、实验日期:2015年10 月9 日三、实验目的:熟悉HDFS常用命令操作。
四、实验用的仪器和材料:硬件:PC电脑一台;配置:内存,4G及以上硬盘250G及以上软件环境:操作系统XP,vmware,ubuntu,jdk,hadoop五、实验的步骤和方法:请用命令完成以下操作1、启动hadoop,通过jps命令查看启动进程,通过web方式查看namenode和jobtracker2、通过ls命令查看hadoop下tmp目录中的文件,包括dfs目录和mapred目录3、进入hadoop-1.2.1目录,执行命令:hadoop fs –ls / 列出HDFS上的文件4、在HDFS上 /user下创建一个你自己拼音名字的目录5、退出hadoop-1.2.1目录,回到本地系统,创建一个test目录,进入test目录,执行echo “hello world” >test1.txt 命令创建test1.txt文件,并输入hello world内容。
6、继续回到hadoop-1.2.1目录下,将刚才在本地创建的test1.txt上传(put)到HDFS 下你名字的目录下。
7、查看HDFS下刚才上传的文件的内容8、退出hadoop-1.2.1目录,回到本地系统,彻底删除test目录(rm –rf test).9、回到hadoop-1.2.1目录下,将HDFS上的test1.txt文件下载到本地系统(/home/grid/)并查看10、在HDFS上删除test1.txt文件。
hdfs 压缩 命令参数
hdfs 压缩命令参数
HDFS(Hadoop分布式文件系统)是一个用于存储大规模数据的
分布式文件系统,压缩命令参数用于在HDFS中对文件进行压缩操作。
在HDFS中,可以使用以下命令参数来进行压缩操作:
1. `-D`,这是Hadoop命令行工具中的一个通用参数,用于设
置Hadoop配置属性。
可以使用`-D`参数来设置压缩相关的属性,比
如压缩编解码器、压缩类型等。
2. `-text`,这个参数用于查看HDFS中的文本文件内容,如果
文件已经被压缩,使用`-text`参数可以在不解压的情况下查看文件
内容。
3. `-copyFromLocal`,当将本地文件复制到HDFS时,可以使
用`-copyFromLocal`参数,并结合其他压缩参数来指定要使用的压
缩编解码器和压缩类型。
4. `-copyToLocal`,与`-copyFromLocal`相对应,当从HDFS
复制文件到本地时,也可以使用压缩参数来指定压缩编解码器和压
缩类型。
5. `press=true`,这个参数可以
在执行MapReduce作业时启用中间结果的压缩,以减少网络传输开
销和磁盘空间占用。
6. `press=true`,这个参数可以在执行MapReduce作业时启用输出结果的压缩,以减
少存储空间占用。
总的来说,HDFS压缩命令参数可以通过设置Hadoop配置属性
和使用特定的命令来实现对文件的压缩操作,以节省存储空间和提
高数据传输效率。
在使用这些参数时,需要根据具体的场景和需求
选择合适的压缩编解码器和压缩类型,以达到最佳的压缩效果。
hadoop安装配置指南
Hadoop安装、配置指南一、环境1、软件版本Hadoop:hadoop-0.20.2.Hive:hive-0.5.0JDK:jdk1.6以上版本2、配置的机器:主机[服务器master]:192.168.10.121 hadoop13从机[服务器slaves]:192.168.10.68 hadoop4在本文中,在命令或二、先决条件1、配置host:打开/etc/host文件,添加如下映射192.168.10.121 hadoop13 hadoop13192.168.10.68 hadoop4 hadoop42、配置SSH自动登陆1)以ROOT用户,登陆到[服务器master]上执行,如下操作:ssh-keygen -t rsa //一路回车cd ~/.sshcat id_rsa.pub >> authorized_keysscp -r ~/.ssh [服务器slaves]:~/2)以ROOT用户,登陆到[服务器slaves]上执行,如下操作:scp -r ~/.ssh [服务器master]:~/3)测试SSH是否配置成功在主服务器中执行如下命令:ssh [服务器master]ssh 192.168.10.68成功显示结果:Last login: Thu Aug 26 14:11:27 2010 from 在从服务器中执行如下命令:ssh [服务器slaves]ssh 192.168.10.121成功显示结果Last login: Thu Aug 26 18:23:58 2010 from 三、安装hadoop1、JDK安装,解压到/usr/local/jdk1.6.0_17,并配置/etc/profile环境export JAVA_HOME=/usr/local/jdk/jdk1.7.0export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre:$PATHexport CLASSPATH=$JAVA_HOME/lib:$JAVA_HOME/lib/tools.jarJDK路径:/usr/local/jdk/jdk1.7.0export JAVA_HOME=/usr/local/jdk/jdk1.7.0export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre:$PATHexport CLASSPATH=$JAVA_HOME/lib:$JAVA_HOME/lib/tools.jar/usr/local/jdk/jdk1.7.02、下载Hadoop 并解压到[服务器master]的/root/zwmhadoop目录下tar zxvf hadoop-0.20.2.tar.gz四、配置hadoop1.配置主机[服务器master]到zwm hadoop/hadoop-0.20.2/ hadoop 目录下,修改以下文件:1)配置conf/hadoop-env.sh文件,在文件中添加环境变量,增加以下内容:export JAVA_HOME=/usr/local/jdk1.6.0_17export HADOOP_HOME=/root/zwmhadoop/hadoop-0.20.2/2)配置conf/core-site.xml文件,增加以下内容<?xml version="1.0"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?><!-- Put site-specific property overrides in this file. --><configuration><property><name></name><value>hdfs://192.168.10.121:9000</value>//你的namenode的配置,机器名加端口<description>The nam e of the default file system. Either the literal string "local" o r a host:port for DFS.</description></property></configuration>3)配置conf/hdfs-site.xml文件,增加以下内容<?xml version="1.0"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?><!-- Put site-specific property overrides in this file. --><configuration><property><name>hadoop.t m p.dir</name><value>/root/zwmhadoop/t m p</value>//Hadoop的默认临时路径,这个最好配置,然后在新增节点或者其他情况下莫名其妙的DataNode启动不了,就删除此文件中的t mp目录即可。