
编译原理第三版课后答案
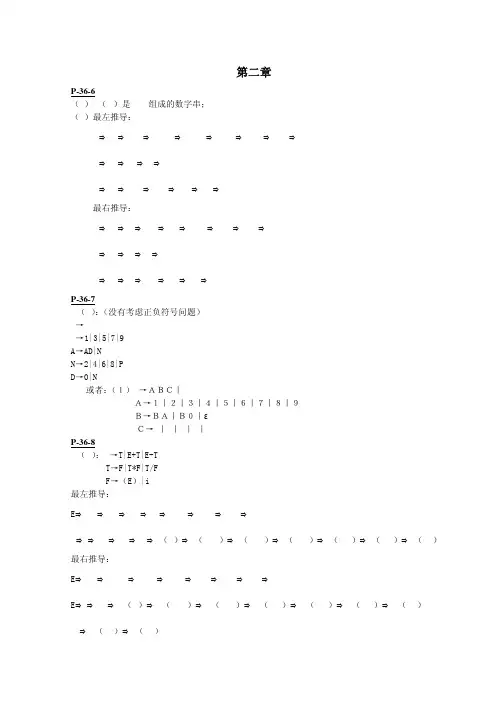
编译原理课后题答案第二章P36-6(1)L G()1是0~9组成的数字串(2)最左推导:最右推导:P36-7G(S)P36-8文法:最左推导:最右推导:语法树:/*************************************************/P36-9句子iiiei有两个语法树:P36-10/*****************************/P36-11/***************L1:L2:L3:L4:***************/第三章习题参考答案P64–7(1)最小化:P64–8(1) (2) (3)P64–12(a)aa,b a 0给状态编号:aaa b b b最小化:a ab ba b (b)已经确定化了,进行最小化最小化:P64–14(1) 01 0 (2):(|)*0101εε0 00 YY最小化: 01 1 1 0 0第四章P81–1(1) 按照T,S 的顺序消除左递归 递归子程序: procedure S; beginif sym='a' or sym='^' then abvance else if sym='(' then begin advance;T;if sym=')' then advance; else error; end else error end;procedure T; begin S; T end;procedure 'T;beginif sym=','then beginadvance;S;'Tendend;其中:sym:是输入串指针IP所指的符号advance:是把IP调至下一个输入符号error:是出错诊察程序(2)FIRST(S)={a,^,(}FIRST(T)={a,^,(}FIRST('T)={,,ε}FOLLOW(S)={),,,#}FOLLOW(T)={)}FOLLOW('T)={)}预测分析表是LL(1)文法P81–2文法:(1)FIRST(E)={(,a,b,^}FIRST(E')={+,ε}FIRST(T)={(,a,b,^}FIRST(T')={(,a,b,^,ε}FIRST(F)={(,a,b,^}FIRST(F')={*,ε}FIRST(P)={(,a,b,^}FOLLOW(E)={#,)}FOLLOW(E')={#,)}FOLLOW(T)={+,),#}FOLLOW(T')={+,),#}FOLLOW(F)={(,a,b,^,+,),#} FOLLOW(F')={(,a,b,^,+,),#} FOLLOW(P)={*,(,a,b,^,+,),#} (2)考虑下列产生式:FIRST(+E)∩FIRST(ε)={+}∩{ε}=φFIRST(+E)∩FOLLOW(E')={+}∩{#,)}=φFIRST(T)∩FIRST(ε)={(,a,b,^}∩{ε}=φFIRST(T)∩FOLLOW(T')={(,a,b,^}∩{+,),#}=φFIRST(*F')∩FIRST(ε)={*}∩{ε}=φFIRST(*F')∩FOLLOW(F')={*}∩{(,a,b,^,+,),#}=φFIRST((E))∩FIRST(a) ∩FIRST(b) ∩FIRST(^)=φ所以,该文法式LL(1)文法.(3)(4)procedure E;beginif sym='(' or sym='a' or sym='b' or sym='^' then begin T; E' endelse errorendprocedure E';beginif sym='+'then begin advance; E endelse if sym<>')' and sym<>'#' then error endprocedure T;beginif sym='(' or sym='a' or sym='b' or sym='^' then begin F; T' endelse errorendprocedure T';beginif sym='(' or sym='a' or sym='b' or sym='^' then Telse if sym='*' then errorendprocedure F;beginif sym='(' or sym='a' or sym='b' or sym='^' then begin P; F' endelse errorendprocedure F';beginif sym='*'then begin advance; F' endendprocedure P;beginif sym='a' or sym='b' or sym='^'then advanceelse if sym='(' thenbeginadvance; E;if sym=')' then advanceelse errorendelse errorend;P81–3/***************(1)是,满足三个条件。
(2)不是,对于A不满足条件3。
(3)不是,A、B均不满足条件3。
(4)是,满足三个条件。
***************/第五章P133–1短语: E+T*F, T*F,直接短语: T*F句柄: T*FP133–2文法:(1)最左推导:最右推导:(2)(((a,a),^,(a)),a)(((S,a),^,(a)),a)(((T,a),^,(a)),a)(((T,S),^,(a)),a)(((T),^,(a)),a)((S,^,(a)),a)((T,^,(a)),a)((T,S,(a)),a)((T,(a)),a)((T,(S)),a)((T,(T)),a)((T,S),a)((T),a)(S,a)(T,S)(T)S“移进-归约”过程:步骤栈输入串动作0 # (((a,a),^,(a)),a)# 预备1 #( ((a,a),^,(a)),a)# 进2 #(( (a,a),^,(a)),a)# 进3 #((( a,a),^,(a)),a)# 进4 #(((a ,a),^,(a)),a)# 进5 #(((S ,a),^,(a)),a)# 归6 #(((T ,a),^,(a)),a)# 归7 #(((T, a),^,(a)),a)# 进8 #(((T,a ),^,(a)),a)# 进9 #(((T,S ),^,(a)),a)# 归10 #(((T ),^,(a)),a)# 归11 #(((T) ,^,(a)),a)# 进12 #((S ,^,(a)),a)# 归13 #((T ,^,(a)),a)# 归14 #((T, ^,(a)),a)# 进15 #((T,^ ,(a)),a)# 进16 #((T,S ,(a)),a)# 归17 #((T ,(a)),a)# 归18 #((T, (a)),a)# 进19 #((T,( a)),a)# 进20 #((T,(a )),a)# 进21 #((T,(S )),a)# 归22 #((T,(T )),a)# 归23 #((T,(T) ),a)# 进24 #((T,S ),a)# 归25 #((T ),a)# 归26 #((T) ,a)# 进27 #(S ,a)# 归28 #(T ,a)# 归29 #(T, a)# 进30 #(T,a )# 进31 #(T,S )# 归32 #(T )# 归33 #(T) # 进34 #S # 归P133–3(1)FIRSTVT(S)={a,^,(}FIRSTVT(T)={,,a,^,(}LASTVT(S)={a,^,)}LASTVT(T)={,,a,^,)}G是算符文法,并且是算符优先文法6(4)栈输入字符串动作# (a,(a,a))# 预备#( a, (a,a))# 进#(a , (a,a))# 进#(t , (a,a))# 归#(t, (a,a))# 进#(t,(a,a))# 进#(t,(a ,a))# 进#(t,(t ,a))# 归#(t,(t, a))# 进#(t,(t,a ))# 进#(t,(t,s ))# 归#(t,(t ))# 归#(t,(t ) )# 进 #(t,s )# 归 #(t )# 归 #(t ) # 进 # s#归successP134–5(1)0.'→⋅S S 1.'→⋅S S 2.S AS →⋅ 3.S A S →⋅ 4.S AS →⋅ 5.S b →⋅ 6.S b →⋅ 7.A SA →⋅ 8.A S A →⋅ 9.A SA →⋅ 10.A a →⋅ 11.A a →⋅ (2)ba ab b a构造LR(0)项目集规范族也可以用GO 函数来计算得到。
所得到的项目集规范族与上图中的项目集一样:0I ={'→⋅S S ,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}GO(0I ,a)={ A a →⋅}=1IGO(0I ,b)={ S b →⋅}=2IGO(0I ,S)={ '→⋅S S ,A S A →⋅,A SA →⋅,A a →⋅,S AS →⋅,S b →⋅}=3I GO(0I ,A)={ S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=4IGO(3I ,a)={ A a →⋅}=1IGO(3I ,b)={ S b →⋅}=2IGO(3I ,S)={ A S A →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=5IGO(3I ,A)={ A SA →⋅,S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=6I GO(4I ,a)={ A a →⋅}=1IGO(4I ,b)={ S b →⋅}=2IGO(4I ,S)={ S AS →⋅,A S A →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=7I GO(4I ,A)={ S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=4IGO(5I ,a)={ A a →⋅}=1IGO(5I ,b)={ S b →⋅}=2IGO(5I ,S)={ A S A →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=5IGO(5I ,A)={ A SA →⋅,S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=6I GO(6I ,a)={ A a →⋅}=1IGO(6I ,b)={ S b →⋅}=2IGO(6I ,S)={ S AS →⋅,A S A →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=7I GO(6I ,A)={ S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=4IGO(7I ,a)={ A a →⋅}=1IGO(7I ,b)={ S b →⋅}=2IGO(7I ,S)={ A S A →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=5IGO(7I ,A)={ A SA →⋅,S A S →⋅,S AS →⋅,S b →⋅,A SA →⋅,A a →⋅}=6I 项目集规范族为C={1I ,2I ,3I ,4I ,5I ,6I ,7I }(3)不是SLR 文法状态3,6,7有移进归约冲突状态3:FOLLOW(S’)={#}不包含a,b状态6:FOLLOW(S)={#,a,b}包含a,b,;移进归约冲突无法消解状态7:FOLLOW(A)={a,b}包含a,b ;移进归约冲突消解所以不是SLR 文法。
编译原理第三版何炎祥第四章习题答案

FOLLOW(T’)=FOLLOW(T)={+,),$}
FOLLOW(F)=FIRST(T’)={(,a,^,ε}
FOLLOW(F’)=FOLLOW(F)={(,a,^,ε}
FOLLOW(P)=FIRST(F’)={*,ε}
(3)
+Leabharlann ε*()
a
^
$
E
E→TE’
E→TE’
SELECT(T’→T)={(,a,^}∩SELECT(T’→ε)={+,ε,),$}=∅
SELECT(F’→*F)={*}∩SELECT(F’→ε)={+,ε,(,),a,^,$}=∅
SELECT(P→(E))={(}∩SELECT(P→a)={a}∩SELECT(P→^)={^}=∅
所以该文法是LL(1)文法。
所以M[B,a]=’B→Sb’
对于产生式A→Bc
FIRST(B)={a}
所以M[A,a]=’A→Bc’
得出LL(1)分析表为:(空白处为ERROR)
a
b
c
$
S
S→aA{bA}
B
B→Sb
A
A→Bc
5.4
(1)S→SbA|aA存在左递归,消除左递归后改写为S→aA{bA}
则文法G[S]:
S→aA{bA}
B→Sb
A→Bc
该文法满足LL(1)文法条件。
(2)对于产生式S→aA{bA}
FIRST(aA{bA})={a}
所以M[S,a]=’S→aA{bA}’
对于产生式B→Sb
FIRST(Sb)={a}
FIRST(F)=FIRST(P)={(,a,^}
程序设计语言编译原理第三版答案

程序设计语言编译原理第三版答案【篇一:西北工业大学版(蒋立源第三版)编译原理课后习题答案】解:源程序是指以某种程序设计语言所编写的程序。
目标程序是指编译程序(或解释程序)将源程序处理加工而得的另一种语言(目标语言)的程序。
翻译程序是将某种语言翻译成另一种语言的程序的统称。
编译程序与解释程序均为翻译程序,但二者工作方法不同。
解释程序的特点是并不先将高级语言程序全部翻译成机器代码,而是每读入一条高级语言程序语句,就用解释程序将其翻译成一段机器指令并执行之,然后再读入下一条语句继续进行解释、执行,如此反复。
即边解释边执行,翻译所得的指令序列并不保存。
编译程序的特点是先将高级语言程序翻译成机器语言程序,将其保存到指定的空间中,在用户需要时再执行之。
即先翻译、后执行。
2解:一般说来,编译程序主要由词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、代码优化程序、目标代码生成程序、信息表管理程序、错误检查处理程序组成。
3解:c语言的关键字有:auto break case char constcontinue default do double else enum extern float for goto if int long register return short signed sizeof static struct switch typedef union unsigned void volatile while。
上述关键字在c语言中均为保留字。
4解:c语言中括号有三种:{},[],()。
其中,{}用于语句括号;[]用于数组;()用于函数(定义与调用)及表达式运算(改变运算顺序)。
c语言中无end关键字。
逗号在c语言中被视为分隔符和运算符,作为优先级最低的运算符,运算结果为逗号表达式最右侧子表达式的值(如:(a,b,c,d)的值为d)。
5略第二章习题解答1.(1)答:26*26=676(2)答:26*10=260(3)答:{a,b,c,...,z,a0,a1,...,a9,aa,...,az,...,zz,a00,a01,...,zzz},共26+26*36+26*36*36=34658个2.构造产生下列语言的文法(1){anbn|n≥0}(2){anbmcp|n,m,p≥0}(3){an # bn|n≥0}∪{cn # dn|n≥0}解:对应文法为g(s) = ({s,x,y},{a,b,c,d,#}, {s→x,s→y,x→axb|#,y→cyd|# },s)(4){w#wr# | w?{0,1}*,wr是w的逆序排列}解:g(s) = ({s,w,r},{0,1,#}, {s→w#, w→0w0|1w1|# },s)(5)任何不是以0打头的所有奇整数所组成的集合(6)所有偶数个0和偶数个1所组成的符号串集合解:对应文法为s→0a|1b|e,a→0s|1c b→0c|1s c→1a|0b3.描述语言特点(1)s→10s0s→aaa→baa→a解:本文法构成的语言集为:l(g)={(10)nabma0n|n, m≥0}。
编译原理(第三版)答案
给状态编号:
a {0,1} {0,1} {0}
Φ
5
b {1} {1} Φ Φ
a
B
0
1
2
3
3
3
3
4
a
a
0
1
a
b
b
b
b
2
3
a
最小化: {0,1} {2,3} {0,1}a={1},{0,1}b={2} {2,3}a={0,3},{2,3}={3} {0,1},{2},{3}
a
a
b b
0
1
2
E'→+E|ε: First(E') = {+,ε}∩Follow(E')={#,)} = Φ
T'→T|ε: First(T') = {(,a,b, ⋀, ε} ∩Follow(T')={+,),#} = Φ
F'→*F'|ε:First(F') = {*,ε}∩Follow(F')={ (,a,b,⋀,),# } = Φ
then advance else if sym=‘(’
then begin advance;T; if sym = ‘)’ then advance; else error;
end else error end
第四章
procedure T; begin
S;T' End
Procedure T';
Begin
P-36-8 G(E):E→T|E+T|E-T
T→F|T*F|T/F F→(E)|i 最左推导:
E⇒E+T⇒T+T⇒F+T⇒i+T⇒i+T*F⇒i+F*F⇒i+i*F⇒i+i*i
蒋立源编译原理第三版第三章习题与答案(修改后)
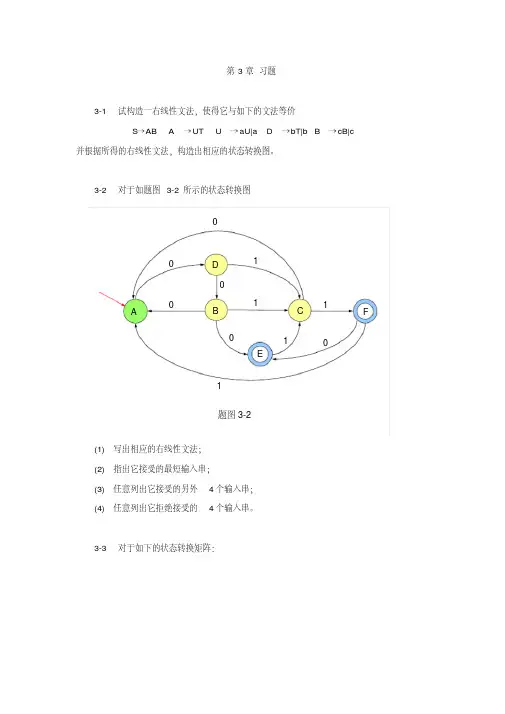
3-1 试构造一右线性文法,使得它与如下的文法等价 S→AB A → UT U → aU|a D →bT|b B → cB|c
并根据所得的右线性文法,构造出相应的状态转换图。
3-2 对于如题图 3-2 所示的状态转换图 0
0 0 A
D
1
0 1
B
C1
F
0
1
0
E
1 题图 3-2
(1) 写出相应的右线性文法; (2) 指出它接受的最短输入串; (3) 任意列出它接受的另外 4 个输入串; (4) 任意列出它拒绝接受的 4 个输入串。
但
{1}
b=
故 1 和 2 可区分,于是便得到下一分划
π1: {1}, {2}, {3}
此时子集已全部分裂,故最小化的过程宣告结束, M′即为状态数最小的 DFA。
(3) 将 NFA M确定化后得 DFA M′,其状态转换矩阵如答案图 3-4-(3) 之 (a) 所示, 给各状态重新命名,即令:
[S]=1, [A]=2, [S,B]=3 且由于 3 的组成中含有 M的终态 B,故 3 为 DFAM′的终态。于是,所构造之 DFAM′的 状态转换矩阵和状态转换图如答案图 3-4-(3) 之(b) 及(c) 所示。
π0:{1,2}, {3}
( ⅱ) 为得到下一分划,考察子集 {1,2} 。因为
{2} b ={3}
但
{1}
b=
故 1 和 2 可区分,于是便得到下一分划
π1: {1}, {2}, {3}
此时子集已全部分裂,故最小化的过程宣告结束, M′即为状态数最小的 DFA。
(4) 将 NFA M确定化后得 DFA M′,其状态转换矩阵如答案图 3-4-(4) 之 (a) 所示, 给各状态重新命名,即令:
编译原理第三版答案

编译原理(第三版)答案《编译原理(第三版)》答案概念:1.编译器是一种程序,它把某种语言写的源程序翻译成另一种语言写的目标程序。
2.编译器的编写是一项复杂而耗时的任务,因为它必须处理语法和语义分析等复杂的编程语言概念。
3.编译器通常分为六个主要阶段:词法分析、语法分析、语义分析、中间代码生成、代码优化、代码生成。
4.词法分析是将源代码转换为令牌序列的过程,这些令牌构成了源代码的抽象语法树(AST)的节点。
5.语法分析是将令牌序列转换为抽象语法树的过程,这个抽象语法树表示了源代码的结构。
6.语义分析是检查源代码是否符合语言的规则,并收集类型信息的过程。
7.中间代码生成是将抽象语法树转换为中间代码的过程,这个中间代码可以在进行进一步优化和代码生成时更容易处理。
8.代码优化是优化中间代码以改进目标代码性能的过程。
9.代码生成是将中间代码转换为目标代码的过程。
10.编译器通常使用特定的数据结构和算法来处理编译的不同阶段,例如优先级队列用于语法分析,哈希表用于语义分析等。
习题答案:1.什么是编译器?它的主要功能是什么?编译器是一种程序,它把某种编程语言写的源程序翻译成另一种编程语言写的目标程序。
主要功能包括词法分析、语法分析、语义分析、中间代码生成、代码优化和代码生成。
2.编译器的基本组成部分是什么?编译器的基本组成部分包括词法分析器、语法分析器、语义分析器、中间代码生成器、优化器和代码生成器。
3.什么是编译器的中间表示?它有哪些形式?编译器的中间表示是编译器在源代码和目标代码之间的一个抽象级别,也被称作中间代码。
它可以是三地址码、抽象语法树或其他形式。
其中三地址码是最常见的中间表示形式之一,它是一种易于理解和处理的中间语言。
4.编译器的优化主要有哪些类型?编译器的优化主要可以分为两种类型:存储优化和执行效率优化。
存储优化主要关注如何减少目标代码的存储空间,而执行效率优化则关注如何提高目标代码的执行效率。
编译原理第三版课后习题解答
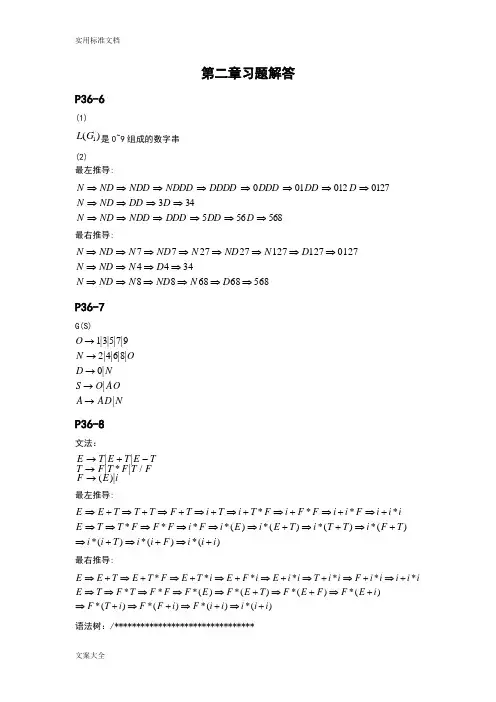
第二章习题解答P36-6(1)L G ()1是0~9组成的数字串(2)最左推导:5685653430127012010⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒D DD DDD NDD ND N D DD ND N D DD DDD DDDD NDDD NDD ND N最右推导:N ND N ND N ND N D N ND N D N ND N ND N D ⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒⇒77272712712701274434886868568P36-7G(S)O N O D N S O AO A AD N→→→→→1357924680|||||||||||P36-8文法:E T E T E T TF T F T F F E i→+-→→|||*|/()| 最左推导:E E T T TF T i T i T F i F F i i F i i i E T T F F F i F i E i E T i T T i F T i i T i i F i i i ⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒⇒⇒⇒⇒⇒+⇒+⇒+⇒+⇒+⇒+********()*()*()*()*()*()*()最右推导:E E T E TF E T i E F i E i i T i i F i i i i i E T F T F F F E F E T F E F F E i F T i F F i F i i i i i ⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒+⇒⇒⇒⇒⇒+⇒+⇒+⇒+⇒+⇒+⇒+**********()*()*()*()*()*()*()*()语法树:/********************************EE FTE +T F F T +iiiEEFTE-T F F T -iiiE EFT+T F FTiii*i+i+ii-i-ii+i*i*****************/P36-9句子iiiei 有两个语法树:S iSeS iSei iiSei iiiei S iS iiSeS iiSei iiiei ⇒⇒⇒⇒⇒⇒⇒⇒P36-10/**************)(|)(|S T TTS S →→***************/P36-11/*************** L1:ε||cC C ab aAb A AC S →→→ L2:bcbBc B aA A AB S ||→→→εL3:εε||aBb B aAb A AB S →→→ L4:AB B A A B A S |01|10|→→→ε ***************/第三章习题参考答案P64–7(1)101101(|)*1 ε ε 1 0 11 确定化:0 1 {X} φ {1,2,3} φ φ φ {1,2,3} {2,3} {2,3,4} {2,3} {2,3} {2,3,4} {2,3,4} {2,3,5} {2,3,4}{2,3,5} {2,3} {2,3,4,Y} {2,3,4,Y}{2,3,5}{2,3,4,}1 00 0 1 1 00 1 0 1 1 1 最小化:X 1 2 3 4 Y5 XY60 12 35 4{,,,,,},{}{,,,,,}{,,}{,,,,,}{,,,}{,,,,},{},{}{,,,,}{,,}{,,,},{},{},{}{,,,}{,012345601234513501234512460123456012341350123456012310100==== 3012312401234560110112233234012345610101}{,,,}{,,}{,},{,}{},{},{}{,}{}{,}{,}{,}{}{,}{}{},{},{,},{},{},{}===== 010 0 1 00 1 0 1 1 1P64–8(1)01)0|1(*(2))5|0(|)5|0()9|8|7|6|5|4|3|2|1|0)(9|8|7|6|5|4|3|2|1(*(3)******)110|0(01|)110|0(10P64–12(a)aa,b a确定化:a b {0} {0,1} {1} {0,1} {0,1} {1} {1}{0}φ5 01 2 4 3 01φφ φ给状态编号:a b 0 1 2 1 1 2 2 0 3 333aaa b b bba最小化:{,},{,}{,}{}{,}{}{,}{,}{,}{}{,},{},{}012301101223032330123a ba b ====a ab bab (b)b b aa baa bb aa a已经确定化了,进行最小化0 1 2 3 01 2 0 2 3 14 5最小化:{{,}, {,,,}}012345011012423451305234523452410243535353524012435011012424{,}{}{,}{,}{,,,}{,,,}{,,,}{,,,}{,}{,}{,}{,}{,}{,}{,}{,}{{,},{,},{,}}{,}{}{,}{,}{,}a b a b a b a b a b a =============={,}{,}{,}{,}{,}{,}{,}10243535353524 b a bb b aa baP64–14(1) 01 0 (2):(|)*0100 1 ε ε确定化:0 1 {X,1,Y}{1,Y}{2}0 1 2 01YX YX2 1{1,Y} {1,Y} {2} {2} {1,Y} φ φφ φ 给状态编号:0 1 0 1 2 1 1 2 2 1 3 3330 1 01 1 10 最小化:{,},{,}{,}{}{,}{}{,}{,}{,}{}{,},{},{}0123011012231323301230101====1 1 1 0第四章P81–1(1) 按照T,S 的顺序消除左递归ε|,)(||^)(T S T TS T T a S S G '→''→→' 递归子程序: procedure S; beginif sym='a' or sym='^' then abvance else if sym='('0 2 13 01 3then begin advance;T;if sym=')' then advance; else error; end else error end;procedure T; begin S;'T end;procedure 'T ; beginif sym=',' then begin advance; S;'T end end; 其中:sym:是输入串指针IP 所指的符号 advance:是把IP 调至下一个输入符号 error:是出错诊察程序 (2)FIRST(S)={a,^,(} FIRST(T)={a,^,(} FIRST('T )={,,ε} FOLLOW(S)={),,,#} FOLLOW(T)={)} FOLLOW('T )={)} 预测分析表a^() , # S S a →S →^S T →()TT ST →' T ST →' T ST →''T'→T ε '→'T ST ,是LL(1)文法P81–2文法:|^||)(|*||b a E P F F F P F T T T F T E E E T E →'→''→→''→+→''→εεε(1)FIRST(E)={(,a,b,^} FIRST(E')={+,ε} FIRST(T)={(,a,b,^} FIRST(T')={(,a,b,^,ε} FIRST(F)={(,a,b,^} FIRST(F')={*,ε} FIRST(P)={(,a,b,^} FOLLOW(E)={#,)} FOLLOW(E')={#,)} FOLLOW(T)={+,),#} FOLLOW(T')={+,),#}FOLLOW(F)={(,a,b,^,+,),#} FOLLOW(F')={(,a,b,^,+,),#} FOLLOW(P)={*,(,a,b,^,+,),#} (2)考虑下列产生式:'→+'→'→'→E E T T F F P E a b ||*|()|^||εεεFIRST(+E)∩FIRST(ε)={+}∩{ε}=φ FIRST(+E)∩FOLLOW(E')={+}∩{#,)}=φ FIRST(T)∩FIRST(ε)={(,a,b,^}∩{ε}=φ FIRST(T)∩FOLLOW(T')={(,a,b,^}∩{+,),#}=φ FIRST(*F')∩FIRST(ε)={*}∩{ε}=φFIRST(*F')∩FOLLOW(F')={*}∩{(,a,b,^,+,),#}=φ FIRST((E))∩FIRST(a) ∩FIRST(b) ∩FIRST(^)=φ 所以,该文法式LL(1)文法. (3)+ * ( ) a b ^ # EE TE →'E TE →' E TE →' E TE →'E' '→+E E'→E ε'→E εTT F T →'T F T →' T F T →' T F T →'T''→T ε'→T T '→T ε '→T T '→T T '→T T '→T εF F P F →' F P F →' F P F →' F P F →'F' '→F ε '→'F F * '→F ε '→F ε '→F ε '→F ε '→F ε '→F εPP E →() P a → P b → P →^(4)procedure E; beginif sym='(' or sym='a' or sym='b' or sym='^' then begin T; E' end else error endprocedure E'; beginif sym='+'then begin advance; E endelse if sym<>')' and sym<>'#' then error endprocedure T; beginif sym='(' or sym='a' or sym='b' or sym='^' then begin F; T' end else error endprocedure T'; beginif sym='(' or sym='a' or sym='b' or sym='^' then Telse if sym='*' then error endprocedure F; beginif sym='(' or sym='a' or sym='b' or sym='^' then begin P; F' end else error endprocedure F'; beginif sym='*'then begin advance; F' end endprocedure P; beginif sym='a' or sym='b' or sym='^' then advanceelse if sym='(' thenbeginadvance; E;if sym=')' then advance else error endelse errorend;P81–3/***************(1) 是,满足三个条件。
编译原理(第三版)第4章课后练习及参考答案中石大版第4章课后练习及参考答案
第4章练习P72作业布置:P723,7,9,11提示1:判断两个正规式是否相等,应判断两个正规式所产生的正规集是否一样。
完成此项任务需要经过四个阶段:第一,画出正规式的NFA;第二,由NFA变换到DFA;第三,将DFA最小化;第四,画出最小化DFA的有限自动机。
如果要判断的正规式的最小化DFA的有限自动机是一样的,则正规式等价;反之,则不等价。
提示2:构造正规表达式的最小化的DFA方法是:首先,按规则将正规表达式用NFA表示;其次,使用ε-closure(Move())将NFA转变为DFA;最后使用子集法将DFA最小化。
对于这类题目要多做练习,熟能生巧。
3.将下图确定化:解:下表由子集法将NFA 转换为DFA :7、给文法G[S]: S →aA|bQ A →aA|bB|bB →bD|aQ0,10,1Q →aQ|bD|b D →bB|aA E →aB|bFF →bD|aE|b构造相应的最小的DFA 。
解:由于从S 出发任何输入串都不能到达状态E 和F ,所以,状态E ,F 为多余的状态,不予考虑。
这样,可以写出文法G[S]对应的NFA M :NFA M={k, Σ, f, S, Z}K={S, A, B, Q, D, Z} S={S} Z={Z} F(S, a)=A f(S, b)=Q F(A, a)=A f(A, b)=B f(A,b)=ZF(B, b)=D f(B, a)=QF(Q, a)=Q f(Q, b)=D f(Q,b)=Z F(D, b)=B f(D, a)=A NFA M 的状态转换图为:下表由子集法将NFA 转换为DFA :a由上表可知:(1)因为C、D是DFA的终态,其他是非终态,可将状态集分成两个子集:P1={S, A, B, E, F},P2={C, D}。
(2)因为{A, B}b={C, D}为终态,{S, E, F}b={B, E, F}为非终态,所以P1可划分为:P11={S, E, F},P12={A, B}。
编译原理(第三版)第3章课后练习及参考答案中石大版
第3章练习P47作业布置:P47 4 ,9,11,14(1)4、已知文法G[Z]:(1)Z::=aZb (2)Z::=ab写出L(G[Z])的全部元素解:L(G[Z])={a n b n,n>=1}9、考虑下面的上下文无关文法:S→SS* | SS+ | a(1)表明通过此文法如何生成串aa+a*,并为该串构造语法树(2)该文法生成的语言是什么?解:(1)推导过程见语法树。
语法树如下(2)该文法生成的语言为用递归逆波兰式表示的运算式。
逆波兰式是将运算对象写在前面,把运算符写在后面。
11、G[E]:E→T|E+T|E-TT→F|T*F|T/FF → (E)|i证明E+T*F 是它的一个句型,指出这个句型的所有短语、直接短语和句柄。
解:可为E+T*F 构造一棵语法树(见下图),所以它是句型。
从语法树中容易看出,E+T*F 的短语有:T*F 是句型E+T*F 的相对于T 的短语,也是相对于规则T →T*F 的直接短语。
E+T*F 是句型E+T*F 的相对于E 的短语。
句型E+T*F 的句柄(最左直接短语)是T*F 。
14、给出生成下述语言的上下文无关文法:(1){a n b n a m b m |n,m>=0}(2){1n 0m 1m 0n |n,m>=0}(3){WaW r |W 属于{0|a}*,W r 表示W 的逆}解:(1)所求文法为G[S]=({S,A},{a,b},P,S),其中P 为:S →AA A →aAb|ε (2)所求文法为G[S]=({S,A},{0,1},P,S),其中P 为: S →1S0|AA →0A1|ε(3)W 属于{0|a}*是指W 可以的取值为{ε,0,a,00,a0,aa0,00aa,a0a0,…}E E + T T * F如果W=aa0a00,则W r=00a0aa。
所求文法为G[S]=({S,P,Q},{0,a},P,S),其中P为:S 0S0|aSa|a。
蒋立源编译原理第三版第三章习题与答案(修改后)
[S] [A] [S,B]
ab
[A]
[S,B]
2
[A]
初态 : [S] 终态 : [S,B] (a) 确定化后的状态矩阵
ab
1
2
3
3
2
初态 : 1 终态 : 3 (b) 改名后的状态矩阵
a
1
2
b 3
a (c) DFA M ′的状态转换图
答案图 3-4-(3)
现将 DFA M′最小化:
( ⅰ) 初始分划由两个子集组成,即
3-3 对于如下的状态转换矩阵:
ab
S
AS
AAB
B
BB
ab S
ABA B
AB BB
( ⅰ ) 初态 : S 终态 : B
( ⅲ ) 初态 : S 终态 : B
ab
S
AB
A
CA
BBC
C
CC
ab S
ACB BBC
C
AS CC
( ⅱ ) 初态 : S 终态 : A,C
( ⅳ ) 初态 : S 终态 : C
答案图 3-3
a, b C
(2) 相应的 3 型文法为:
( ⅰ ) S →aA|bS
A→aA|bB| b
B→ aB|bB|a|b
( ⅱ) S →aA|bB| a源自A→bA|aC| a|bB→aB|bC| b
C→ aC|bC|a|b
( ⅲ) S →aA|bB| b A→aB|bA| a
B→aB| bB|a|b
**
(2) b|a(aa b) b
NFA。
3-8 构造与正规式 (a|b) *(aa|bb)(a|b) * 相应的 DFA。
第 3 章 习题答案
编译原理第三版李劲华课后答案
编译原理第三版李劲华课后答案一、关于编译原理这门课编译原理啊,那可真是一门很神奇又有点难搞的课程呢。
这门课就像是在探究计算机语言的神秘魔法一样。
我们要知道啊,编译原理是把高级程序设计语言编写的源程序,通过词法分析、语法分析、语义分析、中间代码生成、代码优化等一系列过程,最后转化成目标机器可执行的机器语言程序的原理。
这就像是把我们人类说的复杂的话,翻译成计算机能听懂的话一样有趣又复杂。
二、课后答案的重要性这课后答案就像是我们在黑暗中摸索的一盏小灯。
我们在学习编译原理的时候,肯定会遇到各种各样的问题。
比如说,在做那些语法分析的题目时,自己做出来的结果总是和预期不太一样,这时候课后答案就能帮我们找到自己错在哪里啦。
它可以让我们检查自己的思路是否正确,就像有个小老师在旁边悄悄地给我们指点一样。
三、部分典型题目的答案示例1. 词法分析那部分有一道题是关于识别单词的。
这道题的关键就是要根据给定的正则表达式规则去判断输入的字符流能不能被正确识别为一个个单词。
答案就是按照词法分析器的构建方法,从左到右依次扫描字符流,根据不同的模式去匹配。
就像是在一堆小珠子里按照特定的形状去挑选一样。
2. 语法分析中的算符优先分析法也有题目。
做这题的时候,要先构建算符优先关系表,然后根据这个表去对输入的表达式进行分析。
答案就是一步步地展示如何构建这个表,然后如何根据表来分析表达式,就像是按照地图找宝藏的路线一样。
四、整体的学习感受学习编译原理这门课真的是一种挑战,但是当我们通过课后答案慢慢理解了那些复杂的概念和算法之后,又会有一种成就感。
就好像是攀登一座很高的山峰,虽然过程很艰难,但是到达山顶看到风景的时候就会觉得一切都是值得的。
而且这门课的知识在以后做一些跟程序底层相关的工作时,肯定会很有用处的,就像一把隐藏的小钥匙,说不定什么时候就能打开一扇很重要的大门呢。