
MERGE和WITH语法
MERGE和WITH语法
1. MERGE :可⼀次性实现对数据的 INSERT, UPDATE, DELETE等,⽤法如下:
SQL> select * from st_a;
ID NAME
---------- ----------
1 F
100 Z
SQL> select * from st_b;
ID NAME
---------- ----------
1 A
2 B
3 C
100 Z
SQL> merge into st_a a using st_b b on (a.id=b.id)
2 when matched then
3 update set a.name=b.name
4 delete where id=100
5 when not matched then
6 insert values (b.id,b.name);
4 rows merged.
SQL> select * from st_a;
ID NAME
---------- ----------
1 A
2 B
3 C
SQL>
2. WITH:定义的结果集,表名都是临时的,不存储在数据库中,可以将查询的结果集定义别名,⽤于SQL语句的调⽤
SQL> with temp_a as (select id,sum(sal) sumsal from st_a group by id), --注意逗号
2 temp_b as (select sum(sumsal)/count(*) avgsal from temp_a)
3 select * from temp_a where sumsal <(select avgsal from temp_b);
ID SUMSAL
---------- ----------
1 7000
其中temp_a和temp_b是WITH语法定义的两个结果集名称,WITH语法后⾯只能紧跟SELECT语句,且中间不能有任何标点符号
SQL中Merge用法详解
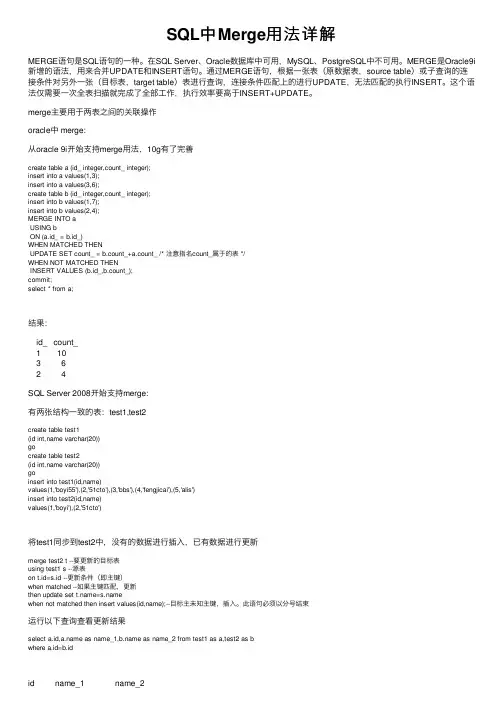
SQL中Merge⽤法详解
MERGE语句是SQL语句的⼀种。在SQL Server、Oracle数据库中可⽤,MySQL、PostgreSQL中不可⽤。MERGE是Oracle9i
新增的语法,⽤来合并UPDATE和INSERT语句。通过MERGE语句,根据⼀张表(原数据表,source table)或⼦查询的连
接条件对另外⼀张(⽬标表,target table)表进⾏查询,连接条件匹配上的进⾏UPDATE,⽆法匹配的执⾏INSERT。这个语
法仅需要⼀次全表扫描就完成了全部⼯作,执⾏效率要⾼于INSERT+UPDATE。
merge主要⽤于两表之间的关联操作
oracle中 merge:
从oracle 9i开始⽀持merge⽤法,10g有了完善
create table a (id_ integer,count_ integer);
insert into a values(1,3);
insert into a values(3,6);
create table b (id_ integer,count_ integer);
insert into b values(1,7);
insert into b values(2,4);
MERGE INTO a
USING b
ON (a.id_ = b.id_)
WHEN MATCHED THEN
UPDATE SET count_ = b.count_+a.count_ /* 注意指名count_属于的表 */
WHEN NOT MATCHED THEN
INSERT VALUES (b.id_,b.count_);
commit;
select * from a;
结果:
id_ count_
1 10
3 6
2 4
SQL Server 2008开始⽀持merge:
有两张结构⼀致的表:test1,test2
create table test1
(id int,name varchar(20))
sqlserver数据库merge语法

SQL Server支持`MERGE`语句,它用于根据源表的数据对目标表执行插入、更新或删除操作。`MERGE`语句通常也被称为"upsert"操作,因为它允许您在单个操作中更新现有记录并插入新记录。
`MERGE`语句在SQL Server中的基本语法如下:
MERGE INTO 目标表名 AS Target
USING 源表名 AS Source
ON 条件
WHEN MATCHED THEN
UPDATE SET 列名1 = 值1, 列名2 = 值2, ...
WHEN NOT MATCHED THEN
INSERT (列名1, 列名2, ...)
VALUES (值1, 值2, ...);
对每个部分的解释:
- `目标表名`:要执行合并操作的目标表。
- `源表名`:提供合并操作数据的源表。
- `条件`:决定如何将目标表中的记录与源表中的记录匹配以进行更新或插入的条件。
- `WHEN MATCHED`:指定在目标表和源表之间找到匹配时执行的操作。
- `WHEN NOT MATCHED`:指定在目标表和源表之间找不到匹配时执行的操作。
下面是一个使用`MERGE`语句的逐步示例: 假设我们有一个`Customers`表和一个`CustomerUpdates`表,并且我们想要在`Customers`表中更新现有的客户记录(如果在两个表中都存在)或插入新的客户记录(如果在`Customers`表中不存在)。
CREATE TABLE Customers (
CustomerID INT PRIMARY KEY,
Name VARCHAR(100),
Age INT
);
CREATE TABLE CustomerUpdates (
CustomerID INT PRIMARY KEY,
Name VARCHAR(100),
stata数据纵向合并命令

stata数据纵向合并命令
Stata数据纵向合并命令
在Stata中,数据纵向合并是将两个或多个数据集按照共同的变量进行合并的操作。这种合并方式通常用于将多个数据集中的不同变量整合在一起,以便进行更全面的分析和处理。
Stata提供了多种命令来实现数据纵向合并,其中最常用的命令是"merge"。merge命令可以根据指定的变量将两个数据集进行合并,并根据需要处理合并时的重复观测、缺失值等情况。
我们需要确保要合并的数据集具有相同的变量。如果两个数据集中的变量名称不完全相同,可以使用"renvars"命令将变量名称进行重命名,以便能够正确地进行合并操作。
在使用merge命令之前,我们需要先将要合并的数据集加载到Stata中。假设我们有两个数据集,分别为"dataset1"和"dataset2",它们都包含了一个共同的变量"ID",我们可以使用以下命令将它们加载到Stata中:
```
use "dataset1.dta", clear
use "dataset2.dta", clear
```
加载完成后,我们可以使用merge命令将两个数据集进行合并。merge命令的基本语法如下:
```
merge 1:1 varlist using filename [, options]
```
其中,"varlist"是要合并的变量列表,"filename"是要合并的数据集文件名,"options"是一些可选参数,用于指定合并时的操作方式。
在合并时,我们可以使用"1:1"或"m:1"的方式进行合并。"1:1"表示两个数据集中的观测是一一对应的,而"m:1"表示一个数据集中的多个观测对应另一个数据集中的一个观测。
如果我们要根据"ID"变量将"dataset1"和"dataset2"进行合并,可以使用以下命令:
```
merge 1:1 ID using dataset2
```
merge命令还提供了一些可选参数,用于处理合并时的重复观测、缺失值等情况。常用的参数包括:
svn中merge的使用

svn中merge的使用
SVN是一种版本控制系统,它允许多个开发者同时对同一个项目进行开发,并能切换和合并代码。在实际开发中,通常会有多个分支,每个分支用于不同的功能开发或修复错误。当一个分支的工作完成后,需要将它的更改合并到其他分支或主干上。这个过程就是使用svn merge命令进行合并。
svn merge命令用来合并两个不同的分支。它的基本语法是:
在使用svn merge之前,需要使用svn update确保本地代码是最新的。因为合并操作可能引入冲突,所以在合并之前最好使用svn st命令检查代码的状态,确保没有未提交的修改。
以下是使用svn merge命令的一些示例:
1.合并两个分支:
svn merge ^/branches/branch1 ^/branches/branch2
这个命令将分支branch1中的更改合并到分支branch2中。
2.合并特定版本的分支:
svn merge -r 100:200 ^/branches/branch1
这个命令将从版本100到200之间的更改合并到当前分支中。注意,这里没有指定目标路径,所以该更改将自动应用到当前目录。
3.合并单个提交:
svn merge -c 100 ^/branches/branch1 这个命令将提交号为100的修改合并到当前目录。
4.合并特定目录或文件:
svn merge ^/branches/branch1/file.txt
这个命令将分支branch1中的file.txt文件合并到当前目录。
除了基本的合并操作,svn merge还支持一些选项和参数,以满足不同的需求。
1. --reintegrate选项:
svn merge --reintegrate ^/branches/branch1
这个选项用于将一个已完成的分支重新合并到主干上。
2. --ignore-ancestry选项:
svn merge --ignore-ancestry ^/branches/branch1
六级语法精选

2015年 6月大学英语六级语法精选训练( 1)
注: 1. collaborate ( 文化艺术方面 ) 合作
in collaboration with 合作 cooperation 合作
2. merge 合并 ; 加强
3. coincide 巧合
4. constitute 构成,组成
[P13-55]
During their fist teacher training year, the students often visited local schools for the of
lessons.
A) observation
B) investigation
C) inspection
D) examination
注: investigation 调查
[P13-56]
He attends to the _____ of important business himself.
A) transaction
B) transition
C) transmission
D) transformation
注: 1. transaction 交易
2. transition 季节的过度 ; 社会制度的转型
3. transmission 广播电视节目的传送 ; 疾病的传播 ; 文化的传播
4. transformation 改变 [P13-57]
Out of ______ revenge, he did his worst to blacken her character and ruin her
reputation.
A) perfect
B) total
C) sheer
D) integral
注: 1. sheer 完全的,纯粹的 ( 六级最爱 )
2. revenge 报复
3. integral 完整的 integrity 诚实,正直
[P13-58]
Oracle中的Merge函数(批量更新删除)

Oracle中的Merge函数(批量更新删除)
Oracle中的Merge函数(批量更新/删除)
摘⾄⽹上的⼏个例⼦
⼀、*****************************************************************Merger into是oracle从9i开始增加的⼀个语句,从merge的字⾯上的意思:合并,兼并不难理解merge在oracle中的含义,merge在oracle所起的作⽤是:如果你从以组值中有选择的更新和插⼊到到⼀张表,具体来说是:如果该表中已经匹配了这组值的某些条件,那么可以使⽤这组值的部分数据来更新这个表的,如果该表中⽆法匹配了这组值的某些条件,那么可以使⽤这组值的数据来为这个表新增⼀条数据。⽆论你在使⽤任何DBMS,你总是难以避免的将会遇到上⾯提到的这种需求,如果你不使⽤merge语句,你将会不得不在程序中增加⼤段的代码,或者是在oracle⽤很长的代码来实现。好在现在我们有了merge,可以帮我们省下很多时间。好了废话少说:Merge 的基本语法是这样的Merge into table[alias]Using table or sql query [alias]On conditionWhen matched thenUpdate set ….When not matched thenInsert values…以上是merge的基本语法,其中alias是为表或者查询写的别名如果你看着空洞的语法觉得头很痛,看下⾯的例⼦吧⾸先我们创建两个表create table test1(id int,name varchar(20));create table test2(id int,name varchar(20))然后随意插⼊⼏⾏数据insert into test1 values(1,’hi’);insert into test1 values(2,’hello’);insert into test2 values(2,’你好’);insert into test2 values(3,’morning’);下⾯我们要使⽤了merge了,将test2中的数据有选择地转移或者更新到test1中如果你运⾏了下下⾯的merge语句,你将会的到⼀个错误,这是因为oracle规定在merge语句中不能更新作为连接的列,也就是on后⾯的那些列merge into test1 t1using test2 t2on (t1.id = t2.id)when matched thenupdate set t1.id = t2.idwhen not matched theninsert values(t2.id,);所以将会得到如下的错误,虽然这个错误翻译的并不怎么样,甚⾄带有明显的误导on (t1.id = t2.id)*ERROR 位于第 3 ⾏:ORA-00904: “T1″.”ID”: ⽆效的标识符好了,知错就改,我们再来运⾏下⾯的merge语句。merge into test1 t1using test2 t2on (t1.id = t2.id)when matched thenupdate set = when not matched theninsert values(t2.id,)成功执⾏了,我们来验证⼀下。select * from test1;ID NAME—— —————-1 hi2 你好3 morning⾄此,你已经掌握了merge语句中的⼤部分。但我们还要提醒⼀些特殊情况。如果我们再向test2中增加⼀条语句insert into test2 values(2,’早’)再执⾏我们以已经成功执⾏过的merge语句,将会遇到下⾯的错误SQL> merge into test1 t12 using test2 t23 on (t1.id = t2.id)4 when matched then5 update set = 6 when not matched then7 insert values(t2.id,)8 ;using test2 t2*ERROR 位于第 2 ⾏:ORA-30926: ⽆法在源表中获得⼀组稳定的⾏这是因为当执⾏到t1.id = t2.id =2时,test2表中对应了两条记录,⽆法进⾏更新或者插⼊。所以就出错了。所以你应该明⽩oracle中的merge语句应该保证on中的条件的唯⼀性,另外⼀点需要说明的是using关键字后⾯可以接表,当然也可以接其他的select语句做出来的⼀个类视图,oracle中的这种结构,我们在前⾯已经介绍多次,在此不作介绍。
oracle的merge语句
oracle的merge语句
摘要:
1.简介
2.Oracle Merge 语句的基本语法
3.Oracle Merge 语句的常见用途
4.Oracle Merge 语句的注意事项
5.总结
正文:
1.简介
Oracle Merge 语句是 Oracle 数据库中一种强大的数据操作语句,它可以实现将两个表之间的数据进行合并、更新或删除操作。通过使用 Merge 语句,可以简化复杂的数据操作,提高工作效率。
2.Oracle Merge 语句的基本语法
Oracle Merge 语句的基本语法如下:
```
MERGE INTO target_table
USING source_table
ON (condition)
WHEN MATCHED THEN
UPDATE
SET column1 = value1, column2 = value2,
...
WHERE condition;
WHEN NOT MATCHED THEN
INSERT
VALUES (value1, value2, ...);
```
其中,`target_table`是要更新的目标表,`source_table`是提供数据的源表,`condition`是用于匹配目标表和源表数据的条件。`WHEN MATCHED`和`WHEN NOT MATCHED`子句分别表示当匹配到数据时执行的操作和当未匹配到数据时执行的操作。
3.Oracle Merge 语句的常见用途
Oracle Merge 语句常用于以下场景:
- 数据迁移:将源表的数据合并到目标表中,例如将测试数据迁移到生产数据表。
- 数据更新:根据源表中的数据更新目标表中的数据,例如根据用户提供的数据更新用户信息。
- 数据删除:在目标表中删除不满足条件的数据,例如删除已离职的员工信息。
stata中横向循环合并的命令
stata中横向循环合并的命令
横向循环合并是指将两个或多个数据集按照共同的变量进行合并,生成一个新的数据集。在stata中,我们可以使用merge命令来实现横向循环合并。merge命令的基本语法如下:
merge 1:1 varlist using filename [, options]
其中,1:1表示按照共同的变量进行一对一合并,varlist是需要合并的变量列表,using filename表示需要合并的数据集文件名,options是用来指定合并的方式和处理合并后数据集的一些选项。
横向循环合并的命令主要有以下几种情况:
1. 一对一合并
一对一合并是指两个数据集中的观察单位一一对应的合并方式。即两个数据集中的共同变量取值相同的观察单位合并在一起,不同的变量取值则被填充为缺失值。一对一合并可以通过merge 1:1命令来实现。
例如,我们有两个数据集A和B,它们有一个共同的变量id,我们可以使用以下命令将这两个数据集按照id变量进行一对一合并:
merge 1:1 id using A
这样,数据集B中的观察单位将按照id变量与数据集A中的观察单位进行匹配,合并成一个新的数据集。
2. 一对多合并
一对多合并是指两个数据集中的观察单位一对多的合并方式。即一个数据集中的观察单位对应多个数据集中的观察单位。一对多合并可以通过merge 1:m命令来实现。
例如,我们有两个数据集A和B,它们有一个共同的变量id,我们可以使用以下命令将这两个数据集按照id变量进行一对多合并:
merge 1:m id using A
这样,数据集B中的观察单位将按照id变量与数据集A中的观察单位进行匹配,合并成一个新的数据集。如果数据集A中的id变量有重复值,那么数据集B中的观察单位将与数据集A中的多个匹配观察单位合并。
3. 多对多合并
多对多合并是指两个数据集中的观察单位多对多的合并方式。即一个数据集中的观察单位对应多个数据集中的观察单位,同时一个数据集中的观察单位也对应多个数据集中的观察单位。多对多合并可以通过merge m:m命令来实现。
python pandas的merge函数
python pandas的merge函数
Python中的pandas库是数据分析、数据处理工作中的神器之一。前置环境中需要安装好pandas库,版本>=0.23.0。本篇文章就来讲一下pandas.merge()函数,它是一个高性能的用于合并多个数据集的函数,而且相比SQL的Join操作更为灵活。
1. merge()函数的基本语法
在pandas中使用merge()函数可以进行多种不同的连接操作,merge()函数的基本语法如下:
```
pandas.merge(left, right, how='inner', on=None, left_on=None, right_on=None,
left_index=False, right_index=False, sort=False, suffixes=('_x', '_y'), copy=True,
indicator=False)
```
其中各个参数的含义如下:
- left: 要合并的左边DataFrame
- right: 要合并的右边DataFrame
- how: 合并方法(inner、outer、left、right),默认为inner
- on: 要合并的列名。若两个DataFrame中需要合并的列名相同,可以直接指定这个参数;若需合并的列名不同,可以使用 left_on 和 right_on 参数指定左右DataFrame需要合并的列名。
- left_on: 左边DataFrame需要合并的列名,可以使用列表指定多个列名进行合并,与 on 或 right_on 参数二选一
- right_on: 右边DataFrame需要合并的列名,可以使用列表指定多个列名进行合并,与 on 或 left_on 参数二选一
- left_index: 是否使用左边DataFrame的索引作为合并键,默认为False
oracle中merge into用法
- 1 - oracle中merge into用法
Oracle中的Merge语句是一种非常强大的数据操作语句,它可以用于将两个数据表合并成一个新表,同时还可以对目标表进行更新和插入操作。在实际的数据处理中,Merge语句可以大大简化我们的操作流程,提高数据处理的效率和准确性。本文将详细介绍Oracle中Merge语句的用法和注意事项。
一、Merge语句的基本语法
Oracle中的Merge语句的基本语法如下:
MERGE INTO 目标表 USING 源表 ON (条件) WHEN MATCHED THEN
UPDATE SET 目标列=源列 WHEN NOT MATCHED THEN INSERT (列名)
VALUES (值);
其中,“目标表”是我们要合并数据的目标表,“源表”是我们要从中获取数据的源表。ON子句是用来指定用于匹配目标表和源表的条件,当目标表和源表匹配时,我们可以更新目标表中的数据;当目标表中没有匹配的数据时,我们可以将源表中的数据插入到目标表中。
二、Merge语句的使用方法
下面我们通过一个实例来介绍Oracle中Merge语句的使用方法。假设我们有两个数据表,一个是员工信息表“EMP_INFO”,另一个是员工考勤表“EMP_ATTENDANCE”。员工信息表中包含员工的基本信息,如员工编号、姓名、性别、职位等;员工考勤表中包含员工的考勤信息,如考勤日期、上班时间、下班时间等。现在我们要将这两个表中的数据合并到一个新表“EMP_TOTAL”中,并且要求在合并的过程中 - 2 - 对新表中的数据进行更新和插入操作。
1.创建数据表
首先我们需要创建员工信息表、员工考勤表和新表EMP_TOTAL。创建表的SQL语句如下:
CREATE TABLE EMP_INFO (EMP_ID NUMBER(10), EMP_NAME