
第八章 相关分析
Pearson简单相关系数计算公式为
对Pearson简单相关系数的统计检验是计 算t统计量,公式为
t统计量服从n−2个自由度的t分布。
Spearman等级相关系数为
8.2 SPSS实现
8.2.1 对话框介绍 在Analyze主菜单中用鼠标指向"Correlate"选项,然后 在打开的子菜单中单击"Bivariate--· "选项,打开对话框,在 该对话框中设置选项,进行变量两两之间的相关分析。该对 话框中各选项的意义分别为: (1)Variables列表框:用箭头按钮从左边列表框中将需 要分析的变量对应的变量名转移到该列表框中。
偏相关分析的主对话框
偏相关的选择项对话框
偏相关应用实例输出1
四川绵阳地区3年生中山柏的数据,分析月生长量与月平均气温、月降雨量、月 平均日照时数、月平均湿度这四个气候因素哪个因素有关。数据来源于袁佳祖 编著《灰色系统理论》,数据编号data8-03。
Descriptive Statistics 生 长 量 (cm) 月 平 均 日 照 时 数 月 平 均 湿 度 月 降 雨 量 (mm) 月 平 均 气 温 (c) Mean 9.4592 98.8917 80.2500 85.2167 15.9833 Std. Deviation 7.17787 34.66262 3.36087 97.48834 7.49919 N 12 12 12 12 12
花 枝 长
花 萼 长
**. Correlation is sig nificant at the 0.01 level (2-tailed).
实例2:对12个受试者的地位欲、权威主义和顺从性进行评秩,得到 的数据文件为Testee.sav,试分析3者之间的相关性。
由于以上数据为评秩变量数据,用Kendall偏秩相关系数和 Spearman秩相关系数进行分析。 在数据编辑器中打开该数据文件,变量分别定名为"地位"、"权 威"和"顺从"。打开"Bivariate Correlations "对话框,在 "Variables"列表框中输入以上变量,在"Correlation Coefficient"方框中选择“Kendall’s”核选框和"Spearman"核选框, 运行过程,生成表4。
Correlations 花 瓣 长 花 瓣 长 Pearson Correlation Sig . (2-tailed) Sum of Squares and Cross-products Covariance N Pearson Correlation Sig . (2-tailed) Sum of Squares and Cross-products Covariance N Pearson Correlation Sig . (2-tailed) Sum of Squares and Cross-products Covariance N 1 . 606.444 35.673 18 .955** .000 487.667 28.686 18 .797** .000 266.667 15.686 18 花 枝 长 .955** .000 487.667 28.686 18 1 . 430.000 25.294 18 .678** .002 191.000 11.235 18 花 萼 长 .797** .000 266.667 15.686 18 .678** .002 191.000 11.235 18 1 . 184.500 10.853 18
-Missing Values方框 设置缺失值的处理方式。 》Exclude cases pairwise单选钮 为默认选项。选择此 项,剔除正在进行相关分析的配对变量中含有缺失值的个案。 》Exclude cases listwise单选钮 选择此项,剔除所有 含有缺失值的个案的全部数据。
12.2.2 应用实例 实例1:H.H.Smith在烟草杂交繁殖的花上搜集了以下的数据 文件为“Flower.sav”。 要求对以上3组数据两两之间进行相 关分析。 在数据编辑器中打开该数据文件,变量分别定名为“花 瓣”、“花枝”和“花萼"。打开Bivariate Correlations对 话框, 进行设置,运行过程,生成以下表格。
(1)Pearson 相关系数度量两个变量之间的线性相关程度。 相关系数前面的符号表征相关关系的方向,其绝对值的大 小表示相关程度,相关系数越大,则相关性越强。
(2)Kendall 偏秩相关系数是适用于度量等级变量或秩变 量相关性的一种非参数度量。
(3)Spearman 秩相关系数是Pearson相关系数的非参数版 本,主要基于数据的秩而不是数据的值本身,它适用于等级 数据和不满足正态假定的等问隔数据。
花 枝 长
花 萼 长
**. Correlation is significant at the 0.01 level (2-tailed).
在以上设置的基础上,单击"Options"按钮,打开"Bivariate Correlations:Options"对话框,选择"Statistics"方框内的两个 核选框,单击“Continue"按钮,运行过程,生成表2和表3。 表2为描述统计量表。表中列出的统计量包括各变量的均值 (Mean)、标准离差(Std.Deviation)和数据个数(N)。
利用表4中Kendall法得到的系数,将0.667、0.388和0.357代入 计算Kendall偏秩相关系数的公式,得结果0.62,该值与0.667相 比差别较小,故可以认为地位欲与权威主义的相关性与顺从性 无关。从表4中得到的Spearman秩相关系数可以看出,地位欲与 权威主义在0.01的显著性水平上有较好的相关性,地位欲与顺 从性在0.05的显著性水平上有较好的相关性。
(3)Test of Significance方框:确定进行双侧显著性检验还 是单侧显著性检验。检验的零假设为相关系数为零,即分析的变 量之间不具相关性。 · Two-tailed单选钮 为默认选项。选择此项,进行双侧显著性 检验 · One-tailed单选钮 选择此项,进行单侧显著性检验
(4)Flag significant correlations 核选框: 默认时选择此项, 表示在成果表中标注经检验显著的变量对,并在表的下方添加脚 注,注明显著性水平。对于单侧检验,显著性水平为0.05,对于双 侧检验,显著性水平为0.01。
Descriptive Statistics 花 瓣 长 花 枝 长 花 萼 长 Mean 40.44 19.67 16.17 Std. Deviation 5.973 5.029 3.294 N 18 18 18
表3为添加了叉积平方和(Sum of Squares and Crossproducts)和协方差(Covariance)的相关分析成果表。
(5)Options按钮:单击该按钮,打开"Bivariate Correlation:Options"对话框。在该对话框中可以设置更多的选 项。
-Statistics方框 设置统计量的生成。 》Means and standard deviations核选框选择此项,计算 均值和标准离差。 》Cross-product deviations and covariance核选框选 择此项,计算叉积离差和协方差。
Correlations 花 瓣 长 花 瓣 长 Pearson Correlation Sig . (2-tailed) N Pearson Correlation Sig . (2-tailed) N Pearson Correlation Sig . (2-tailed) N 1 . 18 .955** .000 18 .797** .000 18 花 枝 长 .955** .000 18 1 . 18 .678** .002 18 花 萼 长 .797** .000 18 .678** .002 18 1 . 18
权 威 主 义
顺 从 性
Spearman's rho
地 位 欲
权 威 主 义
顺 从 性
**. Correlation is significant at the 0.01 level (2-tailed). *. Correlation is significant at the 0.05 level (2-tailed).
rxy, z1 z 2
rxy. z1 rxz2. z1 ryz2 . z1
2 2 (1 rxz )( 1 r ) . z yz 2 . z1 2 1
Pearson偏相关系数假设检验的t统计量:
t
n k 2 r 1 r 2
其中,r是相应的偏相关系数,n是观测量数,k是控制变量的数目, n-k-2是自由度。当t>t0.05(n-k-2)时,p<0.05拒绝原假设
(2)Correlation Coefficients 方框:在该方框内确定计算哪(几) 种相关系数,有3个选项。 · Pearson核选框为默认选项。选择此项,生成Pearson相关系数。 · Kendall’s核选框 选择此项,生成Kendall偏秩相关系数。 · Spearman核选框 选择此项,生成Spearman秩相关系数。
Correlations Kendall's tau_b 地 位 欲 Correlation Coefficient Sig . (2-tailed) N Correlation Coefficient Sig . (2-tailed) N Correlation Coefficient Sig . (2-tailed) N Correlation Coefficient Sig . (2-tailed) N Correlation Coefficient Sig . (2-tailed) N Correlation Coefficient Sig . (2-tailed) N 地 位 欲 1.000 . 12 .667** .003 12 .388 .084 12 1.000 . 12 .818** .001 12 .615* .033 12 权 威 主 义 .667** .003 12 1.000 . 12 .357 .112 12 .818** .001 12 1.000 . 12 .545 .067 12 顺 从 性 .388 .084 12 .357 .112 12 1.000 . 12 .615* .033 12 .545 .067 12 1.000 . 12
第八章 相关分析与回归分析
下一页
返回本节首页
19
③在数据区域中输入B2:C11,选择“系列产 生在—列”,如下图所示,单击“下一步” 按钮。
上一页
第8章 回归分析
下一页
返回本节首页
20
④打开“图例”页面,取消图例,省略标题,如 下图所示。
上一页
第8章 回归分析
下一页
返回本节首页
21
⑤单击“完成”按钮,便得到XY散点图如下图 所示。
n 8, x 36.4, x 207.54 , y 104214 y 880, . xy 4544 6
2 2
r
n xy x y n x2 x 2 n y2 y 2 8 4544 6 36.4 880 .
第8章 回归分析
40
(二)回归分析的种类: 1、按自变量 x 的多少,分为一元回归和多 元回归; 2、按 y 与 x 关系的形式,分为线性回归和 非线性回归。
第8章 回归分析
41
二、一元线性回归分析
x y 62 86 80 110 115 132 135 160
42
(一)一元线性回归方程:
2、非线性相关:当一个变量变动时, 另一个变量也相应发生变动,但这种变 动是不均等的。
第8章 回归分析
9
㈢根据相关关系的方向 1、正相关:两个变量间的变化方向一 致,都是增长趋势或下降趋势。 2、负相关:两个变量变化趋势相反。
上一页
第8章 回归分析
下一页
返回本节首页
10
(四)根据相关关系的程度 1、完全相关:两个变量之间呈函数关系 2、不相关:两个变量彼此互不影响,其 数量的变化各自独立
第8章 相关分析

第8章 相关分析相关分析(Correlations)是研究两个变量间。
或一个变量与多个变量间,或多个变量两两变量间,或两组变量间,或多个变量组与组之间密切程度的一种常用统计学方法。
变量间的密切程度常用相关系数(Correlation Coefficients)或统计量描述。
SAS /Win(v8)系统非编程有如下5种相关量度(Correlation Measure)。
(1)Pearson product-moment correlation ,皮尔逊积矩相关分析。
(2)Spearman coefficients ,斯皮尔曼相关系数s r(3)Cronbach ’coefficient alpha ,克龙巴哈系数α(4)Kendall ’s tan –b coefficient ,肯德尔b τ系数。
(5)Hoeffding ’s D statistic ,霍夫丁D 统计量。
同时将输出变量的简单统计量(Simple Statistics),相关系数(Correlation Coefficients),相应的P 值与图形(P1ots)等。
8-1皮尔逊积矩相关分析[例8-1] 已知5-6岁儿童体检数据的指标为编号(1x ),性别(2x ),月龄(3x ),体重(4x ,kg),身高(5x ,cm),坐高(6x ,cm),胸围(7x ,cm),头围(8x ,cm),左眼视力(9x )与右眼视力(10x ),并已建立SAS 数据集SASUSER.child 。
试对体重(4x )与身高(5x )做皮尔逊(Pearson)相关分析。
(1)进入SAS /Win(V8)系统,单击So1utions->Analysis->Analyst ,进入分析家窗口。
(2)单击File->open By SAS Name->Sasuser->Child->OK ,调入SAS 数据集SASUSER.child(3)单击statistics->Descriptive->correlations ,得到图8-1所示对话框。
薛薇,《SPSS统计分析方法及应用》第八章 相关分析和线性回归分析

以控制,进行偏相关分析。
偏相关分 析输出结 果;负的 弱相关
相关分析 输出结果 ;正强相 关
8.4.1
8.4.2
回归分析概述
线性回归模型
8.4.3
8.4.4 8.4.5 8.4.6
回归方程的统计检验
基本操作
其它操作
应用举例
线性回归分析的内容
能否找到一个线性组合来说明一组自变量和因变量
可解释x对Y的影响大小,还可 以对y进行预测与控制
目的是刻画变量间的相关 程度
8.2.1 8.2.2 8.2.3 8.2.4
散点图 相关系数 基本操作 应用举例
•
相关分析通过图形和数值两种方式,有效地揭示事物
之间相关关系的强弱程度和形式。
8.2.1 散点图 它将数据以点的的形式画在直角坐标系上,通过
Distances 过程用于对各样本点之间或各个变量之间 进行相似性分析,一般不单独使用,而作为聚类分
析和因子分析等的预分析。
1) 选择菜单Analyze Correlate Bivariate,出现 窗口:
2) 把要分析的变量选到变量Variables框。
3) 在相关系数Correlation Coefficents框中选择计算哪种
一元线性回归模型的数学模型:
y 0 1 x
其中x为自变量;y为因变量; 0 为截距,即常量;
1 为回归系数,表明自变量对因变量的影响程度。
用最小二乘法求解方程中的两个参数,得到
1
( x x )( y y ) (x x)
i i 2 i
0 y bx
第八章 方差分析与相关分析
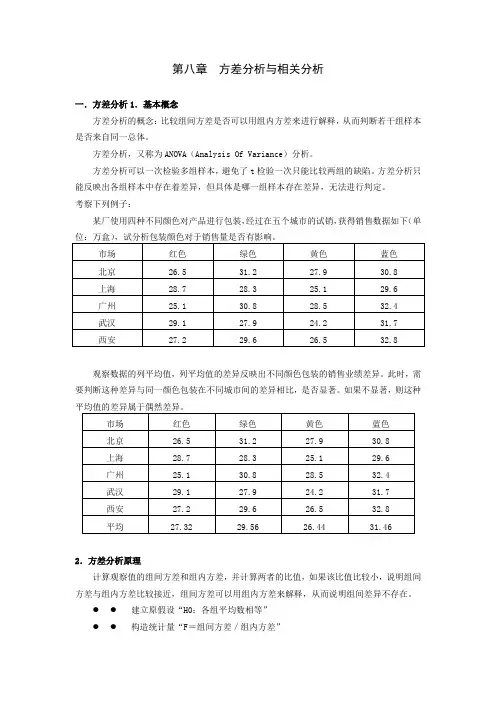
第八章方差分析与相关分析一.方差分析1.基本概念方差分析的概念:比较组间方差是否可以用组内方差来进行解释,从而判断若干组样本是否来自同一总体。
方差分析,又称为ANOVA(Analysis Of Variance)分析。
方差分析可以一次检验多组样本,避免了t检验一次只能比较两组的缺陷。
方差分析只能反映出各组样本中存在着差异,但具体是哪一组样本存在差异,无法进行判定。
考察下列例子:某厂使用四种不同颜色对产品进行包装,经过在五个城市的试销,获得销售数据如下(单观察数据的列平均值,列平均值的差异反映出不同颜色包装的销售业绩差异。
此时,需要判断这种差异与同一颜色包装在不同城市间的差异相比,是否显著。
如果不显著,则这种2.方差分析原理计算观察值的组间方差和组内方差,并计算两者的比值,如果该比值比较小,说明组间方差与组内方差比较接近,组间方差可以用组内方差来解释,从而说明组间差异不存在。
●●建立原假设“H0:各组平均数相等”●●构造统计量“F=组间方差/组内方差”●●在计算组间方差时,使用自由度为(r-1),计算组内方差时,使用自由度为(n-r)。
●●F满足第一自由度为(r-1),第二自由度为(n-r)的F分布。
●●查表,若F值大于0.05临界值,则拒绝原假设,认为各组平均数存在差异。
根据方差计算的原理,生成方差分析表如下:其中:组间离差平方和 SSA (Sum of Squares for factor A) =39.084误差项离差平方和 SSE (Sum of Squares for Error) =76.8455总离差平方和 SST (Sum of Squares for Total)=115.9295P-value值为0.000466,小于0.05,所以拒绝原假设。
3.双因素方差分析观察下列销售数据,欲了解包装方式和销售地区是否对于销售业绩有影响,涉及到双因素的方差分析。
此时需分别计算SSA、SSB与SSE之间的比值是否超过临界值。
第八章相关分析
11-16 5
6-11
-
合计 7
1
3
3
4
1
13
3
3
1
1
8
7
7
2
1 24
24
按耕作深度
分组(cm)
3
8
1
10
1
12
1
14
16
18
合计
3
双变量分组相关表
平均收获率(100kg/亩)
4
5
6
7
1
1
3
2
2
6
3
2
3
5
2
1
2
3
13 11 6
8 合计
3
6
14
1
11
2
5
1
1
4
40
25
多因素复合分组相关表 (日产吨数)
11
第一节 相关分析的一般问题
相关关系种类
相关程度 相关方向 关系表现形式 影响因素 依存关系
完不完 全完全 相全不 关相相
正 相 关
负 相 关
线 性 相
非 线 性
单复 相相 关关
关关
关相
关
因非 果因 关果 系关
系
12
第一节 相关分析的一般问题
二、相关分析与回归分析 (一)涵义
1、相关分析是对具有相关关系的变 量之间的关系密切程度进行分析研究的 统计方法。
倾斜度
煤层深度(m)
100以下
年采掘量(千吨) 100 ̄250 250 ̄400 400以上
0.7m
13
35度以下 (缓斜度)
0.7 ̄0.9 0.9 ̄1.1
第8章 相关分析-4. 互相关技术应用
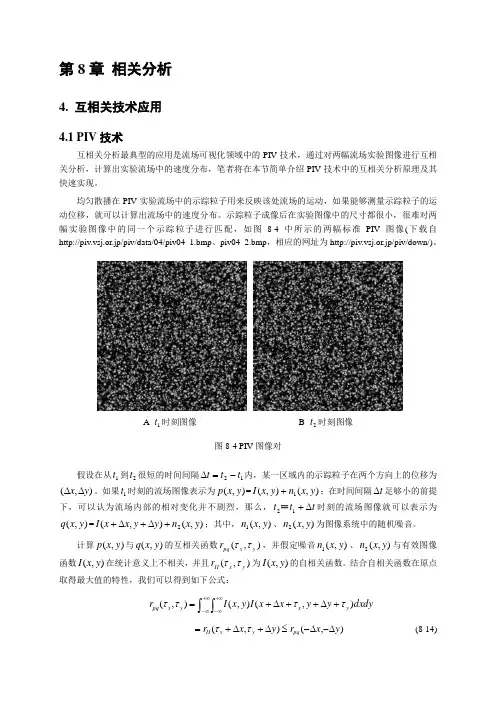
因为除了构造一个二维复值序列,此处介绍的算法在C++代码实现上与第四章的单文档程序CH4_Filter二维部分(2-D)相同,笔者就不再给读者提供具体的算例代码。
图8-5 PIV分析示意图
图8-6图8-4的分析结果
需要提醒读者注意的是,笔者在本章和下一章中提供的互相关分析算法只是PIV技术中的第一步,如亚像素算法、矢量修正等内容都是PIV技术的关键内容。笔者下面介绍一种利用Fourier变换进行矢量光滑的简单且实用的算法。
4.2
在进行PIV实验过程中,由于成像设备曝光不当、流场中示Байду номын сангаас粒子分布不均或噪音干扰等各种不利原因,将导致实验图像质量的降低,使得分析结果中存在一些空白或错误矢量。矢量的有效性判断、空白数据的修补以及错误矢量的修正已经成为PIV技术中的一项重要研究内容。
随着海洋卫星遥感技术的发展,由海洋卫星获取的极区海洋卫星遥感信息越来越丰富,卫星遥感数据的时空分辨率越来越高,可供研究人员利用的国内外卫星遥感数据也越来越多、实时性越来越高,实现大范围、近实时极区海冰运动的分析与研究,为极区的海洋行动提供精细化海冰运动分析与预报产品在技术上已经成为可能。
下面使用的遥感资料主要是可见光与近红外波段的MODIS数据和微波波段的合成孔径雷达数据,这两类数据可以登录LANCE-MODIS和PolarView的网站下载。LANCE-MODIS能够提供由Terra和Aqua两颗卫星生成的近实时可见光/近红外图像,研究人员可以根据需要选择分辨率和成像波段,由不同波段生成最高分辨率为250m的真彩色或伪彩色图像。Polar View网站提供了不同种类卫星载荷、不同海区的观测产品,研究人员可以下载到高分辨率的合成孔径雷达(SAR)数据。图8-7中列出了Terra卫星在北极地区2014年8月10日和8月11日生成的真彩色MODIS图像,红色虚线框标出了海冰覆盖区域;图8-8中列出了2014年1月25日由加拿大Radarsat-2在南极地区扫描生成的SAR图像,红色虚线框标出了两幅图像中的重叠部分,图中的巨型白色物体是编号为A23A的搁浅冰山。
第8章 相关与回归分析
4、在相关关系中,变量之间是平等关系,不存在自变量和因变量。 、在相关关系中,变量之间是平等关系,不存在自变量和因变量。
而在回归分析中必须明确划分自变量和因变量。 而在回归分析中必须明确划分自变量和因变量。
8-9
统计学
STATISTICS
8.2 简单线性相关与回归分析
8 - 10
STATISTICS
8-5
统计学
STATISTICS
(三)从变量相关关系变化的方向看 从变量相关关系变化的方向看 变化的方向 正相关: A 正相关:变量同方向变化 , 即同增同减 (A) 同增同减 负相关:变量反方向变化, 负相关:变量反方向变化, 即一增一减 (B) B 一增一减 从变量相关的程度 相关的程度看 (四)从变量相关的程度看
完全相关 (B) 不完全相关 (A) 不相关 (C)
8-6
25 20 15 10 5 0 0 2 4 6 8 10 12
25 20 15 10 5 0 0 2 4 6 8 10 12
C
35 30 25 20 15 10 5 0 0 5 10 15
统计学
STATISTICS
三、回归分析
回归一词的由来: 回归一词的由来:
8 - 13
见第218页例题 页例题 见第 页例
统计学
STATISTICS
相关系数的特点: 相关系数的特点:
1、r 的取值范围是 − 1 ≤ r ≤ 1 。 、 2、r<0时,β<0 为负相关;r>0时, β>0 为正相关。 为负相关; 为正相关。 、 时 时 3、|r|=1,为完全相关。r =1,为完全正相关;r = -1, 、 ,为完全相关。 ,为完全正相关; , 为完全负正相关。 为完全负正相关。 4、r = 0,不存在线性相关。 、 线性相关。 ,不存在线性相关 5、|r|越趋于 表示两变量线性关系越密切;|r|越趋于 、 越趋于 表示两变量线性关系越密切; 越趋于 越趋于1表示两变量线性关系越密切 越趋于0 表示两变量线性关系越不密切。 表示两变量线性关系越不密切。 线性关系越不密切 6、r是一个随机变量。 、 是一个随机变量 是一个随机变量。
统计学习题第8章相关分析
第八章相关分析一、单项选择⒈当自变量按必然数量转变时,因变量也相应随之而等量转变,这时两个变量之间存在着( )①直线相关关系;②曲线相关关系;③负相关关系;④正相关关系。
⒉当变量x值增加时,变量y值随之下降,那x和y两个变量之间存在着( ) ①正相关关系;②负相关关系;③曲线相关关系;④直线相关关系。
⒊假设变量x值减少,而变量y值却增加,那么变量x与变量y之间存在着( )①直线相关关系;②正相关关系;③曲线相关关系;④负相关关系。
⒋圆的面积与半径间存在着( )①相关关系;②因果关系;③函数关系;④比较关系。
⒌若是变量x和变量y之间的相关系数为-1,这说明两变量之间是( ) ①高度相关关系;②完全相关关系;③低度相关关系;④完全不相关。
⒍相关分析和回归分析相较,对变量的性质要求是不同的。
回归分析中要求( )①自变量是给定的,因变量是随机的; ②两个变量都是非随机的; ③两个变量都是随机的; ④以上三个都不对。
⒎若是变量x和变量y之间的相关系数为1,那么说明两个变量之间是( ) ①完全不相关;②高度相关关系;③完全相关关系;④低度相关关系。
⒏相关关系中,两个变量的关系是对等的,从而变量x对变量y的相关,同变量y对变量x的相关( )①完全不同;②有联系但不一样;③是同一问题;④不必然相同。
⒐已知某工厂甲产品产量和生产本钱有直接关系,在这条直线上,当产量为1000时,其生产本钱为30000元,其中不随产量转变的本钱为6000元,那么本钱总额对产量的回归方程是( )①y=6000+24x ;②y=6+;③y=24000+6x ;④y=24+6000x 。
⒑已知)(∑-x x 2是)(∑-y y 2的两倍,并已知)(∑-x x ·)(y y -是)(∑-y y 2的倍,那么相关系数r为( ) ①不能计算;②;③22.1;④22.1。
⒒在相关分析中,要求相关的两个变量( ) ①都是随机变量; ②都不是随机变量;③其中因变量是随机变量; ④其中自变量是随机变量。
统计学原理第八章相关分析与回归分析
21
例1:P354页,第1题
企业 产量 X 单位成 XY
X2
Y2
序号 (4件) 本(元)Y
1
2
52
104
4
2704
2
3
54
162
9
2916
3
4
52
208
16
2704
4
4
48
192
16
2304
5
5
48
240
25
2304
6
6
∑
24
46
276
36
2116
300
1182
106 15048
即:∑X=24,∑Y=300, ∑XY=1182,
• 2) X倚Y的直线方程的确定
• 根据最小平方法的原理:(x xc )2 最小值
• 将xc = c + dy代入上述公式中,分别对c和d 求一阶偏导数,并令偏导数等于0,就可以
得出两个正规方程:
x nc dy yx cy dy2
d
nyx y n y2 (
x
y )2
c x dy
举例:P355,第4题。
• 偏相关:在复相关中,当假定其他变量不 变时,其中两个变量间的相关关系称为偏 相关。例如,在假定人们收入水平不变的 条件下,某种商品的需求与其价格水平的 关系就是一种偏相关。
9
三、相关分析与回归分析
• (一)相关分析 • 是用一个指标(相关系数)来表明现象
之间相互依存的密切程度。 • (二)回归分析 • 是根据相关关系的具体形态,选择一个
• 曲线相关:如果现象之间的相关关系近似 地表现为某种曲线形式时,就称这种相关 关系为曲线相关。
第八章 相关与回归分析-一元线性回归
12
1、散点图
不良贷款
14
12
10
8
6
4
2
0 0
100
200
300
400
贷款余额 不良贷款与贷款余额的散点图
14
12
10
8 6
4
2
0 0
10
20
30
40
贷款项目个数
不良贷款与贷款项目个数的散点图不来自贷款不良贷款14
12
10
8
6
4
2
0 0
10
20
30
累计应收贷款
不良贷款与累计应收贷款的散点图
14
2
本章主要内容
➢ 相关分析
• 相关关系度量 • 相关关系显著性检验
➢ 一元线性回归分析
• 一元线性回归模型 • 参数的最小二乘估计 • 回归直线的拟合优度 • 显著性检验
➢ 利用回归方程进行预测
➢ 残差分析
3
第一节 直线相关分析 一、变量间的关系
函数关系
相关关系
函数关系的例子
▪ 某种商品的销售额(y)与销售量(x)之间的关系可 表示为 y = px (p 为单价)
儿子与父亲的身高关系:Y=33.73+0.516X(英寸)
24
一、概述——什么是回归分析(Regression )?
1. 从一组样本数据出发,确定变量之间的数学关系式 2. 对这些关系式的可信程度进行各种统计检验,并从
影响某一特定变量的诸多变量中找出哪些变量的影 响显著,哪些不显著 3. 利用所求的关系式,根据一个或几个变量的取值来 预测或控制另一个特定变量的取值,并给出这种预 测或控制的精确程度