
Oracle 分区表的优点
ORACLE 表分区表分区的好处和事处理表分区描述表分区(partition):表分区技术是在超大型数据库(VLDB)中将大表及其索引通过分区(patition)的形式分割为若干较小、可管理的小块,并且每一分区可进一步划分为更小的子分区(sub partition)。
而这种分区对于应用来说是透明的。
Oracle的表分区功能通过改善可管理性、性能和可用性,从而为各式应用程序带来了极大的好处。
通常,分区可以使某些查询以及维护操作的性能大大提高。
此外,分区还可以极大简化常见的管理任务,分区是构建千兆字节数据系统或超高可用性系统的关键工具。
分区功能能够将表、索引或索引组织表进一步细分为段,这些数据库对象的段叫做分区。
每个分区有自己的名称,还可以选择自己的存储特性。
每个分区都是一个独立的段(SEGMENT),可以存放到相同(不同)的表空间中。
从数据库管理员的角度来看,一个分区后的对象具有多个段,这些段既可进行集体管理,也可单独管理,这就使数据库管理员在管理分区后的对象时有相当大的灵活性。
但是,从应用程序的角度来看,分区后的表与非分区表完全相同,使用SQL DML 命令访问分区后的表时,无需任何修改。
(对于高效率查询是有影响,主要差别是对某一分区数据时行查询时和对整体数据进行查询)表分区的好处通过对表进行分区,可以获得以下的好处:1)增强可用性:如果表的某个分区出现故障,表在其他分区的数据仍然可用;2)维护方便:如果表的某个分区出现故障,需要修复数据,只修复该分区即可;3)均衡I/O:可以把不同的分区映射到磁盘以平衡I/O,改善整个系统性能;4)改善查询性能:对分区对象的查询可以仅搜索自己关心的分区,提高检索速度。
分区表事务操作的时候,指定了分区,系统在执行的时候则只操作该分区的记录,提高了数据处理的速度。
不要指定分区直接操作数据也是可以的。
在分区表上建索引及多索引的使用和非分区表一样。
此外,因为在维护分区的时候可能对分区的索引会产生一定的影响,可能需要在维护之后重建索引,相关内容请参考分区表索引部分的文档缺点分区表相关:已经存在的表没有方法可以直接转化为分区表。
不过Oracle 提供了在线重定义表的功能。
什么时候使用分区表1、表的大小超过2GB。
2、表中包含历史数据,新的数据被增加都新的分区中。
各版本表分区的特性区别分区别的类型✓范围分区:将表按某一字段或若干个字段的取值范围分区。
✓hash分区:将表按某一字段的值均匀地分布到若干个指定的分区。
✓复合分区:结合了前面两种分区类型的优点,首先通过值范围将表进行分区,然后以hash模式将数据进一步均匀分配至物理存储位置。
✓列表分区:数据分布是通过分区键的一串值定义的,这对不连续的列表非常有用,如:区域、状态等。
(9I 以上支持)✓混合分区:有两个数据分布办法用于创建混合分区,表首先通过第一个数据分布办法进行初始化分区,然后每个分区再通过第二个办法分成子分区,下面列出了可用的混合分区类型:范围-哈希,范围-列表,范围-范围,列表-范围,列表-列表,列表-哈希。
在10g中索引组织表(表的索引和数据存储在一起)支持通过范围、列表或哈希进行分区,然而,混合分区在索引组织表上不受支持。
✓间隔分区:在11g中才引入,间隔分区是对范围分区的扩展,为等距范围分区提供了自动化,分区创建为元数据,只有分区开始部分是不变的,附加的段是当数据抵达时才分配的,附加分区和本地索引是自动创建的。
numtoyminterval函数转换一个数字为间隔一年至一个月的文字(年或月),间隔分区表可以有传统的范围和自动间隔部分,范围分区表可以通过在ALTER TABLE 命令中使用SET INTERVAL选项被扩展为间隔分区表。
✓REF分区:这个分区方案假设关联表能从相同的分区策略中受益,子表通过PK-FK(主键-外键)关系继承主表的策略,它不需要分区键存储在子表中,通过PARTITION BY REFERENCE关键字指定,子表继承主表的分区策略。
✓基于列的虚拟分区:在Oracle以前的版本中,只有分区键物理存在于表中才能对表进行分区,在11g中引入一个新的特性“虚拟列”移除了这个限制,允许分区键通过使用一个或多个表的列的表达式进行定义,虚拟列仅作为元数据存储。
如:向表ACCOUNTS添加一个虚拟列:✓分区顾问Oracle 11g也提供了分区顾问,它支持生成分区建议,与10g中为物理视图、物理视图日志和索引提供建议类似,实际上,分区顾问是Oracle 11g中SQL 访问顾问的一部分,这个顾问帮助生成建议,它将预先收集实施分区后的性能,它还生成创建高效分区的脚本,可以手动通过SQL*plus或通过企业管理器队列提交给Oracle。
分区表的创建范围分区将数据基于范围映射到每一个分区,这个范围是你在创建分区时指定的分区键决定的。
这种分区方式是最为常用的,并且分区键经常采用日期。
当使用范围分区时,请考虑以下几个规则:1、每一个分区都必须有一个VALUES LESS THEN子句,它指定了一个不包括在该分区中的上限值。
分区键的任何值等于或者大于这个上限值的记录都会被加入到下一个高一些的分区中。
2、所有分区,除了第一个,都会有一个隐式的下限值,这个值就是此分区的前一个分区的上限值。
3、在最高的分区中,MAXVALUE被定义。
MAXVALUE代表了一个不确定的值。
这个值高于其它分区中的任何分区键的值,也可以理解为高于任何分区中指定的VALUE LESS THEN的值,同时包括空值。
范围分区就是对数据表中的某个值的范围进行分区,根据某个值的范围,决定将该数据存储在哪个分区上。
如根据序号分区,根据业务记录的创建日期进行分区等。
根据序号分区建表:SQL> create table dinya_test2 (3 transaction_id number primary key,4 item_id number(8) not null,5 item_description varchar2(300),6 transaction_date date not null7 )8 partition by range (transaction_id)9 (10 partition part_01 values less than(30000000) tablespace dinya_space01,11 partition part_02 values less than(60000000) tablespace dinya_space02,12 partition part_03 values less than(maxvalue) tablespace dinya_space0313 );Table created.根据交易的序号,交易ID在三千万以下的记录将存储在第一个表空间dinya_space01中,分区名为:par_01,在三千万到六千万之间的记录存储在第二个表空间:dinya_space02中,分区名为:par_02,而交易ID在六千万以上的记录存储在第三个表空间dinya_space03中,分区名为par_03.根据交易日期分区建表:SQL> create table dinya_test2 (3 transaction_id number primary key,4 item_id number(8) not null,5 item_description varchar2(300),6 transaction_date date not null7 )8 partition by range (transaction_date)9 (10 partition part_01 values less than(to_date(’2006-01-01’,’yyyy-mm-dd’))tablespace dinya_space01,11 partition pa rt_02 values less than(to_date(’2010-01-01’,’yyyy-mm-dd’))tablespace dinya_space02,12 partition part_03 values less than(maxvalue) tablespace dinya_space0313 );Table created.这样我们就分别建了以交易序号和交易日期来分区的分区表。
每次插入数据的时候,系统将根据指定的字段的值来自动将记录存储到制定的分区(表空间)中。
当然,我们还可以根据需求,使用两个字段的范围分布来分区,如partition by range ( transaction_id ,transaction_date), 分区条件中的值也做相应的改变。
Hash分区(散列分区)是在列值上使用散列算法,以确定将行放入哪个分区中。
当列的值没有合适的条件时,建议使用散列分区。
散列分区为通过指定分区编号来均匀分布数据的一种分区类型,因为通过在I/O设备上进行散列分区,使得这些分区大小一致。
散列分区为通过指定分区编号来均匀分布数据的一种分区类型,因为通过在I/O设备上进行散列分区,使得这些分区大小一致。
如将物料交易表的数据根据交易ID散列地存放在指定的三个表空间中:SQL> create table dinya_test2 (3 transaction_id number primary key,4 item_id number(8) not null,5 item_description varchar2(300),6 transaction_date date7 )8 partition by hash(transaction_id)9 (10 partition part_01 tablespace dinya_space01,11 partition part_02 tablespace dinya_space02,12 partition part_03 tablespace dinya_space0313 );Table created.hash分区最主要的机制是根据hash算法来计算具体某条纪录应该插入到哪个分区中, hash算法中最重要的是hash函数,Oracle中如果你要使用hash分区,只需指定分区的数量即可。
建议分区的数量采用2的n次方,这样可以使得各个分区间数据分布更加均匀.复合分区有时候我们需要根据范围分区后,每个分区内的数据再散列地分布在几个表空间中,这样我们就要使用复合分区。
复合分区是先使用范围分区,然后在每个分区内再使用散列分区的一种分区方法,如将物料交易的记录按时间分区,然后每个分区中的数据分三个子分区,将数据散列地存储在三个指定的表空间中:SQL> create table dinya_test2 (3 transaction_id number primary key,4 item_id number(8) not null,5 item_description varchar2(300),6 transaction_date date7 )8 partition by range(transaction_date)subpartition by hash(transaction_id)9 subpartitions 3 store in (dinya_space01,dinya_space02,dinya_space03)10 (11 partition part_01 values less than(to_date(’2006-01-01’,’yyyy-mm-dd’)),12 partition part_02 values less than(to_date(’2010-01-01’,’yyyy-mm-dd’)),13 partition part_03 values less than(maxvalue)14 );Table created.该例中,先是根据交易日期进行范围分区,然后根据交易的ID将记录散列地存储在三个表空间中。
oracle分表机制

Oracle的分表机制主要是通过分区表(Partitioned Table)来实现的。
分区表是一种特殊的数据库对象,它可以将一张大表分割成多个小表,这些小表在逻辑上是一个整体,在物理上可以存储在不同的表空间中。
分区表可以提高查询效率,简化数据管理,提高数据可用性。
Oracle的分区表主要有如下特点:
1. 分区表的数据可以分散存储在多个表空间中,可以提高并发处理能力和查询性能。
2. 分区表可以按照时间、范围或者其他方式进行分区,便于数据的管理和维护。
3. 分区表在逻辑上是一个表,对应用来说是透明的,应用程序可以直接访问分区表,无需知道数据具体存储在哪里。
Oracle的分区表可以通过两种方式创建:
1. 静态分区:在创建表的时候就定义好分区,分区键必须是在创建表时定义的列。
2. 动态分区:在表创建后还可以进行分区,分区键可以是表中的任何列。
总的来说,Oracle的分表机制通过分区表可以提高数据库的处理能力,提高数据的可用性和管理性。
oracle表分区创建
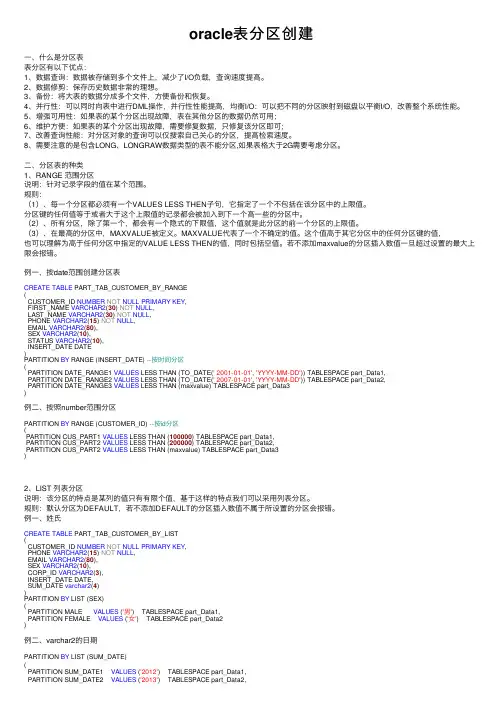
oracle表分区创建⼀、什么是分区表表分区有以下优点:1、数据查询:数据被存储到多个⽂件上,减少了I/O负载,查询速度提⾼。
2、数据修剪:保存历史数据⾮常的理想。
3、备份:将⼤表的数据分成多个⽂件,⽅便备份和恢复。
4、并⾏性:可以同时向表中进⾏DML操作,并⾏性性能提⾼,均衡I/O:可以把不同的分区映射到磁盘以平衡I/O,改善整个系统性能。
5、增强可⽤性:如果表的某个分区出现故障,表在其他分区的数据仍然可⽤;6、维护⽅便:如果表的某个分区出现故障,需要修复数据,只修复该分区即可;7、改善查询性能:对分区对象的查询可以仅搜索⾃⼰关⼼的分区,提⾼检索速度。
8、需要注意的是包含LONG、LONGRAW数据类型的表不能分区,如果表格⼤于2G需要考虑分区。
⼆、分区表的种类1、RANGE 范围分区说明:针对记录字段的值在某个范围。
规则:(1)、每⼀个分区都必须有⼀个VALUES LESS THEN⼦句,它指定了⼀个不包括在该分区中的上限值。
分区键的任何值等于或者⼤于这个上限值的记录都会被加⼊到下⼀个⾼⼀些的分区中。
(2)、所有分区,除了第⼀个,都会有⼀个隐式的下限值,这个值就是此分区的前⼀个分区的上限值。
(3)、在最⾼的分区中,MAXVALUE被定义。
MAXVALUE代表了⼀个不确定的值。
这个值⾼于其它分区中的任何分区键的值,也可以理解为⾼于任何分区中指定的VALUE LESS THEN的值,同时包括空值。
若不添加maxvalue的分区插⼊数值⼀旦超过设置的最⼤上限会报错。
例⼀,按date范围创建分区表CREATE TABLE PART_TAB_CUSTOMER_BY_RANGE(CUSTOMER_ID NUMBER NOT NULL PRIMARY KEY,FIRST_NAME VARCHAR2(30) NOT NULL,LAST_NAME VARCHAR2(30) NOT NULL,PHONE VARCHAR2(15) NOT NULL,EMAIL VARCHAR2(80),SEX VARCHAR2(10),STATUS VARCHAR2(10),INSERT_DATE DATE)PARTITION BY RANGE (INSERT_DATE) --按时间分区(PARTITION DATE_RANGE1 VALUES LESS THAN (TO_DATE(' 2001-01-01', 'YYYY-MM-DD')) TABLESPACE part_Data1,PARTITION DATE_RANGE2 VALUES LESS THAN (TO_DATE(' 2007-01-01', 'YYYY-MM-DD')) TABLESPACE part_Data2,PARTITION DATE_RANGE3 VALUES LESS THAN (maxvalue) TABLESPACE part_Data3)例⼆、按照number范围分区PARTITION BY RANGE (CUSTOMER_ID) --按id分区(PARTITION CUS_PART1 VALUES LESS THAN (100000) TABLESPACE part_Data1,PARTITION CUS_PART2 VALUES LESS THAN (200000) TABLESPACE part_Data2,PARTITION CUS_PART2 VALUES LESS THAN (maxvalue) TABLESPACE part_Data3)2、LIST 列表分区说明:该分区的特点是某列的值只有有限个值,基于这样的特点我们可以采⽤列表分区。
oracle的list表分区注意事项
oracle的list表分区注意事项以Oracle的List表分区注意事项为标题,写一篇文章在Oracle数据库中,表分区是一种将大型表分割为更小、更可管理的部分的技术。
这可以提高查询性能、简化数据维护和管理,并且可以根据特定的业务需求进行灵活的数据访问和操作。
本文将重点介绍Oracle的List表分区,并提供一些需要注意的事项。
一、什么是List表分区List表分区是一种基于指定的列值进行分区的方法。
它允许我们根据预定义的列表值将表中的数据分割成多个分区。
每个分区都包含一个或多个特定的列表值,这些值由用户在创建表时指定。
通过将数据分散到不同的分区中,我们可以更有效地管理和查询数据。
二、List表分区的好处1. 提高查询性能:通过将数据分散到不同的分区中,可以减少查询的数据量,从而提高查询性能。
2. 简化数据维护和管理:由于数据被分割成多个分区,可以更容易地对特定的分区进行维护和管理,而无需对整个表进行操作。
3. 灵活的数据访问和操作:List表分区允许我们根据特定的列表值对数据进行访问和操作,这样可以更灵活地满足不同的业务需求。
三、List表分区的注意事项在使用List表分区时,有一些需要注意的事项,以确保分区的有效和正确运行。
1. 分区列选择:选择适合的分区列非常重要。
分区列应该是经常用于查询和过滤的列,同时也应具有较高的区分度。
这样可以确保数据在分区中分布均匀,避免数据倾斜问题。
2. 分区值定义:在创建表时,需要明确指定每个分区所包含的列表值。
这些值应该是互斥的,不能存在重叠的情况。
否则,可能会导致数据重复或无法查询的问题。
3. 分区的命名规范:为每个分区指定一个有意义的名称是非常重要的。
这样可以更容易地识别和理解每个分区的含义,以及与特定业务需求的对应关系。
4. 分区的数量和大小:根据数据量和查询需求,合理确定分区的数量和大小。
过多的分区可能会导致管理和维护的复杂性增加,而过少的分区可能无法满足性能和灵活性的要求。
oracle分区应用详解

分区应用详解一、概述:1、分区:将表数据划分成更小的子集。
经验:在一个表的数据超过2000万条或占用2G 空间时,建议建立分区表。
2、好处:1)提高可用性。
如100GB 的表,如果划分成2G 的50个分区,只要查询的数据所处的分区online,而其他的分区可以是offline,数据库依然工作正常。
2)减轻管理负担。
对分区数据的维护,比如删除、更新、分析、数据恢复等,可以以分区为单位进行维护。
3)提高DML 和查询操作性能。
利用CBO 的分区排除机制,跳过未含有相关数据的表分区,减少I/O。
分区表使用CBO,CBO 具有很好的“分区意识能力”,直接排除不属于查询结果的分区。
(注:分区键列上同样不能应用函数,否则不会使用索引)对于分区的表,应尽可能的利用分区键作为查询条件,不然会执行full table scan,会比不分区的全表扫描花费更多的时间,失去分区的意义。
3、分区信息可查询:select *from user_tab_partitions;(比如小区表,可以按小时分区,小时里再按hash 分区防止分区不均匀,此时再对各分区进行truncate 等维护,可提高性能)二、操作:1、创建分区分区可分为如下几种:(范围分区,hash 分区,列表分区,范围-hash 分区,范围-列表分区等)Al l R i ght sR ese r vedA、范围分区使用列值的范围来确定一个数据行被插入到那个分区中。
1)分区键最多可16列,一个表最多可65636个分区。
2)分区范围中不能有任何空隙。
3)每个分区中,等于上限的值都是存储在上一个分区中的。
4)less then 子句指定的值,必须是一个用RPAD 函数填充过的值、日期(必须包含世纪)或常数。
5)分区表不能包含带有long,long raw 的数据列。
6)试图插入一个无法放入任一分区的数据,都导致ORA-14400错误。
7)通过更新数据使数据在分区间移动不被允许,除非创建表的时候指定了enable row movement 子局。
oracle partition用法

oracle partition用法Oracle Partition是Oracle数据库中的一项功能,允许将表或索引分割成多个逻辑分区,这样可以更好地管理和维护大型数据集。
使用Oracle Partition的好处包括:1. 提高查询性能:根据分区键,Oracle可以只查询特定分区上的数据,而不需要扫描整个表。
这样可以显著减少查询时间,提高查询性能。
2. 支持更有效的数据维护:可以对特定分区进行数据加载、删除、备份和恢复,而不会影响其他分区。
这样可以加快数据维护的速度,并且减少维护操作对整个表的影响。
3. 改善数据安全性和可用性:可以将不同的分区存储在不同的存储介质上,例如将热数据存储在高性能存储中,将冷数据存储在低成本存储中。
这样可以根据数据的访问模式和重要性进行优化,提高数据安全性和可用性。
使用Oracle Partition时,需要定义分区策略和分区键。
分区策略定义如何将表或索引分割成多个分区,例如按范围、按列表或按哈希等方式进行分割。
分区键则是定义用于分割的列或表达式,根据这个键的值将数据放入不同的分区中。
以下是一个创建分区表的示例:CREATE TABLE sales(sale_id NUMBER,product VARCHAR2(50),sale_date DATE,amount NUMBER)PARTITION BY RANGE (sale_date)(PARTITION sales_q1 VALUES LESS THAN (TO_DATE('01-APR-2021', 'DD-MON-YYYY')),PARTITION sales_q2 VALUES LESS THAN (TO_DATE('01-JUL-2021', 'DD-MON-YYYY')),PARTITION sales_q3 VALUES LESS THAN (TO_DATE('01-OCT-2021', 'DD-MON-YYYY')),PARTITION sales_q4 VALUES LESS THAN (TO_DATE('01-JAN-2022', 'DD-MON-YYYY')));这个示例中,sales表被按照销售日期进行范围分区,分成了四个分区sales_q1、sales_q2、sales_q3和sales_q4。
Oracle表分区的优缺点及有哪些分区类型

Oracle表分区的优缺点及有哪些分区类型分区表的作⽤:Oracle 的表分区功能可以使某些查询以及维护操作的性能⼤⼤提⾼分区表优缺点:(1)由于将数据分散到各个分区中,减少了数据损坏的可能性;(2)可以对单独的分区进⾏备份和恢复;(3)可以将分区映射到不同的物理磁盘上,来分散 IO;(4)提⾼可管理性、可⽤性和性能。
(5)缺点:已经存在的表没有⽅法可以直接转化为分区表。
不过 Oracle 提供了在线重定义表的功能。
(6)特殊性:含有 LONG、LONGRAW 数据类型的表不能进⾏分区,⼀般分区类型为:varchar,varchar2,number,date (7)每个表的分区或⼦分区数的总数不能超过 1023 个。
什么时候⽤分区表(设计原则):(1)单表过⼤,当表的⼤⼩超过 2GB,或对于 OLTP 系统,表的记录超过 1000 万,都应考虑对表进⾏分区。
(2)历史数据据需要剥离的,表中包含历史数据,新的数据被增加到新的分区中。
(3)查询特征⾮常明显,⽐如是按整年、整⽉或者按某个范围!(4)基于表的⼤部分查询应⽤,只访问表中少量的数据。
(5)按时间段删除成批的数据,例如按⽉删除历史数据。
(6)按时间周期进⾏表空间的备份时,将分区与表空间建⽴对应关系。
(7)如果⼀个表中⼤部分数据都是只读数据,通过对表进⾏分区,可将只读数据存储在只读表空间中,对于⼤数据库的备份是⾮常有益的。
(8)对于经常执⾏并⾏查询的表应考虑进⾏分区。
(9)当对表的部分数据可⽤性要求很⾼时,应考虑进⾏表分区。
分区表的类型:(1)范围分区(Range Partitioning) 8i+,以某⼀个范围进⾏分区。
eg:时间段划分。
(2)列表分区(List Partitioning) 9i+,以某⼀些⼏个值进⾏分区。
eg:地区分区,省份进⾏划分。
(3)哈希分区(Hash Partitioning),8i+,根据 hash 值进⾏的散列分区,可以有效的消除 io 的竞争。
多做知识的积累 详解ORACLE数据库的分区表
多做知识的积累详解ORACLE数据库的分区表此文从以下几个方面来整理关于分区表的概念及操作: 1.表空间及分区表的概念2.表分区的具体作用3.表分区的优缺点4.表分区的几种类型及操作方法5.对表分区的维护性操作.(1.) 表空间及分区表的概念表空间:是一个或多个数据文件的集合,所有的数据对象都存放在指定的表空间中,但主要存放的是表,所以称作表空间。
分区表:当表中的数据量不断增大,查询数据的速度就会变慢,应用程序的性能就会下降,这时就应该考虑对表进行分区。
表进行分区后,逻辑上表仍然是一张完整的表,只是将表中的数据在物理上存放到多个表空间(物理文件上),这样查询数据时,不至于每次都扫描整张表。
( 2).表分区的具体作用Oracle的表分区功能通过改善可管理性、性能和可用性,从而为各式应用程序带来了极大的好处。
通常,分区可以使某些查询以及维护操作的性能大大提高。
此外,分区还可以极大简化常见的管理任务,分区是构建千兆字节数据系统或超高可用性系统的关键工具。
分区功能能够将表、索引或索引组织表进一步细分为段,这些数据库对象的段叫做分区。
每个分区有自己的名称,还可以选择自己的存储特性。
从数据库管理员的角度来看,一个分区后的对象具有多个段,这些段既可进行集体管理,也可单独管理,这就使数据库管理员在管理分区后的对象时有相当大的灵活性。
但是,从应用程序的角度来看,分区后的表与非分区表完全相同,使用 SQL DML 命令访问分区后的表时,无需任何修改。
什么时候使用分区表:1、表的大小超过2GB。
2、表中包含历史数据,新的数据被增加都新的分区中。
(3).表分区的优缺点表分区有以下优点:1、改善查询性能:对分区对象的查询可以仅搜索自己关心的分区,提高检索速度。
2、增强可用性:如果表的某个分区出现故障,表在其他分区的数据仍然可用;3、维护方便:如果表的某个分区出现故障,需要修复数据,只修复该分区即可;4、均衡I/O:可以把不同的分区映射到磁盘以平衡I/O,改善整个系统性能。
oracle的分区字段
oracle的分区字段
摘要:
1.Oracle 分区字段的概述
2.Oracle 分区字段的作用
3.Oracle 分区字段的实现方式
4.Oracle 分区字段的优缺点
5.Oracle 分区字段的应用案例
正文:
【Oracle 分区字段的概述】
Oracle 分区字段是Oracle 数据库中一种重要的数据组织方式,可以将大表按照某个或多个列的值进行划分成不同的分区,以提高查询效率和存储空间利用率。
【Oracle 分区字段的作用】
1.提高查询效率:通过分区字段,可以快速定位到所需的数据,减少全表扫描的时间。
2.提高存储空间利用率:分区字段可以将数据分散到不同的物理存储设备上,避免数据浪费和存储空间不足的问题。
【Oracle 分区字段的实现方式】
1.范围分区:根据分区字段的值范围将数据划分为不同的分区。
2.列表分区:将分区字段的值作为分区名称,创建多个分区。
3.组合分区:将多个分区字段组合起来,形成更细粒度的分区。
【Oracle 分区字段的优缺点】
1.优点:提高查询效率,减少I/O 操作,便于数据管理。
2.缺点:分区过多可能导致维护困难,同时分区字段的选择需要谨慎,以免影响数据均匀分布。
【Oracle 分区字段的应用案例】
1.大表查询:对于存储大量数据的表,通过设置分区字段,可以快速定位到所需的数据,提高查询效率。
2.数据备份与恢复:分区字段可以帮助用户快速备份和恢复数据,减少备份和恢复的时间。
3.数据分析:通过对分区字段的统计和分析,可以更好地了解数据分布情况,为数据挖掘和分析提供支持。
oracle表分区详解
一、Oracle分区简介ORACLE的分区是一种处理超大型表、索引等的技术。
分区是一种“分而治之”的技术,通过将大表和索引分成可以管理的小块,从而避免了对每个表作为一个大的、单独的对象进行管理,为大量数据提供了可伸缩的性能。
分区通过将操作分配给更小的存储单元,减少了需要进行管理操作的时间,并通过增强的并行处理提高了性能,通过屏蔽故障数据的分区,还增加了可用性。
二、Oracle分区优缺点优点:增强可用性:如果表的某个分区出现故障,表在其他分区的数据仍然可用;维护方便:如果表的某个分区出现故障,需要修复数据,只修复该分区即可;均衡I/O:可以把不同的分区映射到磁盘以平衡I/O,改善整个系统性能;改善查询性能:对分区对象的查询可以仅搜索自己关心的分区,提高检索速度。
缺点:分区表相关:已经存在的表没有方法可以直接转化为分区表。
不过Oracle 提供了在线重定义表的功能。
三、Oracle分区方法范围分区:范围分区就是对数据表中的某个值的范围进行分区,根据某个值的范围,决定将该数据存储在哪个分区上。
如根据序号分区,根据业务记录的创建日期进行分区等。
Ha sh分区(散列分区):散列分区为通过指定分区编号来均匀分布数据的一种分区类型,因为通过在I/O设备上进行散列分区,使得这些分区大小一致。
List分区(列表分区):当你需要明确地控制如何将行映射到分区时,就使用列表分区方法。
与范围分区和散列分区所不同,列表分区不支持多列分区。
如果要将表按列分区,那么分区键就只能由表的一个单独的列组成,然而可以用范围分区或散列分区方法进行分区的所有的列,都可以用列表分区方法进行分区。
范围-散列分区(复合分区):有时候我们需要根据范围分区后,每个分区内的数据再散列地分布在几个表空间中,这样我们就要使用复合分区。
复合分区是先使用范围分区,然后在每个分区内再使用散列分区的一种分区方法(注意:先一定要进行范围分区)范围-列表分区(复合分区):范围和列表技术的组合,首先对表进行范围分区,然后用列表技术对每个范围分区再次分区。
1、简述分区表的概念及其优势
1、简述分区表的概念及其优势
分区表是数据库中常用的一种数据管理技术,它将一张表中的数据按照某种规则划分为不同的部分,每个部分称为一个分区。
每个分区可以独立地存储在物理磁盘上,这样就可以提高查询效率、维护和管理数据的便利性。
分区表的优势如下:
1. 提高查询效率:通过将数据划分为不同的分区,可以只查询与查询条件匹配的分区,减少数据的扫描量,提高查询效率。
例如,如果一个表按照日期进行分区,那么在查询特定日期的数据时,只需要扫描对应日期的分区,而不是整个表。
2. 维护和管理便利:当某个分区的数据量过大时,可以单独对该分区进行维护和管理,如备份、恢复等操作,而不会影响其他分区的正常运行。
这使得数据的维护和管理更加灵活和高效。
3. 降低存储空间:通过将数据划分为不同的分区,可以更好地利用存储空间,避免数据的浪费。
例如,如果一个表按照日期进行分区,那么在删除旧数据时,
只需要删除对应日期的分区,而不是整个表。
4. 提高数据可靠性:当某个分区出现故障时,可以单独对该分区进行恢复,而不会影响其他分区的正常运行。
这使得数据的可靠性更高,因为即使某个分区出现故障,其他分区的数据仍然可以正常访问和使用。
分区表是一种有效的数据管理技术,可以提高查询效率、维护和管理数据的便利性,降低存储空间和提高数据可靠性。
在实际应用中,可以根据具体的需求和场景选择合适的分区策略和算法,以实现更好的数据管理和应用效果。