
常见SQL语句优化
连接的次序
如果A表与B表存在多对一或一对一的关系,则 下面的语句有区别:
下面SQL低效: Select * from A
where A.CITY in (select B.City from B) 下面语句高效:
Select A.* from A, B
2016年5月6日
Oracle SQL语句优化
11/25
不推荐语句-少用ORDER BY
如要对结果进行排序,可考虑几种情况 :
必须排序吗?; 结果集多大; 导致临时表空间的使用; 尽可能在内存完成排序 ALTER SESSION SET SORT_AREA_SIZE=2048000;
18/25
推荐方法-变量与类型
变量类型与表的列的类型差异 :
避免变量类型与表的列的类型不同带来的转 换问题; 不要定义了变量但不使用;
Oracle新变量类型:
用BINARY_DOUBLE 替代NUMBER类型; 用BINARY_FLOAT 替代NUMBER类型
2016年5月6日
8/25
不推荐语句-动态语句
关于动态语句:
Oracle 在PL/SQL中可用动态; Oracle系统动态在必须用才用,动态就是性能 问题; 不建议在4GL等工具大量使用 SQL语句
一般不能用静态才使用动态:
DROP TABLESPACE TRUNCATE TABLE …
2016年5月6日 Oracle SQL语句优化 9/25
2016年5月6日
Oracle SQL语句优化
14/25
不推荐语句- MOD
Oracle有些内置函数开销大,MOD是一个 :
在IF 中使用MOD,就产生不必要的开销 BEGIN …
Stop_watch.start_timer; FOR lv_count_num IN 1 .. 10000 LOOP IF MOD(lv_count_num,1000) = 0 THEN; DBMS_OUTPUT.PUT_LINE(‘Hit 1000;Total:’ |lv_count_num) END LOOP; Stop_watch.stop_timer; DECLARE Lv_count_inc_num PLS_INTEGER := 0 ; END; BEGIN / Stop_watch.start_timer; FOR lv_count_num IN 1 .. 10000 LOOP Lv_count_inc_num := Lv_count_inc_num +1; IF lv_count_num=1000 THEN; DBMS_OUTPUT.PUT_LINE(‘Hit 1000;Total:’ |lv_count_num) Lv_count_inc_num := 0; END IF; END LOOP; 15/25 2016年5月6日 Oracle SQL语句优化 Stop_watch.stop_timer;
17/25
推荐方法-巧用ROWID
Oracle ROWID可立即确定行的位置 :
用ROWID对表的相应行进行更新:
--使用 empid 列进行更新的例子: DECLARE CURSOR cur_employee IS SELECT empno,sal ,ROWID FROM EMP ; Lv_new_salary_num NUMBER; BEGIN Stop_watch.start_timer; FOR cur_rec IN cur_employee LOOP --确定工资增长 Lv_new_salary_num := cur_rec.salary ; UPDATE emp SET salary =lv_new_salary_num WHERE employee_id = cur_rec.ROWID; END LOOP; COMMIT; Stop_watch.stop_timer; END; 2016年5月6日 Oracle SQL语句优化 /
13/25
不推荐语句-SYSDATE
Oracle内置函数SYSDATE产生意些开销 :
SYSDATE可在循环开始时用,在循序尽量避免, 如下面量个例子:
DECLARE Lv_current_date DATE := TRUNC(SYSDATE); Lv_final_date DATE; BEGIN Stop_watch.start_timer; FOR lv_count_num IN 1 .. 10000 LOOP Lv_final_date := Lv_current_date END LOOP; Stop_watch.stop_timer; END; /
2016年5月6日 Oracle SQL语句优化 16/25
推荐方法-巧用ROWID
Oracle ROWID可立即确定行的位置 :
下面例子用一般方法对数据行更新:
--使用 empid 列进行更新的例子: DECLARE CURSOR cur_employee IS SELECT empno,sal FROM EMP ; Lv_new_salary_num NUMBER; BEGIN Stop_watch.start_timer; FOR cur_rec IN cur_employee LOOP --确定工资增长 Lv_new_salary_num := cur_rec.salary ; UPDATE emp SET salary =lv_new_salary_num WHERE employee_id = cur_rec.employee.id; END LOOP; COMMIT; Stop_watch.stop_timer; END; 2016 年5月6日 Oracle SQL语句优化
WHERE子句的连接顺序
采用自下而上的顺序解析WHERE子句 ; 表之间连接必须写在其他WHERE条件之前; 那些可以过滤掉最大数量记录的条件必须写在 WHERE子句的末尾。
例1( 低效): SELECT … FROM EMP E WHERE SAL > 50000 AND JOB = ‘MANAGER’ AND 25 < ( SELECT COUNT(*) FROM EMP WHERE MGR=E.EMPNO); 例2(高效): SELECT … FROM EMP E WHERE 25 < ( SELECT COUNT(*) FROM EMP WHERE MGR=E.EMPNO) AND SAL > 50000 AND JOB = ‘MANAGER’;
Oracle SQL语句优化
20/25
推荐方法-临时表的使用
如要将一些中间结果在会话中使用,不要采用 永久表,要用临时表 :
在会话中有效; 数据可自动存入临时表空间; 不影响永久表空间; …
2016年5月6日
Oracle SQL语句优化
21/25
推荐方法-尽可能用MINUS
MINUS可替代NOT IN:
不推荐语句-COMMIT
完整性下多用COMMIT语句:
确保数据完整前提下,释放程序语句获得的锁 redo log buffer 中的空间 ORACLE为管理上述3种资源中的内部花费
2016年5月6日
Oracle SQL语句优化
10/25
不推荐语句-少用LIKE
字符串的匹配:
要少用 like '%..%'(不以 % 开头 ) ; 当对于 like '%...' 的 (不以 % 结尾);
推荐方法-DECODE函数
Oracle 所有版本都支持DECODE :
DECODE表示译码,可快速将某个列的值转换成对 应的结果; DECODE比IF THEN高效; …
select sid,serial#,username, DECODE(command, 0,’None’, 2,’Insert’, 3,’Select’, 6,’Update’, 7,’Delete’, 8,’Drop’, ‘Other’) cmmand from v$session where username is not null;
Oracle Database 几个常见SQL优化
内容提要
FROM子句与WHERE子句顺序 几个不推荐与推荐方法 实体视图与查询重写 新SQL语句使用建议 编码人员与表结构的理解
2016年5月6日
Oracle SQL语句优化
2/25
FROM多表的顺序
ORACLE的解析器按照从右到左的顺序 FROM子句中写在最后的表(基础表 driving table)将被最先处理 ; 选择记录条数最少的表作为基础表
Oracle SQL语句优化
19/25
推荐方法-自制临时表
Oracle 要从一个经过多次修改的表与另外进行 关联,可能因为关键的表的数据过于分散而效 率低下,下面方法可能是一个选择 :
创建一个表空间; 将关联的创建为一个新的表存储在新表空间里; 用这个临时的表进行关联查询 …
2016年5月6日
例2(效率低): SELECT * FROM EMP E , LOCATION L , CATEGORY C WHERE E.CAT_NO = C.CAT_NO AND E.LOCN = L.LOCN AND E.EMP_NO BETWEEN 1000 AND 2000;
2016年5月6日 Oracle SQL语句优化 4/25
DECLARE Lv_current_date DATE; BEGIN Stop_watch.start_timer; FOR lv_count_num IN 1 .. 10000 LOOP Lv_current_date := TRUNC(SYSDATE); END LOOP; Stop_watch.stop_timer; END; /
sql优化in和notin语句
sql优化in和notin语句WHY?IN 和 NOT IN 是⽐较常⽤的关键字,为什么要尽量避免呢?1、效率低可以参看我之前遇到的⼀个例⼦()2、容易出现问题,或查询结果有误(不能更严重的缺点)以 IN 为例。
建两个表:test1 和 test2create table test1 (id1 int)create table test2 (id2 int)insert into test1 (id1) values (1),(2),(3)insert into test2 (id2) values (1),(2)我想要查询,在test2中存在的 test1中的id 。
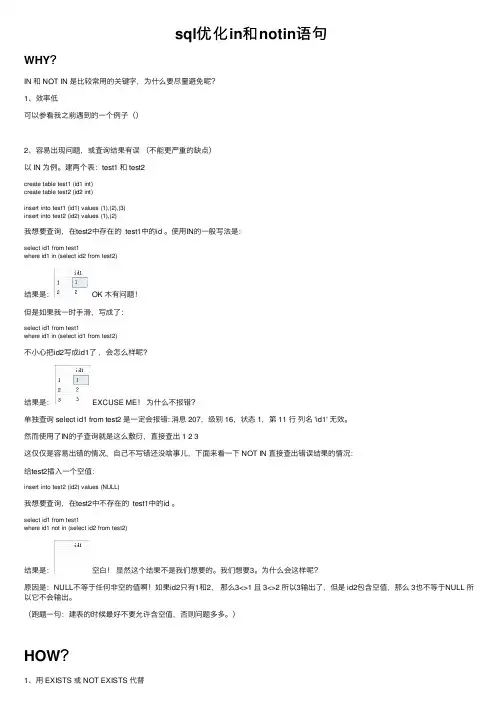
使⽤IN的⼀般写法是:select id1 from test1where id1 in (select id2 from test2)结果是: OK ⽊有问题!但是如果我⼀时⼿滑,写成了:select id1 from test1where id1 in (select id1 from test2)不⼩⼼把id2写成id1了,会怎么样呢?结果是: EXCUSE ME!为什么不报错?单独查询 select id1 from test2 是⼀定会报错: 消息 207,级别 16,状态 1,第 11 ⾏列名 'id1' ⽆效。
然⽽使⽤了IN的⼦查询就是这么敷衍,直接查出 1 2 3这仅仅是容易出错的情况,⾃⼰不写错还没啥事⼉,下⾯来看⼀下 NOT IN 直接查出错误结果的情况:给test2插⼊⼀个空值:insert into test2 (id2) values (NULL)我想要查询,在test2中不存在的 test1中的id 。
select id1 from test1where id1 not in (select id2 from test2)结果是:空⽩!显然这个结果不是我们想要的。
我们想要3。
为什么会这样呢?原因是:NULL不等于任何⾮空的值啊!如果id2只有1和2,那么3<>1 且 3<>2 所以3输出了,但是 id2包含空值,那么 3也不等于NULL 所以它不会输出。
sql server 语句优化题目
题目:SQL Server 语句优化随着数据量的增加和数据库应用的复杂化,SQL Server 数据库在使用过程中可能会出现性能下降的情况,而对于性能下降的根本原因通常可以追溯到 SQL 语句的性能不佳。
对 SQL Server 数据库中的 SQL 语句进行优化显得尤为重要。
本文将从 SQL 语句的优化方法、常见优化技巧和注意事项等方面展开探讨。
一、SQL 语句优化的方法1. 了解执行计划在进行 SQL 语句优化时,首先需要了解 SQL 语句的执行计划。
执行计划是 SQL Server 生成的一份详细的指导书,用于指导 SQL Server 如何执行查询。
通过查看执行计划,可以清晰地了解 SQL 语句的执行过程,找到执行效率低下的地方并进行相应的优化。
2. 使用索引索引是提高 SQL 查询效率的重要手段之一。
在 SQL 查询过程中,如果涉及到大量的数据表,没有索引的情况下,数据库引擎将对整个数据表进行扫描,导致查询性能低下。
正确使用索引可以大大提高 SQL 查询的效率。
但是,过多的索引也可能会导致性能下降,因此需要根据实际情况进行合理的索引设计和使用。
3. 优化 SQL 语句在编写 SQL 语句时,应尽量避免使用 SELECT *,而是明确指定需要查询的字段,减少不必要的数据传输和计算。
尽量将复杂的逻辑操作放到数据库层面完成,减少数据传输和网络开销,提高查询效率。
二、常见的 SQL 语句优化技巧1. 避免在 WHERE 子句中使用函数在 SQL 查询中,如果在 WHERE 子句中使用了函数,数据库引擎会对每一条记录都进行函数的计算,导致查询性能低下。
应尽量避免在WHERE 子句中使用函数,可以通过其他方法来达到相同的查询效果。
2. 使用 UNION ALL 替代 UNION在 SQL 查询中,如果使用 UNION 进行多个查询结果的合并,数据库引擎会进行重复数据的去重操作,导致性能下降。
而使用 UNION ALL 则可以避免重复数据的去重操作,提高查询效率。
sqlsqerver语句优化方法
sqlsqerver语句优化方法SQL Server是一种关系型数据库管理系统,可以使用SQL语句对数据进行操作和管理。
优化SQL Server语句可以提高查询和操作数据的效率,使得系统更加高效稳定。
下面列举了10个优化SQL Server语句的方法:1. 使用索引:在查询频繁的列上创建索引,可以加快查询速度。
但是要注意不要过度索引,否则会影响插入和更新操作的性能。
2. 避免使用SELECT *:只选择需要的列,避免不必要的数据传输和处理,提高查询效率。
3. 使用JOIN替代子查询:在进行关联查询时,使用JOIN操作比子查询更高效。
尽量避免在WHERE子句中使用子查询。
4. 使用EXISTS替代IN:在查询中使用EXISTS操作比IN操作更高效。
因为EXISTS只需要找到一个匹配的行就停止了,而IN需要对所有的值进行匹配。
5. 使用UNION替代UNION ALL:如果对多个表进行合并查询时,如果不需要去重,则使用UNION ALL操作比UNION操作更高效。
6. 使用TRUNCATE TABLE替代DELETE:如果要删除表中的所有数据,使用TRUNCATE TABLE操作比DELETE操作更高效。
因为TRUNCATE TABLE不会像DELETE一样逐行删除,而是直接删除整个表的数据。
7. 使用分页查询:在需要分页显示查询结果时,使用OFFSET和FETCH NEXT操作代替传统的使用ROW_NUMBER进行分页查询。
这样可以减少查询的数据量,提高效率。
8. 避免使用CURSOR:使用游标(CURSOR)会增加数据库的负载,降低查询效率。
如果可能的话,应该尽量避免使用游标。
9. 使用参数化查询:使用参数化查询可以减少SQL注入的风险,同时也可以提高查询的效率。
因为参数化查询会对SQL语句进行预编译,可以复用执行计划。
10. 定期维护数据库:定期清理过期数据、重建索引、更新统计信息等维护操作可以提高数据库的性能。
SQL优化工具及使用技巧介绍
SQL优化工具及使用技巧介绍SQL(Structured Query Language)是一种用于管理和操作关系型数据库的编程语言。
它可以让我们通过向数据库服务器发送命令来实现数据的增删改查等操作。
然而,随着业务的发展和数据量的增长,SQL查询的性能可能会受到影响。
为了提高SQL查询的效率,出现了许多SQL优化工具。
本文将介绍一些常见的SQL优化工具及其使用技巧。
一、数据库性能优化工具1. Explain PlanExplain Plan是Oracle数据库提供的一种SQL优化工具,它可以帮助分析和优化SQL语句的执行计划。
通过使用Explain Plan命令,我们可以查看SQL查询的执行计划,了解SQL语句是如何被执行的,从而找到性能瓶颈并进行优化。
2. SQL Server ProfilerSQL Server Profiler是微软SQL Server数据库管理系统的一种性能监视工具。
它可以捕获和分析SQL Server数据库中的各种事件和耗时操作,如查询语句和存储过程的执行情况等。
通过使用SQL Server Profiler,我们可以找到数据库的性能瓶颈,并进行相应的优化。
3. MySQL Performance SchemaMySQL Performance Schema是MySQL数据库提供的一种性能监视工具。
它可以捕获和分析MySQL数据库中的各种事件和操作,如查询语句的执行情况、锁的状态等。
通过使用MySQL Performance Schema,我们可以深入了解数据库的性能问题,并对其进行优化。
二、SQL优化技巧1. 使用索引索引是提高SQL查询性能的重要手段之一。
在数据库中创建合适的索引可以加快查询操作的速度。
通常,我们可以根据查询条件中经常使用的字段来创建索引。
同时,还应注意索引的维护和更新,避免过多或过少的索引对性能产生负面影响。
2. 避免全表扫描全表扫描是指对整个表进行扫描,如果表中数据量较大,查询性能会受到较大影响。
sql优化的8种方式

sql优化的8种⽅式1.设置索引。
MySQL索引操作:给表列创建索引:建表时创建索引:create table t(id int,name varchar(20),index idx_name (name));给表追加索引:alter table t add unique index idx_id(id);给表的多列上追加索引alter table t add index idx_id_name(id,name);或者:create index idx_id_name on t(id,name);查看索引使⽤show语句查看t表上的索引:show index from t;或者:show keys from t;–mysql中索引也被称作keys使⽤show create table语句查看索引:show create table t\G删除索引:使⽤alter table命令删除索引:alter table 表 drop index 索引名使⽤drop index命令删除索引:drop index 索引名 on 表索引原理:例如⼀个学⽣信息表,我们设置学号(stu_id)为索引:索引页之间存在⼀定的关联关系,⼀般为树形结构;分为根节点、分⽀节点、和叶⼦节点根节点页中存放分段stu_id的起始值,以及值所对应的分⽀索引页号分⽀索引页中存放分段stu_id的起始值,以及值所对应的叶⼦索引页号叶⼦索引页中存放排序后的stu_id值,该值所对应的表页号, 下⼀个叶⼦索引页的页号.2.使⽤EXPLAIN 来查看你的 SELECT 查询关于MySQL服务器是如何执⾏SQL语句的相关信息可以⽤explain语句来查看,可以⽤explain语句查看执⾏过程的语句主要有select、insert、update、delete等,其使⽤⽅式是explain后接具体的增删改查SQL语句。
例如:explain select * from test.t; 其返回形式为数据表,如下图所⽰:其中每个字段代表的含义如下:三、不要使⽤表达式作为查询条件使⽤采⽤表达式的⽅式作为查询条件,条件列中的索引会失效,即便返回⾏数⾮常少,优化器也会使⽤低效的全表扫⽅式来解析SQL语句;如果同样效果的语句采⽤⽅式⼆的写法,索引不会失效,查询效率⾼。
数据库调优如何让数据查询更快更准

数据库调优如何让数据查询更快更准在信息化时代,数据库成为了企业、组织存储重要数据的主要手段。
然而,随着数据量增大和使用频率加强,数据库查询响应时间变慢、查询结果准确率下降的问题愈发严重,因此数据库调优成为了必不可少的环节。
本文将介绍如何通过数据库调优让数据查询变得更快更准确。
一、优化SQL语句SQL语句是数据库操作的核心,尤其是数据查询,其效率是否高,直接影响到查询速度。
常见的SQL优化手段有:1. 尽可能的使用索引:索引可以让查询的速度大大加快,但是索引对于修改、删除等操作的性能会有所降低;因此,在选择索引时需要慎重。
2. 避免使用%匹配:在使用LIKE等模糊查询时,不要使用%开头,否则查询速度会大大降低,建议使用全文索引或者分词搜索。
3. 避免使用<>或NOT操作:这些操作需要扫描整个数据表,速度自然慢。
4. 使用多行INSERT替代单行INSERT:单行插入操作的效率低下,可通过使用多行INSERT一次性插入多条记录来提高效率。
二、合理配置数据库参数数据库的一些参数设置对于查询性能影响也非常大,比如缓存大小、线程池大小等。
在调优的时候,需要根据实际情况设置以下几个方面的参数:1. 设置缓存大小:缓存是提高查询效率的重要手段,通过将数据缓存在内存中,可以大大加快查询速度。
2. 设置线程池大小:线程池的大小设置合理可以提高并发查询效率,但是过大则会耗尽服务器资源,过小则会限制并发数。
3. 设置SQL缓存:SQL缓存可以把经常使用的SQL语句缓存到内存中,以提高查询速度。
三、适当分表随着数据量的增长,单个数据表的数据量也会越来越大,而对于一个庞大的数据表进行查询时,效率自然会下降。
因此,可以根据数据的特征,将其分散到多个数据表中,以提高查询效率。
同时,随着分表数量的增加,对于查询应该如何统计分表查询结果也需要进行优化。
四、使用缓存为了提高查询效率,可以使用缓存机制,当查询数据发生变化时,及时更新缓存数据。
SQL语句优化--OR语句优化案例
SQL语句优化--OR语句优化案例从上海来到温州,看了前⼏天监控的sql语句和数据变化,发现有⼀条语句的io次数很⼤,达到了150万次IO,⽽两个表的数据也就不到20万,为何有如此多的IO次数,下⾯是执⾏语句:select ws.nodeid,ststepid,wi.curstepid from Workflowinfo wi,Workflowstep ws where ws.workflowid='402881db1b441e6f011c0cff320e4766'and (ststepid = ws.id or (wi.curstepid = ws.id and isreceived=1and issubmited =1))执⾏IO统计结果如下:(22⾏受影响)表'workflowstep'。
扫描计数1,逻辑读取23次,物理读取0次,预读0次,lob 逻辑读取0次,lob 物理读取0次,lob 预读0次。
表'Worktable'。
扫描计数4,逻辑读取1490572次,物理读取0次,预读0次,lob 逻辑读取0次,lob 物理读取0次,lob 预读0次。
表'workflowinfo'。
扫描计数4,逻辑读取12208次,物理读取0次,预读0次,lob 逻辑读取0次,lob 物理读取0次,lob 预读0次。
表'Worktable'。
扫描计数0,逻辑读取0次,物理读取0次,预读0次,lob 逻辑读取0次,lob 物理读取0次,lob 预读0次。
执⾏计划如下:这⾥发现:主要是嵌套循环算法占的开销最⼤。
个⼈感觉是“Or”引起的性能问题,后来根据业务逻辑改写。
如下:语句修改如下:select ws.nodeid,ststepid,wi.curstepid from Workflowinfo wi, Workflowstep wswhere ws.workflowid='402881db1b441e6f011c0cff320e4766'and (ststepid = ws.id)union allselect ws.nodeid,ststepid,wi.curstepid from Workflowinfo wi, Workflowstep ws where ws.workflowid='402881db1b441e6f011c0cff320e4766'and (wi.curstepid = ws.id and isreceived=1查询IO次数如下:(22⾏受影响)表'workflowinfo'。
oracle sql优化常用的15种方法
oracle sql优化常用的15种方法1. 使用合适的索引索引是提高查询性能的重要手段。
在设计表结构时,根据查询需求和数据特点合理地添加索引。
可以通过创建单列索引、复合索引或者位图索引等方式来优化SQL查询。
2. 确保SQL语句逻辑正确SQL语句的逻辑错误可能会导致低效查询。
因此,在编写SQL语句前,需要仔细分析查询条件,确保逻辑正确性。
3. 使用连接替代子查询在一些场景下,使用连接(JOIN)操作可以替代子查询,从而减少查询的复杂度。
连接操作能够将多个数据集合合并为一个结果集,避免多次查询和表的扫描操作。
4. 避免使用通配符查询通配符查询(如LIKE '%value%')在一些情况下可能导致全表扫描,性能低下。
尽量使用前缀匹配(LIKE 'value%')或者使用全文索引进行模糊查询。
5. 注意选择合适的数据类型选择合适的数据类型有助于提高SQL查询的效率。
对于整型数据,尽量使用小范围的数据类型,如TINYINT、SMALLINT等。
对于字符串数据,使用CHAR字段而不是VARCHAR,可以避免存储长度不一致带来的性能问题。
6. 优化查询计划查询计划是数据库在执行SQL查询时生成的执行计划。
通过使用EXPLAIN PLAN命令或者查询计划工具,可以分析查询计划,找出性能瓶颈所在,并对其进行优化。
7. 减少磁盘IO磁盘IO是影响查询性能的重要因素之一。
可以通过增加内存缓存区(如SGA)、使用高速磁盘(如SSD)、使用合适的文件系统(如ASM)等方式来减少磁盘IO。
8. 分区表对于大数据量的表,可以考虑使用分区表进行查询优化。
分区表可以将数据按照某个规则分散到不同的存储区域,从而减少查询范围和加速查询。
9. 批量操作尽量使用批量操作而不是逐条操作,可以减少数据库的事务处理开销,提高SQL执行效率。
可以使用INSERT INTO SELECT、UPDATE、DELETE等批量操作语句来实现。
sql语句优化面试题
sql语句优化面试题在数据库开发和优化领域,SQL语句优化是一个重要的话题。
随着数据量的增长,SQL查询性能的优化变得尤为重要。
本文将介绍一些常见的SQL语句优化面试题,并提供一些解析和最佳实践。
1. 什么是SQL语句优化?SQL语句优化是为了提高数据库查询性能而对SQL查询语句进行的一系列改进和调整的过程。
通过对SQL查询进行优化,可以减少数据库的负载,加快查询速度,提升应用程序的性能。
2. SQL语句优化的方法有哪些?- 索引优化:为表中的关键列创建索引,并确保索引被合理地使用。
- 查询重写:通过改变查询方式或者重写查询语句,使其更加高效。
- 视图优化:使用视图来优化复杂的查询,减少重复性的计算和读取操作。
- 表分区:根据数据特性和查询模式将表划分成多个分区,提高查询效率。
- 缓存优化:通过使用缓存技术,减少对数据库的访问次数,加快查询速度。
3. 请列举一些常见的SQL查询性能问题。
- 缺乏合适的索引导致全表扫描,查询速度慢。
- 过多的连接操作导致查询复杂度高。
- 子查询嵌套层次过多,增加查询开销。
- 数据库统计信息不准确,导致查询优化器做出错误的执行计划。
- 数据库设计模型不合理,导致查询需要多次关联多个表。
4. 如何通过索引优化来提高查询性能?- 确保重要的查询列都有索引,特别是在WHERE和JOIN子句中经常使用的列。
- 避免在索引列上进行函数、计算或者转换操作,这会导致索引失效。
- 确保索引的列的顺序和查询条件的顺序一致,可以减少索引树的搜索次数。
- 如果一次查询中需要访问的数据较少,可以使用覆盖索引来避免对表的访问。
5. 如何避免SQL注入攻击?- 使用参数化查询或者预编译语句,将用户输入的数据作为参数传递给SQL查询。
- 对输入进行严格的合法性验证,过滤掉潜在的恶意字符。
- 使用ORM框架或者存储过程等抽象层来处理SQL查询,减少直接操作数据库的风险。
6. 如何优化复杂查询?- 尽量避免使用嵌套查询,可以使用关联查询或者临时表来替代。
SQL优化的几种方法及总结
SQL优化的⼏种⽅法及总结优化⼤纲:通过explain 语句帮助选择更好的索引和写出更优化的查询语句。
SQL语句中的IN包含的值不应该过多。
当只需要⼀条数据的时候,使⽤limit 1。
如果限制条件中其他字段没有索引,尽量少⽤or。
尽量⽤union all代替union。
不使⽤ORDER BY RAND()。
区分in和exists、not in和not exists。
使⽤合理的分页⽅式以提⾼分页的效率。
查询的数据过⼤,可以考虑使⽤分段来进⾏查询。
避免在where⼦句中对字段进⾏null值判断。
避免在where⼦句中对字段进⾏表达式操作。
必要时可以使⽤force index来强制查询⾛某个索引。
注意查询范围,between、>、<等条件会造成后⾯的索引字段失效。
关于JOIN优化。
优化使⽤1、mysql explane ⽤法 explane显⽰了mysql如何使⽤索引来处理select语句以及连接表。
可以帮助更好的索引和写出更优化的查询语句。
EXPLAIN SELECT*FROM l_line WHERE `status` =1and create_at >'2019-04-11';explain字段列说明table:显⽰这⼀⾏的数据是关于哪张表的type:这是重要的列,显⽰连接使⽤了何种类型。
从最好到最差的连接类型为const、eq_reg、ref、range、indexhe和allpossible_keys:显⽰可能应⽤在这张表中的索引。
如果为空,没有可能的索引。
可以为相关的域从where语句中选择⼀个合适的语句key:实际使⽤的索引。
如果为null,则没有使⽤索引。
很少的情况下,mysql会选择优化不⾜的索引。
这种情况下,可以在select语句中使⽤use index(indexname)来强制使⽤⼀个索引或者⽤ignore index(indexname)来强制mysql忽略索引key_len:使⽤的索引的长度。