
回归结果参数解释
excel回归结果解读

Excel回归结果解读1.引言在统计学和数据分析领域,回归分析是一种常用的方法,用于分析一个或多个自变量与一个因变量之间的关系。
在Ex ce l中,我们可以使用回归分析工具,通过输入一组数据,得到回归模型的参数估计结果和相关统计信息。
本文将重点介绍如何解读E xce l回归结果,理解回归系数、显著性检验和拟合优度等指标。
2.回归模型及参数估计结果回归模型通常采用线性模型表示,可以用以下形式表示:$$Y=\b et a_0+\b eta_1X_1+\be ta_2X_2+\l do ts+\be ta_nX_n+\v ar e ps il on$$其中,$Y$是因变量,$X_1,X_2,\l do ts,X_n$是自变量,$\be ta_0,\be ta_1,\be ta_2,\ld ot s,\b et a_n$是回归系数,$\va re ps il on$是误差项。
在E xc el回归分析的结果中,我们主要关注回归系数的估计值和其显著性水平。
2.1回归系数的解读回归系数表示当自变量的值增加一个单位时,因变量的平均变化量。
具体解读如下:-$\b et a_0$是截距项,表示当所有自变量都为0时,因变量的平均值。
-$\b et a_1,\b et a_2,\l do ts,\be ta_n$是自变量$X_1,X_2,\ld ot s,X_n$的回归系数。
以$\b et a_1$为例,当自变量$X_1$的值增加一个单位时,因变量$Y$的平均变化量为$\be t a_1$。
如果$\b et a_1>0$,表示$X_1$和$Y$正相关;如果$\b et a_1<0$,表示$X_1$和$Y$负相关;如果$\b et a_1=0$,表示$X_1$和$Y$之间没有线性关系。
2.2显著性检验显著性检验用于判断回归系数是否显著不等于0。
在E xc el回归结果中,我们通常关注P值,以判断回归系数的显著性。
一元线性回归分析的结果解释
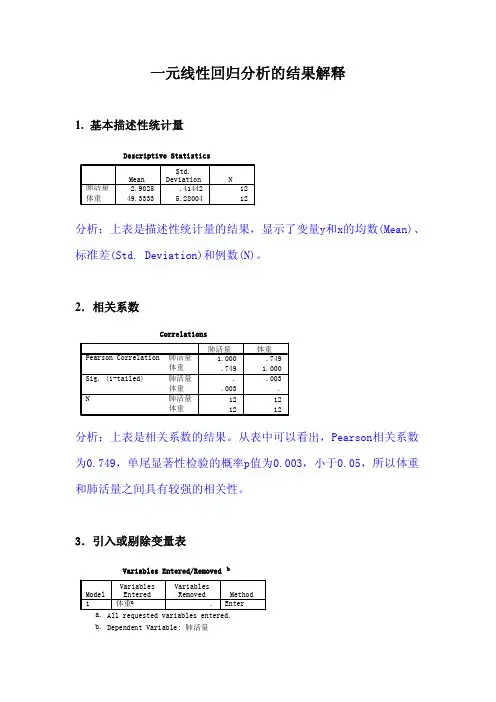
一元线性回归分析的结果解释1.基本描述性统计量分析:上表是描述性统计量的结果,显示了变量y和x的均数(Mean)、标准差(Std. Deviation)和例数(N)。
2.相关系数分析:上表是相关系数的结果。
从表中可以看出,Pearson相关系数为0.749,单尾显著性检验的概率p值为0.003,小于0.05,所以体重和肺活量之间具有较强的相关性。
3.引入或剔除变量表分析:上表显示回归分析的方法以及变量被剔除或引入的信息。
表中显示回归方法是用强迫引入法引入变量x的。
对于一元线性回归问题,由于只有一个自变量,所以此表意义不大。
4.模型摘要分析:上表是模型摘要。
表中显示两变量的相关系数(R)为0.749,判定系数(R Square)为0.562,调整判定系数(Adjusted R Square)为0.518,估计值的标准误差(Std. Error of the Estimate)为0.28775。
5.方差分析表分析:上表是回归分析的方差分析表(ANOVA)。
从表中可以看出,回归的均方(Regression Mean Square)为1.061,剩余的均方(Residual Mean Square)为0.083,F检验统计量的观察值为12.817,相应的概率p 值为0.005,小于0.05,可以认为变量x和y之间存在线性关系。
6.回归系数分析:上表给出线性回归方程中的参数(Coefficients)和常数项(Constant)的估计值,其中常数项系数为0(注:若精确到小数点后6位,那么应该是0.000413),回归系数为0.059,线性回归参数的标准误差(Std. Error)为0.016,标准化回归系数(Beta)为0.749,回归系数T检验的t统计量观察值为3.580,T检验的概率p值为0.005,小于0.05,所以可以认为回归系数有显著意义。
由此可得线性回归方程为:y=0.000413+0.059x7.回归诊断分析:上表是对全部观察单位进行回归诊断(CasewiseDiagnostics-all cases)的结果显示。
ols regression results表的结果解读

ols regression results表的结果解读1. 被解释变量(Dependent Variable):这是你要预测或解释的变量,通常用Y 表示。
2. 解释变量(Independent Variable):这些是用来预测被解释变量的变量,通常用X1, X2, ..., Xk 表示。
3. 回归系数(Coefficients):这一列显示了每个解释变量对被解释变量的影响程度。
系数的大小表示当解释变量增加一个单位时,被解释变量的预期变化量。
正的系数表示正相关关系,负的系数表示负相关关系。
4. 标准误差(Std. Error):这是每个回归系数的标准误差,用于衡量估计值的精度。
较小的标准误差意味着估计值更可靠。
5. t 统计量(t-Statistic):这是用于检验每个回归系数是否显著不为零的统计量。
它计算了回归系数与零假设之间的差异,并根据自由度进行调整。
较高的t 值表示回归系数与零假设有较大的差异,更有可能拒绝零假设。
6. 概率(P-Value):这是每个回归系数的p 值,用于确定回归系数是否显著。
p 值越小,说明拒绝零假设的证据越强。
通常,我们使用一个特定的显著性水平(如0.05)来判断是否拒绝零假设。
7. R-squared(R-squared):这是衡量回归模型解释被解释变量变异的比例的指标。
它表示自变量对被解释变量的解释能力。
R-squared 的取值范围在0 到1 之间,越高表示模型的解释能力越强。
8. 调整后的R-squared(Adjusted R-squared):这是一种调整了自由度的R-squared 指标,用于考虑自变量数量对模型拟合效果的影响。
它通常比R-squared 稍微小一些,但在自变量数量较多时更能准确反映模型的拟合效果。
9. 残差标准误差(Residual Standard Error):这是模型预测误差的标准差,用于衡量模型的精度。
较小的残差标准误差意味着模型的预测更准确。
回归分析中相关参数的涵义
回归分析中F、D.W、t、sig.t的含义1、T检验和F检验(1)T检验和F检验的由来一般而言,为了确定从样本(sample)统计结果推论至总体时所犯错的概率,我们会利用统计学家所开发的一些统计方法,进行统计检定。
通过把所得到的统计检定值,与统计学家建立了一些随机变量的概率分布(probability distribution)进行比较,我们可以知道在多少%的机会下会得到目前的结果。
倘若经比较后发现,出现这结果的机率很少,亦即是说,是在机会很少、很罕有的情况下才出现;那我们便可以有信心的说,这不是巧合,是具有统计学上的意义的(用统计学的话讲,就是能够拒绝虚无假设null hypothesis,Ho)。
相反,若比较后发现,出现的机率很高,并不罕见;那我们便不能很有信心的直指这不是巧合,也许是巧合,也许不是,但我们没能确定。
F值和t值就是这些统计检定值,与它们相对应的概率分布,就是F分布和t分布。
统计显著性(sig)就是出现目前样本这结果的机率。
(2)统计学意义(P值或sig值)结果的统计学意义是结果真实程度(能够代表总体)的一种估计方法。
专业上,p值为结果可信程度的一个递减指标,p值越大,我们越不能认为样本中变量的关联是总体中各变量关联的可靠指标。
p值是将观察结果认为有效即具有总体代表性的犯错概率。
如p=0.05提示样本中变量关联有5%的可能是由于偶然性造成的。
即假设总体中任意变量间均无关联,我们重复类似实验,会发现约20个实验中有一个实验,我们所研究的变量关联将等于或强于我们的实验结果。
(这并不是说如果变量间存在关联,我们可得到5%或95%次数的相同结果,当总体中的变量存在关联,重复研究和发现关联的可能性与设计的统计学效力有关。
)在许多研究领域,0.05的p值通常被认为是可接受错误的边界水平。
至于具体要检定的内容,须看你是在做哪一个统计程序。
举一个例子,比如,你要检验两独立样本均数差异是否能推论至总体,而进行的t检验。
【线性回归】线性回归模型中几个参数的解释

【线性回归】线性回归模型中⼏个参数的解释【线性回归】线性回归模型中⼏个参数的解释R ⽅1. 决定系数/拟合优度类似于⼀元线性回归,构造决定系数。
称为y 关于⾃变量的样本复相关系数。
其中,,有SST=SSR+SSE总离差平⽅和记为SST ,回归平⽅和记为SSR ,残差平⽅和为SSE 。
由公式可见,SSR 是由回归⽅程确定的,即是可以⽤⾃变量x 进⾏解释的波动,⽽SSE 为x 之外的未加控制的因素引起的波动。
这样,总离差平⽅和SST 中能够由⽅程解释的部分为SSR ,不能解释的部分为SSE 。
1. 意义意味着回归⽅程中能被解释的误差占总误差的⽐例。
⼀般来说越⼤,拟合效果越好,⼀般认为超过0.8的模型拟合优度⽐较⾼。
需要注意的是当样本量⼩时,很⼤(例如0.9)也不能肯定⾃变量与因变量之间关系就是线性的。
随着⾃变量的增多,必定会越来越接近于1,但这会导致模型的稳定性变差,即模型⽤来预测训练集之外的数据时,预测波动将会⾮常⼤,这个时候就会对作调整,调整R ⽅可以消除⾃变量增加造成的假象。
F 检验0、预备知识(1)假设检验为了判断与检测X 是否具备对Y 的预测能⼒,⼀般可以通过相关系数、图形等⽅法进⾏衡量,但这只是直观的判断⽅法。
通过对回归参数做假设检验可以为我们提供更严格的数量化分析⽅法。
(2)全模型与简化模型我们称之为全模型(full Model,FM )通过对某些回归系数进⾏假设,使其取指定的值,把这些指定的值带⼊全模型中,得到的模型称为简化模型(reduced model,RM )。
常⽤的简化⽅法将在之后介绍。
1、F 检验检验是线性模型的假设检验中最常⽤的⼀种检验,通过值的⼤⼩可以判断提出的假设是否合理,即是否接受简化模型。
1. 为检验我们的假设是否合理,即评估简化模型相对全模型拟合效果是否⼀样好,需要先建⽴对两个模型拟合效果的评价⽅法。
这⾥我们通过计算模型的残差平⽅和()来衡量模型拟合数据时损失的信息量,也表⽰模型的拟合效果。
stata面板数据re模型回归结果解释

stata面板数据re模型回归结果解释Stata是一种统计分析软件,可用于面板数据的回归分析。
在使用Stata进行面板数据的回归模型分析时,常见的面板数据回归模型是随机效应模型(Random Effects Model)和固定效应模型(Fixed Effects Model)。
回归结果解释通常包括以下几个方面:1. 模型拟合度:回归结果中的R-squared(决定系数)可以用来衡量模型对观测数据的拟合程度。
R-squared越接近1,说明模型对数据的解释能力越强。
2. 系数估计:回归结果中的各个系数估计值表示自变量与因变量之间的关系。
系数的正负和显著性可以告诉我们自变量对因变量的影响方向和程度。
通常,系数的显著性可以通过查看t统计量或者P值来确定。
显著性水平一般为0.05或0.01,如果P值小于显著性水平,则表示该系数是显著的。
3. 解释变量:回归结果中可能包含多个解释变量,每个解释变量的系数表示该变量对因变量的影响。
系数的正负可以告诉我们该变量对因变量的影响方向,而系数的大小可以表示该变量对因变量的影响程度。
4. 控制变量:回归模型中可能还包含一些控制变量,这些变量用于控制其他可能对因变量产生影响的因素。
通过控制这些变量,可以更准确地评估自变量对因变量的影响。
5. 随机效应和固定效应:如果采用了随机效应模型,回归结果中可能会显示随机效应的方差或标准差。
这些参数可以用来评估不同个体之间的随机差异。
而固定效应模型则将个体固定效应纳入考虑,回归结果中可能包括各个个体的固定效应系数。
6. 模型诊断:在解释回归结果时,还需要进行模型诊断,以评估回归模型是否满足模型假设。
常见的模型诊断包括残差分析、异方差性检验、多重共线性检验等。
需要注意的是,面板数据回归模型的解释需要结合具体的研究背景和问题进行分析,确保结果的可靠性和有效性。
同时,了解Stata软件的使用方法和相关统计知识也是进行面板数据回归分析的基础。
地理加权回归模型结果解读
地理加权回归模型结果解读
地理加权回归(GWR)模型是一种用于分析空间数据的空间统计方法,它通过引入地理位置权重来揭示自变量与因变量之间的局部关系。
与传统的全局回归模型相比,GWR模型可以更好地揭示空间异质性和局部关系。
下面是对GWR模型结果的解读:
1. 模型参数:GWR模型结果中,最主要的参数是带宽(Bandwidth)。
带宽用于确定邻近地区的范围,带宽的选择会影响模型的预测精度。
合适的带宽可以使得模型结果更接近真实情况,反映出局部关系。
2. 系数估计:GWR模型结果中,各解释变量的系数会随着地理位置的变化而变化。
系数的大小反映了自变量对因变量的影响程度,正值表示正相关,负值表示负相关。
通过分析系数的变化,可以了解不同地理位置下自变量对因变量的影响。
3. 残差分析:GWR模型的残差是观测值与模型预测值之间的差异。
残差的空间分布可以反映出模型是否能够较好地拟合数据,如果残差在空间上呈现随机分布,说明模型的预测效果较好。
4. 空间异质性:GWR模型可以揭示空间异质性,即地理位置对模型结果的影响。
通过分析模型结果,可以了解不同地理位置下自变量与因变量之间的关系,以及空间异质性的存在。
5. 模型评价:GWR模型的评价指标主要包括决定系数(R²)、赤池信息准则(AIC)等。
这些指标可以用来评价模型的拟合效果和预测能力。
总之,在解读GWR模型结果时,要结合具体问题和数据特点进行分析,避免对模型结果的误解。
同时,在实际应用中,需要根据实际情况选择合适的带宽,以获得更好的模型效果。
EVIEWS回归结果的理解(可打印修改)
回归结果的理解参数解释:1、回归系数(coefficient)注意回归系数的正负要符合理论和实际。
截距项的回归系数无论是否通过T检验都没有实际的经济意义。
2、回归系数的标准误差(Std.Error)标准误差越大,回归系数的估计值越不可靠,这可以通过T值的计算公式可知3、T检验值(t-Statistic)T值检验回归系数是否等于某一特定值,在回归方程中这一特定值为0,因此T值=回归系数/回归系数的标准误差,因此T值的正负应该与回归系数的正负一致,回归系数的标准误差越大,T值越小,回归系数的估计值越不可靠,越接近于0。
另外,回归系数的绝对值越大,T值的绝对值越大。
4、P值(Prob)P值为理论T值超越样本T值的概率,应该联系显著性水平α相比,α表示原假设成立的前提下,理论T值超过样本T值的概率,当P值<α值,说明这种结果实际出现的概率的概率比在原假设成立的前提下这种结果出现的可能性还小但它偏偏出现了,因此拒绝接受原假设。
5、可决系数(R-squared)都知道可决系数表示解释变量对被解释变量的解释贡献,其实质就是看(y尖-y均)与(y=y均)的一致程度。
y尖为y的估计值,y均为y的总体均值。
6、调整后的可决系数(Adjusted R-squared)即经自由度修正后的可决系数,从计算公式可知调整后的可决系数小于可决系数,并且可决系数可能为负,此时说明模型极不可靠。
7、回归残差的标准误差(S.E.of regression)残差的经自由度修正后的标准差,OLS的实质其实就是使得均方差最小化,而均方差与此的区别就是没有经过自由度修正。
8、残差平方和(Sum Squared Resid)见上79、对数似然估计函数值(Log likelihood)首先,理解极大似然估计法。
极大似然估计法虽然没有OLS运用广泛,但它是一个具有更强理论性质的点估计方法。
极大似然估计的出发点是已知被观测现象的分布,但不知道其参数。
回归分析结果解释
下面的回归分析结果,红色字体表示解释文字SUMMARY OUTPUT
回归统计
Multiple R 0.852211601 相关系数
R Square 0.726264613 判定系数。
表示因变量的总变动中,有72.63%是由于自变量的变动引起的;或者说,该回归模型可以解释因变量总变动的72.63%
Adjusted R Square 0.69204769
修正判定系数.避免增加自变量而高估R2.用
于多元回归模型拟合优度的比较
标准误差19.94541646 表示观测值与估计值的平均离差
观测值10 观测值的个数
方差分析部分用来对回归方程做显著性检验,看自变量整体和因变量有无显著的线性关系。
检验方法是:若P< α , 则因变量与自变量之间存在线性关系;否则不存在线性关系
方差分析自由度平方和均方F检验中统
计量取值
F值对应的P值
df SS MS F Significance
F
回归分析 1 8443.843 8443.843 21.22530439 0.001739257 残差8 3182.557 397.8196
总计9 11626.4
该部分结果主要用来得到回归方程的参数以及进行回归系数的显著性检验。
检验方法是:若
P< α , 则因变量与该自变量之间存在线性关系;否则不存在线性关系。
系数t检验中统
计量取值
t值对应的P值
Coefficients 标准误差t Stat P-value Lower 95%。
stata中logit回归结果解读
stata中logit回归结果解读Stata中的logit回归是一种广泛使用的统计方法,用于分析二分类数据的影响因素。
logit回归模型可以帮助研究者理解自变量对因变量的影响,并预测因变量的概率。
通过解释logit回归结果,研究者可以了解特定自变量对概率的影响程度及方向。
在进行logit回归之前,首先要明确研究目的并确定合适的自变量。
logit 回归的因变量必须是二元分类变量(例如“是”或“否”),而自变量可以是连续或者分类变量(例如性别、年龄、收入等)。
在得到logit回归结果之后,我们需要关注下列几个方面来解释结果:估计参数(Estimate)、标准误差(Std. Err.)、Z值(z value)、P值(P> z )以及置信区间(Conf. Interval)。
首先,估计参数(Estimate)表示自变量的系数估计值。
系数正负值反映了自变量与因变量之间的关系方向,正值表示自变量与因变量正相关,负值表示自变量与因变量负相关。
系数绝对值的大小表明了自变量对因变量的影响力大小,绝对值越大,影响越强。
其次,标准误差(Std. Err.)表示估计参数的稳定性。
标准误差越小,表示估计参数的稳定性越高,可靠程度越大。
通常情况下,我们希望标准误差越小越好。
第三,Z值(z value)是估计参数与标准误差的比值。
Z值的绝对值越大,表示估计参数显著性越高。
在一般情况下,当z值大于1.96时,我们可以认为该估计参数是显著的。
其次,P值(P> z )是用来判断估计参数是否显著的重要指标。
P值越小,表示估计参数的显著性越高。
一般情况下,若P值小于0.05,我们可以认为该估计参数是显著的。
最后,置信区间(Conf. Interval)表示估计参数的可信程度。
95置信区间是指如果我们对同一总体进行多个样本研究,其中包含的参数估计结果在95的情况下将处于这个区间内。
一般情况下,若置信区间不包含0,我们可以认为该估计参数是显著的。