
stata中文教程第三讲
.05004353
设 X 服从自由度为 3 的2 分布,计算概率 P(X<5),则操作如下 . di chi2(3,5) 概率 P(X<5)=0.82820288
.82820288
2 分布右侧累积概率计算 设 X 服从自由度为 1 的2 分布,计算概率 P(X>3.84),则操作如下 . di chi2tail(1,3.84) .05004353 概率 P(X>3.84)=0.05004353
Stata 软件基本操作和数据分析入门
第三讲 概率分布和抽样分布 赵耐青 概率分布累积函数 1. 标准正态分布累积函数 norm(X) 2. t 分布右侧累积函数 ttail(df,X) ,其中 df 是自由度 3. 2 分布累积函数 chi2(df,X) ,其中 df 是自由度 4. 2 分布右侧累积函数 chi2tail(df,X) ,其中 df 是自由度 5. F 分布累积函数 F(df1,df2,X),df1 为分子自由度,df2 为分母 自由度 6. F 分布右侧累积函数 F(df1,df2,X),df1 为分子自由度,df2 为 分母自由度 累积函数的计算使用 正态分布计算 X 服从 N(0,1),计算概率 P(X<1.96) . display norm(1.96) .9750021 即概率 P(X<1.96)=0.9750021 norm(1.96), 同样可以得到上述结果。
t 分布的临界值计算函数 invchi2tail(df,P) 例如计算自由度为 28 的右侧累积概率为 0.025 的临界值 t28,,操作 如下 . di invttail(28,0.025) 2.0484071 临界值 t28,=2.0484071
2 分布的临界值计算函数 invchi2(df,P) 或 invchi2tail(df,P) 例如:计算自由度为 1 的2 右侧累积概率为 0.05 的临界值20.05,操 作如下: . di invchi2(1,0.95) 3.8414591 或者操作如下: . di invchi2tail(1,0.05) 临界值20.05=3.8414591
sort list
no
按照编号排序 显示随机分组的结果
结果如下:
1. 2. 3. 4. 5. 6. 7. 8. 9. 10. 11. 12. 13. 14. 15. 16. 17. 18. 19. 20. no 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 r .9512007 .5249876 .5129986 .126439 .5866161 .7059209 .2633286 .5644688 .1171033 .954065 .4822863 .3347736 .5678902 .7994431 .1180503 .9834299 .2807874 .095245 .9446051 .3467524 group 2 2 1 1 2 2 1 2 1 2 1 1 2 2 1 2 1 1 2 1
设 t 服从自由度为 10 的 t 分布,计算概率 P(t<-2),操作如下 . di 1-ttail(10,-2) .03669402 概率 P(t<-2)=0.03669402
F 分布累积概率计算 设 F 服从 F(3,27),计算概率 P(F<1),操作如下: . di F(3,27,1) .59208514
设置种子数为 100 设置样本量为 20 产生 20 个在(0,1)区间上均匀分布的随机数。 显示这些随机数
利用均匀分布随机数进行随机分组: 例:某实验要把 20 只大鼠随机分为 2 组,每组 10 只,请制定随 机分组方案和措施。 第一步、把 20 只大鼠编号,1,2,3,4,5,6,7,8,9,10, 11,12,13,14,15,16,17,18,19,20。并且标明。 第二步、用 Stata 软件制定随机分组方案,操作如下:
注意这里的函数是大写 F,stata 软件中是区分大小写的
概率 P(F<1)=0.59208514
设 F 服从 F(4,40),计算概率 P(F>3),操作如下: . di 1-F(4,40,3) 概率 P(F>3)=0 .02954694
.02954694
F 分布右侧累积概率计算 设 F 服从 F(3,27),计算概率 P(F<1),操作如下: . di 1-Ftail(3,27,1)
1. 2. 3. 4. 5. 6. 7. 8. 9. 10. x 109.9397 100.3761 100.1955 93.13968 101.3131 103.249 96.2013 100.9739 92.86244 110.1137
清除内存 设置种子数为 200 设置样本量为 10 产生服从 N(100,62)的随机数 显示随机数
3.8414591
临界值20.05=3.8414591
F 分布的临界值计算函数 invF(df1,df2,P) 或 invF(df1,df2,P) 例如计算分子自由度为 3 和分母自由度 27 的右侧累积概率为 0.05 的 临界值,操作如下: . di invF(3,27,0.95) 2.9603513 或者操作为: . di invFtail(3,27,0.05) 2.9603513 临界值 F0.05(3,27)= 2.9603513 临界值 F0.05(3,27)= 2.9603513
产生随机数 计算机所产生的随机数是通过一串很长的序列数模拟随机数,故 称为伪随机数, 在实际应用这些随机数时, 这些随机数一般都能具有 真实随机数的所有概率性质和统计性质, 因此可以产生许许多多的序 列伪随机数, 一个序列的第一个随机数对应一个数, 这个数称为种子 数(seed),因此可以利用种子数,使随机数重复实现。 设置种子数的命令为 set seed 的随机序列是相同的。 产生(0,1)区间上的均匀分布的随机数 uniform() 例如产生种子数为 100 的 20 个在(0,1)区间上的均匀分布的随机 数,则操作如下: clear 清除内存 数。 每次设置同一种子数, 则产生
设 X 服从自由度为 3 的2 分布,计算概率 P(X<5),则操作如下 .di chi2(3,5) 概率 P(X<5)=0.82820288
.82820288
t 分布右侧累积概率计算 设 t 服从自由度为 10 的 t 分布,计算概率 P(t>2.2),操作如下 . di ttail(10,2.2) .02622053 概率 P(t>2.2)=0.02622053 (注意:这是右累积函数)
.9750021
又如 X 服从 N(100,62),计算概率 P(X>90),操作如下 . di 1-norm((90-100)/6) .95220965 2 分布累积概率计算 设 X 服从自由度为 1 的2 分布,计算概率 P(X>3.84),则操作如下 . di 1-chi2(1,3.84) 概率 P(X>3.84)=0.05004353
clear set seed 200 set obs 20 range no 1 20 gen r=uniform() gen group=1 sort r replace group=2 in 11/20
清除内存 设置种子数为 200 设置样本量为 20 建立编号 1 至 20 产生在(0,1)均匀分布的随机数 设置分组变量 group 的初始值为 1 对随机数从小到大排序 设置最大的 10 个随机数所对应的记录 为第 2 组,即:最小的 10 个随机数所 对应的记录为第 1 组
随机分组整理如下 第一组 编号 3 4 7 9 11 12 15 17 18 20
第二组 编号 1 2 5 6 8 10 13 14 16 19
产生服从正态分布 N(,2)的随机数 invnorm(uniform())*+。 例如产生 10 个服从正态分布 N(100,62)的随机数,操作如下: clear set seed 200 set obs 10 gen x=invnorm(uniform())*6+100 list 结果如下:
注意这里的函数是大写 F,stata 软件中是区分大小写的
.59208514
概率 P(F<1)=0.59208514
设 F 服从 F(4,40),计算概率 P(F>3),操作如下: . di Fta=0 .02954694
概率分布的临界值计算 正态分布的临界值计算函数 invnorm(P) 例如:双侧 U0.05(即:左侧累积概率为 0.975),操作如下 . di invnorm(0.975) 1.959964 即 U0.05=1.959964
set seed 100 set obs 20 gen r=uniform() list 结果如下 1. 2. 3. 4. 5. 6. 7. 8. 9. 10. 11. 12. 13. 14. 15. 16. 17. 18. 19. 20. r .7185296 .1646728 .9258041 .1833736 .0067327 .7413361 .3599943 .1634543 .445553 .6489049 .3799431 .5964895 .0251346 .2164402 .6848479 .1270018 .6466258 .1869288 .4522384 .067132
教学应用:考察样本均数的分布。 由于个体变异的原因, 样本均数 X 的抽样误差(其定义为样本均数
与总体均数的差值)是不可避免的,并且样本均数的抽样误差是呈随 机变化的。 对于一次抽样而言, 无法考察样本均数的抽样误差的规律 性,但当大量地重复抽样,计算每次抽样的样本均数 X ,考察样本均 数 X 的随机分布规律性和统计特征。举例如下: 利用计算机模拟产生 100000 个服从正态分布 N(100,62)的样本, 样本量分别为 n=4,n=9,n=16,n=36,每个样本计算样本均数。这 里关键处是要清楚什么是样本量(每次抽样所观察的对象个数,也就 是每个样本的个体数 n)、什么是样本个数(指抽样的次数),现以 n=4 为例,一条记录存放一个样本,样本量 n=4,也就是每个样本的第 1 个数据放在第 1 列,第 2 个数据放在第 2 列,第 3 个数据放在第 3 列,第 4 个数据放在第 4 列,因此第 1 行是第一个样本,第 2 行是第 2 个样本,第 100000 行是第 100000 个样本,计算样本均数放在第 5 列,因此共有 100000 个样本均数。具体操作如下: clear set memory 60m
使用Stata进行统计数据分析教程

使用Stata进行统计数据分析教程章节一:Stata简介与安装Stata是一款广泛使用的统计软件,由StataCorp开发,并提供了强大的数据分析和数据管理功能。
首先,我们需要了解Stata的基本特点和优势,并学习如何安装Stata软件及其组件包。
为了顺利进行数据分析,安装正确的版本和组件是必不可少的。
章节二:数据导入与数据管理在开始数据分析之前,我们首先需要将数据导入Stata软件中,这涉及到数据的格式转换和读取,包括常见的Excel、CSV等格式。
然后,我们会学习如何对数据进行清洗,删除无效数据、处理缺失数据和异常值等。
此外,我们还会介绍如何创建和修改变量、合并数据集以及数据筛选等高级数据管理功能。
章节三:描述性统计分析描述性统计是最基本的统计方法之一,用于描述数据的分布和性质。
在这一章节中,我们会学习如何使用Stata进行描述性统计分析,包括计算平均数、中位数、标准差、最大值和最小值等统计指标。
同时,我们还会学习如何绘制直方图、箱线图和散点图等图形工具,以更直观地展示数据的分布特征。
章节四:推断统计分析推断统计分析用于从样本数据中推断总体的性质,常用的方法包括假设检验和置信区间估计。
在这一章节中,我们会学习如何使用Stata进行常见的假设检验,如单样本t检验、独立样本t检验和相关样本t检验等。
同时,我们还会介绍如何计算置信区间和进行方差分析等高级统计方法。
章节五:回归分析回归分析是统计学中常用的建模和预测方法,用于描述自变量与因变量之间的关系。
在这一章节中,我们会学习如何使用Stata 进行简单线性回归和多元线性回归分析,包括模型拟合、参数估计和模型诊断。
此外,我们还会介绍如何解决共线性和异方差等常见问题,并讨论如何进行交互效应和非线性回归分析。
章节六:多元统计分析除了回归分析,Stata还提供了丰富的多元统计分析方法,如主成分分析、因子分析和聚类分析等。
在这一章节中,我们会学习如何使用Stata进行多元统计分析,包括降维与因子提取、聚类分析和判别分析等。
STATA操作流程-附面板数据演示视频-presentationPPT教学课件

• Vif 检查共线性
• Ivreg y x1 (x2=x3 x4..) 这里用x3和x4等作为x2 的工具变量,与 x1一起对y进行回归
• Hausman 进行hausman检验
2020/12/10
13
• gen 生成一个新的变量
• replace 修改某个变量的数据
• 接下来,我们用Microsoft Access将txt的 文本文件转化为mdb的数据文件
• 再使用Stata专用的StataTransfer把mdb的 文件转化为Stata的数据库文件dta。
• demo
2020/12/10
4
第三篇 文件和目录操作
2020/12/10
5
• cd 可以显示当前的工作目录 • cd d:\ 转到D盘 • cd d:\tutorial 转到D盘的tutorial目录 • dir 显示当前工作目录内的文件内容 • mkdir bak 在单前工作目录内建立一个新
谢谢观看
Thank You For Watching
17
的文件夹bak
2020/12/10
6
• copy exp1.dta bak\exp1.dta 将当前目录内 的文件exp1复制到bak文件夹中
• erase exp1.dta 将当前目录内的exp1文件删 除
• copy bak\exp1.dta exp1.dta 由bak文件中复 制exp1到当前目录
• demo
2020/12/10
7
第四篇 数据库操作
2020/12/10
8
• use exp1.dta 打开当前目录中的一个数据 文件
stata 中文教程

Stata介绍作为流行的计量经济学软件,Stata的功能十分地全面和强大。
可以毫不夸张地说,凡是成熟的计量经济学方法,在Stata中都可以找到相应的命令,而这些命令都有许多选项以适应不同的环境或满足不同的需要。
即使是最详细的Stata手册,也难免有遗珠之憾,更何况本文仅是一个粗浅的介绍。
掌握Stata最好的办法是在实践中学习:Stata 本身提供了非常强大的帮助系统,并且关于Stata的书籍和网络资源都不少。
本文拟根据如下顺序介绍Stata:1.界面;2.文件和数据;3.语法和命令;4.数据管理;5.描述统计;6.画图;7.回归和回归分析;8.常用命令。
第3和第4部分是最体现Stata灵活性的地方,也是应用Stata的基础。
第5和第6部分介绍如何用Stata完成基本的统计功能。
Stata的功能很多,比如回归,曲线拟合,生存分析,主成分分析,因子分析,聚类分析,时间序列分析等等。
但回归无疑是其中最重要的功能。
第7部分介绍如何用Stata作线性回归和Logistic回归。
本文第2和第3部分包含了作者的观点,难免有偏颇之处。
其余部分主要来自文献的归纳和总结。
限于水平有限,错误在所难免,敬请原谅。
1.界面图1 Stata界面Stata有4个窗口:1. Stata Command(右下)用于向Stata输入命令;2. Stata Results(右上)用于显示运行结果;3. Review(左上)记录使用过的命令;4. Variables(左下)显示当前memory中的所有变量。
窗口上方是工具栏,其上的按钮依次为(从左到右)Open, Save, Print Graph/Print Log, Log Start/Stop/Suspend, Bring Log to Front, Bring Graph to Front, Do-file Editor, Data Editor, Data Browser, Clear –more- condition, Break。
轻松上手的stata中文教程

三、輸入資料(Entering data)
在本小節中,我們將介紹如何把資料讀進 STATA。但是在正式介紹之前, 我們必須先對幾個一般性的指令(general command)有所瞭解,說明如下: cd:即 change directory,簡言之,告知 STATA 資料儲存的地方。例如當 資料儲存在 e 槽的 sample 資料夾時,則必須先輸入 cd e:\sample。 dir/ls:用來顯示目錄的內容。 set memory #m:設定記憶體的容量。例如:當有一筆龐大的資料要處理 時,則可設定 100mb 的容量,此時可輸入 set memory 100m 。 (輸入指令 memory 可以知道記憶體容量的大小 以及使用情況。) set matsize #:設定所需的變數個數。一般而言,不須對此部分進行設定, 除非所欲處理的資料龐大或是當執行後出現 matsize too small 的訊息時再進行修改即可。內建為 40。 set more off/on:若欲執行結果以分頁的型式呈現時,則輸入 set more on; 若欲執行結果同時呈現時,則輸入 set more off。 help:求助鍵。後面必須接的是指令。說明如何使用該指令,例如:help
5
use sample1-6.dta Note:此一指令亦可用在讀取網路上的資料(use 網址)。 最後,將資料輸入的相關指令整理成下表。 insheet read ASCII (text) data created by a spreadsheet infile infix input use read unformatted ASCII (text) data read ASCII (text) data in fixed format enter data from keyboard load a Stata-format dataset
Stata教程
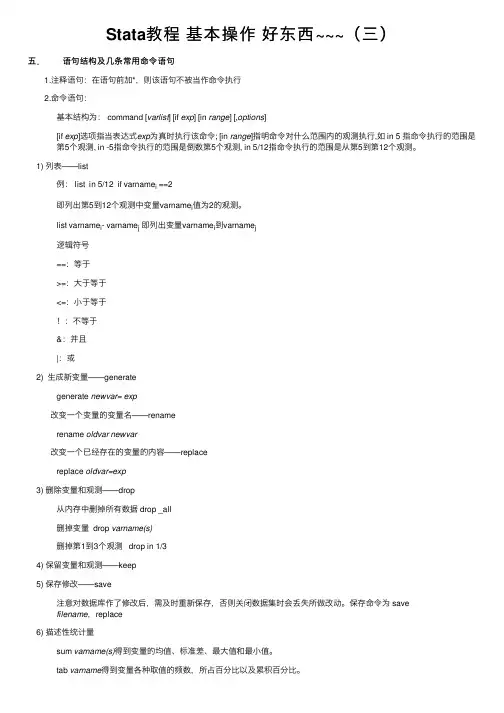
Stata教程基本操作好东西~~~(三)五.语句结构及⼏条常⽤命令语句1.注释语句:在语句前加*,则该语句不被当作命令执⾏2.命令语句:基本结构为: command [varlist] [if exp] [in range] [,options][if exp]选项指当表达式exp为真时执⾏该命令; [in range]指明命令对什么范围内的观测执⾏,如 in 5 指命令执⾏的范围是第5个观测, in -5指命令执⾏的范围是倒数第5个观测, in 5/12指命令执⾏的范围是从第5到第12个观测。
1) 列表——list例: list in 5/12 if varname i ==2即列出第5到12个观测中变量varname i值为2的观测。
list varname i- varname j即列出变量varname i到varname j逻辑符号==:等于>=:⼤于等于<=:⼩于等于!:不等于&:并且|:或2) ⽣成新变量——generategenerate newvar= exp改变⼀个变量的变量名——renamerename oldvar newvar改变⼀个已经存在的变量的内容——replacereplace oldvar=exp3) 删除变量和观测——drop从内存中删掉所有数据 drop _all删掉变量 drop varname(s)删掉第1到3个观测 drop in 1/34) 保留变量和观测——keep5) 保存修改——save注意对数据库作了修改后,需及时重新保存,否则关闭数据集时会丢失所做改动。
保存命令为 savefilename,replace6) 描述性统计量sum varname(s)得到变量的均值、标准差、最⼤值和最⼩值。
tab varname得到变量各种取值的频数,所占百分⽐以及累积百分⽐。
tab1 varname(s)得到各变量各种取值的频数,所占百分⽐以及累积百分⽐。
stata17 中文操作手册

stata17 中文操作手册Stata 17 中文操作手册Stata是一款广泛应用于数据分析和统计建模的统计软件,它能够帮助用户进行各种数据处理和分析任务。
本操作手册将带领您了解如何在Stata 17中进行常见的数据操作、统计分析和图表制作等操作。
请按照以下步骤进行操作:1. 数据导入和保存在Stata 17中,您可以使用"import"命令将外部数据文件导入Stata工作环境。
例如,您可以使用"import excel"命令导入Excel文件,使用"import delimited"命令导入CSV文件。
导入后,您可以使用"save"命令将数据保存为Stata格式的文件,以便以后使用。
2. 数据清理与转换在进行数据分析之前,您可能需要对数据进行清理和转换。
Stata提供了一系列命令来实现这些操作。
例如,使用"drop"命令可以删除数据集中的某些变量或观测值,使用"rename"命令可以重新命名变量,使用"generate"命令可以创建新的变量。
3. 描述性统计分析Stata 17提供了大量的命令和功能来进行描述性统计分析。
例如,使用"summarize"命令可以计算变量的均值、标准差、最大值和最小值等统计量,使用"tabulate"命令可以生成交叉表并计算频数和百分比等。
4. 统计推断在进行统计推断时,Stata 17提供了各种命令来进行假设检验和参数估计。
例如,使用"ttest"命令可以进行单样本或双样本均值差异的t 检验,使用"regress"命令可以进行线性回归分析。
5. 绘图功能Stata 17具备强大的绘图功能,能够绘制各种类型的图表以可视化数据。
例如,使用"histogram"命令可以绘制直方图,使用"scatter"命令可以绘制散点图,使用"line"命令可以绘制折线图。
Stata教程(免费)
第一章 Stata 概貌§1.1 Stata的功能、特点和背景Stata是一个用于分析和管理数据的功能强大又小巧玲珑的实用统计分析软件,由美国计算机资源中心(Computer Resource Center)研制。
从1985至1998的十四年时间里,已连续推出1.1,1.2,1.3,1.4,1.5,……及2.0,2.1,3.0,3.1,4.0,5.0,6.0等多个版本,通过不断更新和扩充,内容日趋完善。
它同时具有数据管理软件、统计分析软件、绘图软件、矩阵计算软件和程序语言的特点,又在许多方面别具一格。
Stata融汇了上述程序的优点,克服了各自的缺点,使其功能更加强大,操作更加灵活、简单,易学易用,越来越受到人们的重视和欢迎。
Stata的突出特点是只占用很少的磁盘空间,输出结果简洁,所选方法先进,内容较齐全,制作的图形十分精美,可直接被图形处理软件或字处理软件如WORD等直接调用。
一、 Stata的数据管理能力1.Stata的数据管理空间受计算机的操作系统和计算机扩展内存的影响。
对640k内存的微机,3.1版本的Stata可以管理2400个记录×99个变量,并随计算机扩展内存的增加而增加;对4.0的WINDOWS版本,Stata可以管理4800个记录×99个变量;对WINDOWS 95下的5.0版本,可根据计算机的配置情况设置变量数和记录数,如32M扩展内存的计算机,可处理2千万个数据。
变量数和记录数可以互相交易(trade),即减少记录数可以增加变量数,减少变量数可以增加记录数。
2.可以将分组变量转换成指示变量(哑变量),将字符串变量映射成数字代码。
3.可以对数据文件进行横向和纵向链接,可以将行数据转为列数据,或反之。
4.可以恢复、修改执行过的命令。
5.可以利用数值函数或字符串函数产生新变量。
6.可以从键盘或磁盘读入数据。
二、 Stata的统计功能Stata的统计功能很强,除了传统的统计分析方法外,还收集了近20年发展起来的新方法,如Cox比例风险回归,指数与Weibull回归,多类结果与有序结果的logistic回归,Poisson回归、负二项回归及广义负二项回归,随机效应模型等。
STATA使用教程
STATA使用教程第一章:介绍 StataStata 是一款统计分析软件,广泛应用于经济学、社会科学、健康科学和医学研究等领域。
本章将介绍 Stata 软件的基本特点、适用范围和主要功能。
1.1 Stata 的特点Stata 是一款功能强大、易于使用的统计软件。
不同于其他统计软件,Stata 具有灵活性高、数据处理效率好的优点。
它支持多种数据文件格式,可以处理大规模的数据集,并且具有丰富的数据处理、统计分析和图形展示功能。
1.2 Stata 的适用范围Stata 软件适用于各类研究领域,涵盖了经济学、社会科学、医学、健康科学等多个领域。
它广泛应用于定量分析、回归分析、面板数据分析、时间序列分析等领域,可用于统计推断、数据可视化和模型建立等任务。
1.3 Stata 的主要功能Stata 软件提供了丰富的功能模块,包括数据导入导出、数据清洗、数据管理、描述性统计、推断统计、回归分析、面板数据分析、时间序列分析、图形展示等。
这些功能模块为用户提供了全面且灵活的数据分析工具。
第二章:Stata 数据处理数据处理是统计分析的前置工作,本章将介绍 Stata 软件的数据导入导出、数据清洗和数据管理等功能。
2.1 数据导入导出Stata 支持导入多种文件格式的数据,如文本文件、Excel 文件和 SAS 数据集等。
用户可以使用内置命令或者图形界面进行导入操作,导入后的数据可以存储为 Stata 数据文件(.dta 格式),方便后续的数据处理和分析。
2.2 数据清洗数据清洗是数据处理的重要环节,Stata 提供了多种数据清洗命令,如缺失值处理、异常值处理和数据类型转换等。
用户可以根据实际情况选择合适的数据清洗操作,确保数据的准确性和完整性。
2.3 数据管理数据管理是有效进行数据处理的关键,Stata 提供了许多数据管理命令,如数据排序、数据合并、数据分割和数据标记等。
这些命令可以帮助用户高效地对数据进行管理和组织,提高数据处理效率。
stata教程
stata教程Stata 是一种广泛应用于统计分析的软件,拥有强大的数据处理和建模能力。
本教程将介绍 Stata 的一些基础操作和常用命令,帮助您快速上手使用该软件。
1. 安装和启动 Stata在开始使用Stata 之前,您需要先安装该软件。
安装完成后,双击图标启动 Stata。
2. 导入数据使用 Stata 进行统计分析的第一步是导入数据。
可以通过命令 `use` 来加载已有的 Stata 数据集,或者使用 `import` 命令导入其它格式的数据文件。
3. 数据处理Stata 提供了许多数据处理的命令,比如 `drop` 可以删除某些变量或观察值,`rename` 可以修改变量名,`generate` 可以创建新变量等。
4. 描述性统计描述性统计是对数据的基本概况进行分析,可以使用命令`summarize` 来获取平均值、标准差等统计量,使用 `tabulate`命令生成频数表,还可以通过 `graph` 命令绘制直方图或散点图等图形。
5. 假设检验假设检验用于验证某个统计假设是否成立。
Stata 提供了多种假设检验的命令,比如 `ttest` 可以进行单样本或独立样本 t 检验,`anova` 可以进行方差分析等。
6. 回归分析回归分析是一种常用的建模方法,可以用于研究变量之间的关系。
在Stata 中,可以使用`regress` 命令进行简单线性回归,使用 `logit` 命令进行逻辑回归等。
7. 图形输出Stata 可以生成各种类型的图形输出,比如线图、散点图、柱状图等。
可以使用`graph export` 命令将图形导出为图片文件,方便在报告中使用。
8. 编写批处理脚本如果需要重复执行一组命令,可以将这些命令写入批处理脚本。
Stata 支持编写批处理脚本来自动化数据处理和分析的过程。
以上是关于 Stata 的基础教程,希望能帮助您快速入门并熟练使用该软件进行数据分析。
更多高级功能和命令,请参考Stata 官方文档或相关教程。
《STATA简易操作》课件
使用Stata进行生存分析,包括数据导 入、选择合适的生存分析模型、参数 估计和结果解释。
分析生存曲线和风险函数,探究影响 因素对生存时间的影响。
进行模型假设检验和模型比较。
案例三:面板数据分析
总结词:利用面板数据分析方
法,探究个体、时间和其他变
量的交互作用。
01
详细描述
绘制折线图
折线图用于展示随时间变化的数据 趋势。
VS
在Stata中,可以通过输入“line yvar xvar”命令来绘制折线图。其中 yvar代表要展示的数据变量,xvar代 表时间变量。还可以通过添加选项来 修改线条样式、标记等。
05
Stata实战案例
案例一:线性回归分析
总结词:通过线性回归分析,探究自变量与因 变量之间的关系。
01
确定研究问题,选择合适的自变量和因变 量。
03
02
详细描述
04
使用Stata进行线性回归分析,包括数据 导入、模型设定、参数估计和结果解释。
分析模型的拟合优度,如判定系数、调整 判定系数等。
05
06
检验模型的假设条件,如线性关系、误差 项独立同分布等。
案例二:生存分析
总结词:利用生存分析方法,研究生 存时间与影响因素之间的关系。 详细描述
多元回归
探讨多个自变量对因变量的影响,以 及交互项和平方项的设定。
面板数据分析
面板数据介绍
阐述面板数据的概念、特点及其在经济学中 的应用。
固定效应与随机效应模型
比较两种模型的适用场景和结果解释。
面板数据的单位根与协整检验
介绍用于检验数据稳定性和长期关系的检验 方法。