
随机前沿模型(SFA)-原理解读
随机前沿模型(SFA )原理和软件实现
一、SFA 原理
在经济学中,常常需要估计生产函数或者成本函数。
生产函数f (x)的定义为:在给定投入x 情况下的最大产出。
但现实中的产商可能达不到最大产出的前沿,为了,假设产商i 的产量为:
i i i y f (x ,)βξ= (1)
其中,β为待估参数;i ξ为产商i 的水平,满足i 01ξ<≤。
如果i =1ξ,则产商i 正好处于效率前沿。
同时,考虑生产函数还会受到随机冲击,故将方程(1)改写成:
i v i i i y f (x ,)e βξ= (2)
其中,i v e 0>为随机冲击。
方程(2)意味着生产函数的前沿i v i f (x ,)e β是随机的,故此类模型称为“随机前沿模型”(stochastic frontier model )。
随机前沿模型最早由Aigner, Lovell and Schmidt(1977)提出,并在实证领域运用广泛,Kumbhakar and Lovell(2000)为该领域的研究写了一本著作,有兴趣的同学可以去参考。
假设o k
1i 1i ki f (x ,)e x x ββββ=L (柯布道格拉斯生产函数,共有K 个投入品),则对方程(2)取对数可得:
K i 0k ki i i k 1ln y =+ln x ln ββξν=++∑ (3)
由于i 01ξ<≤,故i ln 0ξ≤。
定义i i u =-ln 0ξ≥,则方程3可以写成:
K
i 0k ki i i k 1ln y =+ln x -u ββν=+∑ 其中,i u 0≥为“无效率”项,反映产商i 距离效率前沿面的距离。
混合扰动项
i i i ενμ=-分布不对称,
使用OLS 估计不能估计无效率项i u 。
为了估计无效率项i u ,必须对i i νμ、的分布作出假设,并进行更有效率的MLE (最大似然估计)估计。
一般,无效率项的分布假设有如下几种:
(1) 半正态分布
(2) 截断正态分布
(3) 指数分布
在一般的论文中,使用的最多的是半正态分布
随机前沿模型可以很容易地用于估计成本函数,经过与生产函数的随机前沿模型类似的推导可得:
K
i 0y i k ki i i k 1ln c =+lny ln P +u βββν=++∑
其中,i c 为产商i 的成本,i y 为产出,ki P 为要素K 的价格,i u 为无效率项,i ν为成本函数的随机冲击。
注意混合误差项的形式(符号)。
对于成本函数,i u =0意味着产商达到最低成本的效率前沿;
反之,如果i u 0>,则产商需付出更高的成本。
i u 是否存在的检验
使用随机前沿模型的前提是无效率项i u 存在,此假定可以通过检验
“220u 1u H : =0 vs H : >0σσ”来判断是否成立。
使用单边的广义似然比检验。
二、软件实现
Frontier4.1软件是由Tim Coelli 开发的一款专门用于完成随机前沿分析的软件,它可以用最大似然估计随机前沿成本模型和随机前沿生产模型,下面简单介绍一下该软件的使用方法,更加详细的说明可以参考英文指导《A Guide to FRONTIER Version 4.1: A Computer Program for Stochastic Frontier Production and Cost Function Estimation 》
Eg1.DTA 用于输入数据,是一个纯文本文件,数据文件的格式必须是3+K[+p]列。
第一列是评价体系的序号;
第二列是时期t ;
第三列是因变量;
第四列之后是K 个自变量;
[+p]仅当选择TE EFFECTS MODEL 模型输入。
EG1.INS 设置命令
1 1=ERROR COMPONENTS MODEL, 2=TE EFFECTS MODEL
选择模型
eg1.dta DATA FILE NAME
数据文件
eg1.out OUTPUT FILE NAME
结果存储文件
2 1=PRODUCTION FUNCTION, 2=COST FUNCTION
选择生产模型(1)还是成本模型(2)
n LOGGED DEPENDENT V ARIABLE (Y/N)
变量是不是已经进行了对数运算
25 NUMBER OF CROSS-SECTIONS
评价体系数目
1 NUMBER OF TIME PERIODS
时期数目
25 NUMBER OF OBSERV ATIONS IN TOTAL
总记录数目
2 NUMBER OF REGRESSOR V ARIABLES (Xs)
自变量个数
Y MU (Y/N) [OR DELTA0 (Y/N) IF USING TE EFFECTS MODEL]
假设U的分布。
Y表示截断分布,N表示半正态分布
n ETA (Y/N) [OR NUMBER OF TE EFFECTS REGRESSORS (Zs)]
y 表示时变模型,n表示非时变模型。
n STARTING V ALUES (Y/N)
选择n
其他设置保持不变。
物流业要素配置效率及区域异质性——基于SFA模型的实证检验

分析了 2005-2018 年全国各地区劳动、资本、技术三大生产要素资源配置效率。结果表明,全国物流业要素配置
效率大体呈波动变化的下降态势。资本和劳动力要素配置效率差异格局明显,总体呈现出“东强西弱”的异质性
格局,需要针对性地提升各区域生产要素的配置和利用水平,实现物流业多样化发展。
关键词:劳动力要素配置;物流业;随机前沿模型;异质性;实证分析
的产出模式,当 ui,t>0 时表示为产出导向型生产非效率项。
考虑物流业完全竞争要素市场下生产要素的自由流
动,在供求双方均拥有完全信息交换需求以保证竞争不受
到阻碍与干扰的前提下,要素配置便达到最优状态。参考
Kim(1992)的研究,有如下结论:
生产函数:Y=f (x1、x2…xj )
(2)
利润函数:π=TR-c=p·f (x1、x2…xj )-∑ j wj xj
中图分类号:F252
文献标识码:A
文章编号:2095-9397(2021)14-0111-04
文章著录格式:何纪翔,马晓琳 . 物流业要素配置效率及区域异质性——基于 SFA 模型的实证检验 [J]. 商业经
济研究,2021(14):111-114
引言
资本、劳动力均是维持生产活动不可或缺的物质基 础,为产业经济建设和发展提供了有力支撑。一直以来, 我国物流业粗放式发展格局依赖于生产要素无序的高投 入和高消耗,在很大程度上造成了要素配置扭曲,引起了 各类生产要素过度消耗、效率低下等严重阻碍经济可持 续发展的问题。而物流业不仅是服务业的重要组成部分, 在新常态经济格局下,物流业还是促进资源融通、加速 生产、带动消费发展的重要行业,物流业的发展需要更 多要素投入,要素资源约束也会更多地体现在物流业发 展过程中,以物流业提质增效为关键的第三产业发展方 式转型的要求同样迫切。因此,基于要素配置效率角度, 合理分析物流业发展质量,是加速物流经济整体发展水平 的关键。从物流业业务量来看,2020 年第一季度全国快 递单量累计 125.3 亿件,同比增长 3.2%;从市场规模来看, 伴随着存量消费市场持续向线上转移,多样化的物流形 态不断发展,以往的社会物流体系不断派生出市域物流、 短途快速物流等新业态,特别是移动互联网催生社区新 零售的发展,在很大程度上使得物流市场日益发展完善。 在物流经济可持续快速发展背景下,劳动力要素的稳定投 入不可或缺,2020 年 4 月,中共中央、国务院关于构建 更加完善的要素市场化配置体制机制的意见中指出要引 导劳动力要素合理畅通有序流动,这在一定程度上对于提
基于截面随机前沿模型的中国保险业效率研究
基于截面随机前沿模型的中国保险业效率研究江生忠;张煜【摘要】我国保险业快速发展,但依然面临生产低效率问题.为了提升保险业产出效率,能与国际同业竞争,研究中国保险业效率及影响因素十分必要.采用Cobb-Douglas生产函数形式,选取保费作为产出,应用截面随机前沿模型SFA,定量估计中国保险业产出效率.并采用多个控制变量实证分析教育、外资和薪酬对效率的作用.最后,选取赔偿及给付衡量产出,对模型进行稳健性检验.发现资本主要影响赔偿及给付,而劳动显著影响保费.保险业呈现规模报酬递增.效率较高,正在缓慢提升.外资对保险业效率影响正面,而教育和工资对效率的作用复杂.据此提出加大投入,做大规模,坚持对外开放,综合运用各种手段提高效率等的政策建议.这必将提升中国保险业效率,最终造福人民群众.【期刊名称】《保险职业学院学报》【年(卷),期】2017(031)005【总页数】8页(P5-12)【关键词】保险业;产出效率;截面随机前沿模型;影响因素【作者】江生忠;张煜【作者单位】南开大学金融学院,天津300071;南开大学金融学院,天津300071【正文语种】中文【中图分类】F84.481978年改革开放以来,中国保险业发展迅猛。
保险业经历了从无到有,从水平落后到效率较高的发展历程。
2001年入世以来,保险市场对外开放,保险企业更是进一步提质增效。
2009年起,中国保费收入更是突破了10万亿元大关,产能巨大。
但是,由于起点较低,以及一些深层次的体制机制问题,保险业依然面临着供给不足,服务水平落后,与国际效率前沿相比,存在生产无效率的严峻现状。
为此,国家提出保险业的供给侧改革,就是为了提升保险业的产出效率。
响应国家号召,赶超国际先进水平,减少资源浪费和产出无效率,提升民族保险企业的运营水平,依然是我国保险业所面临的重大挑战。
在此情况下,研究中国保险业的产出效率及影响因素,十分必要。
本文拟采用截面随机前沿方法,实证分析中国保险业的产出效率及影响因素,具体研究教育、外资和薪酬因素对效率的定量影响。
中国工业企业生产效率随机前沿模型分析
若TEC>1,则存在前沿效率的进步。 (3)规模效率变化(SEC) 一个厂商可以通过变动他的运营规模 使得该厂商运营与生产的技术最优规模 (TOPS)处,以提高其生产效率。 一个厂商在 某个时期的规模效率可以表示为:
均来源于2000 年~2 0 0 8年的 《中国统计年 鉴》 和 《科技统计年鉴》 , 部分年份的数据来 源于各年各地区的统计年鉴。 (1)实际工业总产值(Y)。 本文采用实际 工业总产值作为产出。 处理方式如下:将 《中国统计年鉴》 中规模以上工业企业的各 年名义工业总产值,经过各年各地区工业 品出厂价格指数平减, 得到实际的工业总 产值。 内资工业部门的实际工业总产值由 规模以上工业企业和规模以上三资企业的 实际工业总产值相减得到。 (2)固定资产净值(K)。 对于固定资产净 值的处理采用永续盘存法(PIM),以1999年 的 固 定 资 产 净 值 为 基 期, 以 相 邻 两 年 的 固 定资产年末余值之差作为当年的新增固定 资产投资。 公 式 如 下:
表2
+∑
n =1
N
n
InX nit +
1 N N ∑∑ 2 n =1 j =1
nj
InX nit InX njt +
∑
n =1
N
tn
tInX nit + t t +
1 2
tt
t 2 + D1 + D2 + D3 + Vit − U it (11)
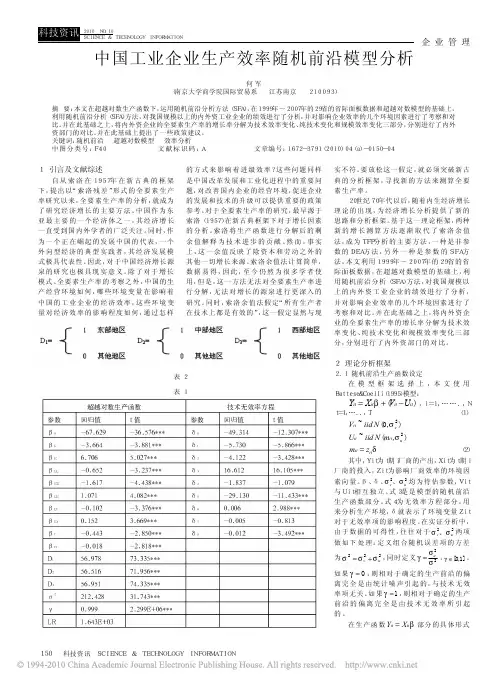
(1)内 资 工 业 企 业 的 估 计 结 果 分 析:我 们将内资工业部门的估计结果统计如表1 所示。 (2)对 于 显 著 性 和 假 设 检 验 的 说 明:由 表3.1,除了δ4、 δ7之外,所有系数均通过 了1%的t检验;而γ=0.999,并且显著,这说 明 生 产 对 于 前 沿 的 偏 离, 主 要 是 由 于 技 术 无效率所引起的。 对于是否存在无效性的
【国家社会科学基金】_随机前沿分析(sfa)_基金支持热词逐年推荐_【万方软件创新助手】_20140806

科研热词 推荐指数 技术效率 4 影响因素 3 随机前沿模型 2 随机前沿分析 2 随机前沿生产函数 1 随机前沿分析方法(sfa) 1 随机前沿函数模型 1 随机前沿函数 1 进入退出 1 航空航天产业 1 自然因素 1 联立方程组模型 1 粮食生产技术效率 1 生产率促进型投资 1 生产效率 1 物流业 1 灌溉用水效率 1 滞后效应 1 湖北省 1 渠道 1 支出扩张 1 技术前沿 1 批发市场 1 工业效率 1 区域差异 1 创新效率 1 分位数回归分解 1 农地城市流转效率 1 农产品 1 农业技术 1 全要素生产率 1 三阶段dea模型 1 sfa 1
科研热词 技术效率 随机前沿方法 随机前沿分析 随机前沿函数模型 高科技产业 面板门槛回归 随机前沿分析法(sfa) 间接溢出效应 金融安全 贸易 经验分析 经营绩效 直接溢出效应 生产性服务业 海外扩张 服务业 效率 战略引资 外溢效应 外商直接投资 制造业 利润效率 创新效率 创新 创业板 出口 中国信托业 中国上市公司 三阶段dea sfa ipo抑价
2012年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29
科研热词 技术效率 随机前沿分析 sfa 非参数方法 随机前沿分析方法 随机前沿分析(sfa) 陶瓷产业集群 营业税 经营绩效 管理效率(me) 空间过滤 空间计量 税收征管效率 环境因素 测土配方施肥技术 本土技术转移 教育投入产出 技术效率损失模型 技术创新 工业 国际技术转移 区域差异 创新效率 全要素生产率 主成分分析 σ 收敛 β 收敛 tobit模型 mc-sfa模型
推荐指数 3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
中国各省份产能利用率测度——基于随机前沿生产函数法的分析
产能过剩不仅会导致资源浪费、企业恶性竞争、公司生产经营困难甚至破产倒闭,还会大幅度扰乱社会秩序,增加国际贸易摩擦风险。
工业、制造业作为支持国家发展的基础性产业,其重要性不言而喻。
然而,人们对当前经济表现所知甚少,因此本文将从产能利用率的角度出发,对当前中国各个省份的产能利用情况进行测度,并运用随机前沿生产函数对产能利用率进行估计分析。
一、文献综述从定义上来讲,产能利用率是指观察到的实际产出y 与潜在产出Y 的比值,潜在产出是指在给定要素投入、技术水平,且要素被充分利用的情况下,企业/行业所能够达到的最大产出水平。
所以,CU=y/Y。
在现实社会中,由于企业在生产的时候经常需要考虑市场需求、资源限制、设备磨损等多方面因素,不能实现投入要素的充分利用,所以往往会出现实际产出小于潜在产出,既CU<1。
目前国内关于测量产能利用率的研究工作尚处于起步阶段,所采用的方法也主要是借鉴国外的相关研究。
国内外学者测算产能利用率的方法大致分为以下几种:1.峰值法:在20世纪60年代,美国学者Klein 就开展了对企业产能利用率的测量,其提出的“峰值法”可谓是开创了经济分析法的先河。
Klein 将产能定义为企业在一段时间内所达到的产出水平的峰值,即在一个经济周期中企业实际产出的最大值作为潜在产出。
峰值法的最大缺陷在于我们无法确定企业在产出峰值是否实现了产能的完全利用。
2.函数法:由于峰值法限制较多,后续学者开始从产出的微观经济定义出发对产能利用率进行研究。
根据现有要素的投入情况,构建相应的生产函数、成本函数或者利润函数,将产能定义为企业利润最大化或者成本最小化情况下的产出水平,将实际产出水平与计算得到的最佳产出水平的比值作为衡量产能利用率的标准。
相对而言,函数法以微观经济基础作为理论支撑,但是对函数形式设定要求严格,一旦函数形式设定错误,所测算的产能利用率可信度也随之降低。
3.协整法:Shaikh and Moudud (2004)认为产出受到企业固定资本存量的影响,两者之间具有稳定的长期关系,所以提出了协整法测量产能利用率。
空间面板随机前沿模型及技术效率估计.doc

空间面板随机前沿模型及技术效率估计空间面板随机前沿模型及技术效率估计林佳显, 龙志和, 林光平 1 12 ( 1. 华南理工大学经济与贸易学院, 广东广州510006; 摘要: 随机前沿模型是测算技术效率的重要方法之一。
通常,模型假设生产单元之间彼此独立,然而在技术扩散过程中,空间外部性起着重要作用。
文章结合随机前沿模型理论与空间经济计量分析方法,构建空间面板随机前沿模型, 同时考虑空间滞后因变量和空间误差自相关,并逐步放松模型设定条件, 首先考虑技术效率时变,接着引入技术无效率项的异方差性,之后考虑观察数据中潜在的截面异质性,分别以引入随机截面特有项和设定随机系数的形式来表示截面中图分类号: F064. 1 ----------------------------------- 精选公文范文,管理类,工作总结类,工作计划类文档,感谢阅读下载---------------------------------------- ~ 1 ~文献标识码: A 文章编号: 100022154 ( 2010 ) 05 20071 20 、引言随机前沿模型( SFM ) 的理论最初 A igne r、Love ll 和Schm id t (ALS) ( 1977 ) [ 2 ] [ 1 ] , Meeu sen 和V an den B roeck (MB ) ( 1977 ) 提出, 并很快成为计量经济学中一个引人注目的分支,被广泛应用于效率测算和生[ 3 ] 产率分析尤其是在Jond row 等( JLM S) ( 1982 )指出各个生产单元的技术无效率可以通过条件分布[ u |i vi - ui ] 的期望 E [ ui | vi - ui ] 或模M ode [ ui | vi - ui ] 来估算以后。
随机前沿分析( SFA ) 始于对生产最优化的研究, 经过30 多年的发展, 其在理论研究与实践应用方面都得到了深入的发展, 已被尝试性地应用于生产经济学以外的领域, 如劳动经济学、公共经济学以及金融经济学等。
【国家自然科学基金】_随机前沿方法(sfa)_基金支持热词逐年推荐_【万方软件创新助手】_20140802
科研热词 随机前沿生产函数 生产技术效率 农业用水效率 tobit模型
推荐指数 1 1 1 1
2010年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23
科研热词 随机前沿分析 灌溉用水效率 sfa dea 面板数据 随机前沿生产函数 通径分析 跨国公司r&d投资 绩效 生产效率 玉米优势产区 玉米 溢出效应 投资效率 技术非效率模型 大股东控制 多层次/随机前沿分析 农户 全要素生产率 供应商 人力资源外包 主成分变量 c-d生产函数
推荐指数 3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2011年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 随机前沿分析 技术效率 物流业 数据包络分析 全要素生产率 随机前沿方法 随机前沿主方程组方法 配置效率 能源消耗 股权结构 综合绩效 经济增长 空间相关性 空间收敛性 研究现状 研发技术效率 独立董事 影响因素 大型综合医院 复合残差项 地区差异 区域增长 全要素生产率变动分解 企业效率 代理成本 主成分分析 sfa
2014年 序号 1 2 3 4 5 6 7 8 9 10 11
科研热词 高技术产业 随机前沿函数 环境因素 旅游业 医疗服务 医疗卫生服务效率 医疗卫生服务 全要素生产率 专利产业化效率 sfa方法 malmquist指数
推荐指数 1 1 1 1 1 1 1 1 1 1 1
2013年 科研热词 推荐指数 随机前沿方法 4 随机前沿分析 4 技术效率 4 高校校办产业 2 随机前沿分析(sfa) 2 效率 2 投资来源 2 成本函数 2 全要素生产率 2 fdi 2 高校知识创新链 1 高校 1 随机前沿分析方法(sfa) 1 随机前沿 1 绩效评价 1 统计分析 1 科技创新 1 碳排放 1 湖北省 1 数据包络分析 1 政产学研用 1 技术转移效率 1 房地产上市公司 1 战略性新兴产业 1 成本效率 1 成本一效益效率 1 成本-效益效率 1 影响因素 1 当地政府支持 1 外部运营环境 1 国防科技工业 1 商业银行 1 参数法 1 协同 1 医疗卫生 1 区域市场需求规模不确定性 1 创新效率 1 创意经济 1 农地城市流转效率 1 军民融合 1 公交线路 1 企业规模 1 人力资本 1 产权类型 1 产业集聚 1 产业竞争力 1 交通运输系统工程 1 专利转化效率 1 x效率 1 malmquist指数 1
基于SFA方法的中国智能制造业全要素生产率研究
基于SFA方法的中国智能制造业全要素生产率研究*申丹虹 崔张鑫内容摘要:本文基于随机前沿分析(SFA)和Malmquist法对我国2010—2018年的智能制造业①上市公司的全要素生产率进行了测算和分解,以探寻智能制造业的发展现状及存在的问题,从而找到提升路径。
结果表明:智能制造业目前还处于规模递减的状态,但是发展潜力很大。
智能制造业的全要素生产率年均增长为 5%,主要归因于技术水平的落后,说明智能与制造业的融合并没有消除“信息技术生产率悖论”的存在。
我国依然要加大对技术创新的投入并加强对高素质人才和管理人才的投入,推进要素的优化配置以及增加资本的投入从而促进制造业的高质量发展。
关键词:智能制造业;全要素生产率;Malmquist;随机前沿函数中图分类号:C812 文献标识码:A 文章编号:1004-7794(2021)01-0048-06DOI: 10.13778/ki.11-3705/c.2021.01.006一、引言和文献综述在互联网、大数据、云计算等技术不断发展的基础上,人工智能催生了一批新技术,引领着新一轮的科技革命和产业变革,各领域对人工智能的应用加速推进,在此背景下,人工智能和制造业的融合,可以为制造业的高质量发展提供新动能。
米晋宏等(2020)运用上市公司的数据实证研究分析了人工智能技术的应用对制造业产业结构的升级有促进作用[1]。
付文宇等(2020)通过2003—2018年30个省份的面板数据实证分析表明人工智能通过技术的创新和人才资本的积累效应促进了了制造业的升级[2]。
智能制造业是人工智能和制造业的深度融合。
目前,对于智能制造业全要素生产率的研究是热点话题。
葛金田(2019)提出生产率是衡量竞争力和经济可持续发展的重要影响因素,因而提高智能制造业全要素生产率极其重要[3]。
一些学者认为智能促进制造业全要素生产率的提升,刘亮等(2020)证伪了“信息技术生产率悖论”的存在,指出人工智能对中高技术行业生产率的提升效应强[4]。
随机前沿分析和包络数据分析SFA,DEA及运行结果
随机前沿分析和包络数据分析SFA,DEA及运⾏结果先推荐读这篇⽂章:邹志庄教授计量研究汇结,三部分总结经济研究经验(昨⽇,计量哥推荐出去之后,由于未能够把邹⾄庄教授名字校正正确,对此向各位读者和Chow教授表⽰抱歉).正⽂在经济学中,技术效率是指在既定的投⼊下产出可增加的能⼒或在既定的产出下投⼊可减少的能⼒。
常⽤度量技术效率的⽅法是⽣产前沿分析⽅法。
所谓⽣产前沿是指在⼀定的技术⽔平下,各种⽐例投⼊所对应的最⼤产出集合。
⽽⽣产前沿通常⽤⽣产函数表⽰。
前沿分析⽅法根据是否已知⽣产函数的具体的形式分为参数⽅法和⾮参数⽅法,前者以随机前沿分析(StochasticFrontierAnalysis,下⽂简称SFA)为代表,后者以数据包络分析(DataEnvelopeAnalysis,下⽂简称DEA)为代表。
⽬前,我国学者已将这两种⽅法⼴泛应⽤于各个领域,但在使⽤过程中也存在⼀些问题,尤其对于SFA。
⽽SFA与DEA各有其利弊,不能简单地认为⼀种⽐另⼀种好,必须根据具体问题和实际度量结果做出判断。
因此如何正确合理地使⽤这两种⽅法是⽬前⾯临的主要问题。
针对上述情况,本⽂将⾸先简要总结SFA与DEA中最常⽤的模型;然后分别指出使⽤中⼀些关键的地⽅和常见的问题;最后⽐较分析这种两种⽅法。
1 SFA模型在经济学中,技术效率的概念应⽤⼴泛。
Koopmans⾸先提出了技术效率的概念,他将技术有效定义为:在⼀定的技术条件下,如果不减少其它产出就不可能增加任何产出,或者不增加其它投⼊就不可能减少任何投⼊,则称该投⼊产出为技术有效的。
Farrell⾸次提出了技术效率的前沿测定⽅法,并得到了理论界的⼴泛认同,成为了效率测度的基础。
在实际应⽤中,前沿⾯是需要确定的。
其确定⽅法主要两种:⼀种是通过计量模型对前沿⽣产函数的参数进⾏统计估计,并在此基础上,对技术效率进⾏测定,这种⽅法被称为效率评价的“统计⽅法”或“参数⽅法”;另⼀种是通过求解数学中的线性规划来确定⽣产前沿⾯,并进⾏技术效率的测定,这种⽅法被称为“数学规划⽅法”或“⾮参数⽅法”。
【国家自然科学基金】_随机前沿分析(sfa)_基金支持热词逐年推荐_【万方软件创新助手】_20140801
2013年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52
2014年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21
53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74
协同 区域市场需求规模不确定性 创意经济 出口贸易 农户技术效率 农地城市流转效率 农业产业化 军民融合 公交线路 企业规模 人力资源效率 人力资本 产权类型 产业集聚 产业竞争力 交通运输系统工程 主成分分析 专利转化效率 不良贷款 三阶段dea模型 x效率 malmquist指数
2012年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51
科研热词 推荐指数 技术效率 8 随机前沿分析 7 随机前沿方法 4 随机前沿模型 3 随机前沿分析(sfa) 3 效率 3 影响因素 3 商业银行 3 sfa 3 高校校办产业 2 能源效率 2 投资来源 2 战略性新兴产业 2 成本效率 2 成本函数 2 创新效率 2 全要素生产率 2 fdi 2 高校知识创新链 1 高校 1 面板单位根 1 随机效应回归 1 随机性收敛 1 随机前沿生产函数 1 随机前沿分析方法(sfa) 1 长三角 1 自然因素 1 绿色经济 1 绩效评价 1 统计分析 1 空间差异 1 科技环境 1 科技创新 1 碳排放 1 知识溢出 1 滞后效应 1 湖北省 1 水资源利用效率 1 数据包络分析 1 政产学研用 1 技术转移效率 1 房地产上市公司 1 成本一效益效率 1 成本-效益效率 1 当地政府支持 1 外部运营环境 1 外资r&d 1 地区差异 1 国际比较 1 国防科技工业 1 国民健康 1 参数法 1