
易语言正则表达式大全
易语言正则表达式大全
摘要:
一、易语言正则表达式简介
1.易语言正则表达式的概念
2.易语言正则表达式的作用
二、易语言正则表达式的语法与规则
1.字符类
2.量词
3.选择与分组
4.捕获组与非捕获组
5.零宽断言与负向预查
6.正向预查与反向预查
三、易语言正则表达式的应用实例
1.文本匹配与替换
2.文件处理
3.网络爬虫
四、易语言正则表达式的优化与调试
1.优化正则表达式
2.调试正则表达式
正文:
易语言正则表达式大全
易语言正则表达式是一种强大的文本处理工具,通过特定的语法规则与模式,可以快速高效地对大量文本进行匹配、替换、分割等操作。
易语言正则表达式广泛应用于编程、文本编辑、数据分析等领域。
本文将详细介绍易语言正则表达式的相关知识。
一、易语言正则表达式简介
易语言正则表达式(Regular Expression),简称regex,是一种用于处理字符串的强大工具。
它可以用来检查字符串是否符合某种模式、提取字符串中的特定部分或者替换字符串中的某些内容。
易语言正则表达式的应用场景非常广泛,例如在文本编辑器中查找并替换特定文本,或者在编程语言中进行字符串处理等。
二、易语言正则表达式的语法与规则
易语言正则表达式的语法主要包括字符类、量词、选择与分组、捕获组与非捕获组、零宽断言与负向预查、正向预查与反向预查等。
1.字符类:用于匹配某一类字符。
例如:[a-zA-Z] 表示匹配所有英文字母。
2.量词:用于指定字符或字符类出现的次数。
例如:d{3} 表示匹配三个数字。
3.选择与分组:用于根据不同的条件选择匹配的文本。
例如:(ab|cd) 表示匹配ab 或cd。
4.捕获组与非捕获组:用于将正则表达式匹配到的内容捕获到一个组中,或者不进行捕获。
例如:(?:ab) 表示不捕获内容的非捕获组。
5.零宽断言与负向预查:用于检查某个位置是否存在某个字符或字符类,
但不会匹配该位置的字符。
例如:^ 表示检查字符串开头是否匹配某个字符或字符类。
6.正向预查与反向预查:用于检查某个位置是否存在某个字符或字符类,并匹配该位置的字符。
例如:$ 表示检查字符串结尾是否匹配某个字符或字符类。
三、易语言正则表达式的应用实例
易语言正则表达式在实际应用中非常广泛,例如在文本编辑器中进行文本匹配与替换、在编程语言中处理文件名或URL 等。
通过合理地设计和使用正则表达式,可以极大地提高文本处理的效率。
四、易语言正则表达式的优化与调试
为了提高正则表达式的性能,可以通过优化正则表达式来减少匹配次数。
此外,在编写正则表达式时,需要进行充分的调试,以确保正则表达式能够正确地匹配所需的文本。
综上所述,易语言正则表达式是一种功能强大且实用的文本处理工具。
常用的正则表达式代码汇总

常⽤的正则表达式代码汇总常⽤的正则表达式代码汇总常⽤的正则表达式代码汇总:1。
^\d+$ //匹配⾮负整数(正整数 + 0)2。
^[0-9]*[1-9][0-9]*$ //匹配正整数3。
^((-\d+)|(0+))$ //匹配⾮正整数(负整数 + 0)4。
^-[0-9]*[1-9][0-9]*$ //匹配负整数5。
^-?\d+$ //匹配整数6。
^\d+(\.\d+)?$ //匹配⾮负浮点数(正浮点数 + 0)7。
^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$ //匹配正浮点数8。
^((-\d+(\.\d+)?)|(0+(\.0+)?))$ //匹配⾮正浮点数(负浮点数 + 0)9。
^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$ //匹配负浮点数10。
^(-?\d+)(\.\d+)?$ //匹配浮点数11。
^[A-Za-z]+$ //匹配由26个英⽂字母组成的字符串12。
^[A-Z]+$ //匹配由26个英⽂字母的⼤写组成的字符串13。
^[a-z]+$ //匹配由26个英⽂字母的⼩写组成的字符串14。
^[A-Za-z0-9]+$ //匹配由数字和26个英⽂字母组成的字符串15。
^\w+$ //匹配由数字、26个英⽂字母或者下划线组成的字符串16。
^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$ //匹配email地址17。
^[a-zA-z]+://匹配(\w+(-\w+)*)(\.(\w+(-\w+)*))*(\?\S*)?$ //匹配url18。
匹配中⽂字符的正则表达式: [\u4e00-\u9fa5]19。
匹配双字节字符(包括汉字在内):[^\x00-\xff]20。
正则表达式大全
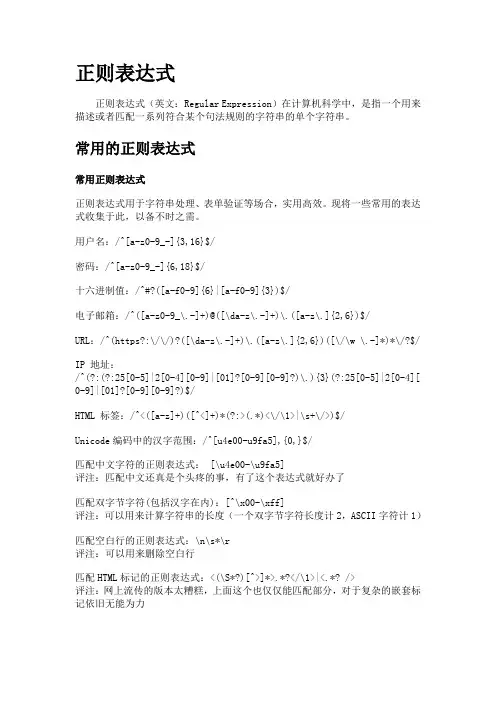
正向预查,在任何匹配 pattern 的字符串开始处匹配查找字符串。这是一个非获取匹配,也就是 说,该匹配不需要获取供以后使用。例如,“Windows(?=95|98|NT|2000)”能匹配“Windows2000” (?=pattern) 中的“Windows”,但不能匹配“Windows3.1”中的“Windows”。预查不消耗字符,也就是说, 在一个匹配发生后,在最后一次匹配之后立即开始下一次匹配的搜索,而不是从包含预查的字符 之后开始。
匹配 Email 地址的正则表达式: \w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)* 评注:表单验证时很实用
匹配网址 URL 的正则表达式:[a-zA-z]+://[^\s]* 评注:网上流传的版本功能很有限,上面这个基本可以满足需求
匹配帐号是否合法(字母开头,允许 5-16 字节,允许字母数字下划线): ^[a-zA-Z][a-zA-Z0-9_]{4,15}$ 评注:表单验证时很实用
标识一个八进制转义值或一个向后引用。如果\nm 之前至少有 nm 个获得子表达式,则 nm 为向后 引用。如果\nm 之前至少有 n 个获取,则 n 为一个后跟文字 m 的向后引用。如果前面的条件都不 满足,若 n 和 m 均为八进制数字(0-7),则\nm 将匹配八进制转义值 nm。
如果 n 为八进制数字(0-3),且 m 和 l 均为八进制数字(0-7),则匹配八进制转义值 nml。
?
的。非贪婪模式尽可能少的匹配所搜索的字符串,而默认的贪婪模式则尽可能多的匹配所搜索的
字符串。例如,对于字符串“oooo”,“o+?”将匹配单个“o”,而“o+”将匹配所有“o”。
regexp 常用表达式
regexp 常用表达式
正则表达式(RegExp,或称为正规表达式)是用于匹配字符串模式的强大工具。
以下是一些在正则表达式中常用的模式:
1. 匹配数字:
•匹配一个或多个数字:\d+
•匹配零或一个数字:\d?
•匹配一个数字范围:\d{2,4}(匹配2到4个数字)
2. 匹配字母:
•匹配一个或多个字母:[a-zA-Z]+
•匹配零或一个字母:[a-zA-Z]?
3. 匹配单词字符:
•匹配一个或多个单词字符(字母、数字、下划线):\w+
4. 匹配空格:
•匹配一个或多个空格:\s+
5. 匹配开头和结尾:
•匹配字符串开头:^
•匹配字符串结尾:$
6. 匹配任意字符:
•匹配除换行符外的任意字符:.
7. 转义特殊字符:
•如果要匹配特殊字符本身,需要使用反斜杠 \ 进行转义。
8. 匹配字符集:
•匹配字符集中的任何一个字符:[aeiou](匹配元音字母)
•匹配字符集中的任何一个字符的补集:[^0-9](匹配非数字字符)
9. 限定符:
•匹配零次或多次:*
•匹配一次或多次:+
•匹配零次或一次:?
•匹配固定次数:{n}、{n,}、{n,m}
10. 分组和引用:
•使用括号进行分组:(pattern)
•引用分组中匹配的文本:\1、\2 等
11. 或操作:
•匹配 A 或 B:A|B
这只是正则表达式的基础,正则表达式还有许多高级特性和用法。
根据具体需求,你可能需要深入学习更多关于正则表达式的内容。
正则表达式150种表达方式

正则表达式150种表达方式1、删除所有数字。
只要查找:\d就OK。
为了不留空行:替换处:\d2、删除所有英文字母。
只要查找:\a就OK。
为了不留空行:替换处:\d3、删除除换行符以外的所有。
只要查找:. 为了不留空行:替换处:\d4、既删除英文字母又删除数字。
只要查找:\w。
为了不留空行:替换处:\d5、删除数字加字母加等于(如:3a=或3zz=)只要查找:\d+\a+\=。
为了不留空行:替换处:\d6、删除换行。
只要查找:$。
替换处:\d(还原查找:\a+=\f。
替换:\0\n)。
如在换行后加一空格,查找:(\a)$。
替换:\0 \d。
7、删除空行只要查找:^$。
为了不留空行:替换处:\d8、删除首尾空格。
只要查找:^\s*|\s*$就OK9、删除行前数字及顿号。
只要查找:\d+、替换为空10、删除末尾标点符号。
只要查找:\P+$|\P+\s+$,“|”前面是没有空格的,“|”后面有空格,P后的加是为了……而用的。
11、删除末尾空格。
只要查找:\s+$。
替换为空。
12、删除第一个字如:“的我们”中的“的”只要查找:^\的。
13、删除第几个字。
查找:查找:^().(.+)。
替换:\1\2。
去掉前面的拼音:查找:^\a+替换为空。
第一个括号里可加“.”且可变。
14、删含的。
查:.*的.*替:\d。
的头查:.*=的.*替:\d。
的尾查:\a.*\c.*的$替:\d(留它不匹配)●删非的行查:^[^的]+$替:\d15、删除几码以上的码查:^(...)...替:\1。
删第几位码。
查:^(...).(.+)替:\1\2(变成\1,\2则其位则改成,了)首括号的.可变。
16、删除各类型的几字词,但必须是码前词后或纯词。
三字词:查找:^\~f{}\f{3}$替换:\d。
替换:\d “3”可以改。
17、删除11字词及其以上的词条查找(自定义格式):\a{}\=(\c|\P|\p){11,}。
替换:\d。
11可改。
20个正则表达式必知(能让你少写1,000行代码)
20个正则表达式必知(能让你少写1,000⾏代码)正则表达式(regular expression)描述了⼀种字符串匹配的模式,可以⽤来检查⼀个串是否含有某种⼦串、将匹配的⼦串做替换或者从某个串中取出符合某个条件的⼦串等。
列⽬录时, dir *.txt或ls *.txt中的*.txt就不是⼀个正则表达式,因为这⾥*与正则式的*的含义是不同的。
构造正则表达式的⽅法和创建数学表达式的⽅法⼀样。
也就是⽤多种元字符与运算符可以将⼩的表达式结合在⼀起来创建更⼤的表达式。
正则表达式的组件可以是单个的字符、字符集合、字符范围、字符间的选择或者所有这些组件的任意组合。
正则表达式是由普通字符(例如字符 a 到 z)以及特殊字符(称为"元字符")组成的⽂字模式。
模式描述在搜索⽂本时要匹配的⼀个或多个字符串。
正则表达式作为⼀个模板,将某个字符模式与所搜索的字符串进⾏匹配。
正则表达式,⼀个⼗分古⽼⽽⼜强⼤的⽂本处理⼯具,仅仅⽤⼀段⾮常简短的表达式语句,便能够快速实现⼀个⾮常复杂的业务逻辑。
熟练地掌握正则表达式的话,能够使你的开发效率得到极⼤的提升。
正则表达式经常被⽤于字段或任意字符串的校验,如下⾯这段校验基本⽇期格式的JavaScript代码:var reg = /^(\\d{1,4})(-|\\/)(\\d{1,2})\\2(\\d{1,2})$/;var r = fieldValue.match(reg);if(r==null)alert('Date format error!');下⾯是在前端开发中经常使⽤到的20个正则表达式:1 . 校验密码强度密码的强度必须是包含⼤⼩写字母和数字的组合,不能使⽤特殊字符,长度在8-10之间。
^(?=.*\\d)(?=.*[a-z])(?=.*[A-Z]).{8,10}$2. 校验中⽂字符串仅能是中⽂。
^[\\u4e00-\\u9fa5]{0,}$3. 由数字、26个英⽂字母或下划线组成的字符串^\\w+$4. 校验E-Mail 地址同密码⼀样,下⾯是E-mail地址合规性的正则检查语句。
易语言正则表达式大全

易语言正则表达式大全包含以下几个主要部分:1. 字符集:* `[abc]`:匹配a、b 或c。
* `[^abc]`:匹配除方括号内字符以外的任意字符。
* `[a-zA-Z]`:匹配所有英文字母。
* `[0-9]`:匹配数字。
* `\d`:匹配数字,等价于[0-9]。
* `\D`:匹配非数字,等价于`[^0-9]`。
* `\s`:匹配空白字符(空格、制表符、换行符等)。
* `\S`:匹配非空白字符。
* `\w`:匹配单词字符(字母、数字、下划线),等价于`[a-zA-Z0-9_]`。
* `\W`:匹配非单词字符。
2. 量词:* `?`:出现0 次或1 次。
* `*`:出现0 次或多次。
* `+`:出现1 次或多次。
* `{n}`:出现n 次。
* `{n,}`:出现n 次或多次。
* `{n,m}`:出现n 到m 次。
3. 分组与选择:* `( )`:分组,将多个字符组合成一个整体。
* `|`:选择,匹配该符号前后的任意一个表达式。
4. 定位符:* `^`:匹配输入字符串的开始位置。
* `$`:匹配输入字符串的结束位置。
5. 转义字符:* `\`:用于转义特殊字符,如`.`、`*`、`+` 等。
6. 预定义模式:* `\b`:匹配一个单词边界,即字与空格间的位置。
* `\B`:匹配非单词边界的位置。
7. 反向引用:* `\1`、`\2`、`\3` 等:用于引用前面的分组中捕获的内容。
8. 零宽断言:* `(?=exp)`:正向肯定预查,匹配后面跟随exp 的位置。
* `(?!exp)`:正向否定预查,匹配后面不跟随exp 的位置。
* `(?<=exp)`:反向肯定预查,匹配前面是exp 的位置。
* `(?<!exp)`:反向否定预查,匹配前面不是exp 的位置。
9. 贪婪与懒惰量词:* `*?`、`+?`、`{n,}?` 等:懒惰量词,尽可能少地匹配。
* `*`、`+`、`{n,}` 等:贪婪量词,尽可能多地匹配。
正则表达式参考大全
各式各样的正则表达式参考大全:^\d+$//匹配非负整数(正整数+ 0)//匹配整数^\d+(\.\d+)?$//匹配非负浮点数(正浮点数+ 0)^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$//匹配正浮点数^((-\d+(\.\d+)?)|(0+(\.0+)?))$//匹配非正浮点数(负浮点数+ 0)^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$//匹配负浮点数^(-?\d+)(\.\d+)?$//匹配浮点数^[A-Za-z]+$????????? //匹配由26个英文字母组成的字符串^[A-Z]+$??? //匹配由26个英文字母的大写组成的字符串^[a-z]+$//匹配由26个英文字母的小写组成的字符串^[A-Za-z0-9]+$//匹配由数字和26个英文字母组成的字符串^\w+$//匹配由数字、26个英文字母或者下划线组成的字符串^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$//匹配email地址^[a-zA-z]+://匹配(\w+(-\w+)*)(\.(\w+(-\w+)*))*(\?\S*)?$//匹配url匹配中文字符的正则表达式:[\u4e00-\u9fa5]匹配双字节字符(包括汉字在内):[^\x00-\xff]匹配空行的正则表达式:\n[\s| ]*\r匹配HTML标记的正则表达式:/<(.*)>.*<\/>|<(.*) \/>/匹配首尾空格的正则表达式:(^\s*)|(\s*$)匹配Email地址的正则表达式:\w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*匹配网址URL的正则表达式:^[a-zA-z]+://(\w+(-\w+)*)(\.(\w+(-\w+)*))*(\?\S*)?$ 匹配帐号是否合法(字母开头,允许5-16字节,允许字母数字下划线):^[a-zA-Z][a-zA-Z0-9_]{4,15}$匹配国内电话号码:(\d{3}-|\d{4}-)?(\d{8}|\d{7})?匹配腾讯QQ号:^[1-9]*[1-9][0-9]*$下表是元字符及其在正则表达式上下文中的行为的一个完整列表,具体到每个正则表达式符号:\ 将下一个字符标记为一个特殊字符、或一个原义字符、或一个后向引用、或一个八进制转义符。
正则表达式语法大全
正则表达式语法⼤全. :匹配任何单个字符。
例如正则表达式“b.g”能匹配如下字符串:“big”、“bug”、“b g”,但是不匹配“buug”,“b..g”可以匹配“buug”。
[ ] :匹配括号中的任何⼀个字符。
例如正则表达式“b[aui]g”匹配bug、big和bag,但是不匹配beg、baug。
可以在括号中使⽤连字符“-”来指定字符的区间来简化表⽰,例如正则表达式[0-9]可以匹配任何数字字符,这样正则表达式“a[0-9]c”等价于“a[0123456789]c”就可以匹配“a0c”、“a1c”、“a2c”等字符串;还可以制定多个区间,例如“[A-Za-z]”可以匹配任何⼤⼩写字母,“[A-Za-z0-9]”可以匹配任何的⼤⼩写字母或者数字。
( ) :将() 之间括起来的表达式定义为“组”(group),并且将匹配这个表达式的字符保存到⼀个临时区域,这个元字符在字符串提取的时候⾮常有⽤。
把⼀些字符表⽰为⼀个整体。
改变优先级、定义提取组两个作⽤。
| :将两个匹配条件进⾏逻辑“或”运算。
'z|food' 能匹配"z" 或"food"。
'(z|f)ood' 则匹配"zood" 或"food"。
:匹配0⾄多个在它之前的⼦表达式,和通配符没关系。
例如正则表达式“zo”能匹配“z”、“zo”以及“zoo”;因此“.”意味着能够匹配任意字符串。
"z(b|c)"→zb、zbc、zcb、zccc、zbbbccc。
"z(ab)"能匹配z、zab、zabab(⽤括号改变优先级)。
+ :匹配前⾯的⼦表达式⼀次或多次,和对⽐(0到多次)。
例如正则表达式9+匹配9、99、999等。
“zo+”能匹配“zo”以及“zoo”,不能匹配"z"。
:匹配前⾯的⼦表达式零次或⼀次。
《易语言“正则表达式”教程》
《易语⾔“正则表达式”教程》”与字符串”匹配时,匹配的结果是:成功;匹配到的内容是”整个字符串,表达式中的”将与字符串中最后⼀个《易语⾔“正则表达式”教程》本⽂改编⾃多个⽂档,因此如有雷同,不是巧合。
“正则表达式”的应⽤范围越来越⼴,有了这个强⼤的⼯具,我们可以做很多事情,如搜索⼀句话中某个特定的数据,屏蔽掉⼀些⾮法贴⼦的发⾔,⽹页中匹配特定数据,代码编辑框中字符的⾼亮等等,这都可以⽤正则表达式来完成。
本书分为四个部分。
第⼀部分介绍了易语⾔的正则表达式⽀持库,在这⾥,⼤家可以了解第⼀个正则表达式的易语⾔程序写法,以及⼀个通⽤的⼩⼯具的制作。
第⼆部分介绍了正则表达式的基本语法,⼤家可以⽤上述的⼩⼯具进⾏试验。
第三部分介绍了⽤易语⾔写的正则表达式⼯具的使⽤⽅法。
这些⼯具是由易语⾔⽤户提供的,有的⼯具还带有易语⾔源码。
他们是:monkeycz、零点飞越、寻梦。
第四部分介绍了正则表达式的⾼级技巧。
⽬录《易语⾔“正则表达式”教程》 1⽬录 1第⼀章易语⾔正则表达式⼊门 3⼀.与DOS下的通配符类似 3⼆.初步了解正则表达式的规定 3三.⼀个速查列表 4四.正则表达式⽀持库的命令 54.1第1个正则表达式程序 54.2第2个正则表达式例程 74.3第3个例程 84.4⼀个⼩型的正则⼯具 9第⼆章揭开正则表达式的神秘⾯纱 11引⾔ 12⼀.正则表达式规则 121.1普通字符 121.2简单的转义字符 131.3能够与“多种字符”匹配的表达式 141.4⾃定义能够匹配“多种字符”的表达式 16 1.5修饰匹配次数的特殊符号 171.6其他⼀些代表抽象意义的特殊符号 20⼆.正则表达式中的⼀些⾼级规则 212.1匹配次数中的贪婪与⾮贪婪 212.2反向引⽤\1,\2 (23)2.3预搜索,不匹配;反向预搜索,不匹配 24三.其他通⽤规则 25四.其他提⽰ 27第三章正则表达式⼯具与实例 28⼀.正则表达式⽀持库 291.1“正则表达式”数据类型 291.2“搜索结果”数据类型 30⼆.正则表达式实⽤⼯具 302.1⼀个成品⼯具 302.2易语⾔写的⼯具 33三.应⽤实例 343.1实例1 343.2实例2 363.3实例3 373.4实例4 37第四章正则表达式话题 38引⾔ 38⼀.表达式的递归匹配 381.1匹配未知层次的嵌套 381.2匹配有限层次的嵌套 39⼆.⾮贪婪匹配的效率 402.1效率陷阱的产⽣ 402.2效率陷阱的避免 41附录: 42⼀.17种常⽤正则表达式 42第⼀章易语⾔正则表达式⼊门⼀.与DOS下的通配符类似其实,所谓的“正则表达式”,是⼤家⼀直在使⽤的,记得吗?在搜索⽂件时,会使⽤⼀种威⼒巨⼤的武器——DOS通配符——“?”和“”。
易语言正则表达式大全
易语言正则表达式大全易语言中的正则表达式与其他语言的正则表达式语法基本一致,支持常见的正则表达式操作符和元字符,但易语言的正则表达式不支持一些高级特性,例如复杂的回溯、后向引用等。
以下是易语言中常用的正则表达式元字符和操作符:1. 元字符:- `.`: 匹配除换行符以外的任意字符。
- `\d`: 匹配一个数字字符。
- `\D`: 匹配一个非数字字符。
- `\w`: 匹配一个字母、数字或下划线字符。
- `\W`: 匹配一个非字母、数字或下划线字符。
- `\s`: 匹配一个空白字符,包括空格、制表符、换行符等。
- `\S`: 匹配一个非空白字符。
- `[]`: 匹配方括号中的任意一个字符。
- `[^]`: 匹配不在方括号中的任意一个字符。
- `^`: 匹配输入的开始位置。
- `$`: 匹配输入的结束位置。
- `*`: 匹配前面的表达式零次或多次。
- `+`: 匹配前面的表达式一次或多次。
- `?`: 匹配前面的表达式零次或一次。
- `{n}`: 匹配前面的表达式恰好n次。
- `{n,}`: 匹配前面的表达式至少n次。
- `{n,m}`: 匹配前面的表达式至少n次,但不超过m次。
- `|`: 匹配两个或多个表达式之一。
2. 操作符:- `(` 和 `)`: 标记一个子表达式的开始和结束。
- `*?`、`+?`、`??`、`{n,m}?`等:匹配前面的表达式的最小次数。
- `(?i)`、`(?s)`、`(?m)` 等:修改正则表达式的匹配模式。
例子:1. 匹配一个以数字开头、大小写字母结尾的字符串:```^\d\w*[a-zA-Z]$```2. 匹配一个由数字和逗号组成的字符串:```^\d+(,\d+)*$```3. 匹配一个包含邮箱地址的字符串:```\w+@\w+\.\w+```以上只是一些简单的易语言正则表达式示例,更复杂的正则表达式可以通过组合和嵌套来实现。
在实际使用时,可以参考具体的正则表达式教程和文档,如易语言官方文档或其他相关资源。