
编译原理第八章作业
四元式序列 (1) (+ , a , b, (2) (@ , t1 , ~ , (3) (+ , c , d , (4) (* , t2 , t3 , (5) (+ , a , b , (6) (+ , t5 , c , (7) (- , t4 , t6 , 作业中的问题: 作业中的问题:
t 1) t 2) t 3) t 4) t 5) t 6) t 7)
;
- E d a +
E + b c
问题: 、 的四元式不能省, 问题:1、第2个a+b的四元式不能省,删除时代码优化所作的 个 的四元式不能省 工作; 工作; 2、三元式内引用的序号和三元是式前面的序号不一致。 、三元式内引用的序号和三元是式前面的序号不一致。
第8章 中间代码生成 章
1、给出下面表达式的逆波兰式(后缀式) 、给出下面表达式的逆波兰式(后缀式) (1)、a * (−b + c ) (2)、¬A ∨ ¬(C ∨ ¬D) (3)、a + b * (c + d / e)
ab @ c + *
A¬CD¬ ∨ ¬ ∨
abcde / + * +
问题: 、 问题:1、最好别随便调换两个操作数的先后顺序 2、逆波兰式已经定义了运算的先后顺序, 、逆波兰式已经定义了运算的先后顺序, 不需要再加(),()不允许出现在逆波兰式里。 (),()不允许出现在逆波兰式里 不需要再加(),()不允许出现在逆波兰式里。
1、没有生成序号;为了和-(减号)区别,负号用 、没有生成序号;为了和 (减号)区别,负号用@ 2、生成顺序的问题:必须按语法成分的实际处理顺序 、生成顺序的问题: 生成 3、中间代码生成之后,再进行优化,所以 不能省略 、中间代码生成之后,再进行优化,所以(5)不能省略
练习: 练习: 将while A>B do if C<D then X:=Y+Z else X:=Y*Z 转化成四元式序列;假设当前的 转化成四元式序列;假设当前的nextstat=100
第2题 请将表达式 题 请将表达式-(a+b)*(c+d)-(a+b+c)分别表示成三 分别表示成三 元式和四元式序列 E
三元式序列 (1) ( + , a , (2) ( @ , (1) , (3) ( + , c , (4) ( * , (2) , (5) ( + , a , (6) ( + , (5) , (7) ( - , (4) , b ) ~ ) d ) (3) ) b ) c ) (6) )
编译原理简明教程(第2版)第8章
④ 若NODE(A)=null,则把A附加到结点n,并令NODE(A)= n;否则,先 从NODE(A)的附加标记集中将A删去(注意,若NODE(A)有前驱或 NODE(A)是叶结点,则不能将A删去),然后再把A附加到新的结点n, 并令NODE(A)= n。
例:构造以下基本块的DAG
(1) (:=, 3.14, _, T1) (2) (*, 2, T1, T2) (3) (+, R, r, T3) (4) (*, T2, T3, A) (5) (:=, A, _, B) (6) (*, 2, T1, T4) (7) (+, R, r, T5) (8) (*, T4, T5, T6) (9) (-, R, r, T7) (10) (*, T5, T7, B)
8.1.3
优化技术简介
Байду номын сангаас
1、合并常量运算
运算对象是常量或在编译时已知,则在编译时直接计算 出结果,不必等到运行时再去计算。
例: x := 3.14 * 2 ; y := 2 * 5 * a ; z := x + 0.5 ;
合并常量元算后: x := 6.28; y := 10 * a ; z := 6.78 ;
优化可在编译的不同阶段进行:
源代码设计阶段 ------
程序员选择好的算法和语句
语义分析阶段
------ 如何生成高质量的中间代码
中间代码 ------ 采用优化技术
目标代码
------ 有效利用寄存器、指令、处理机
8.1.2
代码优化的分类
1、与机器的相关性 与机器有关的优化:寄存器的优化、多处理机的 优化、特殊指令的优化、无 只有一个 用代码的消除。 入口和一 与机器无关的优化:基本块的优化、循环优化。 个出口 2、优化范围 局部优化:基本程序块上进行的优化 全局优化:全局程序范围内的优化
编译原理第8章作业及习题参考答案

第八章 语法制导翻译和中间代码生成1.给出下面表达式的逆波兰表示(后缀式): (1) a*(-b+c)(4) (A ∧B) ∨(⌝C ∨ D)(7) if(x+y)*z=0 then s ∶=(a+b)*c else s ∶=a*b*c解(1) ab-c+*(4) AB ∧C ⌝D ∨∨(7) xy+z*0=sab+c*:=sab*c*:=¥(注:¥表示if-then-else 运算)2. 请将表达式-(a+b)*(c+d)-(a+b+c)分别表示成三元式、间接三元式和四元式序列。
答案:三元式(1) (+ a, b) (2) (+ c, d)(3) (* (1), (2)) (4) (- (3), /) (5) (+ a, b)(6) (+,(5),c) (7) (- (4), (6)) 间接三元式间接三元式序列 间接码表 (1) (+ a, b) (1) (2) (+ c, d) (2) (3) (* (1), (2)) (3) (4) (- (3), /) (4)¥= :=*:=+ xyzs +cxa bs* c*a b(5) (- (4), (1)) (1)(6) (- (4), (5)) (5)(6)四元式(1) (+, a, b, t1) (2) (+, c, d, t2) (3) (*, t1, t2, t3) (4) (-, t3, /, t4)(5) (+, a, b, t5) (6) (+, t5, c, t6) (6) (-, t4, t6, t7)3. 采用语法制导翻译思想,表达式E 的"值"的描述如下: 产生式 语义动作(0) S ′→E {print E.VAL}(1) E →E1+E2 {E.VAL ∶=E1.VAL+E2.VAL} (2) E →E1*E2 {E.VAL ∶=E1.VAL*E2.VAL} (3) E →(E1) {E.VAL ∶=E1.VAL} (4) E →n {E.VAL ∶=n.LEXVAL}如果采用LR 分析法,给出表达式(5 * 4 + 8) * 2的语法树并在各结点注明语义值VAL 。
第八章课后作业答案

emit(‘j’relop.op‘,’id 1.place‘,’id 2.place‘,’‘0’);
emit(‘j,-,-,0’) }
E→E1 and M E2
{ backpatch(E1.truelist, M.quad);
E.truelist:=E2.truelist;
E.falselist:=merge(E1.falselist,E2.falselist) }
M→{ M.quad:=nextquad }
if语句
Sif E then M S1
{backpatch(E.truelist, M.quad)
S.nextlist:=merge(E.falselist, S1.nextlist)}
a := a + b – 1
用到的翻译模式如下:
布尔表达式
E→id1 relop id2 { E.truelist:=makelist(nextquad);
E.falselist:=makelist(nextquad+1);
emit(‘j’relop.op‘,’id 1.place‘,’id 2.place‘,’‘0’);
emit(p‘:=’E.place)
else error }
E→E1opE2 { E.place:=newtemp;
emit(E.place‘:=’E1.place‘op’E2.place)}
101
j,_,_,111
102
j=,b,100, 104
103
j,_,_,100
104
J<,a,20,106
M→{ M.quad:=nextquad }
编译原理,清华大学,第2版_第8章 语法制导翻译和中间代码生成

将if-then-else看作一个完整的操作符,则e、x和 y 分别是三个操作数,这显然是一个三元运算。根据后缀式 的特点,它的后缀式可以写为:
exy if-then-else(记为: exy¥) 但是,这样的表示有个弱点。按照算法的计算次序,e、 x和y均需计算,而实际上,根据条件e的取值,计算x则不 计算y,计算y则不计算x。
一、逆波兰表示 典型特征是操作数在前,操作符紧跟其后。 特点:由于操作符紧跟操作数之后,因此只要知道操作 符有几个操作数,每一步的运算就可以确定。
1、 表达式的表示:
例:a+b 例:-a+b*c 例: (a+b)*c ab+ a@bc*+ ab+c* <左部><表达式的逆波兰式> ::=
2、 赋值语句的逆波兰表示:
E → E1 + E2
E → E1 * E2 E → (E1) E → num
E.val := E1.val + E2.val;
val[top] := val[top]+val[top+2];
E.val := E1.val * E2.val; E.val := E1.val; E.val := num.lexval;
第八章 语法制导翻译和中间代码生成
• 教学要求:本章介绍编译程序的第三个阶段语 义分析及中间代码生成的设计原理和实现方法,
要求理解语法制导翻译、语义动作的基本概念;
掌握语义规则和中间代码的表示形式。 • 教学重点:语义规则,中间代码的表示形式, 自下而上分析制导翻译概述。
语义处理功能: • 1、静态语义审查:验证语法结构合理 的程序是否真正有意义。 • 2、解释执行动态语义、生成代码:执 行真正的翻译(生成中间代码或目标代 码)。
编译原理清华大学出版社第8章习题重点题解答
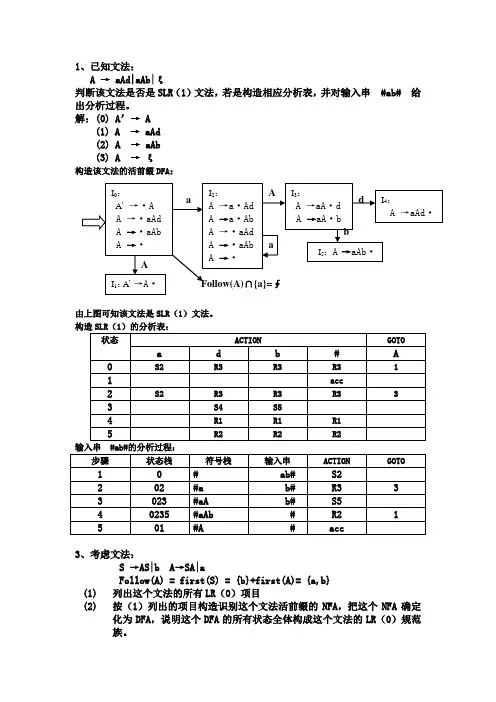
1、已知文法:A → aAd|aAb|ξ判断该文法是否是SLR(1)文法,若是构造相应分析表,并对输入串 #ab# 给出分析过程。
解:(0) A’→ A(1)A → aAd(2) A → aAb(3) A →ξ构造该文法的活前缀DFA:由上图可知该文法是SLR(1)文法。
构造SLR(1)的分析表:3、考虑文法:S →AS|b A→SA|aFollow(A) = first(S) = {b}+first(A)= {a,b}(1)列出这个文法的所有LR(0)项目(2)按(1)列出的项目构造识别这个文法活前缀的NFA,把这个NFA确定化为DFA,说明这个DFA的所有状态全体构成这个文法的LR(0)规范族。
(3)这个文法是SLR的吗?若是,构造出它的SLR分析表。
(4)这个文法是LALR或LR(1)的吗?解:(0)S’→S (1)S→AS (2)S→b (3)A→SA (4)A→a(1)列出所有LR(0)项目:S’→·S S→·b A→·a S’→ S· S→b· A→a·S →·AS A→·SAS →A·S A→S·AS →AS· A→SA·(3)构造该文法的活前缀NFA:由上可知:I1 I3 I5 中存在着移进和归约冲突在I1中含项目:S’→ S·归约项 Follow(S’)={#}A →·a 移进项 Follow(S’)∩{a}=∮S →·b 移进项 Follow(S’)∩{b}=∮在I3中含项目:A →SA·归约项 Follow(A)={a,b}S →·b 移进项 Follow(A) ∩ {b}≠∮A →·a 移进项 Follow(A) ∩ {a}≠∮在I5中含项目:S →AS·归约项 Follow(S)={#,a,b}A →·a 移进项 Follow(S) ∩ {a}≠∮S →·b 移进项 Follow(S) ∩ {b }≠∮由此可知,I3、I5的移进与归约冲突不能解决,所以这个文法不是SLR (1)文法。
胡元义版编译原理课后习题答案
则文法G[S′]的LR(0)项目集示范族为 I0:S′→·S I4:S→a· I10:L→S;·L I5 : S→while e· do s I6 : S→begin L·end I7 : L→S· S→·while e do S L→·S S→·begin L end L→·S;L S→·a S→·while e do S
所有外层分程序的符号表都无法找到此标识符,则表
明程序中使用了一个未经说明 ( 定义 )的标识符,此时 可按语法错误予以处理。
8.4 对下列程序,当编译程序编译到箭头所指位 置时,画出其层次表(分程序索引表)和符号表: program stack(output); var m, n:integer; r:real;
w h ile L S ; I4 I7 a s I1 0 I6 b eg in en d I9 w h ile L I1 2 a
图8-2 习题8.5中文法G[S′]的DFA
在 LR(0) 项 目 集 规 范 族 中 , 只 有 I7 含 有 “ 移 进”/“归约”冲突,且该冲突可用SLR(1)方法解决。
图8-1 分程序索引表和符号表示意图
8.5 已知文法G[S]: S→while (e) S S→{L}
S→a
L→S;L L→S
/*a代表赋值句*/
构造该文法的LR型的错误校正分析程序。
【解答】 首先将文法G[S]拓广为G[S′]:(0) S′→S (1) S→while e do S
(2) S→begin L end
号的处理,这就需要用到语法符号的相关属性。为了在需
要时能找到这些语法成分及其相关属性,就必须使用一些 表格来保存这些语法成分及其属性,这些表格就是符号表。
编译原理练习题及答案
第一章练习题(绪论)一、选择题1.编译程序是一种常用的软件。
A) 应用B) 系统C) 实时系统D) 分布式系统2.编译程序生成的目标代码程序是可执行程序。
A) 一定B) 不一定3.编译程序的大多数时间是花在上。
A) 词法分析B) 语法分析C) 出错处理D) 表格管理4.将编译程序分成若干“遍”将。
A)提高编译程序的执行效率;B)使编译程序的结构更加清晰,提高目标程序质量;C)充分利用内存空间,提高机器的执行效率。
5.编译程序各个阶段都涉及到的工作有。
A) 词法分析B) 语法分析C) 语义分析D) 表格管理6.词法分析的主要功能是。
A) 识别字符串B) 识别语句C) 识别单词D) 识别标识符7.若某程序设计语言允许标识符先使用后说明,则其编译程序就必须。
A) 多遍扫描B) 一遍扫描8.编译方式与解释方式的根本区别在于。
A) 执行速度的快慢B) 是否生成目标代码C) 是否语义分析9.多遍编译与一遍编译的主要区别在于。
A)多遍编译是编译的五大部分重复多遍执行,而一遍编译是五大部分只执行一遍;B)一遍编译是对源程序分析一遍就立即执行,而多遍编译是对源程序重复多遍分析再执行;C)多遍编译要生成目标代码才执行,而一遍编译不生成目标代码直接分析执行;D)多遍编译是五大部分依次独立完成,一遍编译是五大部分交叉调用执行完成。
10.编译程序分成“前端”和“后端”的好处是A)便于移植B)便于功能的扩充C)便于减少工作量D)以上均正确第二章练习题(文法与语言)一、选择题1.文法 G 产生的 (1) 的全体是该文法描述的语言。
A.句型B. 终结符集C. 非终结符集D. 句子2.若文法 G 定义的语言是无限集,则文法必然是 (2) A递归的 B 上下文无关的 C 二义性的 D 无二义性的3. Chomsky 定义的四种形式语言文法中, 0 型文法又称为(A)文法;1 型文法又称为(C)文法;2 型语言可由(G) 识别。
A 短语结构文法B 上下文无关文法C 上下文有关文法D 正规文法E 图灵机F 有限自动机G 下推自动机4.一个文法所描述的语言是(A);描述一个语言的文法是(B)。
编译原理编译第八章
一. 状态转换图的定义
有限的有向图 有向边上标记字符
x
2
唯一初态
1
若干终态(至少一个)
y
3
精选ppt
二. 状态转换图识别的串
从初态出发到某一终态路径上字符的连 接。下图是识别标识符的状态转换图:
字母或数字
字母
0
1 其它字符
* 2
精选ppt
第四节 词法分析器的设计
一. 单词符号
第四章设计的语言允许下述单词: 标识符、数字串、begin、end、integer、if、 then、else、function、read、write、
精选ppt
(9)buildlist:将token中的标识符存入符号表,并 将其在符号表中的位置填入val (10)dtb:将token中的数字串转换成二进制,并 存入常数表,位置填入val (11)val:存放标识符在符号表中的位置,或常数 在常数表中的位置 (12)return(c,val):返回二元式 (13)error:出错处理
<=
<>
类别编码
9 10 11 12 13 14
15
16
精选ppt
助记符
$FUNCTION $READ $WRITE $SUB $MUL $LT
$LE
$NE
单词符号
= > >= := ; (
)
类别编码
17 18 19 20 21 22 23
精选ppt
助记符
$EQ $GT $GE $ASSIGN $SEM $LPAR $RPAR
‘ : ‘: begin getchar; if character = ‘ = ‘ then return($ASSIGN,—) else error
编译原理(龙书)习题(5,6,7,8)章剖析.
第8章 代码生成
8.2.1 假设所有的变量都存放在内存中,为下 面的三地址语句生成代码: 1) x = 1 LD R1 , 1 ST x , R1
3) x = a + 1 LD R1 , a ADD R1 , R1 , 1
8.2.2 假设a和b是元素为4字节值的数组,为下面的三地址语 句序列生成代码。
| 1D1 {D.val 1 2D1.b D1.val; D.b D1.b 1}
| {D.val 0;
D.b 0}
第6章 中间代码生成
6.1.1 为下面的表达式构造DAG ((x+y)-((x+y)*(x-y)))+((x+y)*(x-y))
6.2.1 将算术表达式 a+-(b+c) 翻译成
第7章 运行时环境
7.2.3 图7-9中是递归计算Fiabonacci数列的C语言代码。假设f 的活动记录按顺序包含下列元素:(返回值,参数n,局 部变量s,局部变量t)。通常在活动记录中还会有其他元 素。下面的问题假设初始调用是f(5)。
int f(int n) { int t,s; if (n<2) return 1; s = f(n-1); t = f(n-2); return s+t;
} 图7-9
活动树
5 f(1) 1 f(1)
第
第
个
个
调
调
用
用
即
即
将
将
返
返
回
回
7.2.5 在一个通过引用传递参数的语言中,有 一个函数f(x,y)完成下面的计算: x = x + 1; y = y + 2; return x + y; 如果将a赋值为3,然后调用f(a,a),那么返回 值是什么?
编译原理第17讲(第八章)
01
02
数据结构优化
选择合适的数据结构来存储和操作数 据,以减少内存占用和提高数据访问 速度。
03
循环优化
通过对循环进行展开、合并、重排等 操作,减少循环次数和提高循环效率 。
05
04
函数优化
通过对函数进行内联、外联、合并等 操作,减少函数调用开销和提高函数 执行效率。
程序性能提升的策略
优化内存管理
全局优化
针对整个程序的优化,包括函数 内联、循环展开、公共子表达式 消除等。
机器相关优化
针对特定机器指令集和硬件特性 进行的优化,如指令调度、寄存 器分配等。
常用的优化技术
无用代码删除
删除程序中不会被执行到的代 码,以及不会对程序结果产生 影响的代码。
循环展开
将循环体中的代码复制多次, 从而减少循环次数和循环控制 的开销,提高程序执行效率。
语法分析
编译器首先对源程序进行语法分析,生成 语法树(Syntax Tree)。
目标代码生成
编译器将优化后的中间代码转换成目标代 码,生成与特定计算机体系结构相关的机 器指令序列。
语义分析
编译器对语法树进行语义分析,检查源程 序的语义正确性,并进行类型检查、符号 表管理等。
优化
编译器对中间代码进行优化,提高目标代 码的执行效率。
01
目标代码(Object Code)是指编译器将源程序翻译成机器语 言后生成的代码,它是计算机能够直接执行的指令序列。
02
目标代码通常与特定的计算机体系结构相关,不同的计算机体
系结构需要不同的目标代码。
目标代码通常以二进制格式存储,可以被链接器(Linker)链
03
接成可执行文件。