
SQL:in和exists的区别效率问题
in和exists
in是把外表和内表作hash连接,而exists是对外表作loop循环,每次loop循环再对内表进行查询。
一直以来认为exists比in效率高的说法是不准确的。
如果查询的两个表大小相当,那么用in和exists差别不大。
如果两个表中一个较小,一个是大表,则子查询表大的用exists,子查询表小的用in:
例如:表A(小表),表B(大表)
1:
select*from A where cc in(select cc from B)
效率低,用到了A表上cc列的索引;
select*from A where exists(select cc from B where cc=)
效率高,用到了B表上cc列的索引。
相反的
2:
select*from B where cc in(select cc from A)
效率高,用到了B表上cc列的索引;
select*from B where exists(select cc from A where cc=)
效率低,用到了A表上cc列的索引。
not in和not exists
如果查询语句使用了not in那么内外表都进行全表扫描,没有用到索引;
而not extsts的子查询依然能用到表上的索引。
所以无论那个表大,用not exists都比not in要快。
ORACLE中IN和EXISTS的区别
ORACLE中IN和EXIST S的区别EXI STS的执行流程s elect * fr om t1 wher e exi sts ( sele ct nu ll fr om t2 wher e y = x )可以理解为:f or xin (selec t * f rom t1 ) loop if( exi sts ( sele ct nu ll fr om t2 wher e y = x.x) th en OUTP UT TH E REC ORDend i fe nd lo op对于in 和exist s的性能区别:如果子查询得出的结果集记录较少,主查询中的表较大且又有索引时应该用in,反之如果外层的主查询记录较少,子查询中的表大,又有索引时使用exis ts。
其实我们区分in和exist s主要是造成了驱动顺序的改变(这是性能变化的关键),如果是e xists,那么以外层表为驱动表,先被访问,如果是IN,那么先执行子查询,所以我们会以驱动表的快速返回为目标,那么就会考虑到索引及结果集的关系了另外IN时不对NULL进行处理如:se lect1 fro m dua l whe re nu ll i n (0,1,2,n ull)为空2.NOTIN 与N OT EX ISTS:NOTEXIST S的执行流程sel ect .....fro m rol lup Rwher e not exis ts (selec t 'Fo und'fromtitle T wher e R.s ource_id = T.Ti tle_I D);可以理解为:forx in( sel ect * from roll up ) loop if ( notexist s ( t hat q uery) ) t henOUTPU T end if; end;注意:NOT E XISTS与 NO T IN不能完全互相替换,看具体的需求。
T-SQL经验总结
T-SQL经验总结在庞⼤的业务系统背后,⼀定有数据库管理系统的⽀持。
在现代以数据为中⼼的开发时代,SQL编程也显得尤为重要。
下⾯总结下我最近SQL编程的⼀些经验:1.SELECT查询要列出所有要查询的字段2.注意UNION和UNION ALL的区别,在IN,OR,UNION ALL这三种⽅案中,UNION ALL的执⾏效率是最⾼的。
3.视图定义要尽量简单,最好不要包含业务逻辑。
⽐如:在业务系统中,单据会有多种状态,那么在系统与系统交互的过程中,可能两边的状态码定义的不同,那么就需要映射。
在这种场景下,强烈建议这种映射不要放在视图定义或SQL查询中,因为这会降低查询的性能。
4.表变量与临时表的选择。
表变量会将数据存储在数据库服务的内存中,临时表会将数据存储在数据库服务器的磁盘上,会产⽣I/O,因此临时表消耗资料要多些,性能显⽰要差些。
⼀般来说,建议采⽤表变量。
如果数据量⼤(选取的字段多,有⼤字段,数据条⽬超过10W),⼜要连续使⽤多次的,建议⽤临时表。
5.在表变量上设计主键是有百益⽽⽆⼀害的,临时表上更应该设计主键了。
设计主键主要是让数据有序存储,提⾼查询性能。
6.要把握INNER JOIN和LEFT/RIGHT JOIN的区别。
选择好了可以使SQL很简洁⾼效。
7.EXISTS的效率⽐IN要好⼗倍的样⼦。
下⾯三个版本的效果,V1<V2<V3。
代码--V1DELETE FROM dbo.MasterWHERE TransactionNumber IN(SELECT OriginalTransactionNumber FROM dbo.MasterHistory WITH(NOLOCK))--V2DELETE FROM dbo.MasterWHERE EXISTS(SELECT1FROM dbo.MasterHistory b WITH(NOLOCK)WHERE b.OriginalTransactionNumber=TransactionNumber)--V3DELETE aFROM dbo.Master aINNER JOIN dbo.MasterHistory b WITH(NOLOCK)ON a.TransactionNumber=b.OriginalTransactionNumber8.WHERE筛选⼦句要以选择性⾼的放在前⾯,选择性低或没有选择性的放在后⾯。
SQL语句中exists和in的区别

SQL语句中exists和in的区别转⾃https:///liyasong/p/sql_in_exists.html 和 /lick4050312/article/details/4476333表展⽰ 查询中涉及到的两个表,⼀个user和⼀个order表,具体表的内容如下: user表: order表:in ⼀、确定给定的值是否与⼦查询或列表中的值相匹配。
in在查询的时候,⾸先查询⼦查询的表,然后将内表和外表做⼀个笛卡尔积,然后按照条件进⾏筛选。
所以相对内表⽐较⼩的时候,in的速度较快。
具体sql语句如下:1 SELECT2 *3 FROM4 `user`5 WHERE6 `user`.id IN (7 SELECT8 `order`.user_id9 FROM10 `order`11 ) 这条语句很简单,通过⼦查询查到的user_id 的数据,去匹配user表中的id然后得到结果。
该语句执⾏结果如下: 它的执⾏流程是什么样⼦的呢?让我们⼀起来看⼀下。
⾸先,在数据库内部,查询⼦查询,执⾏如下代码:SELECT`order`.user_idFROM`order` 执⾏完毕后,得到结果如下: 此时,将查询到的结果和原有的user表做⼀个笛卡尔积,结果如下: 此时,再根据我们的user.id IN er_id的条件,将结果进⾏筛选(既⽐较id列和user_id 列的值是否相等,将不相等的删除)。
最后,得到两条符合条件的数据。
⼆、select * from A where id in(select id from B)以上查询使⽤了in语句,in()只执⾏⼀次,它查出B表中的所有id字段并缓存起来.之后,检查A表的id是否与B表中的id相等,如果相等则将A表的记录加⼊结果集中,直到遍历完A表的所有记录. 它的查询过程类似于以下过程List resultSet=[]; Array A=(select * from A); Array B=(select id from B);for(int i=0;i<A.length;i++) { for(int j=0;j<B.length;j++) { if(A[i].id==B[j].id) { resultSet.add(A[i]); break; } } } return resultSet;可以看出,当B表数据较⼤时不适合使⽤in(),因为它会B表数据全部遍历⼀次. 如:A表有10000条记录,B表有1000000条记录,那么最多有可能遍历10000*1000000次,效率很差. 再如:A表有10000条记录,B表有100条记录,那么最多有可能遍历10000*100次,遍历次数⼤⼤减少,效率⼤⼤提升.结论:in()适合B表⽐A表数据⼩的情况exists ⼀、指定⼀个⼦查询,检测⾏的存在。
in和exists的区别与SQL执行效率分析

in和exists的区别与SQL执行效率分析本文对in和exists的区别与SQL执行效率进行了全面整理分析……最近很多论坛又开始讨论in和exists的区别与SQL执行效率的问题,本文特整理一些in和exists的区别与SQL执行效率分析SQL中in可以分为三类:1、形如select * from t1 where f1 in ('a','b'),应该和以下两种比较效率select * from t1 where f1='a' or f1='b'或者select * from t1 where f1 ='a' union all select * from t1 f1='b'你可能指的不是这一类,这里不做讨论。
2、形如select * from t1 where f1 in (select f1 from t2 where t2.fx='x'),其中子查询的where里的条件不受外层查询的影响,这类查询一般情况下,自动优化会转成exist语句,也就是效率和exist一样。
3、形如select * from t1 where f1 in (select f1 from t2 where t2.fx=t1.fx),其中子查询的where里的条件受外层查询的影响,这类查询的效率要看相关条件涉及的字段的索引情况和数据量多少,一般认为效率不如exists。
除了第一类in语句都是可以转化成exists 语句的SQL,一般编程习惯应该是用exists而不用in,而很少去考虑in和exists的执行效率.in和exists的SQL执行效率分析A,B两个表,(1)当只显示一个表的数据如A,关系条件只一个如ID时,使用IN更快:select * from A where id in (select id from B)(2)当只显示一个表的数据如A,关系条件不只一个如ID,col1时,使用IN就不方便了,可以使用EXISTS:select * from Awhere exists (select 1 from B where id = A.id and col1 = A.col1)(3)当只显示两个表的数据时,使用IN,EXISTS都不合适,要使用连接:select * from A left join B on id = A.id所以使用何种方式,要根据要求来定。
SQL中EXISTS的用法
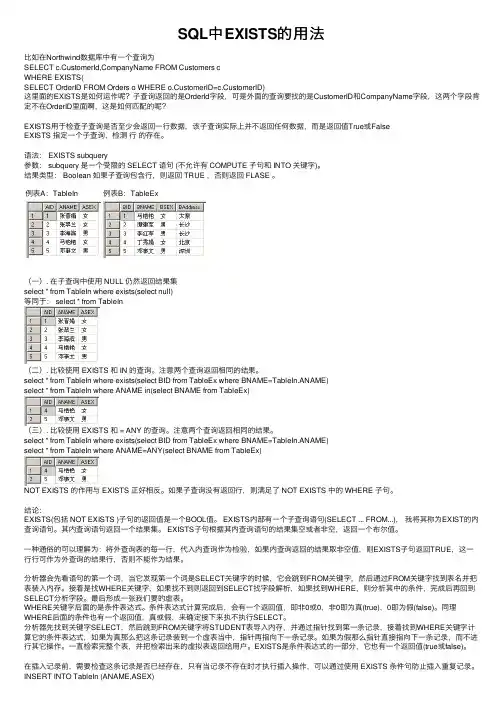
SQL中EXISTS的⽤法⽐如在Northwind数据库中有⼀个查询为SELECT c.CustomerId,CompanyName FROM Customers cWHERE EXISTS(SELECT OrderID FROM Orders o WHERE o.CustomerID=c.CustomerID)这⾥⾯的EXISTS是如何运作呢?⼦查询返回的是OrderId字段,可是外⾯的查询要找的是CustomerID和CompanyName字段,这两个字段肯定不在OrderID⾥⾯啊,这是如何匹配的呢?EXISTS⽤于检查⼦查询是否⾄少会返回⼀⾏数据,该⼦查询实际上并不返回任何数据,⽽是返回值True或FalseEXISTS 指定⼀个⼦查询,检测⾏的存在。
语法: EXISTS subquery参数: subquery 是⼀个受限的 SELECT 语句 (不允许有 COMPUTE ⼦句和 INTO 关键字)。
结果类型: Boolean 如果⼦查询包含⾏,则返回 TRUE ,否则返回 FLASE 。
例表A:TableIn例表B:TableEx(⼀). 在⼦查询中使⽤ NULL 仍然返回结果集select * from TableIn where exists(select null)等同于: select * from TableIn(⼆). ⽐较使⽤ EXISTS 和 IN 的查询。
注意两个查询返回相同的结果。
select * from TableIn where exists(select BID from TableEx where BNAME=TableIn.ANAME)select * from TableIn where ANAME in(select BNAME from TableEx)(三). ⽐较使⽤ EXISTS 和 = ANY 的查询。
注意两个查询返回相同的结果。
select * from TableIn where exists(select BID from TableEx where BNAME=TableIn.ANAME)select * from TableIn where ANAME=ANY(select BNAME from TableEx)NOT EXISTS 的作⽤与 EXISTS 正好相反。
Oracle中in与exist,not in与not exist的性能问题
上星期五与haier讨论in跟exists的性能问题,正好想起原来公司的一个关于not in的规定,本想做个实验证明我的观点是正确的,但多次实验结果却给了我一个比较大的教训。
我又咨询了下oracle公司工作的朋友,确实是我持有的观点太保守了。
于是写个文章总结下,希望对大家有所启发。
后面可能有大篇是关于10053 trace的内容,只作实验证明,可直接忽略看最终的结论即可。
我们知道,in 是把外表和内表作hash 连接,而exists是对外表作loop循环,每次loop循环再对内表进行查询。
一直以来认为exists比in效率高的说法是不准确的。
如果查询的两个表大小相当,那么用in和exists是差别不大的。
但如果两个表中一个较小,一个是大表,则子查询表大的用exists,子查询表小的用in,效率才是最高的。
假定表A(小表),表B(大表),cc列上都有索引:•select * from A where cc in(select ccfrom B); --效率低,用到了A表上cc列的索引•select * from A where exists(select cc from B where cc=A.cc); --效率高,用到了B 表上cc列的索引。
相反的:•select * from B where cc in (select cc from A); --效率高,用到了B表上cc列的索引•select * from B where exists(select ccfromA where cc=); --效率低,用到了A表上cc列的索引通过使用exists,Oracle会首先检查主查询,然后运行子查询直到它找到第一个匹配项,这就节省了时间。
Oracle在执行IN子查询时,首先执行子查询,并将获得的结果列表存放在一个加了索引的临时表中。
在执行子查询之前,系统先将主查询挂起,待子查询执行完毕,存放在临时表中以后再执行主查询。
MySQL中in与exists的使用及区别介绍
MySQL中in与exists的使⽤及区别介绍先放⼀段代码for(int i=0;i<1000;i++){for(int j=0;j<5;j++){System.out.println("hello");}}for(int i=0;i<5;i++){for(int j=0;j<1000;j++){System.out.println("hello");}}分析以上代码可以看到两⾏代码除了循环的次序不⼀致意外,其他并⽆区别,在实际执⾏时两者所消耗的时间和空间应该也是⼀致的。
但是这仅仅是在Java中,现在我们转化⼀下情景,最外层循环是数据库中的连接操作,内层循环为查找操作,那么现在两次的结果将相差巨⼤。
之所以出现这样的原因是数据库的特点决定的,数据库中相⽐较于查询操作⽽⾔,建⽴连接是更消耗资源的。
第⼀段代码建⽴了1000次连接,每⼀次连接却只做了5次查询,显然是很浪费的。
因此在我们对数据库进⾏操作时需要遵循的操作应当是⼩表驱动⼤表(⼩的数据集驱动⼤的数据集)。
in与exists表结构tbl_emp为员⼯表,deptld为部门id。
tbl_dept为部门表。
员⼯表中含有客⼈,其deptld字段为-1mysql> desc tbl_emp;+--------+-------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+--------+-------------+------+-----+---------+----------------+| id | int(11) | NO | PRI | NULL | auto_increment || name | varchar(20) | YES | | NULL | || deptld | int(11) | YES | MUL | NULL | |+--------+-------------+------+-----+---------+----------------+3 rows in set (0.00 sec)mysql> desc tbl_dept;+----------+-------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+----------+-------------+------+-----+---------+----------------+| id | int(11) | NO | PRI | NULL | auto_increment || deptName | varchar(30) | YES | MUL | NULL | || locAdd | varchar(40) | YES | | NULL | |+----------+-------------+------+-----+---------+----------------+3 rows in set (0.01 sec)我们知道对于⼀个公司⽽⾔相对于部门来说员⼯数要多得多。
SQL 里的 EXISTS与in、not exists与not in
SQL 里的EXISTS与in、not exists与not in2011-01-07 10:01:25| 分类:sql | 标签:|字号大中小订阅系统要求进行SQL优化,对效率比较低的SQL进行优化,使其运行效率更高,其中要求对SQL中的部分in/not in修改为exists/not exists修改方法如下:in的SQL语句SELECT id, category_id, htmlfile, title, convert(varchar(20),begintime,112) as pubtimeFROM tab_oa_pub WHERE is_check=1 andcategory_id in (select id from tab_oa_pub_cate where no='1')order by begintime desc修改为exists的SQL语句SELECT id, category_id, htmlfile, title, convert(varchar(20),begintime,112) as pubtimeFROM tab_oa_pub WHERE is_check=1 andexists (select id from tab_oa_pub_cate where tab_oa_pub.category_id=convert(int,no) and no='1') order by begintime desc分析一下exists真的就比in的效率高吗?我们先讨论IN和EXISTS。
select * from t1 where x in ( select y from t2 )事实上可以理解为:select *from t1, ( select distinct y from t2 ) t2where t1.x = t2.y;——如果你有一定的SQL优化经验,从这句很自然的可以想到t2绝对不能是个大表,因为需要对t2进行全表的“唯一排序”,如果t2很大这个排序的性能是不可忍受的。
informix exists与in效率测试记录
Exists与in的效率测试记录●目的:找出何种情况适用in还是exists条件为最优。
●环境描述:操作系统:linux数据库:IBM Informix Dynamic Server Version 10.00.UC3R1 表:Chen建表模式create table "informix".chen(a integer,b integer,c char(10)) extent size 16 next size 16 lock mode page;revoke all on "informix".chen from "public";create index "informix".chenona on "informix".chen (a) using btreein datadbs ;create index "informix".testf on "informix".chen ("informix".testfunction(b)) using btree in datadbs ;create table "informix".test(a integer,b integer,c integer) extent size 16 next size 16 lock mode page;revoke all on "informix".test from "public";create index testona on test(a);Sql语句:语句in:Select * from chen where a in (select a from test);语句exists :Select * from chen where exists (select a from test where test.a=chen.a);数据库为有日志缓存模式测试过程:A、外表比内表大只差别在数据量不同测试:1、小量数据Chen记录为10000Test 记录为1000结果输出:语句in:QUERY:------Select * from chen where a in (select a from test)Estimated Cost: 87Estimated # of Rows Returned: 10001) informix.chen: INDEX PATH(1) Index Keys: a (Serial, fragments: ALL)Lower Index Filter: informix.chen.a = ANY <subquery>Subquery:---------Estimated Cost: 38Estimated # of Rows Returned: 10001) informix.test: SEQUENTIAL SCAN语句existsQUERY:------Select * from chen where exists (select a from test where test.a=chen.a)Estimated Cost: 666Estimated # of Rows Returned: 10001) informix.test: INDEX PATH (Skip Duplicate)(1) Index Keys: a (Key-Only) (Serial, fragments: ALL)2) informix.chen: INDEX PATH(1) Index Keys: a (Serial, fragments: ALL)Lower Index Filter: informix.test.a = informix.chen.a NESTED LOOP JOIN因为记录量太少没必要做时间的测试。
SQLin与exists相关性能问题总结
SQLin与exists相关性能问题总结SQL in与exists相关性能问题总结in 和 existsin 和 exists的是DBA或开发⼈员⽇常⼯作学习中常⽤的基本运算符,今天我就这两个所带来的性能问题进⾏分析总结,⽅便⾃⼰与他⼈的后续学习与⼯作。
先来了解in 和 exists的性能区别: 如果主查询中的表较⼤且⼜有索引,⼦查询得出的结果集记录较少时,应该⽤in;反之如果外层的主查询记录较少,⼦查询中的表⼤,⼜有索引时使⽤exists。
举例说明: select * from A where A.ID in(select B.ID from B )select * from A where exists(select 1 from B where A.ID=B.ID) 其中,第⼀句in字句使⽤的是外层A表的索引,括号中的B全表扫描,所以,当A表巨⼤⽽B表很⼩的时候,此时性能较⾼,反之性能很差;第⼆句exists字句中使⽤的是内层B表的索引,外⾯A全表扫描,所以,当B表巨⼤⽽A表很⼩的时候,此时性能较⾼,反之性能很差。
区分in和exists主要是造成了驱动顺序的改变(这是性能变化的关键),如果是exists,那么以外层表为驱动表,先被访问,如果是in,那么先执⾏⼦查询,再以in为驱动表,去查找外层表中符合要求的记录,所以我们会以驱动表的快速返回为⽬标,那么就会考虑到索引及结果集的关系了。
a) in的执⾏顺序:1.⾸先执⾏⼀次⼦查询,⼦查询先产⽣结果集;2. 然后主查询再去结果集⾥去找符合要求的字段列表去.符合要求的输出,反之则不输出。
b) exists的执⾏顺序:1.⾸先执⾏⼀次外部查询;2.对于外部查询中的每⼀⾏分别执⾏⼀次⼦查询,⽽且每次执⾏⼦查询时都会引⽤外部查询中当前⾏的值;3.使⽤⼦查询的结果true或false来确定外部查询的结果集。
例如:表A(⼩表),表B(⼤表)select * from A where cc in(select cc from B)-->效率低,⽤到了A表上cc列的索引;select * from A where exists(select cc from B where cc=)-->效率⾼,⽤到了B表上cc列的索引。