
均匀分布U[0, 1] - 描述统计
概率论与数理统计浙大四版 第二章3讲2
PXGfxdx
G
例2 某电子元件的寿命 X(单位:小时)是以
f x 1000
x2
x 100 x 100
为密度函数的连续型随机变量.求 5 个同类型的元 件在使用的前 150 小时内恰有 2 个需要更换的概率.
1
x0
0x1 1x2
x2
即
0,
x0
F(x)
x2 , 2 2x 1 x2 ,
0 x 1 1 x 2
2
1,
x2
对连续型r.v,若已知F(x),我们通过求导 也可求出 f (x),请看下例.
例3 设r.vX的分布函数为
0, x 0
(1) 求X取值在区间
F(x) 没意义的点处,任意规定 F(x)的值.
由于连续型 r.v唯一被它的密度函数所确 定. 所以,若已知密度函数,该连续型 r.v 的概率规律就得到了全面描述.
f (x)
o
x
下面给出几个常用连续型r.v的例子.
(1)若 r.vX的概率密度为: f ( x)
f(x)b1a, axb
例2 设r.v X 的密度函数为 f (x)
f(x)2 1x2, 1x1
0, 其它
求 F(x).
解: F(x) = P(X x) =
x
f (t)dt
f(x)2 1x2, 1x1
0, 其它
解: 对x < -1,F(x) = 0
求 F(x).
对 1x1,
0, 其它
求 F(x).
均匀分布
a
b
01 0 1
于是,均匀分布的分布函数为:
0 ,
x a;
F
(x)
x
b
a a
,
a x b;
1
1,
x ba, b ) 的子区间的概率与位置无 关,与子区间长度成正比。
即对于( c, d) (a, b ) ,有
∪
d1
d c
P ( c X d )
(
2 )3 3
(1)0 3
20
33
3
27
x
F ( x ) f ( t ) d t
x a:
x
F ( x ) f ( t ) d t
0
a
x
a xb:
F (x)
f (t)dt f (t)dt
a
0 x 1 d t x a
a ba
ba
b x :
a
b
x
F (x) f (t)dt f (t)dt f (t)dt
解:X的概率密度函数
设Y表示3次观测中,观测值大于3的次数
f
(x)
1
3
,
0,
x (2, 5) x (2, 5)
设A={ X>3 }, 则
P(A) P( X 3)
1
5
dx
2
P(Y
则
2)
Y~ B(3, 2/3), 因而有
P(Y 2) P(Y 3)
C32
(
2 )2 3
( 1 )1 3
C33
1 ba
a
b
阴影部分面积为 1
f (x)
(1) f (x) 0
( 2 )
f ( x)dx 1
概率论与数理统计第6讲
d
d −c f ( x) d x = . b−a
2. 指数分布 定义: 定义:若随机变量 X 具有概率密度
λ e , x ≥ 0 , f ( x) = 0, x < 0.
− λx
(λ > 0)
的分布是参数为 的指数分布, 则称 X的分布是参数为λ的指数分布,记成 的分布是 X ~E(λ)。 。 指数分布常用于可靠性统计研究中, 指数分布常用于可靠性统计研究中,如 元件的寿命服从指数分布。 元件的寿命服从指数分布。
∫
于是
1= ∫
+∞
+∞
−∞
f ( x) d x = 1
2
故
−∞
f ( x) d x = c ∫
0
x x d x =c 3
2
3 2 0
8c = 3
3 c= . 8
(2) P ( −1 < X < 1) = ∫ f ( x) d x
−1
1
= ∫ 0 d x + ∫ cx 2 d x
−1dx= . 0 8 8
(2). 确定数据分组数 m (一般取为 ~15), 一般取为7~ ), 组距 d = (b − a) / m, , 子区间端点 ti = a + i d, i = 0, 1, · · · , m; ;
(3). 计算落入各子区间内观测值频数 ni =| { xj ∈ [ti−1, ti), j = 1, 2, · · · , n}|, , 频率 fi = ni / n, i = 1, 2, · · · , m; , ;
取值于(x 表示随机变量 X 取值于 , x +△ x]上的概率 上的概率 近似等于 f (x ) △x 。 f (x ) △x 在连续型随机变量中所起的作用与 pk=P{X=xk} 在离散型随机变量中所起的作用 类似。 类似。
《概率论与数理统计》第4-7 章自测题讲评
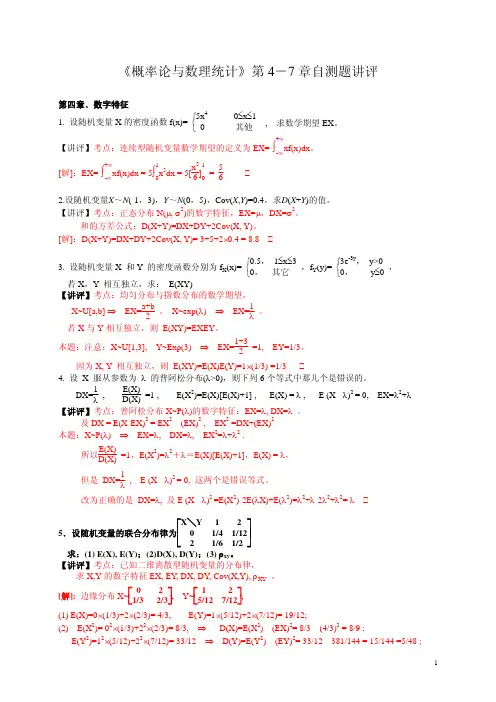
《概率论与数理统计》第4-7章自测题讲评第四章﹑数字特征1. 设随机变量X 的密度函数f(x)= ⎩⎨⎧5x 4 0≤x ≤10 其他 , 求数学期望EX 。
【讲评】考点:连续型随机变量数学期望的定义为EX= ∫-∞+∞xf(x)dx 。
[解]:EX= ∫-∞+∞xf(x)dx = 5∫01x 5dx = 5[x 56]01= 562.设随机变量X ~N (-1,3),Y ~N (0,5),Cov(X ,Y )=0.4,求D (X +Y )的值。
【讲评】考点:正态分布N(μ, σ2)的数字特征,EX=μ,DX=σ2。
和的方差公式:D(X+Y)=DX+DY+2Cov(X, Y)。
[解]:D(X+Y)=DX+DY+2Cov(X, Y)= 3+5+2×0.4 = 8.83. 设随机变量X 和Y 的密度函数分别为f X (x)= ⎩⎨⎧0.5, 1≤x ≤30, 其它 ,f Y (y)= ⎩⎨⎧3e -3y , y>00, y ≤0 ,若X ,Y 相互独立,求: E(XY)【讲评】考点:均匀分布与指数分布的数学期望,X~U[a,b] ⇒ EX=a+b 2 。
X~exp(λ) ⇒ EX=1λ 。
若X 与Y 相互独立,则 E(XY)=EXEY 。
本题:注意:X~U[1,3], Y~Exp(3) ⇒ EX=1+32 =1, EY=1/3,因为X, Y 相互独立,则 E(XY)=E(X)E(Y)=1×(1/3) =1/34. 设 X 服从参数为 λ 的普阿松分布(λ>0),则下列6个等式中那几个是错误的。
DX=1λ , E(X)D(X) =1 , E(X 2)=E(X)[E(X)+1] , E(X) = λ , E (X - λ)2 = 0, EX=λ2+λ【讲评】考点:普阿松分布X~P(λ)的数字特征:EX=λ, DX=λ 。
及DX = E(X-EX)2 = EX 2 – (EX)2 , EX 2 =DX+(EX)2本题:X~P(λ) ⇒ EX=λ, DX=λ, EX 2=λ+λ2 .所以E(X)D(X) =1,E(X 2)=λ2+λ=E(X)[E(X)+1],E(X) = λ,但是 DX=1λ , E (X - λ)2 = 0, 这两个是错误等式。
(1) 均匀分布

Show[fn1,fn3]
小
0.5 0.4
大 0.3 0.2 0.1
-6
几何意义 数据意义
-5 -4 -3 -2 -1
大小与曲线陡峭程度成反比 大小与数据分散程度成正比
正态变量的条件 若 r.v. X
① 受众多相互独立的随机因素影响
② 每一因素的影响都是微小的 ③ 且这些正、负影响可以叠加
在 x = ± 时, 曲线 y = f (x) 在对应的
点处有拐点 曲线 y = f (x) 以 x 轴为渐近线
曲线 y = f (x) 的图形呈单峰状
P(X ) F() 1 F() P(X )
1 2
0.3 0.25
0.2 0.15
0.1 0.05
-6 -5 -4 -3 -2 -1
x
(x) 1
x t2
e 2 d t x
2
其值有专门的表供查.
0.4 0.3 0.2 0.1
-3 -2 -1
123
(0) 0.5 (x) 1 (x)
P(| X | a) 2 (a) 1
(x) 1(x)
X
4)
4
2
2
2
2
(0)
0.3
2 0.8
P(X 0) 0.2
解二 图解法
0.2 0.15
0.1 0.05
0.3 0.2
-2
2
4
6
由图
P(X 0) 0.2
例 3 原理
设 X ~ N ( , 2), 求 P(| X | 3 )
中级质量专业技术人员职业资格模拟考试及答案(4)
中级质量专业技术人员职业资格模拟考试(4)一、单选[共40题,每题1分,总计40分]1.找出关于组距的正确描述()。
A.组距必定相等B.组距可以相等,也可以不相等C.组距不相等的情况用的比较多D.对应于数据最大及最小的一个或两个组,使用与其他组不相等的组距,这样的情况不可能存在2.以下不是用来描述样本分散程度的统计量的是()。
A.样本极差B.样本方差C.样本均值D.样本标准差3.某溶液中的乙醇浓度服从正态分布,从中抽取一个样本量为4的样本,求得X=8.5%样本标准差为S=0.04%。
分别求出正态均值μ与σ的95%的置信区间()。
A.[8.292,8.388] [0.017,0.112]B.[8.440,8.560] [0.017,0.112]C.[8.440,8.560] [0.182,0.123]D.[8.430,8.550] [0.182,0.112]4.设X1,X2,…,X25是从均匀分布U(0,5)抽取的一个样本,则∑==251251iiX X近似服从的分布是()。
A.N(5,1/12)B.N(5,1/10)C.N(2.5,1/12)D.N(2.5,1/10)5.有人研究了汽车速度与每升汽油行驶里程之间的关系,得到相关系数为0.27,但是他们发现速度表出了故障因而不太精确,每小时快了3公里,于是对速度表进行了修正,重新求得的相关系数是()。
A.0.35B.0.27C.0.30D.06.为提高某产品的产量,考虑三个三水平因子反应温度(A),反应压力(B),溶液浓度(C)。
当用正交表L9(34)安排实验,因子ABC依次放在123列上,并A.B,A,CB.C,A,BC.C,B,AD.A,B,C7.()检验是根据被检样本中的不合格产品数,推断整批产品的接收与否。
A.计件抽样B.计点抽样C.计数抽样D.计量抽样8.不属于接收概率的计算方法的有()。
A.超几何分布计算法B.几何分布计算法C.二项分布计算法D.泊松分布计算法9.检验水平反映了批量(N)与样品量(n)之间的关系,GB/T2828.1中,将一般检验分为()三个检验水平。
各种分布的随机数生成算法
各型分布随机数的产生算法随机序列主要用概率密度函数(PDF〃Probability Density Function)来描述。
一、均匀分布U(a,b)⎧1x∈[a,b]⎪ PDF为f(x)=⎨b−a⎪0〃其他⎩生成算法:x=a+(b−a)u〃式中u为[0,1]区间均匀分布的随机数(下同)。
二、指数分布e(β)x⎧1⎪exp(−x∈[0,∞)βPDF为f(x)=⎨β⎪0〃其他⎩生成算法:x=−βln(1−u)或x=−βln(u)。
由于(1−u)与u同为[0,1]均匀分布〃所以可用u 替换(1−u)。
下面凡涉及到(1−u)的地方均可用u替换。
三、瑞利分布R(µ)⎧xx2exp[−x≥0⎪回波振幅的PDF为f(x)=⎨µ2 2µ2⎪0〃其他⎩生成算法:x=−2µ2ln(1−u)。
四、韦布尔分布Weibull(α,β)xα⎧−αα−1⎪αβxexp[−(]x∈(0,∞)βPDF为f(x)=⎨⎪0〃其他⎩生成算法:x=β[−ln(1−u)]1/α五、高斯(正态)分布N(µ,σ2)⎧1(x−µ)2exp[−]x∈ℜ2PDF为f(x)=⎨2πσ 2σ⎪0〃其他⎩生成算法:1〄y=−2lnu1sin(2πu2)生成标准正态分布N(0,1)〃式中u1和u2是相互独立的[0,1]区间均匀分布的随机序列。
2〄x=µ+σy产生N(µ,σ2)分布随机序列。
六、对数正态分布Ln(µ,σ2)⎧1(lnx−µ)2exp[−x>0PDF为f(x)=⎨2πσx 2σ2⎪0〃其他⎩生成算法:1〄产生高斯随机序列y=N(µ,σ2)。
2〄由于y=g(x)=lnx〃所以x=g−1(y)=exp(y)。
七、斯威林(Swerling)分布7.1 SwerlingⅠ、Ⅱ型7.1.1 截面积起伏σ⎧1−exp[σ≥0⎪σ0截面积的PDF为f(σ)=⎨σ0〃【指数分布e(σ0)】⎪0〃其他⎩生成算法:σ=−σ0ln(1−u)。
一维均匀分布随机数序列的产生方法
一维均匀分布随机数序列的产生方法【摘要】利用混沌的随机数产生算法和线性同余发生器以及MATLAB产生一维均匀分布随机数序列.经过检验,随机数列的统计性质有了很大提高,【关键词】混沌;线性同余发生器;MATLAB;随机数1 引言随机数在信息加密、数值运算及医学中基因序列分析等研究中有着广泛的应用。
比如数值运算中,Monte Carlo方法占有重要的地位,随机数是该方法的基础.随机数的质量影响了信息的安全和计算结果的精度。
特别是一些安全级别比较高的应用,对随机数提出了很高的要求。
随机数可由硬件和软件两种方式产生。
在计算机中广泛使用的是软件方式,通过计算机利用数学模拟随机过程产生随机数。
此方法有着自身的不足,数据之间有着关联性,存在周期,并非真正的随机数,因此被成为伪随机数。
生成随机数的方法繁多,从产生机理来说,可分为数学方法和物理方法两种,其所产生的随机数分别被称之为伪随机数和真随机数,前者易被破解,后者取自物理世界的真实随机源,难以破解,但这并不代表基于真随机源产生的随机数质量就很高,要取决于产生算法如何利用这个真随机源,相反的,许多用数学方法产生的随机数质量比较好。
因此,若能将数学方法和物理方法结合起来,则可能产生高质量的真随机数。
常见的产生随机数的方法有【1】线性同余法(LCG,Linear Congruent Generators)、Tarsworthe位移计数器法、Fibonacci延迟产生器法等。
为了克服以上方法的缺陷,人们还发展了许多新的方法。
组合发生器就是著名的一种。
它是将两个随机数发生器进行组合,以一种发生器产生一个随机数列,再用另一个随机数发生器对随机数列进行重修排列,得到一个更为独立,周期更长的随机数列。
已有一些利用混沌序列转换伪随机数列的报道【2】,文献【3】虽然提出了一种由logistic映射构造具有均匀性数列的好方法,但数据之间的独立性较差。
本研究中提出了一种新的方法,利用混沌算法【4】和线性同余发生器相组合得到随机数列,并就数据的均匀性和独立性进行了检验。
常见统计分布及其特点
【附录一】常见分布汇总一、二项分布二项分布(Binomial Distribution),即重复n次的伯努利试验(Bernoulli Experiment),用ξ表示随机试验的结果, 如果事件发生的概率是P,则不发生的概率q=1-p,N次独立重复试验中发生K次的概率是。
二、泊松poisson分布1、概念当二项分布的n很大而p很小时,泊松分布可作为二项分布的近似,其中λ为np。
通常当n≧10,p≦0.1时,就可以用泊松公式近似得计算。
2、特点——期望和方差均为λ。
3、应用(固定速率出现的事物。
)——在实际事例中,当一个随机事件,例如某电话交换台收到的呼叫、来到某公共汽车站的乘客,以固定的平均瞬时速率λ(或称密度)随机且独立地出现时,那么这个事件在单位时间(面积或体积)内出现的次数或个数就近似地服从泊松分布三、均匀分布uniform设连续型随机变量X的分布函数F(x)=(x-a)/(b-a),a≤x≤b则称随机变量X服从[a,b]上的均匀分布,记为X~U[a,b]。
四、指数分布Exponential Distribution1、概念2、特点——无记忆性(1)这种分布表现为均值越小,分布偏斜的越厉害。
(2)无记忆性当s,t≥0时有P(T>s+t|T>t)=P(T>s) 即,如果T是某一元件的寿命,已知元件使用了t 小时,它总共使用至少s+t小时的条件概率,与从开始使用时算起它使用至少s小时的概率相等。
3、应用在电子元器件的可靠性研究中,通常用于描述对发生的缺陷数或系统故障数的测量结果五、正态分布Normal distribution1、概念2、中心极限定理与正态分布(说明了正态分布的广泛存在,是统计分析的基础)中心极限定理:设从均值为μ、方差为σ^2;(有限)的任意一个总体中抽取样本量为n 的样本,当n充分大时,样本均值的抽样分布近似服从均值为μ、方差为σ^2/n 的正态分布。
3、特点——在总体的随机抽样中广泛存在。
第4讲 随机数的生成及随机变量抽样
一、均匀分布U(0,1)的随机数的产生
• 产生均匀分布的标准算法在很多高级计算机语 言的书都可以看到。算法简单,容易实现。使用者 可以自己手动编程实现。Matlab 中也提供给我们 用于产生均匀分布的各种函数。我们的重点是怎样 通过均匀分布产生服从其他分布的随机数。因此, 直接使用Matlab提供的可靠安全的标准函数,当然 不用费事了。
学习主要的随机变量抽样方法1均匀分布u01的随机数的产生2其他各种分布的随机数的产生方法3随机数生成实例4实验作业随机数的生成及随机变量抽样随机数的产生是实现mc计算的先决条件
随机数的生成及随机变 量抽样 实验目的
学习主要的随机变量抽样方法
实验内容
1、均匀分布U(0,1)的随机数的产生 2、其他各种分布的随机数的产生方法 3、随机数生成实例 4、实验作业
随机向量的抽样方法
在用Monte Carlo等方法解应用问题时,随机 向量的抽样也是经常用到的. 若随机向量各分量相互独立,则它等价于多个 一元随机变量的抽样。
例8 生成单位正方形内均匀分布的1行10000列随机 数,并画散点图。 mm=10000 xRandnum=unifrnd(0,1,1,mm); yRandnum=unifrnd(0,1,1,mm); plot(xRandnum,yRandnum,'.')
0.25
0.05
F(X4)=0.95
F(X5)=1.00
( .70 -- .95]
( .95 – 1)
随机变量生成的算法为 ①产生一个u(0,1),并令i=0; ②令i=i+1; ③若u>F(xi),转回到第②步,否则转至④;
mm=10000;Randnum=unifrnd(0,1,1,mm);xRandnum=zeros(1,mm); for ii=1:mm if Randnum(1,ii)<=0.1 xRandnum(1,ii)=10; else if Randnum(1,ii)<=0.3 xRandnum(1,ii)=20; else if Randnum(1,ii)<=0.7 xRandnum(1,ii)=30; else if Randnum(1,ii)<=0.95 xRandnum(1,ii)=40; else xRandnum(1,ii)=50; end end end end end cdfplot(xRandnum)