
spss单样本t检验
spss -- t-test
Independent t-testห้องสมุดไป่ตู้practice
为了研究摄入酒精对驾驶汽车动作的影响,某研究者 随即抽取了20名成年司机,随机分成相等的两组。一 组摄入一定量的酒精,一组未摄入酒精,然后要求他 们在驾校的教练场驾驶汽车半个小时。结果每一位司 机遇到障碍物时平均的刹车距离为 3.5 3.0 4.5 2.8 5.0 4.0 2.6 5.0 4.5 6.0
Results
这14名数学兴趣小组的成员的数学平均分为 91.71分,标准差为4.39分.当把这组学生的平 均分(91.71)与全班平均分(80)进行单样 本t检验时,结果显示,t = 9.98,df = 13, p<.001.表明该数学小组成员数学的平均分显 著高于全班平均分。
Practice
摄 入 未 摄 入
3.2
2.5
2.5
1.0
3.5
2.0
2.0
2.5
1.5
1.0
Paired samples t-test
下面的数据是对12名技工学校学生进行某项劳动技能 实地训练前后的技能测试成绩,问实地训练是否有效 地提高了该项劳动技能的水平? 1 2 3 4 5 6 7 8 9 10 11 12
Xiaoyan Xu Sichuan Normal University
Single sample t-test (Onesample t-test)
某数学兴趣小组成员在期末考试中的数学成绩 如下所示,已知全班平均分为80分。请问该组 同学的平均数学成绩是否与全班同学的平均数 学成绩有显著差异。 90 85 88 92 95 99 100 89 92 91 93 88 87 95
(完整word版)单独样本T检验1
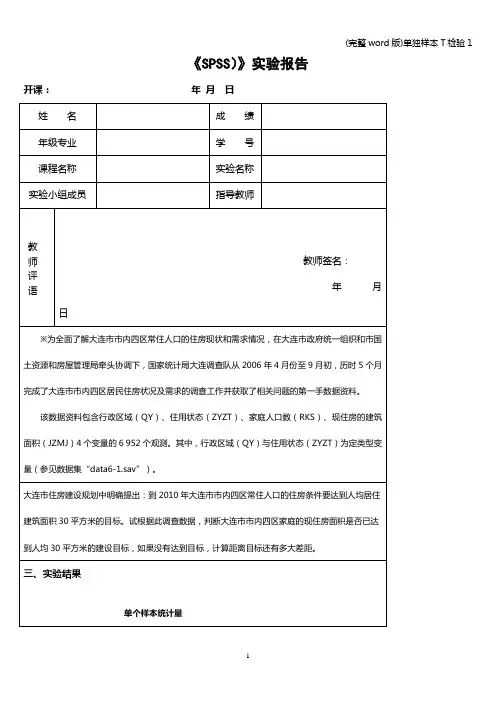
大连市住房建设规划中明确提出:到2010年大连市市内四区常住人口的住房条件要达到人均居住建筑面积30平方米的目标。试根据此调查数据,判断大连市市内四区家庭的现住房面积是否已达到人均30平方米的建设目标,如果没有达到目标,计算距离目标还有多大差距。
《SPSS)》实验报告
开课:年月 日
姓 名
成 绩
年级专业
学 号
课程名称
实验名称
实验小组成员
指导教师
教 师 评 语
教师签名:
年月日
※为全面了解大连市市内四区常住人口的住房现状和需求情况,在大连市政府统一组织和市国土资源和房屋管理局牵头协调下,国家统计局大连调查队从2006年4月份至9月初,历时5个月完成了大连市市内四区居民住房状况及需求的调查工作并获取了相关问题的第一手数据资料。
三、实验结果
单个样本统计量
N
均值
标准差
均值的标准误
家庭人均建筑面积
6952
30.5490
24.52867
.29418
单个样本检验
检验值= 30t源自dfSig.(双侧)均值差值
差分的95%置信区间
下限
上限
家庭人均建筑面积
1.866
6951
.062
.54896
-.0277
1.1256
根据上表结果可知,该市家庭人均建筑面积均值为30.5490,其中sig为0.062大于0.05所以该人均建筑面积为30的假设成立。所以已经达成了目标。
SPSS—单样本T检验

一、被调查学生对“云窗的打分值”总体平均值的推断:1、以71个被调查学生为样本做T 检验由表a 可知,71个观测的平均值为71.21,标准差为15,120,均值标准误为1.794。
表b 中,第二列是t 统计量的观测值为0.675,第三列是自由度n-1=70,第四列是t 统计量观测值的双尾概率p 值,第五列是样本均值与检验值的差(1.211),即t 统计量的分子部分,他除以表a 的均值标准误(1.794)后得到t 统计量的观测值0.675,第六列和第七列是总体均值与检验值差的95%的置信区间,为(67.63,74.79)。
对于研究的问题应采用双尾检验,因此比较2α和2p,即比较α和p 。
由于p 大于α(0.05),因此不能拒绝零假设,认为被调查学生对“云窗的打分值”总体平均值没有显著差异。
有95%的把握认为总体均值在 67.63~74.79 分之间。
70分包含在置信区间内,也证实了上述推断。
2、被调查学生对“云窗的打分值”的重抽样自举表cBootstrap 指定采样方法简单箱图样本数1000置信区间度95.0%置信区间类型百分位由表c可知,自举过程执行1000次,随机数种子指定为默认值2000000,采样方法为简单箱图。
中均值的重抽样自举均值与实际样本均值的差为-0.12,1000个均值的标准差为1.82,由此得到的均值95%的置信区间为(67.18,74.46)表e中没有给出双尾检验的概率p值,但是从检验的结果可知有95%的把握认为总体均值在67.184~74.463之间。
70包含在置信区间内。
用更大的样本量再一次说明了被调查学生对“云窗的打分值”总体平均值没有显著差异。
spss单一样本的T检验

spss单一样本的T检验SPSS是一款广泛使用的统计软件,可以用于各种统计分析,包括单一样本的T 检验。
下面是关于如何使用SPSS进行单一样本的T检验的详细步骤和解释。
一、目的单一样本的T检验主要用于比较一个样本的平均值与已知的或预设的数值,或者用于比较一个样本与已知的或预设的数值之间的差异。
这种检验通常用于检验一个样本是否显著地不同于已知的或预设的数值。
二、步骤1.打开SPSS软件,点击“分析”菜单,然后选择“比较平均值”>“独立样本T检验”。
2.在弹出的对话框中,将左侧的“独立样本T检验”选项卡中的“变量”字段拖到右侧的“变量”框中。
3.在“独立样本T检验”选项卡下方的“组”字段中输入已知的或预设的数值。
4.点击“确定”按钮,SPSS将计算并显示T检验的结果。
三、结果解释单一样本的T检验的结果通常包括T值和p值。
T值是计算出的统计量,而p 值是观察到的数据与零假设之间的不一致程度。
如果p值小于选择的显著性水平(通常为0.05),则可以拒绝零假设,认为样本平均值与已知的或预设的数值之间存在显著差异。
四、注意事项1.单一样本的T检验的前提是数据符合正态分布。
如果数据不符合正态分布,可以使用非参数检验,例如Mann-Whitney U检验或Wilcoxon符号秩检验。
2.在使用单一样本的T检验时,需要明确知道或预设的数值是什么,以及为什么要比较这个数值。
如果不知道或预设的数值是什么,或者比较的目的不明确,那么这种检验可能会没有意义或者导致错误的结论。
3.单一样本的T检验只能告诉我们一个样本的平均值与已知的或预设的数值之间的差异是否显著,但不能告诉我们这种差异的实际意义或影响。
因此,在解释结果时需要谨慎,并考虑实际应用背景。
4.在进行单一样本的T检验时,需要确保数据的质量和准确性。
如果数据存在缺失、异常值或错误,将会对结果产生影响。
在进行统计分析前,需要对数据进行清洗和预处理。
5.在进行单一样本的T检验时,需要考虑变量的类型和测量尺度。
spss数据统计分析(复习)

均值:方差检验(【单样本T检验】1.从某厂第一季度生产的电子元件中抽取了部分样品测量他们的电阻(单位:欧姆),数据资料在“小测1.sav”中。
按质量规定,元件的额定电阻为0.140欧姆,假定元件的电阻服从正态分布。
判断这批产品的质量是否合格。
从上表单样本数据统计量表中可以得测试电阻值的样品有35个,均值为0.1423,标准差为0.00426,均值标准误为0.00072从单样本检验表中可以看出:t统计量的值为3.174,自由度为34,均值差值为0.00229,95%的置信区间(0.0008,0.0037),相伴概率为0.003,远小于显著性水平0.05,说明假设成立,也就是说这批产品的质量与0.140欧姆有显著性差异,说明这批产品的质量是不合格的。
【独立样本T检验】2、甲乙两台测时仪同时测量两靶间子弹飞行的时间,测量结果在“小测2.sav”中,假定两台仪器测量的结果服从正态分布,设显著性水平为0.05,问两台仪器的测量结果有无显著差异Levene检验主要用来检验原假设条件是否成立,(即:假设方差相等和方差不相等两种情况)如果SIG>0.05,证明假设成立,不能够拒绝原假设,如果SIG<0.05,证明假设不成立,拒绝原假设。
在组数据统计表中可以得到第1组有6个样本,均值为12.8883,标准差是0.72256,均值标准误为0.29498;第二组有7个样本,均值是13,标准差是0.5870均值标准误是0.22189;在独立样本检验表中可以得出F 的统计量的值为1.028,相伴概况为0,332,远大于显著性水平0.05,说明这两组数据的方差之间不存在显著差别,所以适合采用独立样本T检验。
t的统计量为-0.772,自由度为11,95%的置信区间,(01.07881,0.51834),相伴概率为0.456,远大于显著性水平0.05,假设成立,不能拒绝原假设,说明这2台仪器的测试结果没有显著性差异。
3-5--t检验-SPSS-有答案知识讲解

1. 00
16 2.6250 .9270.926763
Independent Samples Test
Levene's Test for Equalit y of Variances t-t est for Equality of Means
F
Sig.
t
血 清 胆 E固 qua 醇 l variances assumed .057 .8141.532
健康者编号 X2
1
2.34
2
6.40
3
2.60
4
3.24
5
6.53
6
5.18
7
5.58
8
3.73
9
4.32
10
5.78
11
3.73
2
2.50
3
1.98
4
1.67
5
1.98
6
3.60
7
2.33
8
3.73
9
4.57
10 4.82
11 5.78
12 4.17
13 4.14
分析步骤
第一步:建立数据文件。它设立两个变 量:group 其取值为1表示甲组,其取值2表 示乙组,取文件名为独立样本t检验。GS表 示血糖值.
Test Variable List框内;在
Test Distribution中 激活“Normal”。 单击OK按钮。 则得出输出结 果。
P1=0.995,P2=0.652,都可认为近似正态分布
One -Sample Kolm ogoro v-Smirnov Te st
GRO UP
1.00
N
Norm al Parameters
SPSS-t检验
数据输入
1)启动SPSS,进入定义变量工作表,分别命名 两变量:组别、鱼产量。其中组别1表示A料,组 别2表示B料。
2)进入数据视图工作表,输入数据
统计பைடு நூலகம்析
Analyze---compare mean----indendent samples T test
Test variable(输入):产鱼量
2、选择检验方法和计算检验统计量 因为总体标准差σ未知,所以采用t检验。 Analyze →Compare Means→One-Sample T Test出现如下对话框:
•把x移入到Test Variable(s) 的变量列表; •在Test Value后输入需要 比较的总体均数20; •OK
3、根据检验统计量的结果做出统计推断 基本统计量信息:
T检验
(一)单个总体均数的t检验 (二)独立样本成组t检验 (三)成对样本t检验
(一)单个总体均数的t检验
计算公式
样本平均数与总体平均数差异显著性检验
例:成虾的平均体重为21克,在配合饲料中添加 0.5%的酵母培养物饲养成虾时,随机抽取16只对 虾,体重为20.1、21.6、22.2、23.1、20.7、19.9、 21.3、21.4、22.6、22.3、20.9、21.7、22.8、 21.7、21.3、20.7。试检验添加添加0.5%的酵母 培养物是否提高了成虾体重。
从结果中可以看出,统计量t=3.056,P=0.012<α=0.05,因此拒 绝H0,接收H1,即用该方法测量所得结果与标准浓度值有所不 同。认为该方法测量结果所对应总体均数μ与标准浓度μ0间的差 异有统计学意义。
(二)独立样本成组t检验
独立样本:又称非配对样本或成组样本。是指一组数据与另一 组数据没有任何关系,也就是说,两样本资料是相互独立的。 两组的样本容量尽可能相同,可以提高检验的精确度。其均 数差异显著性的t检验,又分为两总体方差相等(方差齐性)和 方差不等两种检验方法。
spss均值检验(均数分析单样本t检验独立样本t检验)
在统计学中,我们往往从样本的特性推知随机变量总体的特性。
但由于总体中个体之间存在差异,样本的统计量和总体的参数之间往往会有误差。
因此,均值不相等的样本未必来自不同分布的总体,而均值相等的样本未必来自有相同分布的总体。
也就是说,如何从样本均值的差异推知总体的差异,这就是均值比较的内容。
SPSS提供了均值比较过程,在主菜单栏单击“Analyze”菜单下的“Compare Means”项,该项下有5个过程,如图4-1。
平均数比较Means过程用于统计分组变量的的基本统计量。
这些基本统计量包括:均值(Mean)、标准差(Standard Deviation)、观察量数目(Number of Cases)、方差(Variance)。
Means过程还可以列出方差表和线性检验结果。
[例子]调查了棉铃虫百株卵量在暴雨前后的数量变化,统计暴雨前和暴雨后的统计量,其数据如下:暴雨前 110 115 133 133 128 108 110 110 140 104 160 120 120暴雨后 90 116 101 131 110 88 92 104 126 86 114 88 112该数据保存在“DATA4-1.SAV”文件中。
1)准备分析数据在数据编辑窗口输入分析的数据,如图4-2所示。
或者打开需要分析的数据文件“DATA4-1.SAV”。
图4-2 数据窗口2)启动分析过程在SPSS主菜单中依次选择“Analyze→Compare Means→Means”。
出现对话框如图4-3。
图4-3 Means设置窗口3)设置分析变量从左边的变量列表中选中“百株卵量”变量后,点击变量选择右拉按钮,该变量就进入到因子变量列表“Dependent List:”框里,用户可以从左边变量列表里选择一个或多个变量进行统计。
从左边的变量列表中选中“调查时候”变量,点击“Independent List”框左边的右拉按钮,该变量就进入分组变量“IndependentList”框里,用户可以从左边变量列表里选择一个或多个分组变量。
spss统计分析教程-独立样本t检验(1)
独立样本T检验下面我们要用SPSS来做成组设计两样本均数比较的t检验,选择Analyze==>Compare Means==>Independent-Samples T test,系统弹出两样本t检验对话框如下:将变量X选入test框内,变量group选入grouping框内,注意这时下面的Define Groups按钮变黑,表示该按钮可用,单击它,系统弹出比较组定义对话框如右图所示:该对话框用于定义是哪两组相比,在两个group框内分别输入1和2,表明是变量group取值为1和2的两组相比。
然后单击Continue按钮,再单击OK按钮,系统经过计算后会弹出结果浏览窗口,首先给出的是两组的基本情况描述,如样本量、均数等(糟糕,刚才的半天工夫白费了),然后是t检验的结果如下:Levene's TestforEqualityofVariancest-test for Equality of MeansFSig.tdfSig.(2-tailed)MeanDifferenceStd.ErrorDifference95%ConfidenceInterval ofthe Difference体方差是否齐,这里的戒严结果为F = ,p = ,可见在本例中方差是齐的;第二部分则分别给出两组所在总体方差齐和方差不齐时的t检验结果,由于前面的方差齐性检验结果为方差齐,第二部分就应选用方差齐时的t检验结果,即上面一行列出的t= ,ν=22,p=。
从而最终的统计结论为按α=水准,拒绝H0,认为克山病患者与健康人的血磷值不同,从样本均数来看,可认为克山病患者的血磷值较高。
SPSS抽样误差和t检验
抽样误差和t 检验Sampling error and t test一、目的要求(一)掌握抽样误差的定义,单样本t 检验、配对t 检验和两样本t 检验的计算及在SPSS 中的实现 (二)熟悉三种t 检验的适用条件二、预习纲要(一)t 检验的前提条件1.样本来自正态总体;2.两样本均数比较时,两样本总体方差齐性;3.各样本之间相互独立。
(二)抽样误差定义由个体变异产生的,抽样造成样本统计量与总体参数的差异,称为抽样误差。
通常用标准误说明均数抽样误差的大小。
(三)计算公式 1.标准误 nS S x =2.样本均数与总体均数比较 xS x t ||μ-=3.配对资料的比较 dS d t |0|-=4.两样本均数比较 )(2121||x x S x x t --=三、例题(一)样本均数与总体均数比较(One-Sample T Test 过程)【例1】随机抽取某地区20名成年男子,测得其脉搏(次/分)如下:75 73 73 76 79 63 81 80 76 70 897577828176806779661.数据的录入本例只有一个变量脉搏,其变量名为pulse ,依次输入上述的20个脉搏测量值,结果如图4.1图4.1 单样本t检验数据录入格式2.统计分析选择Analyze---Compare Means---One Sample T Test…命令项,弹出One Sample T Test对话框,将左侧变量列表中的变量pulse选入右侧的Test Variable(s):栏中。
在Test V alue栏中键入待比较的总体均值72(图4.2),最后点击OK钮。
图4.2 One Sample T Test对话框3.结果的输出及解释:首先输出的是变量pulse的基本统计指标,一共有20例样本,样本均值为75.900,标准差为6.121,标准误为1.3686。
其次输出的是单样本比较的统计指标,t=2.850,自由度为19,双侧P值=0.010,P<0.05,不能认为该地成年男子的脉搏为72次/分。