
学校的学生成绩进行聚类分析
学校的学生成绩进行聚类分析
1、背景
随着我国经济的发展,网络已被应用到各个行业,人们对网络带来的高效率越来越重视,然而大量数据信息给人们带来方便的同时,也随之带来了许多新问题,大量数据资源的背后隐藏着许多重要的信息,人们希望能对其进行更深入的分析,以便更好地利用这些数据,从中找出潜在的规律。
那么,如何从大量的数据中提取并发现有用信息以提供决策的依据,已成为一个新的研究课题。
目前普遍使用的成绩分析方法一般只能得到均值、方差等一类信息,且仅仅是从一门课程独立数据进行的分析,但在实际教学中,比如学生在学习某一门课程时,是哪一门或者几门课程对其影响很大,包括教学以外的哪些因素对学生成绩造成了较大的影响等各种有价值的信息往往无法获知。
2、聚类分析
在数据库中的知识发现和数据挖掘(KDDM)受到目前人工智能与数据库界的广泛重视。
KDDM的目的是从海量的数据中提取人们感兴趣的、有价值的知识和重要的信息,聚类则是KDDM领域中的一个重要分支。
所谓聚类是将物理或抽象的集合分组成为类似的对象组成的多个类的过程。
聚类分析就是将一组数据分组,使其具有最大的组内相似性和最小的组间相似性。
简单的说就是达到不同聚类中的数据尽可能不同,而同一聚类中的数据尽可能相似,它与分类不同,分类是对于目标数据库中存在哪些类这一信息是知道的,所要做的就是将每一条记录分别属于哪一类标记出来;而聚类是在预先不知道目标数据库到底有多少类的情况下,希望将所有的记录组成不同的簇或者说“聚类”,并且使得在这种分类情况下,以某种度量为标准的相似性,在同一聚类之间最小化,而在不同聚类之间最大化。
事实上,聚类算法中很多算法的相似性都基于距离而且由于现实数据库中数据类型的多样性,关于如何度量两个含有非数值型字段的记录之间的距离的讨论有很多,并提出了相应的算法。
聚类分析的算法可以分为以下几类:划分方法、层次方法、基于密度方法等。
这里只描述一种:K-means算法,如下
3、K-means算法
K均值聚类,即数据挖掘中的C均值聚类,属于聚类分析方法中一种基本的且应用最广泛的划分算法。
K-means算法是J.B.MacQueen在1967年提出的,是聚类方法中一个基本的划分方法,也是目前诸多聚类算法中极有影响的一种技术。
K-均值算法以k为参数,把N个对象分为k个簇,以使簇内具有较高的相似度。
相似度的计算根据一个簇中对象的平均值来进行。
算法首先随机地选择K个对象,每个对象初始地代表了一个簇的平均值或中心。
对剩余的每个对象根据其与各个簇中心的距离,将它赋给最近的簇。
然后重新计算每个簇的平均值。
这个过程不断重复,直到准则函数收敛。
K-Means算法的准则函数定义为:
即E是数据库所有对象的平方误差的总和。
其中x是空间中的点,表示给定的数据对象,是簇的平均值。
K-means算法描述为:
输入:簇的数目k和包含n个对象的数据库
输出:k个簇,使平方误差准则最小
(1)assigninitial value for means;
//任意选择k个对象作为初始的簇中心
(2)REPEAT
(3)FOR j=ito n DO assign each xj to the cluster which has the closest mean;
//根据簇中对象的平均值,将每个对象赋给最类似的簇
(4)FORi=1 to k DO
//更新簇的平均值,即计算每个对象簇中对象的平均值
(5)ComputeE;
//计算准则函数E
(6)UNTILE 不再明显地发生变化;
从上面的算法思想和算法框架,我们不难看出,K个初始聚类中心点的选取对聚类结果具有较大的影响,因为在该算法中是随机地选取任意K个点作为初始聚类中心。
如果有先验知识,可以选取具有代表性的点作为初始中心点。
在上面这个算法中,一次迭代中把每一个数据对象分到离它最近的聚类中心所在的类中,这个过程的时间复杂度为O(nkd),这里n指的是总的数据对象的个数,k是指定的聚类数也叫簇数,d是数据对象的维数;新的分类产生以后需要计算新的聚类中心,这个过程的时间复杂度为0(nd)。
所以这个算法一次迭代需要的总的时间复杂度为O(nkd)。
4、数据准备与数据预处理
(1)聚类数据的预处理
现实世界中的数据库存在大量的噪声数据、空缺数据和不一致数据。
基因表达数据也存在这种情况。
有很多数据预处理技术可以去掉数据中的噪声,纠正不一致。
为了提高涉及距离度量的聚类算法的精度和有效性,可以采用数据规范化的一些方法。
(2)数据清理
在实际数据库中往往存在着一些空缺值和噪音数据。
对于空缺值,可以采用以下方法填写空缺值。
1)人工填写空缺值。
这种方法对操作人员要求较高。
并且,该方法很费时,当数据集很大时,该方法可能行不通。
2)使用该空缺值所在属性的平均值来填充。
比如当进行样本聚类时,如果某个样本在某个指标值上的值空缺,可使用其它样本在该指标上的平均值来填充该空缺值。
对于噪声数据,我们可以采用一些数据平滑技术来平滑数据。
3)数据规范化。
如果数据库中的各属性的量纲和单位不同,在计算机对象间的距离之前,必须把不同的度量单位统一成相同的度量单位。
由于属于不同概念范畴的属性具有不同的含义,把所有的属性转化成某个特定的度量单位是不可能的。
常用的方法是把属性的值域映射为一个相同的区间(通常是[0,1]区间),这个过程成为属性的标准化或规范化。
准备500学生的成绩包含:数学、英语、语文、物理、化学、历史、地理等
5、RapidMiner聚类分析
分析流程:读取数据库---->聚类分析---->存储csv文件---->结束
1、打开RapidMiner工具,进入白板界面
2、读取数据库:拖曳---左侧中的Database--->Read Database标签,读取数据库,然后设置数据库的基本条件,点击白板中的Read Database,查看右侧信息
1)数据库连接条件:点击Connection右边的数据库连接配置按钮,输入相关信息如:数据库名称、用户名、密码、Host等,然后点击下方的测试一下连接是否成功。
2)读取数据库中表以及相关属性数据配置:点击query右侧的图标,选择数据库下的表--属性--以及条件,可以筛选出来对应的数据
3、聚类算法:拖曳---左侧中的Modeling--->segmentation--->K-Means标签到白板中,聚类算法插件,用于数据的聚类分析
1)配置聚类算法的参数:簇数、迭代次数等
4、存储文件:拖曳---左侧中的Data Access--->Files--->Write标签到白板中,存储文件插件,
用于分析结果的存储
然后在右侧csv file配置存储路径
5、分析流程图---规划,通过连接线连接整个的执行流程,并点击执行按钮如图所示
6、执行结果
1)、分析具体结果数据
2)、统计数据:最大、最小、平均值、聚类
3)、聚类分析图
7、结果分析:
第一个图可以看出:
1)每科目的最低分、最高分、平均分等信息
2)聚类:三簇数据,每簇数据的学生个数
第二个图可以看出:
1)每科分值的分布情况,看出大部分学生的成绩分布在【70-80】之间,90分以上的偏少第三个图可以看出:
1)聚类按三簇进行聚类,也就是说分为了三类学生
2)cluster_0结合第一个图有378个学生实例,从成绩上分析学习情况:地理成绩不及格;语文、化学成绩偏差;物理、英语较好;数学最好
cluster_1结合第一个图有136个学生实例,从成绩上分析学习情况:地理成绩不及格;历史、化学成绩偏差;语文较好;物理、英语、数学最好
cluster_2结合第一个图有26个学生实例,从成绩上分析学习情况:地理成绩不及格;历史、化学成绩偏差;语文、数学、物理较好;英语最好
因此,根据分析的数据来看,这三类的学生,老师可以根据不同的情况,进行分类着重辅导。
聚类算法在学生成绩分析中的应用
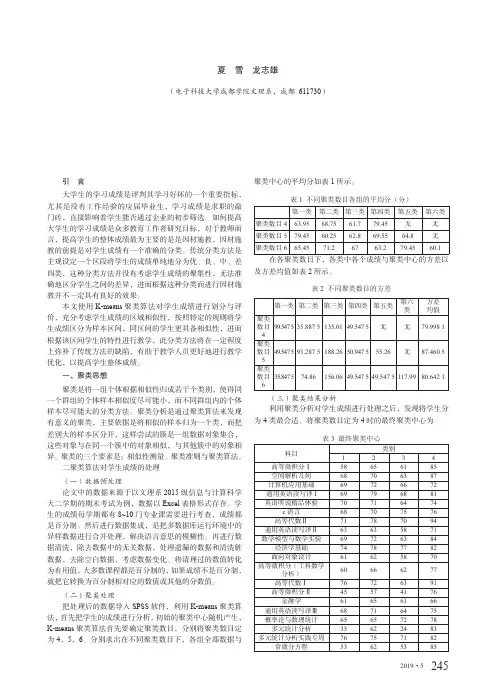
(一)数据预处理 论文中的数据来源于以文理系 2015 级信息与计算科学 大二学期的期末考试为例,数据以 Excel 表格形式存在。学 生的成绩每学期都有 8~10 门专业课需要进行考查,成绩都 是百分制。然后进行数据集成,是把多数据库运行环境中的 异样数据进行合并处理,解决语言意思的模糊性。再进行数 据清洗,除去数据中的无关数据,处理遗漏的数据和清洗脏 数据,去除空白数据,考虑数据变化。将清理过的数值转化 为有用值,大多数课程都是百分制的,如果成绩不是百分制, 就把它转换为百分制相对应的数值或其他的分数值。
聚类数目 4 63.95 68.75 61.7 79.45 无
无
聚类数目 5 79.45 60.25 62.8 69.55 64.8
无
聚类数目 6 65.45 71.2 67 63.2 79.45 60.1
在各聚类数目下,各类中各个成绩与聚类中心的方差以
及方差均值如表 2 所示。
表 2 不同聚类数目的方差
(二)聚类处理 把处理后的数据导入 SPSS 软件,利用 K-means 聚类算 法,首先把学生的成绩进行分析,初始的聚类中心随机产生, K-means 聚类算法首先要确定聚类数目,分别将聚类数目定 为 4,5,6。分别求出在不同聚类数目下,各组全部数据与
表 1 不同聚类数目各组的平均分(分)
第一类 第二类 第三类 第四类 第五类 第六类
些课堂的自由,让他们自己可以专研自己感兴趣的知识点。
参考文献:
[1] 王 智 . 改 进 K-means 算 法 在 职 高 试 卷 成 绩 分 析 中 的 应 用 [J]. 电脑知识与技术,2010,6(18):5048-5049.
[2] 葛佶莛 . 基于聚类算法的学生成绩评价与管理机制研 究 [J]. 中国教育信息化,2014(7):76-78
利用K-means聚类分析技术分析学生成绩
利用K-means聚类分析技术分析学生成绩摘要:数据挖掘是在海量的数据中寻找模式或规则的过程。
数据聚类则是数据挖掘中的一项重要技术,就是将数据对象划分到不同的类或者簇中,使得属于同簇的数据对象相似性尽量大,而不同簇的数据对象相异性尽量大。
目前数据挖掘技术在商业、金融业等方面都得到了广泛的应用,而在教育领域的应用较少,随着高校招生规模的扩大,在校学生成绩分布越来越复杂,除了传统成绩分析得到的一些结论外,还有一些不易发现的信息隐含其中,因而把数据挖掘技术引入到学生成绩分析中,有利于针对性地提高教学质量。
本论文就是运用数据挖掘中的聚类分析学生成绩的,利用学生在选择专业前的各主要学科的成绩构成,对数据进行选择,预处理,挖掘分析等。
运用聚类算法分析学生对哪个专业的强弱选择,从而为具有不同成绩特征的同学在专业选择及分专业后如何开展学习提供一定的参考意见。
关键字:数据挖掘聚类分析学生成绩分析Abstract:Data mining is a process that in the vast amounts of data looking for patterns or rules. Data clustering is an important data mining technology for people to understand and explore the inherent relationship between things. Clustering is to partition data objects into different categories, or clusters, making the similarity with the clusters of data as large as possible. While the dissimilarity of different clusters of data as large as possible.Nowadays data mining technology is widely used in business and finance. But it is less used in education field. With the increase of enrollment in universities, there are more and more students in campus, and that makes it more and more complex in the distribution of students" records. Besides some conclusions from traditional record analysis, a lot of potential information cannot be founded. Importing the data mining technology to students" record analyzing makes it more convenient and improve the teaching quality. In this paper, clustering technique in data mining is used to students' performance analysis, the use of data structure of main subject before the students specialized in choice of mode, pretreatment and data mining. Using clustering technology to analyse which professional students are good at, so as to choose how to learn professional and give some reference opinions after students of different grades choose their majors.Keywords :Data Mining , Clustering Technology , Students' Achievement1.概述1.1背景随着我国经济的发展,网络已被应用到各个行业,人们对网络带来的高效率越来越重视,然而大量数据信息给人们带来方便的同时,也随之带来了许多新问题,大量数据资源的背后隐藏着许多重要的信息,人们希望能对其进行更深入的分析,以便更好地利用这些数据,从中找出潜在的规律。
考试成绩的聚类分析
考试成绩的聚类分析[摘要]学业成绩是对学生进行测评的主要指标,对个体的发展具有重要意义。
本文以45名学生初中入学成绩和初一全学年四次期中,期末各科考试成绩为样本,采用统计方法,对所有样本进行聚类分析,探究聚类分析结果和实际经验之间的相关关系,期望对学生能有一个更全面的、更公平的评价方式,为提高教学质量,实施分类指导和教学,提供定量性的决策依据。
[关键词]学业成绩;分类;聚类分析一.引言刚入学的初一年级新生都有一种很强的自豪感和优越感,他们都想在初中阶段取得优异的成绩。
但由于学生存在学习能力和学习习惯上的差异,随着时间的推移,初中各科知识广度、深度、难度的增加,学生的学习成绩的差异会逐渐拉大,部分学生原有的自豪感和优越感就会逐渐减弱和消失。
而这种自豪感和优越感的保持与发挥,对于教师教育、教学工作的深入开展又是非常有用的,所以根据学生的实际情况对他们进行划分,以便于教师对他们实施分类指导、分层教学,即因材施教。
对于那些学习比较好的学生,可以适当地拓宽知识面,加深难度,并经常提醒他们不要忘了自己当初立下的雄心壮志。
对于那些学习比较差的同学,我们可以适当的降低难度并经常鼓励他们,让学生重新找回自信,证明自己并不比别人差,只是自己还不够努力或学习方法有问题。
因此,根据学生在一定阶段的学业成绩,结合经验和科学方法对学生进行分类,是一项有意义的研究工作。
在日常工作中,老师们常用的分类方法只是根据短时期的平均成绩或总成绩大致估计一下是好,还是差或者干脆采取等级制,这样的分类评价由于缺少定量的标准,往往带有判断者的主观色彩,不能充分反映学生原始成绩中蕴含的信息资源。
而且对于长期的样本数据,由于人脑容量的限制,老师们不可能把握每一个学生在一个较长时期的变化趋势。
因此采用科学的方法对成绩数据进行分析和挖掘是对传统方法和经验的补充、完善。
二.方法介绍聚类分析是数据挖掘和统计学中的常用分类方法。
可以分为变量聚类和样本聚类。
原创:基于聚类的学生成绩分析
摘要:该文采用聚类分析的k均值算法对学生的考试成绩进行聚类,得到了簇中心和个类数。
研究表明,如果优秀率、良好率、中等率、及格率和不及格率符合正态分布,说明教学效果良好,学生对该课程内容掌握较好。
中国论文网关键词:聚类;K均值算法;成绩分析中图分类号:TP312文献标识码:A文章编号:1009-3044(2012)03-0519-03Students’Score Analysis Based on Clustering MethodSONG Xiang-hong1, BAI Ming-yue2(1.Department of Computer Science and Application, Pingdingshan Institute of Education, Pingdingshan 467000, China; 2.Office of Fun? ther Education, Pingdingshan Institute of Education, Pingdingshan 467000, China)Abstract: K means algorithm of cluster analysis was applied to analyze the students’score, and the cluster centers and number of cases in each cluster were obtained. Research results indicate that if the rates of excellence, good, middle, pass, and fail is subjected to normal distri? bution, it shows that the teaching effect is good and the condition of students mastering the course is well.Key words: cluster; K means algorithm; score analysis学生成绩是学校学生信息数据库中最重要的部分,也是评估教学质量的重要依据,也是评价学生是否掌握好所学知识的重要标志。
基于机器学习的聚类算法在分析学生成绩中的应用

基于机器学习的聚类算法在分析学生成绩中的应用在教育领域中,学生成绩的分析一直是学校管理和教育改进的重要任务之一。
聚类算法是机器学习中常用的一种技术,可以对大量数据进行分类和分析,并帮助教育工作者更好地了解学生成绩的分布和特点。
本文将介绍基于机器学习的聚类算法在分析学生成绩中的应用,并探讨其在教育领域中的潜在作用。
首先,聚类算法可以帮助教育工作者快速识别出学生成绩中的不同群体。
例如,通过聚类算法,可以将学生划分为高、中、低三个群体,从而快速了解学生群体的整体水平和分布情况。
这样的分类可以帮助教育工作者有针对性地制定学习计划和教学策略,更好地满足学生的学习需求。
其次,聚类算法还可以帮助教育工作者挖掘学生成绩中的潜在规律和因素。
通过对学生成绩数据进行聚类分析,可以发现某些学生群体之间存在着明显的差异。
这可能意味着存在一些特定的因素或教学策略,对学生成绩的影响较大。
进一步分析这些差异,可以帮助教育工作者调整教学方法,提高学生成绩的整体水平。
此外,聚类算法还可以帮助教育工作者进行学生细分和个性化教育。
通过聚类算法,可以将学生按照其学习特点、兴趣爱好等因素进行细分。
这样,教育工作者可以根据不同细分群体的需求,设计出更有针对性的教育方案。
例如,对于数学能力较强的学生,可以提供更多的挑战性课程和学习资源;而对于英语基础较差的学生,则可以提供更多的辅导和帮助。
通过个性化教育,可以更好地满足学生的学习需求,提高学生成绩和学习兴趣。
此外,聚类算法还可以帮助教育管理者进行学校和班级绩效分析。
通过对学生成绩进行聚类分析,可以了解不同学校或班级的整体绩效水平和分布情况。
这样的分析可以帮助教育管理者了解学校或班级的优势和劣势,并制定相应的改进措施。
例如,如果某个班级的学生成绩整体较低,可以通过分析聚类结果找出问题所在,进而实施有效的教学改革。
当然,基于机器学习的聚类算法在学生成绩分析中也存在一些挑战和限制。
首先,聚类算法需要大量的学生成绩数据来进行训练和分析。
基于聚类分析的高职学生成绩影响模型
06
参考文献
参考文献
参考文献1
张三, 李四. (2020). 基于聚类分析的高职学 生成绩影响模型研究. 教育研究, 20(3), 1223.
参考文献2
王五, 赵六. (2019). 聚类分析在教育领域的应用及 发展趋势. 教育研究, 19(4), 56-67.
参考文献3
陈七, 王八. (2018). 基于聚类分析的学生分 类方法研究. 教育研究, 18(5), 78-89.
学生成绩特征提取与预处理
1 2
成绩数据清洗
去除缺失值、异常值和重复值,确保数据质量。
特征提取
从成绩数据中提取与学习效果相关的特征,如平 均分、最高分、最低分、分数标准差等。
3
数据规范化
将特征数据进行规范化处理,以消除不同特征之 间的量纲和取值范围差异对聚类结果的影响。
模型构建与评估
01
02
03
模型构建
02
基于聚类分析的学生成 绩影响模型构建
聚类分析算法选择
K-Means算法
通过设定聚类簇数,将学生成绩划分为不同的簇,以挖掘学生成 绩之间的相似性和差异性。
DBSCAN算法
通过设定密度阈值,将相邻且密度达到阈值要求的学生成绩划分为 同一簇,以发现任意形状的簇。
层次聚类算法
通过不断合并相近且密度达到阈值要求的学生成绩,形成一个树状 结构,以揭示学生成绩的层次关系。
基于聚类分析的高职 学生成绩影响模型
汇报人: 日期:
目录
• 引言 • 基于聚类分析的学生成绩影响模型构建 • 学生成绩影响因素分析 • 基于聚类分析的学生成绩预测模型 • 结论与展望 • 参考文献
01
引言
研究背景与意义
基于聚类分析的学生成绩评定方法研究
第四步:在一次迭代前后, J 的值 没有发生变化,说明算法已经收敛。迭 代 2 ~ 3 步直至新的质心与原质心相等 或小于指定阈值,算法结束。
三、k-means 分析法分析学生成绩 (一)调查方法 本次调查采用调查本校 47 位同学某 学期的成绩,调查对象涉及 6 门课程(大 学英语、大学体育、大学计算机基础、 思想道德修养与法律基础、数学分析 I) 的不同成绩来进行研究,具有一定的代 表性。 为了全面考虑大学生成绩所考虑的 主要因素 , 确定大学生的成绩标准 , 建 立聚类结构模型的学生成绩,建立科学 合理的大学生成绩聚类体系,用 SPSS 解 决 K-means 聚类法。 (二)数据分析 首先将 EXCEL 文件中的 47 位同学的 6 门成绩导入 SPSS 软件,然后运用 SPSS 软件对学生成绩进行分析与分类,最后
2 81.92 82.85 71.15 87.23 79.77 83.08
3 36.00 60.00 62.00 87.00 60.00 60.00
智库时代
智库理论
基于聚类分析的学生成绩评定方法研究 *
韦晓静
(百色学院数学与统计学院,广西百色 533000)
摘要:对大学生成绩的评定,是学校教学的重要环节,传统的等级评定方式方法存在一定的缺陷,不能正确且有力地反映学生成绩
所蕴含的信息资源。通过数据挖掘中聚类分析的理念,采用聚类分析算法对学生的成绩进行评定,可以有效地解决传统判定方法的
文章编号:2096-4609(2020)11-0203-002
一、引言 时代在更新,社会在进步,现如今 大学生成绩差异越来越大,特别是高校 学生群体,他们的成绩在教育较为宽松 的情况下出现参差不齐的状态。大学生 成绩不仅仅是作为综合评定的基础,更 是影响个人以后的发展,因而学生成绩 的评定是一个急需解决的问题。 在教学研究动态中,客观、科学合 理地对学生成绩进行评定是教学研究的 核心,它不仅代表着学生的学习效果, 还能反映出教学中出现的一系列问题。 聚类分析一般又称群分析,是根据 俗语“物以类聚”的道理,对事物进行 分类的一种一类多元统计方法。 学生成绩应该以平均的水平作为参 考,实现类聚。聚类分析的方法不仅能 更大地体现出学生之间的差异,且评定 方法是客观合理的,所得的结果减少了 主观因素,使结果更符合实际情况。采 用聚类分析方法,对于学生成绩中的多 个样本进行聚类分析,应用聚类分析方 法评定学生成绩,等级优化了传统的等 级评价方法。 二、聚类分析法相关概念 (一)聚类分析的定义 聚类分析一般称群分析,是研究事 务分类问题的统计分析方法,并且对于 数据挖掘来说也是一个重要的算法。聚 类分析是由多个模式组成的,模式可以 是一个度量向量,也可以是多维空间中 的一个点。 聚类分析以相似性为评判标准,在 不同种类的模式之间,有着更多的相似 性,那么他们就可以分为一种聚类。
聚类算法分析及其在学生成绩分中的应用
本科学生毕业论文(设计)题目聚类算法分析及其在学生成绩分析中的应用学院数学计算机科学学院专业计算机科学与技术学生姓名陶彬贤学号0715206指导教师伍长荣职称副教授论文子数6564完成日期2011 年 4 月15 日论文题目聚类算法分析及其在学生成绩分析中的应用_________学生姓名、学院:陶彬贤数学计算机科学学院中文摘要(300字左右)数据挖掘就是从大量的、不完全的、模糊的、随机的数据中,提取隐含在其中的,人们事先不知道的,但又是潜在有用的信息和知识的过程。
数据挖掘的方法有很多,聚类分析是目前最有应用前景的数据分析方法之一,因为聚类分析能作为一个独立的工具来获得数据分布的情况,观察每一个簇的特点,并能集中的对特定的某些簇作进一步的分析。
对学生原始成绩进行等级评定是教学管理中的重要环节,利用聚类算法可以对学生成绩进行有效的等级划分。
K_mea ns算法是划分式聚类算法的一种,文中运用K means算法对学生成绩进行了聚类并对结果加以分析。
关键词(3〜5个):聚类算法;K means;学生成绩分析英文题目Cluster ng algorithms and Applicati on of Clusteri ng algorithms instude nts' performa nee an alysis学生姓名、学院(英文):Taob in xia n, school of mathematics&computer scie nee 英文摘要Data mi ning extract those implicit but pote ntially useful in formatio n from a lot of in complete, fuzzy and ran dom data.There are many ways of data mi ning .Clusteri ng an alysis is one of the most applicatio n prospect of data an alysis method.because the cluster an alysis can be used as an in depe ndent tool to get data distributi on, observe every cluster characteristic, and can focus on certain cluster for furtheranalysis.Ranking of the student original scores is an important link of teaching ing clustering algorithm can repartition the student achievement effectively.k_mea ns algorithm is a partiti on type of clusteri ng algorith m.ln this paper K_means algorithm is used to cluster the stude nt achieveme nt and the result has bee n analysed.英文关键词Clustering algorithms;k _means; students' performanee analysis目录第一章引言..................................................... 3.第二章聚类分析技术与K_mean翼法 . (3)2.1聚类的定义 (3)2.2聚类算法的分类 (3)第三章聚类技术在学生成绩分析中的应用 (5)3.1学生成绩传统划分 (5)3.2 k_means算法描述[10] (5)3.3 k-means聚类算法实现流程图 (6)3.4 K_mea ns算法对学生成绩分析 (6)3.5程序实现................................................ 7.3.6传统方法与K_means算法的比较 (9)结论........................................................... 9.参考文献:..................................................... 9.致谢......................................................... 1.0聚类算法分析及其在学生成绩分析中的应用陶彬贤,数计学院摘要:数据挖掘就是从大量的、不完全的、模糊的、随机的数据中,提取隐含在其中的,人们事先不知道的,但又是潜在有用的信息和知识的过程。
学校的学生成绩进行聚类分析
学校的学生成绩进行聚类分析1、背景随着我国经济的发展,网络已被应用到各个行业,人们对网络带来的高效率越来越重视,然而大量数据信息给人们带来方便的同时,也随之带来了许多新问题,大量数据资源的背后隐藏着许多重要的信息,人们希望能对其进行更深入的分析,以便更好地利用这些数据,从中找岀潜在的规律。
那么,如何从大量的数据中提取并发现有用信息以提供决策的依据,己成为一个新的研究课题。
目前普遍使用的成绩分析方法一般只能得到均值、方差等一类信息,且仅仅是从一门课程独立数据进行的分析,但在实际教学中,比如学生在学习某一门课程时,是哪一门或者几门课程对其影响很大,包括教学以外的哪些因素对学生成绩造成了较大的影响等各种有价值的信息往往无法获知。
2、聚类分析在数据库中的知识发现和数据挖掘(KDDM)受到目前人工智能与数据库界的广泛重视。
KDDM 的目的是从海量的数据中提取人们感兴趣的、有价值的知识和重要的信息,聚类则是KDDM领域中的一个重要分支。
所谓聚类是将物理或抽象的集合分组成为类似的对象组成的多个类的过程。
聚类分析就是将一组数据分组,使其具有最大的组内相似性和最小的组间相似性。
简单的说就是达到不同聚类中的数据尽可能不同,而同一聚类中的数据尽可能相似,它与分类不同,分类是对于目标数据库中存在哪些类这一信息是知道的,所要做的就是将每一条记录分别属于哪一类标记岀来;而聚类是在预先不知道目标数据库到底有多少类的情况下,希望将所有的记录组成不同的簇或者说“聚类”,并且使得在这种分类情况下,以某种度量为标准的相似性,在同一聚类之间最小化,而在不同聚类之间最大化。
事实上,聚类算法中很多算法的相似性都基于距离而且由于现实数据库中数据类型的多样性,关于如何度量两个含有非数值型字段的记录之间的距离的讨论有很多,并提出了相应的算法。
聚类分析的算法可以分为以下几类:划分方法、层次方法、基于密度方法等。
这里只描述一种:K-means算法,如下3、K-means 算法K均值聚类,即数据挖掘中的C均值聚类,属于聚类分析方法中一种基本的且应用最广泛的划分算法。
班级学生成绩聚类分析报告
班级学生成绩聚类分析报告1. 引言学生成绩是评价学生学习成果的一个重要指标。
通过对学生成绩进行聚类分析可以帮助我们理解学生成绩之间的关系,发现不同学生群体之间的特点和差异,为教育教学提供参考。
本报告旨在对某班级学生成绩进行聚类分析,并探讨聚类结果的意义。
2. 数据准备本次分析使用的数据是某班级学生的成绩数据,包括数学、语文、英语三门课程的成绩。
共有50个学生的成绩数据,每位学生的成绩用一个向量表示,该向量的维度为3。
下表给出了前5位学生的成绩数据示例:学生编号数学成绩语文成绩英语成绩S1 85 90 75S2 72 80 82S3 96 91 93S4 68 75 78S5 92 88 853. 聚类分析方法聚类分析是一种将样本根据其相似性进行分组的方法。
在本次分析中,我们使用K-means算法对学生成绩进行聚类。
K-means算法通过将样本划分到K个聚类中心,使得各个样本到所属聚类中心的距离最小化,来实现聚类的目标。
4. 聚类分析过程在进行聚类分析之前,需要先确定K值,即要将样本分成几个聚类。
我们通过手肘法确定K值。
手肘法通过绘制不同K值下的聚类误差平方和(SSE)与K值的关系图,找到误差平方和变动趋势明显变缓的拐点作为合适的K值。
本次分析中,我们尝试了K从1到10的值,计算了对应的SSE,并绘制了SSE与K值的关系图。
观察到当K=3时,SSE的变化趋势明显变缓,因此我们选择K=3作为合适的聚类数量。
接下来,我们使用K-means算法将学生成绩进行聚类。
在聚类过程中,我们随机选择了3个初始聚类中心,并迭代计算每个样本与各个聚类中心的距离,将其划分到距离最近的聚类中心。
5. 聚类结果分析经过聚类分析,我们将学生成绩分成了3个聚类,分别为聚类1、聚类2和聚类3。
下图给出了聚类结果的可视化效果:从上图可以看出,不同聚类之间存在明显的差异。
我们对每个聚类的特点进行分析如下:- 聚类1: 该聚类中的学生在数学和语文成绩上表现较为突出,英语成绩相对较低。