
的 字结构为核心的最长名词短语识别研究
1 引言
最长名词短语(MNP)是指句子中不被其他名词短语直接 包含的名词短语。它的识别能够为自动句法分析、机器翻译系 统提供有力的支持。如对于句法分析而言,最长名词短语内部 结构比较复杂,几乎涉及了汉语所有的词类和句法结构,如果 能够识别出句子中所有的最长名词短语,那么计算机就能较好 地构建出句子的句法树或森林。以往的研究表明,最长名词短 语识别对于结构长度较为敏感,长度大于等于 5 的复杂最长名 词短语的识别精度一般要比简单最长名词短语低 16 个百分 点;并且复杂定语规定的左边界识别难度远远大于右边界[1]。
dePMNP 的下文特征的分布规律与上文有所不同,不仅表 现在邻接关系中,在与局部下文的共现关系上也有所体现。前 者如“是”等动词经常出现在 dePMNP 下文一元邻接词位置 R1 上;后者如“是”之前有时会加上一些副词,表达程度的不同或 委婉的语气等,使得“是”后退到下文二项共现词位置 RC2 上, 如“最令人喜爱的还是”。造成这种情况的有两种因素:(1) dePMNP 常位于主语位置上,R1 位置上也常常出现动词;(2)汉 语中存在一条语法规则:动词可以受副词等语言成分修饰。下 面就从下文一元邻接词集合 R1Set、二项共现词集合 RC2Set 及 位于前的修饰词三个方面讨论 dePMNP 的下文特征。
文献[2]将“的”划分为副词性语法单位的后附成分“的 1”,形 容词性语法单位的后附成分“的 2”,名词性语法单位的后附成分 “的 3”。然而“,的 2”和“的 3”的区分有时并不十分明晰。如“更+A+ 的”中“的”应该是“的 2”,但有的形式却能出现在主语或宾语的 位置上指称事物,如“我要更好的。”文献[3]区分了表述功能的词 汇层面和句法层面,在此基础上把“的”看成是词汇层面的“饰词 标记”,上述“更好的”则是该短语在句法层面的指称化。
从标注了 dePMNP 的训练语料中提取出 dePMNP 的邻接 成分及共现成分,形成各自的成分集合,进行统计分析,发掘 dePMNP 的上下文特征,从而制定合理的识别方案。 3.2.1 上文特征
上文特征主要研究某一语言成分的上文(左部)线性关系, 以期寻找到该成分的边界区分条件。从词语和语义两个角度观 察边界词内部的分布比例。L1Set 中共出现 80 个词型和 734 个 词例,词型的频次分布相当集中,出现频次排在 L1Set 集合前两 位的是“是”,“#”,其中“是”出现 344 次,句首标记词“#”出现 248 次,两者占据了 80%以上的比例。
相对于 R1,特征项在 RC2 上的分布要稀疏得多,主要表现 为一些谓词性的语言成分(词语)。把这些能够同时出现在 R1 和 RC2 位置上的边界特征称之为强特征 f,f 主要由动词,以及 形容词充当,主要有:是,有。
从语义上看,L1Set 的语义频次分布更为集中。充当 dePMNP 边界词的主要有“是非类”“,像如类”以及连接词类、句首标记词等:
“是非”类:是,正是,总是,说是,而是,乃是,但是,并非, 非,凡,所谓
“像如”类:像,如,正如,有如,不如 由此,在识别 dePMNP 的左边界过程中可以有两种选择: (1)利用词型参与统计;(2)利用词型的语义类参与统计。该文 选择前者,因为同一个语义类中的不同词型作为边界时也有分 布概率上的差别,利用词型参与统计有利于分辨这一点。 从边界词的概率分布来看,L1 位置上的边界词概率分布极 不均匀,“是非”类“,像如”类等语义类都有较高的分布水平。但
是,大多数其他类别的边界词都处于较低的分布水平,这为左 边界的识别带来了一定的难度。
以上的分析和讨论建立在能够判别当前位置上存在一个 dePMNP 或不存在 dePMNP 的基础上。然而在语料中,dePMNP 与含“的”字偏正结构的最长名词短语(deSMNP)的形式区分是 模糊的,都以 de 为标志。如何区分 dePMNP 与 deSMNP,希望在 右边界处找到答案,因为 dePMNP 与 deSMNP 右边界必然是不 一致的,识别出 dePMNP 的右边界 de,也就等于判定了当前位 置存在一个 dePMNP。 3.2.2 下文特征
摘 要:以“的”字结构为核心的最长名词短语是汉语最长名词短语的一个特殊子类。以该短语的自动识别为基础重新分化了汉语 MNP 的识别任务。在考察其结构和分布特征的基础上,提出“先识别右边界,识别成果参与左边界识别”的策略,并使用边界分布 概率模型分治了左右边界。实验基于 85 万字的新闻语料上进行训练,并在 42 万字的同质语料上进行了开放测试,取得了 80.63% 的正确率和 75.68%的召回率。 关键词:最长名词短语;“的”字结构;识别;浅层句法分析 DOI:10.3778/j.issn.1002-8331.2010.18.044 文章编号:1002-8331(2010)18-0138-04 文献标识码:A 中图分类号:TP391
“的”字结构的参与方式有两种,一种是参与最长名词短语 修饰语的构成,一种是参与最长名词短语句法核心的构成。该 文将研究第二类最长名词短语的识别问题。
2 以“的”字结构为核心的最长名词短语的界定
以“的”字结构为核心的最长名词短语(deP最长名词短语。 “的”字结构(deP)的定义是界定该短语的关键。
复杂最长名词短语识别精度较低的原因值得进一步考虑, 从语法上说,复杂最长名词短语之所以复杂是因为:(1)汉语缺 乏形态标记,词类和句法成分不是一一对应的,如动词既能作 述语,又能作定语,可造成动词宾语位上的最长名词短语左边 界模糊;(2)语法递归性,如定语可以由复杂句法结构充当。两 者的合力使问题更为突出,特别是“的”字短语参与构成的最长 名词短语,几乎容纳了所有的词类和句法结构,而这部分最长 名词短语的长度也是较大的。
138 2010,46(18)
Computer Engineering and Applications 计算机工程与应用
以“的”字结构为核心的最长名词短语识别研究
钱小飞 QIAN Xiao-fei
中国传媒大学 文学院,北京 100024 School of Chinese Language and Literature,Communication University of China,Beijing 100024,China E-mail:qierflying@
QIAN Xiao-fei.Recognition of MNP with“De-Phrase”puter Engineering and Applications,2010,46(18):138-141.
Abstract:The MNP with “De-Phrase”core is a special subclass of MNP.The identification of the phrase in this paper gives a new subsumption to the task of Chinese MNP recognition.The paper first analyzes the distribution and the structure feature of the phrase,then it advances a strategy of “Identify the right boundary first,then identify the left one”.Furthermore,it adopts the method“Boundary Distribution Probability”to recognize the phrase.A corpus(about 0.85 million Chinese Characters) of news is used for the automatic identification training and anothe(r about 0.42 million Chinese Characters) is used for test,and the experi- ment achieves 80.63% in precision and 75.68% in recall. Key words:Maximal Noun Phrase(MNP);De-Phrase;identification;shallow parsing
表 1 句法分布考察框架
结构名称 主谓结构 动宾结构 介宾结构 述补结构 述“得”补结构
直接成分 1 主语 述语 1 述语 3 述语 2 述语 2
直接成分 2 谓语 宾语 1 宾语 2 补语 1 补语 2
结构名称 定中结构 定“的”中结构 状中结构 状“地”中结构
-
直接成分 1 定语 1 定语 2 状语 1 状语 2 -
直接成分 2 中心语 1 中心语 1 中心语 2 中心语 2
-
依据这个标准考察发现,dePMNP 主要出现在主语和宾语 1 的位置上,而在述补结构,状“地”中结构等结构中的出现概 率几乎为零见表 2。
表 2 dePMNP 句法分布考察
统计指标
频次/例 比例(/ %)
主语 41
39.05
句法位置
宾语 1 宾语 2 定语 1
句法分布以短语所在的句法结构作为考察其句法功能的 依据,提供了从外部观察短语特征的窗口。文献[4]为实词分类
作者简介:钱小飞(1981-),男,博士研究生,主要研究领域为计算语言学、汉语语法学。 收稿日期:2008-12-23 修回日期:2009-03-13
钱小飞:以“的”字结构为核心的最长名词短语识别研究
R1 作为下文特征的典型分布位置,可以在熵值中得到验 证,R1 上的信息熵为 3.25,远小于 RC2 上的 6.30。R1 上的这种 确定性同样只能解释为受到某种句法因素的影响,其中包含了 更多的特征项。出现频次排在 R1Set 集合前三位的是“。”, “,”, “是”。其中“。”出现 235 次, “,”出现 201 次,“是”出现 118 次, 三者占据了 75%以上的比例。
生成语法学中的“的”字结构

每个结构 ( 最多) 只有两个直接成分 ;核心 ( 畴)不 是原子成 分 ,而是特征 集 的复 合体 ;每 范
个结构都有可能被另一核心进行扩展 ,成为另一 核心 的补 足语等 。本 文根据该 理论 和 “ 的” 字 结构的句法语义行 为 ,论证 了 “ 的”为名词性功能范畴 ,并成为句 法核心的可能性。 [ 中图分类号 ]H g [ o 文献标识码]A [ 文章编号 ]17 —50 (0 6 4—04 0 6 1 3 6 20 )0 0 9~ 9
维普资讯
暨南大学华文学院学报 20 年第 4 06 期
生成 语 法 学 中的 “ ’字 结构 ① 的’
熊仲 儒
( 安徽师范大学文学 院,安徽 ,芜湖 2 10 ) 4 0 0
[ 关键词 ]生成语法学 ;短语 结构理论 ;向心性 ;的字结构 [ 摘 要 ]生成语 法学 中的短 语结构理 论认为 每个句 法结构都有 核心 ,而且 只有一 个核心 ;
t n ,t i a e r vd s e ie c s t rv ’ p s i l h a tt sa d i o n l e tr . i s h sp p rp o ie vd n e o p o e d S o sb e e d s u t n mi a au e o e a n s f
另一核 心 的补 足语 ;等 等 。本文 将 根据 生 成语 法 学 中的 短语 结 构 理 论探 讨汉 语 “ ” 的句 的
法地位 。文章分 4 个部分来写 ,第一部分从 “ 可能的短语结构规则” 的角度将 “ 的”确定 为核心 ,并从特征继承的角度将 “ 的”确认为名词性的功能范畴;第二部分从结构 的双分 枝的角度论证了 “ 的”为功能性核心成分 ;第三部分从句法核心的多功能性论证了 “ 的”
朱德熙先生:一个小小的“的”字,牵动着汉语语法的全局,耗尽了先生毕生的心血
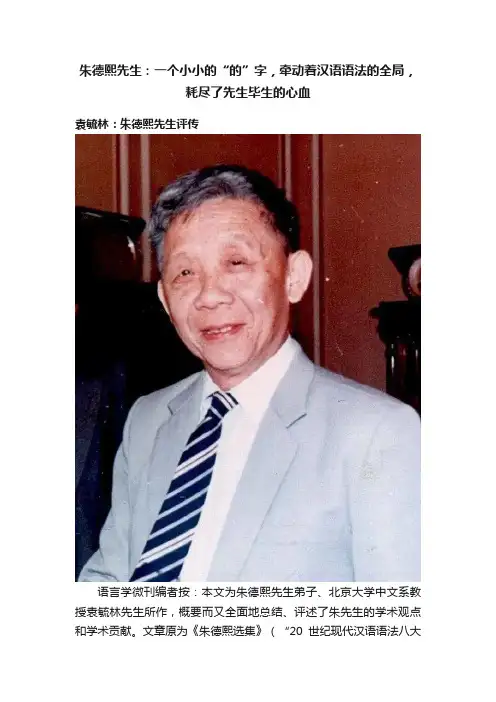
朱德熙先生:一个小小的“的”字,牵动着汉语语法的全局,耗尽了先生毕生的心血袁毓林:朱德熙先生评传语言学微刊编者按:本文为朱德熙先生弟子、北京大学中文系教授袁毓林先生所作,概要而又全面地总结、评述了朱先生的学术观点和学术贡献。
文章原为《朱德熙选集》(“20世纪现代汉语语法八大家”丛书,季羡林主编,东北师范大学出版社,2001年)一书的序言,后改写作为《朱德熙文选》(袁毓林、郭锐编选,北京大学出版社,2010年)一书的前言。
本次刊发,采用《朱德熙文选》中的版本。
来源:语言学微刊(微信公号)一、艰难时世多彩人生①朱德熙先生,1920年12月3日生,江苏省苏州人。
1939年,朱先生考取昆明西南联合大学物理系,第二年转入中文系学习。
受到了罗常培、唐兰、陈梦家等教授的教导和赏识,学问进步很快。
期间休学两年,延至1945年毕业。
毕业后,先生曾在昆明中法大学中文系任教,并加入了中国民主同盟。
1946年由闻一多先生延揽,去清华大学中文系任教。
1952年,因院系调整,先生入北京大学中文系工作,并应邀赴保加利亚索菲亚大学任教,1955年回国,此后他一直在北京大学中文系工作,并于1979年晋升为教授。
朱德熙先生先后担任过北京大学中文系副主任,北京大学计算语言学研究所所长,北京大学副校长兼研究生院院长,中国语言学会副会长、会长,世界汉语教学学会会长兼《世界汉语教学》主编,中国古文字研究会理事,国务院学位委员会委员,国家语言文字工作委员会委员,国务院古籍整理规划小组顾问,《中国大百科全书》总编辑委员会委员,第五、六届中国民主同盟中央委员会委员,第六、七届全国人民代表大会代表,第七届全国人民代表大会常务委员会委员、文教委员会委员等职。
朱德熙先生以其精湛的汉语语法和古文字方面的研究成果而蜚声于国内外的汉语语言学界,除了保加利亚之外,还先后赴美国、法国、泰国、印度、埃及、香港、新加坡、澳大利亚等国家和地区讲学、合作研究或出席国际会议。
_的_和_的_字结构

将“的 ”一分为三的做法从一开始就极具争议 , 支持的和反对的都大有人在 (吕叔湘 1962; 陆俭明 1963; 言一兵 1965; 季永兴 1965; 石毓智 2000; 陆丙甫 2003) 。朱德熙则 坚持自己的观点 , 并且不断地完善提高这一分析 (朱德熙 1966) , 进一步将由谓词性成分构 成的那些“的 ”字结构一分为二 (朱德熙 1983) 。一种像例 ( 2)中“吃的 、穿的 ”那样 , 可以独 立使用 , 而且表示一种事物 , 是表示“转指 ”的 ; 还有一种像“开车的 (技术 ) ”那样 , 不能独 立用来表示事物 , 只能表示动作 , 用来修饰名词 , 也就是所谓的表示“自指 ”。
核心是生成语法常用的概念 , 与通常所说的中心语有些相似 , 但两者的句法地位不完全 相同 , 所涵盖的成分也不尽相同 。传统意义上的中心语是个广义的概念 , 可以是任何句法成 分 。在“白蚁 ”之类的定中复合词里 , 中心语是个黏着语素 ; 在“白菜 ”这种复合词里 , 中心 语则是个词 ; 而在“我昨天买的那棵大白菜 ”这样的定中短语里 , 中心语则是个名词性短语 。 在形式句法的框架里 , 例 (4a)中短语的核心是个狭义的概念 , 一定具有相当于词的句法地 位 , 也就是生成句法里的 X0 。当然 , 生成句法中的 X0并不限于传统意义上的词 , 还可以是 句法结构中一些具有类似地位的成分 , 即所谓的功能性成分 , 如体貌 、时态 、语态等 。核心 是短语中最重要的部分 , 整个短语的句法地位取决于核心的性质 , 以动词 V 为核心的是动 词短语 VP, 以名词 N 为核心的是名词短语 NP。核心也可以是虚词 , 因此以介词 P为核心的 就是介词短语 PP。核心还可以是所谓的功能性成分 , 如以体貌为核心的体貌短语 A spP等 。
汉语最长名词短语的自动识别

汉语最长名词短语的自动识别*周强孙茂松黄昌宁智能技术与系统国家重点实验室清华大学计算机科学与技术系,北京100084摘要:本文通过对包含5573个汉语句子的语料文本中的最长名词短语的分布特点的统计分析,提出了两种有效的汉语最长名词短语自动识别算法:基于边界分布概率的识别算法(算法1)和基于内部结构组合的识别算法(算法2)。
实验结果显示,算法2的识别正确率和召回率分别达到了85.4%和82.3%,取得了较好的自动识别效果。
关键词:最长名词短语,边界识别,句法分析。
1 引言在自然语言句子的理解过程中,能否准确地识别其中的名词短语(np)起了很重要的作用。
按照认知科学的观点,人类必须首先识别、学习和理解文本中的实体(entity)或者概念(具体的或抽象的),才能很好地理解自然语言文本,而这些实体和概念大都是由文本句子中的名词短语所描述的。
因此,如果我们掌握了文本中的名词短语,就可以在很大程度上把握文本所表达的主要意思。
从组成结构上看,句子中的名词短语可分为以下三类:1) 最短名词短语(mNP):即不包含其他任何名词短语的名词短语;2) 最长名词短语(MNP):即不被其他任何名词短语所包含的名词短语;3) 一般名词短语(GNP):所有不是mNP和MNP的名词短语。
从mNP到GNP再到MNP,自动识别的难度是在不断增加的。
而在自然语言处理领域,MNP的自动识别具有更为重要的意义。
因为我们一旦很好地识别出了句子中所有的MNP,就可以很方便地把握句子的整体结构框架,从而很快构建出句子的完整句法树(森林)。
正是认识到了这一点,近几年来,许多研究人员在MNP的自动识别方面进行了许多有益的探索,提出了一些行之有效的识别方法。
在英语方面的工作主要有:1) Church的简单名词短语抽取器[1],利用概率矩阵信息来确定句子中np的起始和终止位置。
2) Bourigault的术语抽取器LEXTER[2],通过构造两个阶段的自动分析器发现文本中的术语(即部分MNP)3) Voutilainen的MNP获取工具:NPTool[3],利用两种有限状态分析机制(NP_否定机制和NP_肯定机制)来发现文本中可能的MNP。
以“的”字结构为核心的最长名词短语识别研究

n w s b u t n t h a k o i e e MNP r c g i o . e p p r frt a ay e h i r u i n a d t e sr cu e f au e o h e u s mp i o t e ts f Ch n s o e o n t nTh a e s n lz s t e d si t n h t t r e t r f t e i i tb o u
摘
要: 的” 以“ 字结构为核 心的最长名词短语是 汉语最长名词短语 的一个特殊子类。以该短语 的 自动识别为基础 重新分化 了汉语
MN P的识别任务。在 考察其结构和分布特征 的基础 上 , 出“ 提 先识 别右 边界 , 识别成果参与左边界识别” 的策略 , 并使 用边界 分布
概率模 型分治 了左右边界。实验基 于 8 5万字的新 闻语料 上进行训练 , 并在 4 2万字的同质语料上进行 了开放测试 , 取得 了 8 . % 06 3
meh d “ o n ay Dit b t n Po a it” t rcg i h h aeA c ru (b u .5 miin hn s C aa tr )o e s s to B u d r s iui rb bly o e o nz te p rs . op s a o t0 8 lo C ie e h rce r o i e l s f n w i
E- al q efyng 1 .o m i: i r i @ 63c n l
QI N io fi e o nt n o A X a - e. c g i o fMNP t “ e P r s ”c r . o ue n i e r g a d A pia o s 2 1 , 6 1 )1 8 1 1 R i h D - h a e o e mp tr E gn e i n p l t n , 0 0 4 ( 8 :3 - 4 . C n ci
基于规则的英语名词短语结构自动识别研究

Re s e a r c h o n Aut o ma t i c Re c o g n i t i o n o f No u n Phr a s e S t r uc t u r e Ba s e d o n Ru l e s
Ke y wo r ds: ul r e s;Eng l i s h no u n p h r a s e s ;p hr a s e s t uc r t u r e;a u t o ma t i c r e c o g ni t i o n;c o r p u s
名 词短 语 是 英 语 句子 的核 心组 成 部 分 , 然 而 不 同名词 短语类 型 的结构 用法 及其 在 句子 中所作 成 分 的复杂 性一 直 困扰 着英 语 的机 器识 别 技术 。基本 名
作者简介 : 章忠宪( 1 9 6 3 一 ) , 男, 安徽安庆人 , 漳州职业技术学院计 算机工程 系副教授 , 硕士 , 主要从事人工智 能研究 。
第2 9卷 第 7期
章 忠宪 : 基于 规则 的英语 名 词短 语结 构 自动识 别研 究
・ 7 1・
串在逻 辑上 可 能发生 的各种 情 况 , 即 改变 、 减 少 和 增 加, 总之都是 一种变 化。同化规则 属于转 换规则 。
s e ma nt i c c o l l o c a t i o n,r e v e a l s t he r e l a t i o n s h i p b e t we e n t h e n o u n p h r a s e t y p e a n d i t s c o mp o s i t i o n i n t he s e n t e n c e,o b v i o us l y i mp r o v e s t h e a c c u r a c y o f n o u n p h r a s e r e c o g n i t i o n .
“的”字短语的界定及其主要特点
(11) 他和骆驼都是·逃·出·来·的。 (老舍《骆驼祥子》)
( 12) 这儿·有·的是二十世纪的技术、机械、体 制和对这种体制忠实服役的十六世纪封建制度
“的”在“的”字短语中也是一种标志[ 4 ]。《提要》等“省
上后反而显得不简洁。例如 (例中[ ]里的内容为“添 “的”字短语不是“省去名词”的问题, 而是没有必要用
补”上的名词中心语) :
上名词 (中心词)。
( 8) ·他·满·意的[ 原因 ]是我居然告饶, 承认了 国 民党, 而·我·要·当·众·宣·布·的 [ 原因 ]却是“没领过 党证”这一事实。
(6) ·做·夜·班·的有·做·夜·班·的难处。 (引自张斌主编《现代汉语精解》)
编的《现代汉语》, 吕冀平 (1993 年) 主编的《汉语语法 基础》, 吴桂海、鲍庆林 (1992 年) 主编的《语法修辞新
(7) 那孩子·老·王·家·的, 这孩子·老·李·家·的。 例 (1) 的“莲灰色”是名词, 例 (2) 的“干”是动词,
的”(其中的“×”可以是名词、动词、形容词、人称代词 “的、底、地、得”的分合》中就指出:“我以为, 与其说
或短语) , 相当于一个名词,“具有称代人或事物名称 ‘的’是代名词, 来多建一条文法上的规则, 倒不如看
的作用”[1]。 在具体使用中, 它具有名词的语法功能, 主要用作句子的主语、宾语, 也可作定语、状语或谓 语。对“的”字短语的探讨, 虽始于 30 年代, 但由于 “的”字短语本身的复杂性, 所以几十年来各种语法著 作和各类现代汉语教材对“的”字短语所作的解释很
点。如: 胡裕树 (1981 年) 主编的《现代汉语》这样解 释:“助词‘的’也可以附着在词或词组后边, 合起来成
基于归约的汉语最长名词短语识别方法
模 型 观 察 窗 口受 限 的 矛盾 。 开放 测 试 取 得 了 8 8 . 6 8 的正 确率和 8 9 . 2 1 的 召回率 ; 归 约 方 法 全 面提 升 了识 别 性
能, 特 别是 将 多词 结 构 的 调 和 平 均 值提 高 1 , 优化幅度达 6 以上 , 并且 对 长距 离 复 杂 结 构 有 着 更好 的识 别 效 果 。
wi n d o ws i o d e l s .Th e e x p e r i me n t i n d i c a t e s a g o o d p r e c i s i o n o f 8 8 . 6 8 % a n d a r e c a l l o f 8 9 . 2 1 .Th e r e —
关 键 词 :最 长 名 词 短 语 ; 识 别; 归约 ; 基 本 名 词 短 语
中 图分 类 号 :TP 3 9 1 文 献 标 识 码 :A
C h i ne s e Ma x i ma l No u n Ph r a s e Re c o g n i t i o n Ba s e d o n Re d u c t i o n
duc t i o n me t h od c om p r e h e ns i v e l y i mp r ove s s ys t e m pe r f or ma nc e,e s pe c i a l l y i t i mp r ov e s F1 一 s c o r e b y 1
汉语论文《“字”和汉语研究的方法论【汉语言文学论文】
汉语论文《“字”和汉语研究的方法论【汉语言文学论文】汉语论文《“字”和汉语研究的方法论语义型语言和语法型语言在结构原则上的差异,我们曾进行过一些具体的讨论(徐通锵,1991),但要真正弄清楚每一种类型的语言结构,还需要弄清楚语言结构单位的性质,因为它凝聚着语言结构的基本特点。
汉语是语义型语言,它的基本结构单位是“字";印欧系语言是语法型语言,它的基本结构单位是“词"。
不同语言之间虽然可以找出一些共同的普遍特征,但基本结构单位不能“张冠李戴"。
近百年来的汉语研究,特别是其中的语法研究,把“字"逐出语言而代之以词和语素,这在方法论上无异于“张冠李戴",使汉语的研究出现了一种特有的“印欧语的眼光"。
要摆脱这种“眼光"的束缚,还得从“字"开始,研究它与语言结构的关系,就汉语论汉语,从中总结相应的理论和方法,以便为汉语的研究探索一条新的途径。
一、“字"和汉语结构的基础语言是现实的编码体系。
一种语言如何将现实编成“码",使之成为语言的基本结构单位,这与该语言社团的思维方式有关。
印欧语社团的思维的基本形式是概念、判断和推理,它的基本精神是抽象和推导,采用下定义的方法把一个个概念说清楚。
印欧系语言的结构基础与这种思维方式有密切的关系,大体的情况是:词对应于概念,句子对应于判断;概念要接受判断规则的支配,与之相应,词的结构要受特定句法规则的制约,具有能机械地适应句法位置的变化而变化的机制,即有特定的形式标志去表示结构单位之间的横向联系。
推理由于是由一个或几个已知的判断(前提)推出新判断(结论)的过程,语言编码的规则可能与它的关系远一点,而篇章结构的特点则与它的关系较为密切。
把印欧语的结构基础与概念、判断、推理的思维形式联系起来考察,人们可能不以为然,但只要看一看印欧系语言的语法理论的诞生和发展就可以清楚地了解这一论断的根据。
“的”字短语的界定及其主要特点
点。如: 胡裕树 (1981 年) 主编的《现代汉语》这样解 释:“助词‘的’也可以附着在词或词组后边, 合起来成
(3) 战士们怀着深切的爱, 把廊柱染成·红·的。 (魏巍《依依惜别的深情》)
为具有名词功能的‘的’字结构。”朱德熙 (1982 年) 说,“在现代汉语里, 谓词性成分转化为体词性成分的
语 法系统提要》(1984) (以下简称《提要》) , 提出些讨 不变。”《提要》更对“的”字短语作了比较详细的解释:
论意见, 以期引起人们深入讨论。
的字短语, 可以带助词“的”作名词的定语的
一、语法学界对“的”字短语的解说
各种词语, 很多可以省去名词, 构成的字短语, 用 来代替名词。
1. 关于什么是“的”字短语, 在语法学界主要有三 种 看法: 一是“省略说”, 二是“指 称 说”, 三 是“附 着 说”。“省略说”着眼于“的”字短语的来源,“指称说”着 眼于其功用,“附着说”着眼于助词“的”的使用特点。
[ 关键词 ] “的”字短语; 界定; 主要特点 [ 中图分类号 ] H 314 [ 文献标识码 ] A [ 文章编号 ] 100127623 (1999) 0320042206
“的”字短语 (又称“的”字词组,“的”字结构) 是现
2.“省略说”(又称“替代说”、“添补说”)。 这种说
代汉语所特有的一种常用短语。 其构成形式是“×+ 法可算是最早的说法。史存直早在 1937 年的论文《论
化为表示指称 (designation) 的 V P 了。 姚振武 (1996 的机械组合, 而是产生新义的似于化学反应的效果”。
年) 说,“的”字的使用, 使陈述转化为指称有了非常大 就语法功能说,“的”字短语相当于名词, 一般作主语