
流水线乘法器
流水线乘法器
一般的快速乘法器通常采用逐位并行的迭代阵列结构,将每个操作数的N位都并行地提交给乘法器。
但是一般对于FPGA来讲,进位的速度快于加法的速度,这种阵列结构并不是最优的。
所以可以采用多级流水线的形式,将相邻的两个部分乘积结果再加到最终的输出乘积上,即排成一个二叉树形式的结构,这样对于N位乘法器需要log2(N)级来实现。
一个8位乘法器,如图所示。
module mux_4(mul_a,mul_b,mul_out,clk,rst_n);
parameter MUL_WIDTH = 4;
parameter MUL_RESULT = 8;
input [MUL_WIDTH-1:0] mul_a;
input [MUL_WIDTH-1:0] mul_b;
input clk;
input rst_n;
output [MUL_RESULT-1:0] mul_out;
reg [MUL_RESULT-1:0] mul_out;
reg [MUL_RESULT-1:0] stored0;
reg [MUL_RESULT-1:0] stored1;
reg [MUL_RESULT-1:0] stored2;
reg [MUL_RESULT-1:0] stored3;
reg [MUL_RESULT-1:0] add01;
reg [MUL_RESULT-1:0] add23;
always @(posedge clk or negedge rst_n)
begin
if(!rst_n)
begin
mul_out <= 8'b0000_0000;
stored0 <= 8'b0000_0000;
stored1 <= 8'b0000_0000;
stored2 <= 8'b0000_0000;
stored3 <= 8'b0000_0000;
add01 <= 8'b0000_0000;
add23 <= 8'b0000_0000;;
end
else
begin
stored3 <= mul_b[3] ? {1'b0,mul_a,3'b0} : 8'b0;
stored2 <= mul_b[2] ? {2'b0,mul_a,2'b0} : 8'b0;
stored1 <= mul_b[1] ? {3'b0,mul_a,1'b0} : 8'b0;
stored0 <= mul_b[0] ? {4'b0,mul_a} : 8'b0;
add01 <= stored1 + stored0;
add23 <= stored3 + stored2;
mul_out <= add01 + add23;
end
end
endmodule。
加法乘法动态多功能流水线调度

实验报告学生姓名:学号:一、实验室名称:计算机学院计算中心二、实验项目名称:加法乘法动态多功能流水线调度三、实验原理:把加法和乘法流水线分开,完成乘法流水线后再进行加法流水线。
把一个乘法任务分成三个部分,然后同时执行多个任务以模拟指令的流水线调度。
三个步骤每同时完成一次任务执行总时间就加一,直到最后一个操作数进入流水线,此时加法流水线开始工作。
把一个加法任务分成四个部分,然后同时执行多个任务以模拟指令的流水线调度。
四个步骤每同时完成一次任务执行总时间就加一,直到没有任务时停止,看此时的时间与理论上的流水线调度时间的差距来判别程序是否成功模拟了流水线指令的调度。
四、实验目的:1、掌握加法乘法动态双功能指令调度的方式,2、理解静态多功能流水线和动态多功能流水线在调度模式上的区别,3、了解指令并行度上限的概念。
五、实验内容:(一)给定要执行的任务和执行该任务的流水线结构流水线的调度方式能够提高任务的并行度,但是针对不同的任务,由于相关的存在,其并行度的提高是不一致的。
在开始程序设计前,我们首先要给定所要完成的任务:这里我们使用矩阵点积运算任务,∑=n1i aibi 。
n 的数值可以变化,通过变换n 的值用同一程序进行多次模拟。
给定流水线:流水线分五个步骤,每个步骤的执行时间均为一个单位时间;其中1-2-3-5组成加法流水线,1-4-5组成乘法流水线。
加法和乘法可以同时执行 (二)对任务进行分解动态多功能流水线不同于静态多功能流水线,流水线中同时只能有多种种操作的指令,因此不能将其划分为两个相互独立的加法流水线和乘法流水线。
我们考虑设计一个加法乘法混合运算器,加法4步,乘法三步,在送入源数据时应指明执行哪种运算。
(三)任务分解程序模拟的思路在实验二的基础上。
我们对设计进行变更。
加法乘法有一个类实现,称之为加乘法类。
乘法的数据源为两个队列,加法的数据源为一个队列。
加法器的源数据队列初始为空,乘法器的源数据队列初始分别放入A1-An 和B1-Bn 。
一种支持无符号数的流水线乘法器
1 引 言
乘 法 器 是 C U 中一个 重 要 的基 本运 算 部 件 。 P 所
有 的乘 法 器 都 有 同样 的 处 理 过 程 ,首 先 生 成 部 分
通用 C U的要求 。在本文的乘 法器设计 中, P 通过在 Boh算 法 中增 加 一些 简 单 的逻 辑 ,不 但 简 化 了部 ot 分积 的符 号扩 展 ,而 且可 以使用 同样 的 电路来 处 理 有符号数和无符号数乘法。同时 ,该乘法器作为某 C U的一 部 分 ,为 了满 足 总体 时延 的要求 , Wa P 在 l —
性 能 可 以采 用 树 形 结构 把 这 N个 部 分 积 并行 相加 ,
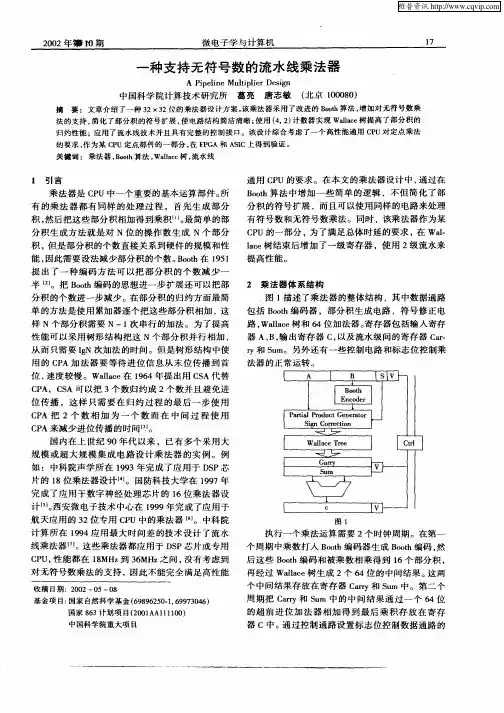
图 1 述 了乘 法器 的 整体 结 构 ,其 中数据 通 路 描
包 括 B o 编 码 器 ,部 分 积 生成 电路 ,符 号修 正 电 ot h 路 , lc 树 和 6 加 法器 。 Wal e a 4位 寄存 器包 括 输 入 寄存 器 A、 输 出寄 存 器 C, B, 以及 流水 级 间 的寄存 器 C r a- r 和 S m。另 外还 有 一 些控 制 电路 和标 志位 控 制乘 y u
位传播 ,这样只需要在 归约过程 的最后一步使用 C A 把 2个 数 相 加 为 一 个 数 而 在 中 间 过 程 使 用 P C A来减少进位传播 的时间【。 P 3 】 . 国 内在 上世 纪 9 0年代 以来 ,已有 多 个 采 用 大 规模或超 大规模集成 电路设计乘 法器 的实例 。例
航 天应 用 的 3 专 用 C U中的乘 法 器 [。 中科 院 2位 P 6 1 计 算 所 在 19 9 4应 用 最 大 时 间 差 的 技术 设 计 了 流水 线 乘 法 器 【。这 些 乘 法器 都应 用 于 D P芯 片或 专用 7 】 S
基于FPGA的流水线单精度浮点数乘法器设计

基于FPGA的流水线单精度浮点数乘法器设计彭章国;张征宇;王学渊;赖瀚轩;茆骥【摘要】针对现有的采用Booth算法与华莱士(Wallace)树结构设计的浮点乘法器运算速度慢、布局布线复杂等问题,设计了基于FPGA的流水线精度浮点数乘法器.该乘法器采用规则的Vedic算法结构,解决了布局布线复杂的问题;使用超前进位加法器(Carry Look-ahead Adder,CLA)将部分积并行相加,以减少路径延迟;并通过优化的4级流水线结构处理,在Xilinx(R)ISE 14.7软件开发平台上通过了编译、综合及仿真验证.结果证明,在相同的硬件条件下,本文所设计的浮点乘法器与基4-Booth算法浮点乘法器消耗时钟数的比值约为两者消耗硬件资源比值的1.56倍.【期刊名称】《微型机与应用》【年(卷),期】2017(036)004【总页数】5页(P74-77,83)【关键词】浮点乘法器;超前进位加法器;华莱士树;流水线结构;Vedic算法;Booth 算法【作者】彭章国;张征宇;王学渊;赖瀚轩;茆骥【作者单位】西南科技大学信息工程学院,四川绵阳621010;西南科技大学信息工程学院,四川绵阳621010;中国空气动力研究与发展中心,四川绵阳621000;西南科技大学信息工程学院,四川绵阳621010;西南科技大学信息工程学院,四川绵阳621010;西南科技大学信息工程学院,四川绵阳621010【正文语种】中文【中图分类】TP331.2浮点乘法器(eFloating Point Multiplier,FPM)是数字信号处理(eDigital Signal Processing,DSP)、视频图像处理以及信号识别等应用邻域重要的运算单元。
尤其是在视频图像处理领域,随着对高速海量图像数据处理的实时性要求逐渐提高,设计一种具有更高速率、低功耗、布局规律、占用面积小和集成度高的浮点乘法器极其重要。
阵列乘法器是采用移位与求和的算法而设计的一种乘法器[1]。
流水线乘法累加器的混合输入设计

1乘法 累 加器 的 基本 原 理 在二 进制 乘法 中,乘法 的 基本算 法 常可用 所谓 的一 位乘 法和 两位 乘法 进 行 。进 行这 种乘 法运 算时 ,通 常分别 用 乘数 的一位 或 二位 与被 乘数 相乘, 再 把 部 分积 加起 来 。移 位相 加 是最 基 本 的乘 法器 设 计 思路, 实现起 来 较 为简 单 。 它的设 计 思想 就是 根据 乘数 的 每一 位 是否 为 1 行计 算, 若 为 1则将 进 被 乘数 移位 相加 。 这 种方 法硬件 资源耗 用较 少 。 以 8位移 位相 加乘 法器 为 例 , 其 实现 过 程 如下 。 先对 乘 数的最 低位 进行 判 断是否 为 l 如 果 为 l 则把 被乘 数相 加, 然 。 , 后 被乘 数 向高位 移 1 , 乘数 向低 位移 1 : 如 果为 0 则 被乘 数不 相加 而 位 位 , 仍 然 向高位 移 1 , 乘数 向低 位移 1 。 如 此循 环判 断 8次, 结束运 算 。 位 位 纯组 合逻 辑 电路 构成 的乘 法器 虽 然工 作速 度 比较 快 , 但过 于占用 硬件 资 源 , 于实现 多 为乘 法器 : 难 因此 本课 题将 介绍 由 8位加 法 器 构成 的来 设 计流 水 线乘法 累加 器 的混合 输入 , 这种 设计 能够 比较 方便 实现 两个8 二进 制数 的 位 乘 法运算 。 2设 计 思路 用 V D 文 本输 入设 计方 法, 计一 个 8 流水 线乘 法累 加器 的混 合输 入, HL 设 位 进行系统 仿真 。 算 术流 水线 主要 是 指运 算操 作步 骤 的并行 。如流水 乘 法器 , 例如 :T R SA~ 10 4 0 为 级流水 运 算器, I A C为 8 T—S 级流 水运 算器 , R Y 1 l 级 流水 运算 器 CA 为 4 等: 设 l 先 6位初 始和 为零 , 1 键 和键 2分 别输 入 乘数 的低 4位 、高 4位 : 3 键 和键 4输入 被 乘数 的 低 4位 、 高 4位 。由波形 可 见, 1 c c o k的第 一 上升 沿 个 由锁 存器输 入 的乘数 和被 乘数 为 0 所 以在 第二 个上 升沿 后得 到结 果 为 S O× , 02 + 3× 1= 4 , 53 5 而第 三个 上升 沿后 得 到结 果为 S 2 3× 1+ 3× 1=9 , 第 52 56 0 而 四个上 升沿 后得 到结 果为 S 2 : 3× 1+ 6× 2 :8 , 此 等等 。如此 往 复, 51 1 6 1如 直 至 8个时 钟脉 冲 后, 流水 线 乘 法累 加 器 过程 终 止 。 2 设计 文件 2 1顶 层原 理 图 如图 l 所示 , l 由 6位加 法器 (D E 1 B 、8 锁存 器 (A C 8 1 和 调入 ADR6) 位 L T H )
串行乘法器与并行乘法器的设计

state <= s1;
end
end
s2: begin
result <= P;
input [7:0] x, y;
output [15:0] result;
reg [15:0] result;
parameter s0 = 0, s1 = 1, s2 = 2;
reg [2:0] count = 0;
state <= s0;
end
default: ;
endcase
end
endmodule
module multi_CX(clk, x, y, result);
reg [1:0] state = 0;
reg [15:0] P, T;
reg [7:0] y_reg;
always @(posedge clk) begin
case (state)
s0: begin
input clk;
input rst_n;
output [7:0] mul_out;
reg [7:0] mul_out;
reg [7:0] stored0;
reg [7:0] stored1;
下面是用Verilog HDL实现一个4位的流水线乘法器:
Java代码
module multi_4bits_pipelining(mul_a, mul_b, clk, rst_n, mul_out);
input [3:0] mul_a, mul_b;
法器的Verilog HDL实现
博客分类: FPGA
Radix-16 Booth流水线乘法器的设计

p e so ra .Byo t ii gt ec mp e so ra n h 4 bCL ( a r -o k h a )a d ri rs in a r y p i zn h o r sin a r ya d t e6 一 A c ry lo a e d d e m n
De i n fRa i 一 6 Bo t pe i e M u tple s g o d x 1 o h Pi ln li i r
Lin e g ,S a h b a a g F n h oZ i io ,Lin i a gJn
( . c o l f lcr nc n no main E gn ei g i nJa tn ie s y Xi n 7 0 4 , ia 1 S h o e to isa d I f r t n i e r ,X i o g Unv ri , 1 0 9 Chn oE o n a o t a 2 S h o f c a ia E gn e ig Xi n J oo gUn v ri ,X n 7 0 4 , ia .col o Me h nc l n i ern , i t n i es y i 1 0 9 Chn ) a a t a
维普资讯
第4 0卷
第1 0期
西
安 交 通
大
学
学 报
Vo . 0 N 1 14 o 0 Oc. 2 0 t 06
20 年 1 06 0月
J OURNAL OF XIAN I JAOTONG UNI VERS TY I
Ra i一 B oh流 水 线 乘 法 器 的设 计 dx1 o t 6
梁峰 ,邵志 标 ,梁晋
(. 1 西安交通大学 电子与信 息工程学 院,7 0 4 , 10 9 西安 ;2 西安交通 大学机 械工程 学院 , 10 9 西安 ) . 704 ,
一种可重构的高速流水线乘法器
第 1 2卷 第 3期 2 0 年 6 月 07
文章 编 号 : 10 -2 9(0 7 0 -0 30 070 4 20 ) 30 3 -4
电路 与 系统 学报
J OURNAL OF CI RCUI TS AND YS EM S S T
=t + xt t t—Ⅳ + ma( , t ) t l2 _ () 4
I N DATA VALI D CL0CK
其 中 ma( , 3』 ) xt t t . 为Ⅳ部 分 中的 最 大延 时【 。 。2 .Ⅳ I J
公式 () = at, 3中 ∑mx 这样流水设计就有效地降低了乘法器 n
n -I
的 时延 ,提 高 了运 算速 度 。
3 1 逻 辑 设 计 .
两 比特 流 水 乘 法 器 流 水 结构 如 图 l 示 【3 输 出样 本 结 果 的 时钟 所 J】 ',
图1 流水结构乘法器逻辑图
SL 周 期 与 电路 的 时钟 周 期 相 同 。 E 当使用 流 水 乘 法 器 处 理 低 速信 号
3 高速可重构 流水 线乘 法器
本 节 将 介 绍 一种 高速 可 重 构 流 水 线 乘 法 器 ,它 不 仅 能 实 现 较 高 的 电路 频 率 ,还 具可 变 速 率 数据 。 通 常 电路 设 计 中 ,“ 水 ” 构 由于 其 高速 、 高 效 , 流 结 及低 输 入 电压 的特 点 ,在 乘 法 电路 的 设计 中受 到 广 泛 的应用 ,。
摘要 ;本 文针 对在 语音 、视频 等信 号处 理 中出现 的变速 率信 号处 理 ,提 出了一种 新 型的 高速 高 效可重 构流 水线乘
法 器 电路 ,并 在 02 哪 .5 工 艺条件 下对 电路进 行 了仿真 。该 电路 通过 控制流 水级 数处 理变速 信 号 ,可 有效地 节约 电路 资源 约 3 %,同 时可 保证频 率达 1 G 4 . Hz的高运 算速度 。 8 关键 词 ;可 重构 ;高速 ;乘法 器 ;流 水线
数字系统高级设计技术(第4讲)
流水线乘法器的结构图
对应的Verilog HDL代码
并行和流水线
--流水线设计
module top( input [7:0] a, input [7:0] b, input clk, output reg [15:0] y );
reg [7:0] a1,b1; reg [15:0] prod,prod1;
由此可见,在不提高系统运行频率的情况下,提高流水线
的级数将成倍地提高系统处理的效能。但是流水线的设计
也是有一定的限制的:
只有对那些能分成n个步骤完成,并且对每个步骤都需要固定相 同处理时间的操作来说才能采用流水线设计;
受硬件资源的限制,流水线的级数是有限制的; 对于存在处理分支预测流水线的设计(广泛应用于微处理器的设
采用流水线后,数据通道将会变成多时钟周期,所以要特别考虑 设计的其余部分,解决增加通路带来的延迟。
并行和流水线
--流水线设计
流水线基本结构是将适当划分的N个操作步骤串连起来。
流水线操作的最大特点是数据流在各个步骤的处理,从时间上看 是连续的;
其操作的关键在于时序设计的合理安排、前后级接口间数据的匹 配。如果前级操作的时间等于后级操作的时间,直接输入即可;
input [7:0] b2,
input [7:0] a3,
input [7:0] b3, output [17:0] y
对应的并行乘法器结构
);
assign y=a0*b0+a1*b1+a2*b2+a3*b3;
endmodule
并行和流水线 --并行设计
下图给出了实现该功能的并行结构。
通过使用多个乘法器,使得四个乘法运算可以同时进行。 但是这种速度的提高是以面积为代价的。
vhdl 四位流水线乘法器
实验二四位流水线乘法器一、实验目的1.了解四位并行乘法器的原理。
2.了解四位并行乘法器的设计思想和流水线的实现方法。
3.掌握用VHDL 语言实现基本二进制运算的方法。
二、实验内容与要求通过开关和键盘输入两组4BIT的二进制数据,按照二进制加法器原理进行加和,求出和及进位,并通过LED显示灯输出显示,完成编译、综合、适配、仿真、实验箱上的硬件测试。
三、实验原理流水线结构的并行乘法器的最大有点就是速度快,尤其实在连续输入的乘法器中,可以达到近乎单周期的运算速度。
流水线乘法器是组合逻辑电路实现无符号数乘法的方法上发展而来的。
其关键是在组合逻辑电路的基础上插入寄存器。
假如有被乘数A 和乘数B,首先用A 与B 的最低位相乘得到S1,然后再把A 左移1 位与B 的第2 位相乘得到S2,再将A 左移3 位与B 的第三位相乘得到S3,依此类推,直到把B 的所有位都乘完为止,然后再把乘得的结果S1、S2、S3……相加即得到相乘的结果。
需要注意的是,具体实现乘法器是,并不是真正的去乘,而是利用简单的判断去实现,举个简单的例子。
假如A 左移n 位后与B 的第n 位相乘,如果B 的这位为‘1’,那么相乘的中间结果就是A 左移n 位后的结果,否则如果B 的这位为‘0’,那么就直接让相乘的中间结果为0 即可。
带B 的所有位相乘结束后,把所有的中间结果相加即得到A 与B 相乘的结果。
在此基础上插入寄存器即可实现流水线乘法器。
四、实验平台(1)硬件:计算机、GX-SOC/SOPC-DEV-LABCycloneII EP2C35F672C8核心板(2)软件:Quartus II软件PIN_AF8 DATAOUT[4] LED4PIN_AE7 DATAOUT[5] LED5PIN_AF7 DATAOUT[6] LED6PIN_AA11 DATAOUT[7] LED7PIN_AE21 BCD[0] 数码管DP4BPIN_AB20 BCD[1]PIN_AC20 BCD[2]PIN_AF20 BCD[3]PIN_AE20 BCD[4] 数码管DP5BPIN_AD19 BCD[5]PIN_AC19 BCD[6]PIN_AA17 BCD[7]PIN_AA18 BCD[8] 数码管DP6BPIN_W17 BCD[9]PIN_V17 BCD[10]PIN_AB18 BCD[11]六、仿真截图七、硬件实现八、程序代码1---clkgen.vhdlibrary IEEE;-- 1HZuse IEEE.std_logic_1164.all;use ieee.std_logic_unsigned.all;entity clkgen isport (CLK : in std_logic;CLK1HZ: out std_logic);end entity;architecture clk_arch of clkgen issignal COUNT : integer range 0 to 50000000; --50MHZ -->1hz begin -- 50M/1=50000000 PROCESS(CLK)BEGINif clk'event and clk='1' thenIF COUNT= 50000000 thenCOUNT<=0;ELSE COUNT<=COUNT+1;END IF;END IF;END PROCESS;PROCESS(COUNT)BEGINIF COUNT= 5000000 THEN -- 1HZCLK1HZ<='1';ELSE CLK1HZ<='0';END IF;END PROCESS;end architecture;2—BCD-- 输出控制模块,把乘法器的输出转换成BCD码在数码管上显示、-- SCKZ.VHDlibrary IEEE;use IEEE.STD_LOGIC_1164.ALL;use IEEE.STD_LOGIC_ARITH.ALL;use IEEE.STD_LOGIC_UNSIGNED.ALL;entity BIN2BCD isport ( DIN: in std_logic_vector(7 downto 0); ---The input 8bit binaryBCDOUT: out std_logic_vector(11 downto 0)--输出显示, 已转换成BCD码);end entity;architecture arch of BIN2BCD issignal data2,data3,data4 :std_logic_vector(9 downto 0);-- 输出数据缓存signal hundred,ten,unit:std_logic_vector(3 downto 0);--signal bcdbuffer:std_logic_vector(11 downto 0);---2'1111_1001_11=999beginBCDOUT<= bcdbuffer;bcdbuffer(11 downto 8)<=hundred;bcdbuffer(7 downto 4)<=ten;bcdbuffer(3 downto 0)<=unit;get_hundred_value:process(data2)beginDA TA2<="00"&DIN;---get hundred valueif data2>=900 thenhundred<="1001";--9data3<=data2-900;elsif data2>=800 thenhundred<="1000";--8data3<=data2-500;elsif data2>=700 thenhundred<="0111";--7data3<=data2-700;elsif data2>=600 thenhundred<="0110";--6data3<=data2-600;elsif data2>=500 thenhundred<="0101";--5data3<=data2-500;elsif data2>=400 thenhundred<="0100";--4data3<=data2-400;elsif data2>=300 thenhundred<="0011";--3data3<=data2-300;elsif data2>=200 thenhundred<="0010";--2data3<=data2-200;elsif data2>=100 thenhundred<="0001";--1data3<=data2-100;else data3<=data2;hundred<="0000";end if;end process; ---get_thousand_valueget_tens_value:process(data3) begin---get tens placeif data3>=90 thenten<="1001";--9data4<=data3-90;elsif data3>=80 thenten<="1000";--8data4<=data3-50;elsif data3>=70 thenten<="0111";--7data4<=data3-70;elsif data3>=60 thenten<="0110";--6data4<=data3-60;elsif data3>=50 thenten<="0101";--5data4<=data3-50;elsif data3>=40 thenten<="0100";--4data4<=data3-40;elsif data3>=30 thenten<="0011";--3data4<=data3-30;elsif data3>=20 thenten<="0010";--2data4<=data3-20;elsif data3>=10 thenten<="0001";--1data4<=data3-10;else data4<=data3;ten<="0000";end if;end process; ---get_ten_valueget_unit_value:process(data4)begin--unit's orderif (data4>0) thenunit<=data4(3 downto 0);else unit<="0000";end if;end process;end arch;3 multi4b --------------------------------------------------------------------------------/ -- DESCRIPTION : Signed mulitplier:-- AIN (A) input width : 4-- BIN (B) input width : 4-- Q (data_out) output width : 8-- 并行流水乘法器--------------------------------------------------------------------------------/--10 × 9 = 90-- 1 0 1 0-- 1 0 0 1 =-- --------------- 1 0 1 0-- 0 0 0 0 --partial products-- 0 0 0 0-- 1 0 1 0-- -------------------- 1 0 1 1 0 1 0--parallel : process all the inputs at the same time--pipeline : use several stages with registers to implement it----关键思想,插入寄存器library IEEE;use IEEE.STD_LOGIC_1164.ALL;use IEEE.STD_LOGIC_ARITH.ALL;use IEEE.STD_LOGIC_UNSIGNED.ALL;entity multi4b isport ( CLK: in STD_LOGIC; ---system clockAIN: in STD_LOGIC_VECTOR (3 downto 0); ---one inputBIN: in STD_LOGIC_VECTOR (3 downto 0);-- the other inputdata_out: out STD_LOGIC_VECTOR (7 downto 0)---the result ---make sure the biggest value ,i,e. 1111x1111=1110_0001 can be held in the register );end multi4b;architecture multi_arch of multi4b issignal A,B :std_logic_vector(3 downto 0); --input register---registers to hold the result of the first processing---registers added to make use of pipeline, the 1st stagesignal A_MULT_B0: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B1: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B2: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B3: STD_LOGIC_VECTOR (3 downto 0);---register to hold the result of the multipliersignal C_TEMP : STD_LOGIC_VECTOR (7 downto 0);beginPROCESS(CLK,AIN,BIN)beginif CLK'EVENT AND CLK='1' THEN-- multiplier operand inputs are registeredA<= AIN;B<= BIN;-----------------Fist stage of the multiplier------------------here we get the axb(0),axb(1),axb(2),axb(3),i.e.partial products---put them into the responding registersA_MULT_B0(0) <= A (0) and B (0);----- multi 1 , get the a(0) and b(0), & put it into the register A_MULT_B0(0)A_MULT_B0(1) <= A (1) and B (0);A_MULT_B0(2) <= A (2) and B (0);A_MULT_B0(3) <= A (3) and B (0);--10 × 9 = 90-- 1 0 1 0-- 1 0 0 1 =-- --------------- 0 0 0 0 1 0 1 0-- 0 0 0 0 0 0 0 0 --partial products-- 0 0 0 0-- 1 0 1 0-- -------------------- 1 0 1 1 0 1 0A_MULT_B1(0) <= A (0) and B (1);A_MULT_B1(1) <= A (1) and B (1);A_MULT_B1(2) <= A (2) and B (1);A_MULT_B1(3) <= A (3) and B (1);A_MULT_B2(0) <= A (0) and B (2);A_MULT_B2(1) <= A (1) and B (2);A_MULT_B2(2) <= A (2) and B (2);A_MULT_B2(3) <= A (3) and B (2);A_MULT_B3(0) <= A (0) and B (3);A_MULT_B3(1) <= A (1) and B (3);A_MULT_B3(2) <= A (2) and B (3);A_MULT_B3(3) <= A (3) and B (3);end if;end process;--------------------Second stage of the multiplier---------------add the all the partial products ,then get the result of the multiplier C_TEMP<=( "0000" & A_MULT_B0 )+( "000"& A_MULT_B1 &'0' )+( "00" & A_MULT_B2 & "00" )+( '0'&A_MULT_B3 & "000" );--build a signal register output---输出寄存,利于实现流水data_out <= C_TEMP; --output registerend multi_arch;九、实验总结。
fpga中做乘法
fpga中做乘法
(实用版)
目录
1.FPGA 简介
2.FPGA 中实现乘法的方法
3.乘法器的设计与实现
4.FPGA 中乘法的优势与应用
正文
【FPGA 简介】
FPGA(现场可编程门阵列)是一种集成电路,用户可以编程其功能和逻辑。
FPGA 具有灵活性高、速度快、资源可重配置等特点,广泛应用于数字信号处理、通信、图像处理等领域。
【FPGA 中实现乘法的方法】
在 FPGA 中实现乘法有多种方法,常见的有:级联乘法器、流水线乘法器、二维阵列乘法器等。
【乘法器的设计与实现】
1.级联乘法器:将多个 1 位乘法器级联起来,实现多位数的乘法运算。
2.流水线乘法器:通过将乘法过程分为多个阶段,利用流水线技术实现高速乘法。
3.二维阵列乘法器:利用二维阵列结构,实现高效的大规模乘法运算。
【FPGA 中乘法的优势与应用】
1.并行处理:FPGA 可以同时执行多个乘法操作,大大提高运算速度。
2.灵活性高:FPGA 可以根据需求调整乘法器的规模和数量,满足不同应用场景的需求。
3.资源可重配置:FPGA 中的乘法器可以与其他逻辑功能共享资源,提高资源利用率。