
统计基础知识与统计实务公式汇总
1、组中值=(上限+下限)÷2
2、首组开口的下限=首组上限-邻组组距
末组开口的上限=末组下限+邻组组距
3、首组开口组的组中值=首组上限-2
邻组组距 末组开口组的组中值=末组下限+
2邻组组距 4、=计划完成程度相对指标%100⨯计划数
实际完成数 5、=计划执行进度相对指标
%100⨯计划期全期计划数累计完成数计划期内某段时间实际 6、=结构相对指标%100⨯总体总量
总体部分总量 7、=比例相对指标%100⨯总体中另一部分数值
总体中某一部分数值 8、=度)动态相对指标(发展速
%100⨯基期同一指标数值报告期某指标数值 9、=比较相对指标%100⨯值
另一条件下同类指标数某条件的某类指标数值 10、=强度相对指标的总体总量指标
另一有联系而性质不同某一总体总量指标 11、简单算术平均数 X =
n x ∑ 12、加权算术平均数=各组次数各组次数各组变量值∑⨯∑)( X =f
xy ∑∑ 注:加权算术平均数是在总体经过分组行成变量数列(包括单项数列和组距数列),有变量值和次数的情况下,将各组变量值分别与其次数相乘后加总求得标志总量,再除以总体单位数(即次数总和)而求得的数值。
13、简单调和平均数 H=x
n 1∑ 适用于未分组资料或各组标志总量均相等的情况
14、加权调和平均数 H=x
m m ∑∑ 适用于资料已分组,且各组变量值出现的次数不相等的情况
15、平均差(A ·D )=n x x -∑ 由未分组的变量资料直接计算,采用简单算术平均法
16、平均差(A ·D )=f f x x ∑-∑ 由已分组的变量数列计算,采用加权算术平均法
17、标准差 n
x x 2
)(-∑=σ 未分组资料 18、标准差 f
f x x ∑-∑=2)(σ 已分组 19、标准差系数%100⨯=x V σσ
20、根据时期数列计算序时平均数 n a a ∑=
21、根据连续时点数列计算序时平均数
①、未分组资料的连续时点数列 可采用简单算术平均法
②、分组资料的连续时点数列 f
af a ∑∑= 22、根据间断时点数列计算序时平均数 ①、间隔相等的间断时点数列2
最末水平最初水平+=a 1
22
121-+++=-n a a a a a n
n ②、间隔不等的间断时点数列1
2111232
121222---+++⎪⎭⎫ ⎝⎛+++⎪⎭⎫ ⎝⎛++⎪⎭⎫ ⎝⎛+=n n n n f f f f a a f a a f a a a 23、平均增长量=1
-=时间数列项数累计增长量逐期增长量个数逐期增长量之和
24、定基发展速度:0
a a i 环比发展速度:1-i i a a 25、定基发展速度与环比发展速度之间的关系:定基发展速度了等于相应各个环比发展速度的连乘积
12112010---⨯⨯⨯⨯=n n
n n n a a a a a a a a a a
26、=年距发展速度去年同期发展水平
本期发展水平 年距增长速度=年距发展速度-1 27、=增长速度基期水平
增长量=基期水平基期水平报告期水平-=1-基期水平报告期水平=发展速度-1 28、定基增长速度=定基发展速度-1 环比增长速度=环比发展速度-1
29、平均发展速度 n n a a x 0
= 平均增长速度=平均发展速度-1 30、销售量综合指数=单价)(基期商品销售量单价报告期商品销售量⨯∑⨯∑)( 0
001p q p q K q ∑∑= q 销售量p 价格 31、商品价格综合指数=
报告期销售量)(基期单价报告期销售量报告期单价⨯∑⨯∑)( 1011q p q p K q ∑∑= 32、全员劳动生产率指数=工人劳动生产率指数×工人占全员比重指数
工业产值指数=产量指数×产品价格指数
生产支出总额指数=成本指数×产品产量指数
商品销售额指数=商品价格指数×商品销售量指数 0
11100010011p q p q p q p q q p q p ∑∑⨯∑∑=∑∑ 33、样本平均数的抽样平均误差:
①、重复抽样计算公式:n n x σ
σμ==2
②、不重复抽样计算公式:⎪⎭⎫ ⎝⎛-=⎪⎭⎫ ⎝⎛--=
N n n N n N n 1122σσμ 34、样本成数的抽样平均误差:
①、重复抽样:()n
p p p -=1μ
②、不重复抽样:()⎪⎭
⎫ ⎝⎛--=N n n p p p 11μ 35、极限误差范围同概率度计抽样平均误差之间的关系:μt =∆
36、样本平均数的极限误差的计算: 重复抽样:n t t x x σμ⋅==∆
37、生产法增加值=总产出-中间投入
38、单价)(服务单价(含税))(货物总产出⨯∑+⨯∑=
39、单价)(投入法人服务单价(含税))(投入的货物中间投入⨯∑+⨯∑=
40、收入法增加值=固定资产折旧+劳动报酬+生产税净额+营业盈余
41、增加值率=(增加值÷总产出)×100%
42、工业产品销售率=(现价工业销售产值÷现价工业总产出)×100%
43、资产=负债+所有者权益
44、主营业务利润=主营业务收入-主营业务成本-主营业务税金及附加
45、其他业务利润=其他业务收入-其他业务支出
46、营业利润=主营业利润+其他业务利润-营业费用-管理费用-财务费用
47、利润总额=营业利润+投资收益+补贴收入+营业外收入-营业外支出
48、月平均人数=报告月每天实有人数之和÷报告月日历日数
49、上期期末人数+本期增加人数-本期减少人数=本期期末人数
50、%100⨯+=城镇失业人员
城镇就业人员城镇失业人员城镇失业率 51、报告期平均人数
报告期工资总额平均工资= 52、格指数报告期城市居民消费价报告期平均工资平均实际工资= 53、格指数报告期城市居民消费价报告期平均工资指数平均实际工资指数= 54、基期平均工资报告期平均工资平均实际工资指数=。
(完整版)统计学公式大全

(完整版)统计学公式大全统计学公式大全本文档旨在提供统计学领域常用的公式大全,便于大家在研究和实践中进行参考和应用。
描述统计学公式中心趋势度量1. 平均数(Mean):$\bar{x} =\frac{{\sum_{i=1}^{n}x_i}}{n}$2. 中位数(Median):若数据个数为奇数,中位数为排序后的中间值;若数据个数为偶数,中位数为排序后的中间两个值的平均值。
3. 众数(Mode):出现频率最高的数值。
离散趋势度量1. 方差(Variance):$Var(x) = \frac{{\sum_{i=1}^{n}(x_i - \bar{x})^2}}{n}$2. 标准差(Standard Deviation):$SD(x) = \sqrt{Var(x)}$3. 极差(Range):$Range(x) = \max(x) - \min(x)$分布形状度量1. 偏度(Skewness):$\text{Skewness} =\frac{{\sum_{i=1}^{n}(x_i - \bar{x})^3}}{n \cdot SD(x)^3}$2. 峰度(Kurtosis):$\text{Kurtosis} =\frac{{\sum_{i=1}^{n}(x_i - \bar{x})^4}}{n \cdot SD(x)^4}$ 推断统计学公式参数估计1. 样本均值的抽样分布标准差(Standard Error of the Mean):$SE(\bar{x}) = \frac{{SD(x)}}{\sqrt{n}}$2. 双侧置信区间公式(Confidence Interval):$\bar{x} \pm Z\cdot SE(\bar{x})$3. 样本比例的抽样分布标准差(Standard Error of Proportion):$SE(p) = \sqrt{\frac{{p(1-p)}}{n}}$4. 双侧置信区间公式(Confidence Interval):$p \pm Z \cdotSE(p)$假设检验1. 样本均值和总体均值的差异(t检验):$t = \frac{{\bar{x} -\mu}}{{SE(\bar{x})}}$2. 双侧拒绝域临界值(t分布):$t_{\text{critical}} = \pmt_{\alpha/2, df}$3. 样本比例和总体比例的差异(z检验):$z = \frac{{\hat{p} - p}}{{SE(p)}}$4. 双侧拒绝域临界值(z分布):$z_{\text{critical}} = \pmz_{\alpha/2}$回归分析公式简单线性回归模型1. 回归方程(Simple Linear Regression):$y = \beta_0 +\beta_1x + \epsilon$2. 线性预测公式(Simple Linear Regression):$\hat{y} =\hat{\beta}_0 + \hat{\beta}_1x$3. 斯皮尔曼秩相关系数(Spearman's Rank Correlation Coefficient):$r_s = 1 - \frac{6\sum d_i^2}{n(n^2 - 1)}$4. 相关系数的显著性检验(t检验):$t = \frac{r}{\sqrt{\frac{1 - r^2}{n-2}}}$结论本文档列举了统计学领域常用的公式,包括描述统计学中的中心趋势度量、离散趋势度量和分布形状度量,推断统计学中的参数估计和假设检验,以及回归分析中的简单线性回归模型等相关公式。
统计学常用公式
统计学常用公式统计学是一门研究数据收集、分析、解释和表达的科学。
在统计学中,有许多常用的公式被广泛应用于数据处理和推断分析。
本文将介绍一些统计学常用公式,并对其进行说明和用途解释。
一、描述统计学公式1. 平均值(Mean)平均值是一组数据的总和除以数据的个数,即:$\bar{X} = \frac{X_1 + X_2 + \cdots + X_n}{n}$其中,$\bar{X}$表示平均值,$X_i$表示第i个数据,n表示数据的个数。
2. 中位数(Median)中位数是将一组数据按照大小排列后,处于中间位置的数值。
当数据个数为奇数时,中位数即为排列后正中间的数;当数据个数为偶数时,中位数为排列后中间两个数的平均值。
3. 众数(Mode)众数是一组数据中出现频率最高的数值。
4. 标准差(Standard Deviation)标准差衡量数据的离散程度,其计算公式为:$SD = \sqrt{\frac{(X_1 -\bar{X})^2 + (X_2 -\bar{X})^2 + \cdots + (X_n -\bar{X})^2}{n-1}}$5. 方差(Variance)方差是标准差的平方,即:$Var = SD^2$6. 百分位数(Percentile)百分位数是指一组数据中某个特定百分比处的数值。
比如,第25百分位数是将一组数据从小到大排列后,处于前25%位置的数值。
二、概率与统计公式1. 随机变量期望(Expectation)随机变量期望是描述随机变量平均值的指标,也称为均值。
对于离散型随机变量X,其期望计算公式为:$E(X) = \sum_{i=1}^{n} X_i \cdot P(X_i)$对于连续型随机变量X,其期望计算公式为:$E(X) = \int_{-\infty}^{\infty} x \cdot f(x)dx$其中,$X_i$表示随机变量X的取值,$P(X_i)$表示对应取值的概率,$f(x)$表示X的概率密度函数。
统计师资格考试必背公式整理
统计师资格考试必背公式整理统计学作为一门应用广泛的学科,已经成为了许多行业中不可或缺的一部分。
而作为统计学的学习者,掌握一些重要的公式是非常重要的。
在统计师资格考试中,这些公式更是必备的工具。
本文将整理一些统计师资格考试中必须掌握的公式,希望对考生有所帮助。
一、描述统计学公式1. 均值公式:均值是统计学中最常用的概念之一,它用来衡量一组数据的集中程度。
均值公式如下:$$\bar{x} = \frac{\sum_{i=1}^{n}x_i}{n}$$其中,$\bar{x}$表示均值,$x_i$表示数据集中的每个观测值,$n$表示观测值的总数。
2. 方差公式:方差用来衡量一组数据的离散程度,它是每个观测值与均值之差的平方的平均值。
方差公式如下:$$Var(X) = \frac{\sum_{i=1}^{n}(x_i - \bar{x})^2}{n}$$其中,$Var(X)$表示方差,$x_i$表示数据集中的每个观测值,$\bar{x}$表示均值,$n$表示观测值的总数。
3. 标准差公式:标准差是方差的平方根,用来衡量一组数据的离散程度。
标准差公式如下:$$SD(X) = \sqrt{Var(X)}$$其中,$SD(X)$表示标准差,$Var(X)$表示方差。
二、概率论公式1. 条件概率公式:条件概率是指在已知某一事件发生的条件下,另一事件发生的概率。
条件概率公式如下:$$P(A|B) = \frac{P(A \cap B)}{P(B)}$$其中,$P(A|B)$表示在事件B发生的条件下,事件A发生的概率,$P(A \capB)$表示事件A和事件B同时发生的概率,$P(B)$表示事件B发生的概率。
2. 期望公式:期望是概率论中的一个重要概念,用来衡量随机变量的平均值。
期望公式如下:$$E(X) = \sum_{i=1}^{n}x_iP(X=x_i)$$其中,$E(X)$表示随机变量X的期望,$x_i$表示随机变量X的每个可能取值,$P(X=x_i)$表示随机变量X取值为$x_i$的概率。
统计学公式汇总

统计学公式汇总统计学是研究数据收集、分析、解释和预测的一门学科。
在统计学中,有许多重要的公式被广泛应用于数据的处理和分析过程中。
本文将汇总一些常见的统计学公式,并简要介绍其应用场景和使用方法。
1. 均值(Mean)均值是统计学中最常用的概念之一,用于衡量一组数据的集中趋势。
对于一个样本集合,均值可以通过将所有观测值相加,然后除以样本容量来计算。
其数学公式如下:均值= ∑(观测值) / 样本容量2. 方差(Variance)方差是用于衡量一组数据的离散程度的指标。
方差越大,表示数据的离散程度越高;方差越小,表示数据的离散程度越低。
方差的计算公式如下:方差= ∑((观测值-均值)^2) / 样本容量3. 标准差(Standard Deviation)标准差是方差的平方根,用于衡量数据的离散程度,并且具有和原始数据相同的单位。
标准差的计算公式如下:标准差 = 方差的平方根4. 相关系数(Correlation Coefficient)相关系数用于衡量两组变量之间的线性关系强度和方向。
相关系数的取值范围在-1到1之间,其中-1表示完全的负相关,1表示完全的正相关,0表示无相关。
相关系数的计算公式如下:r = Cov(X,Y) / (σX * σY)5. 回归方程(Regression Equation)回归方程用于建立一个或多个自变量与因变量之间的线性关系。
回归方程的一般形式为:Y = β0 + β1X1 + β2X2 + ... + βnXn + ε其中,Y表示因变量,X1、X2、...、Xn表示自变量,β0、β1、β2、...、βn表示回归系数,ε表示模型的误差项。
6. 样本容量和置信水平(Sample Size and Confidence Level)在统计学中,样本容量和置信水平是决定实验或调查结果可靠性的重要因素。
样本容量是指从总体中抽取的样本大小,而置信水平是指对总体参数的估计值的信任程度。
统计基础理论相关知识公式
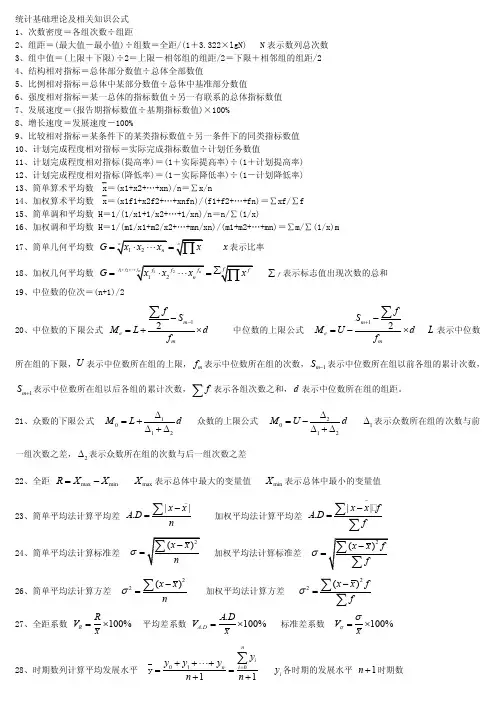
统计基础理论及相关知识公式1、次数密度=各组次数÷组距2、组距=(最大值-最小值)÷组数=全距/(1+3.322×lgN) N 表示数列总次数3、组中值=(上限+下限)÷2=上限-相邻组的组距/2=下限+相邻组的组距/24、结构相对指标=总体部分数值÷总体全部数值5、比例相对指标=总体中某部分数值÷总体中基准部分数值6、强度相对指标=某一总体的指标数值÷另一有联系的总体指标数值7、发展速度=(报告期指标数值÷基期指标数值)×100%8、增长速度=发展速度-100%9、比较相对指标=某条件下的某类指标数值÷另一条件下的同类指标数值 10、计划完成程度相对指标=实际完成指标数值÷计划任务数值11、计划完成程度相对指标(提高率)=(1+实际提高率)÷(1+计划提高率) 12、计划完成程度相对指标(降低率)=(1-实际降低率)÷(1-计划降低率) 13、简单算术平均数 ⎺x =(x1+x2+…+xn)/n =∑x/n14、加权算术平均数 ⎺x =(x1f1+x2f2+…+xnfn)/(f1+f2+…+fn)=∑xf/∑f 15、简单调和平均数 H =1/(1/x1+1/x2+…+1/xn)/n =n/∑(1/x)16、加权调和平均数 H =1/(m1/x1+m2/x2+…+mn/xn)/(m1+m2+…+mn)=∑m/∑(1/x)m 17、简单几何平均数G ==x 表示比率18、加权几何平均数12f f G +==f ∑表示标志值出现次数的总和19、中位数的位次=(n+1)/220、中位数的下限公式 12m e mfS M L d f --=+⨯∑ 中位数的上限公式 12m e mfS M U d f +-=-⨯∑L 表示中位数所在组的下限,U 表示中位数所在组的上限,m f 表示中位数所在组的次数,1m S -表示中位数所在组以前各组的累计次数,1m S +表示中位数所在组以后各组的累计次数,f ∑表示各组次数之和,d 表示中位数所在组的组距。
统计基础知识与统计实务公式汇总[1]

统计基础知识与统计实务公式汇总[1]1组中值=(上限+下限)十22、首组开口的下限=首组上限—邻组组距末组开口的上限=末组下限+邻组组距令邻组组距3、首组开口组的组中值=首组上限—2注:加权算术平均数是在总体经过分组行成变量数列(包括单项数列和组距数列),有变量值和次数的情况下,将各组变量值分别与其次数相乘后加总求得标志总量,再除以总体单位数(即次数总和)而求得的数值。
13、简单调和平均数H=n'、1适用于未分组资料或各组标志总量均相等的情况末组开口组的组中值=末组下限+邻组组距4、计划完成程度相对指标实际完成数计划数100%5、计划执行进度相对指标计划期内某段时间实际累计完成数计划期全期计划数100%6、结构相对指标总体部分总量总体总量100%7、比例相对指标总体中某一部分数值总体中另一部分数值8、动态相对指标(发展速报告期某指标数值基期同一指标数值100%9、比较相对指标某条件的某类指标数值另一条件下同类指标数值100%10、强度相对指标 __________ 某一总体总量指标另一有联系而性质不同的总体总量指标11、简单算术平均数12、加权算术平均数、(各组变量值各组次数)送各组次数X= '「Xx14、加权调和平均数H=适用于资料已分组,且各组变量值出现的次数不相等的情况19、标准差系数V ?"二100%X—y a20、根据时期数列计算序时平均数 a -n21、根据连续时点数列计算序时平均数①、未分组资料的连续时点数列可采用简单算术平均法af②、分组资料的连续时点数列a瓦f22、根据间断时点数列计算序时平均数最初水平亠最末水平①、间隔相等的间断时点数列a二最初平一2:a? ?…an 4:a= —2n -1②、间隔不等的间断时点数列23、平均增长量逐期增长量之和逐期增长量个数纠a2 f1 a2 ^3 f2 a n 4 a n2累计增长量时间数列项数-115 平均差(A?D)由未分组的变量资料直接计算,采用简单算术平均法16 平均差(A?D)、、f由已分组的变量数列计算,采用加权算术平均法17 标准差二(X —X)2未分组资料18 标准差已分组增长量=报告期水平-基期水平=报告期水平基期水平基期水平基期水平28、定基增长速度=定基发展速度-1 环比增长速度=环比发展速度-1平均增长速度=平均发展速度-1'报告期商品销售量单价) '(基期商品销售量单价)心班q 销售量p 价格 -q o P o32、全员劳动生产率指数=工人劳动生产率指数X 工人占全员比重指数工业产值指数=产量指数X产品价格指数生产支出总额指数=成本指数X 产品产量指数商品销售额指数=商品价格指数X 商品销售量指数' p?、q 1p 。
统计学常用公式
统计学常用公式统计学是一门研究数据收集、整理、分析和解释的学科。
在统计学中,公式是非常重要的工具,用于计算和推导各种统计指标和结果。
下面是一些统计学中常用的公式,它们可以帮助我们理解和应用统计学的基本概念和方法。
1. 数据的中心趋势度量在统计分析中,我们经常需要了解数据的中心趋势,即数据的集中程度或平均水平。
以下是几个常用的中心趋势度量公式:- 平均值(Mean):一组数据中所有观测值的总和除以观测值的个数。
- 中位数(Median):将一组数据按照大小排序,位于中间位置的观测值。
- 众数(Mode):出现次数最多的观测值。
- 加权平均值(Weighted Mean):将每个观测值乘以相应的权重,然后求和并除以总的权重和。
2. 数据的离散程度度量除了了解数据集中在哪里,我们还需要了解数据的离散程度,即数据分散的程度。
以下是几个常用的离散程度度量公式:- 方差(Variance):一组数据与其平均值之差的平方的平均值。
- 标准差(Standard Deviation):方差的算术平方根。
- 平均绝对偏差(Mean Absolute Deviation):一组数据与其平均值之差的绝对值的平均值。
3. 数据的相关性度量在统计分析中,我们常常需要了解两个或多个变量之间的相关性。
以下是几个常用的相关性度量公式:- 协方差(Covariance):一组数据中两个变量之间的协方差。
协方差的正负表示两个变量是正相关还是负相关。
- 相关系数(Correlation Coefficient):协方差除以两个变量各自的标准差的乘积。
相关系数的取值范围为-1到1,越接近-1或1表示相关性越强。
4. 抽样误差估计在统计学中,我们通常只能对样本数据进行分析,从而推断总体的特征。
以下是几个常用的抽样误差估计公式:- 样本标准差(Sample Standard Deviation):类似于总体标准差,但在计算时使用样本数据。
- 样本均值(Sample Mean):类似于总体均值,但在计算时使用样本数据。
统计学公式汇总
统计学公式汇总(1) αβδμσνπρυt u F X s 2χ(2) 均数(mean ):nX nX X X X n∑=+⋅⋅⋅++=21式中X 表示样本均数,X 1,X 2,Xn为各观察值。
(3) 几何均数(geometric mean, G ):)lg (lg )lg lg lg (lg 121121nX n X X X X X X G n nn ∑--=+⋅⋅⋅++=⋅⋅⋅∙=式中G 表示几何均数,X 1,X 2,X n 为各观察值。
(4) 中位数(median, M )n 为奇数时,)21(+=n X Mn 为偶数时,2/][)12()2(++=n n XX M式中n 为观察值的总个数。
(5) 百分位数 )%(L xx f x n f iL P ∑-⋅+= 式中L为Px 所在组段的下限,f x 为其频数,i 为其组距,L f ∑为小于L各组段的累计频数。
(6) 四分位数(quartile, Q ) 第25百分位数P 25,表示全部观察值中有25%(四分之一)的观察值比它小,为下四分位数,记作Q L;第75百分位数P 75,表示全部观察值中有25%(四分之一)的观察值比它大,为上四分位数,记作Q U。
(7) 四分位数间距 等于上、下四分位数之差。
(8) 总体方差 NX 22)(μσ-∑=(9) 总体标准差 NX 2)(μσ-∑=(10)样本标准差 1/)(1)(222-∑-∑=--∑=n nX X n X X s (11)变异系数(coefficient of variation, CV ) %100⨯=X sCV (12)样本均数的标准误 理论值nX σσ=估计值ns s X =式中σ为总体标准差,s为样本标准差,n 为样本含量。
(13)样本率的标准误 理论值np )1(ππσ-=估计值np p s p )1(-=式中π为总体率,p 为样本率,n 为样本含量。
(14)总体率的估计:正态分布法,(n p p u p n p p u p /)1(,/)1(-⋅+-⋅-αα) 式中p为样本均数,s 为样本标准差,n 为样本含量。
(完整word版)统计学常用公式
公式一1. 众数【MODE 】(1) 未分组数据或单变量值分组数据众数的计算未分组数据或单变量值分组数据的众数就是出现次数最多的变量值。
(2) 组距分组数据众数的计算对于组距分组数据,先找出出现次数最多的变量值所在组,即为众数所在组,再根据下面的公式计算计算众数的近似值。
下限公式: 1012M =L++i ∆⨯∆∆ 式中:0M 表示众数;L 表示众数的下线;1∆表示众数组次数与上一组次数之差;2∆表示众数组次数与下一组次数之差;i 表示众数组的组距。
上限公式:2012M =U-+i ∆⨯∆∆ 式中:U 表示众数组的上限。
2.中位数【MEDIAN 】(1)未分组数据中中位数的计算根据未分组数据计算中位数时,要先对数据进行排序,然后确定中位数的位置。
设一组数据按从小到大排序后为12N X X X ,,…,,中位数e M ,为则有:e N+M =X1()2当N 为奇数e N N +1221M =X +X 2⎛⎫⎛⎫⎪ ⎪⎝⎭⎝⎭⎧⎫⎪⎪⎨⎬⎪⎪⎩⎭ 当N 为偶数(2)分组数据中位数的计算分组数据中位数的计算时,要先根据公式N / 2 确定中位数的位置,并确定中位数所在的组,然后采用下面的公式计算中位数的近似值:N=1m-1e m-S 2M =L+ii fd f ⨯∑式中:e M 表示中位数;L 表示中位数所在组的下限;m-1S 表示中位数所在组以下各组的累计次数;m f 表示中位数所在组的次数;d 表示中位数所在组的组距。
3.均值的计算【A VERAGE 】(1)未经分组均值的计算未经分组数据均值的计算公式为: 112n ++==nii x x x x x n n=∑…(2)分组数据均值计算分组数据均值的计算公式为: 11221121+++==+ki ik k i k kii x f x f x f x f x f f f f==+∑∑+4.几何平均数【GEOMEAN 】几何平均数是N 个变量值乘积的N 次方根,计算公式为:式中:G 表示几何平均数;∏表示连乘符号。
统计学公式大全
连续型
对于二维随机向量 ,如果存在非负函数 ,使对任意一个其邻边分别平行于坐标轴的矩形区域D,即D={(X,Y)|a<x<b,c<y<d}有
则称 为连续型随机向量;并称f(x,y)为 =(X,Y)的分布密度或称为X和Y的联合分布密度。
分布密度f(x,y)具有下面两个性质:
(1)f(x,y)≥0;
条件概率是概率的一种,所有概率的性质都适合于条件概率。
例如P(Ω/B)=1 P( /A)=1-P(B/A)
(13)乘法公式
乘法公式:
更一般地,对事件A1,A2,…An,若P(A1A2…An-1)>0,则有
… …… … 。
(14)独立性
①两个事件的独立性
设事件 、 满足 ,则称事件 、 是相互独立的。
当x2>x1时,有F(x2,y)≥F(x1,y);当y2>y1时,有F(x,y2)≥F(x,y1);
(3)F(x,y)分别对x和y是右连续的,即
(4)
(5)对于
.
(4)离散型与连续型的关系
(5)边缘分布
离散型
X的边缘分布为
;
Y的边缘分布为
。
连续型
X的边缘分布密度为
Y的边缘分布密度为
(6)条件分布
离散型
若事件 、 相互独立,且 ,则有
若事件 、 相互独立,则可得到 与 、 与 、 与 也都相互独立。
必然事件 和不可能事件Ø与任何事件都相互独立。
Ø与任何事件都互斥。
②多个事件的独立性
设ABC是三个事件,如果满足两两独立的条件,
P(AB)=P(A)P(B);P(BC)=P(B)P(C);P(CA)=P(C)P(A)