
ORACLE_SQL优化案例分析
ORACLE SQL优化案例分析SQL调优的本质就是调整执行计划,形成自己理想的执行计划a)捕获SQL语句,找出花费时间的SQL优化b) 产生SQL语句的执行计划,去掉不必要的全表扫描(在一个有序的表中,如果查询返回少于40%的行,或者在一个无序的表中,返回少于7%的行,那么这个查询都可以调整为使用一个索引来代替全表搜索)c) 验证统计信息(SQL语句涉及到的表格是否做过分析)d)数据分布特点,结果集的记录数e)通过尝试不同的Hint使用正确的索引,从而获得合适的执行计划。
SQL语句tips1.SELECT子句中避免使用‘* ‘当你想在SELECT子句中列出所有的COLUMN时,使用动态SQL列引用‘*’是一个方便的方法.不幸的是,这是一个非常低效的方法. 实际上,ORACLE在解析的过程中, 会将’*’依次转换成所有的列名, 这个工作是通过查询数据字典完成的, 这意味着将耗费更多的时间.2.用TRUNCATE替代DELETE3.使用表的别名(Alias)当在SQL语句中连接多个表时, 请使用表的别名并把别名前缀于每个Column上.这样一来,就可以减少解析的时间并减少那些由Column歧义引起的语法错误.4.sql语句用大写,因为oracle总是先解析sql语句,把小写的字母转换成大写的再执行索引的等级一般情况索引等级如下:a) 等式比较比范围比较要高。
b) 唯一性索引比非唯一性索引要高。
c) 一般情况下单列索引等级要比复合索引高,但如果where子句中包含所有复合索引的字段,则复合索引等级高。
CASE1下列SQL条件语句中的列都建有恰当的索引,但30万行数据情况下执行速度却非常慢:select * from record where substrb(CardNo,1,4)=’5378′(13秒)select * from record where amount/30< 1000;(11秒)select * from record where to_char(ActionTime,’yyyymmdd’)=’19991201′(10秒)WHY???CASE2例2:表tab1中的列col1是字符型(char) select col1,col2 from tab1 where col1>10;有何问题??=>CASE3例3:以下查询表record 中时间ActionTime小于2001年3月1日的数据:select * from record where ActionTime< to_date(’20010301′ ,’yyyymm’)查询计划表明,上面的查询对表进行全表扫描.问题在哪?CASE4例4:select count(*) from stuff where id_no in(’0′,’1′)(23秒)CASE5表ServiceInfo中数据量很大,假设有一百万行,其中有一个字段Flag,取值范围为枚举值:[0,1,2]。
占总数据量的百分比1% 98% 1%比如:select * from serviceinfo where Flag=2 ;上面的语句,实际执行中ORACLE用了全表扫描WHY???CASE6继续上面的例子,由于实际查询中,还有涉及到Flag=1的查询select * from serviceinfo where Flag = 1;而此时如果用上该字段上的索引,将是非常不明智的,效率也极低。
CASE7因为like参数使用的非常频繁,因此如果能够对like子句使用索引,将很高的提高查询的效率。
select * from city where name like ‘%S%’以上查询的执行计划用了全表扫描(TABLE ACCESS FULL)CASE8我们常常必须基于多组数据表计算不同的聚集。
例如下例通过三个独立查询:例8:1)select count(*) from emp where sal<1000;2)select count(*) from emp where sal between 1000 and 5000;3)select count(*) from emp where sal>5000;这样我们需要进行三次全表查询,CASE9update p_container_decl cdset cd.ANNUL_FLAG='0001',ANNUL_DATE = sysdate where exists(select 1from (select tc.decl_no,tc.goods_nofrom p_transfer_cont tc,P_AFFIRM_DO adwhere tc.GOODS_DECL_NO= ad.DECL_NOand ad.DECL_NO= 'sssssssssssssssss') awhere a.decl_no= cd.decl_noand a.goods_no= cd.goods_no)CASE 10select * from ht a where not exists ( select id from bills where ht = a.ht and bill_type=1)因为ht表的数据量非常大。
运行执行计划时发现对ht表的开销非常大。
同时还发现ht表的索引失效了。
Case11在ht表上的ht,code,status三列上创建复合索引n1create index n1 on ht(code,status,ht) ;select * from ht ,qt where ht.ht= qt.ht 发现这个查询很慢。
查看执行计划时发现,n1这个索引并没有被使用。
为什么n1这个索引没有被使用呢?CASE12SELECT * FROM TRANSwhere business_unit = :5and ledger = :6and fiscal_year = :7and accounting_period between 1 and 12and affiliate = :9and statistics_code = :10and project_id = :11and account = :12and currency_cd = :13and deptid = :14and product = :15 ;有一个包含了以上WHERE子句中涉及到的所有列的索引,一般来说我们都希望Oracle选择这个索引,然而,CBO却决定使用一个包含(BUSINESS_UNIT, LEDGER,FISCAL_YEAR, ACCOUNT)的索引CASE13select sce.*from SIN_CUSTOMER_ETL scewhere exists (select 1from ((select cont.CUSTOMER_NUMfrom sin_cont contwhere not exists(select 1from sin_cust custwhere cust.CUSTOMER_NUM = cont.CUSTOMER_NUM)) union (select sgi.guarant_customer_num CUSTOMER_NUMfrom SIN_GUARANT_INFO sgiwhere not exists(select 1from sin_cust custwhere cust.customer_num =sgi.guarant_customer_num))) u_datawhere u_data.CUSTOMER_NUM = sce.CUSTOMER_NUM)CASE13New:select sce.*from SIN_CUSTOMER_ETL scewhere CUSTOMER_NUM IN (select cont.CUSTOMER_NUM from sin_cont contwhere not exists(select 1from sin_cust custwhere cust.CUSTOMER_NUM = cont.CUSTOMER_NUM) union all select sgi.guarant_customer_num CUSTOMER_NUMfrom SIN_GUARANT_INFO sgiwhere not exists(select 1from sin_cust custwhere cust.customer_num =sgi.guarant_customer_num) )Note:如果个子查询结果从业务逻辑上不需排除重复的话union改为union allCASE14 old:CASE14New:select sce.*from SIN_CUSTOMER_ETL scewhere CUSTOMER_NUM IN (select cont.CUSTOMER_NUM from sin_cont contwhere not exists(select 1from sin_cust custwhere cust.CUSTOMER_NUM = cont.CUSTOMER_NUM) union all select sgi.guarant_customer_num CUSTOMER_NUMfrom SIN_GUARANT_INFO sgiwhere not exists(select 1from sin_cust custwhere cust.customer_num =sgi.guarant_customer_num) )Note:如果个子查询结果从业务逻辑上不需排除重复的话union改为union all建索引的考虑1)表的主键、外键必须有索引;2)数据量超过2000的表应该有索引;3)经常与其他表进行连接的表,在连接字段上应该建立索引;4)经常出现在Where子句中的字段,特别是大表的字段,应该建立索引;5)索引应该建在选择性高的字段上;6)索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引;7)频繁进行数据操作的表,不要建立太多的索引;8 )复合索引的建立需要进行仔细分析;尽量考虑用单字段索引代替:复合索引的几个字段是否经常同时以AND方式出现在Where子句中?单字段查询是否极少甚至没有?如果是,则可以建立复合索引;否则考虑单字段索引;正确选择复合索引中的主列字段,一般是选择性较好的字段统计信息SELECT table_name, num_rows, last_analyzed FROM user_tables;select TABLE_OWNER,TABLE_NAME, STATUS,LAST_ANALYZED,NUM_ROWS from user_indexes分析:ANALYZE TABLE OWNER.TABLE;exec dbms_stats.gather_table_stats(‘OWNER',‘TABLE',estimate_percent=>30,cascade=> TRUE);THANK YOU。
Oracle SQL语句优化技术分析
O a e S L 句的性 能问题 常常是 由于 rl Q 语 c 在索引设计和查询设计方面存在各种缺陷引起 的。 Q 优化的实质就是在结果正确的前提下 , SL 充份利用索引 , 减少表扫描的 I / O次数 , 尽量避 免表搜索的发生 。 其实 S L Q 的性能优 化是一个 复杂的过程 ,以上这些只是在应用层次 的一种 体现 , 深入研究还会涉及数据库层 的资源配置 、 网络层的流量控制 以及操作系统层 的总体设计 如 等等方面 , 已经超 出本文所要讨论 的范 围, 这些 S EC EL T FROM US ER LOG WHER 因此不在本文赘述 了。 E 总之 Oal S L语句 的 r e Q c USE N R AME ei ( L C U E _ A 不断总结 , 才 xs t S E T S R N ME 优化需要我们在生产 中不断学习 , E FROM T F W HE TY C D =05 ' S AF E R CI 能更为得心应手 的应用到工作中去。 O E ' 1 4 3 O N操作符 . N TI 2 此操作是 强列不推荐使用 的 , 因为它不能
的 ,因为索引是不索引空值的。使用 I N L SU 或 I O U ,r l会停止使用 索引而执 SN TN L Oa e c 行 全表扫描。 以考虑在设计表时 , 引列设 可 对索 置为 N T N L 。这样就可以用其他操作来取 O U L 代 判断 N L 的操作。 UL
_
b .同一功能 同一性能 不同写法 S QL的影 响。 如一个 S L在 A程序员写的为 slc S Q eetU— e a ,s d f m s fB程序员写 的为 s—  ̄nme e r t u o a e le s r n meu e i f m zj s ( e t u e a . s r d r h .a 带表所有 o st f 者的前缀 )c程序员写的为 Sl tu rn n, e c s_s e e e z u ser i f m Z J . A F ( 写表名 )D程序 d r HS T F 大 o S 员 写 的 为 Slc srnme sri f m e et e_a , e_d r u u o z SS A F 中间多 了空格 )以上 四个 S L在 Ⅲ . F( T Q OAL R C E分析整理之后产生的结果及执行的时
oracle sql 优化技巧
oracle sql 优化技巧(实用版3篇)目录(篇1)1.Oracle SQL 简介2.优化技巧2.1 减少访问数据库次数2.2 选择最有效率的表名顺序2.3 避免使用 SELECT2.4 利用 DECODE 函数2.5 设置 ARRAYSIZE 参数2.6 使用 TRUNCATE 替代 DELETE2.7 多使用 COMMIT 命令2.8 合理使用索引正文(篇1)Oracle SQL 是一款广泛应用于各类大、中、小微机环境的高效、可靠的关系数据库管理系统。
为了提高 Oracle SQL 的性能,本文将为您介绍一些优化技巧。
首先,减少访问数据库的次数是最基本的优化方法。
Oracle 在内部执行了许多工作,如解析 SQL 语句、估算索引的利用率、读数据块等,这些都会大量耗费 Oracle 数据库的运行。
因此,尽量减少访问数据库的次数,可以有效提高系统性能。
其次,选择最有效率的表名顺序也可以明显提升 Oracle 的性能。
Oracle 解析器是按照从右到左的顺序处理 FROM 子句中的表名,因此,合理安排表名顺序,可以减少解析时间,提高查询效率。
在执行 SELECT 子句时,应尽量避免使用,因为 Oracle 在解析的过程中,会将依次转换成列名,这是通过查询数据字典完成的,耗费时间较长。
DECODE 函数也是一个很好的优化工具,它可以避免重复扫描相同记录,或者重复连接相同的表,提高查询效率。
在 SQLPlus 和 SQLForms 以及 ProC 中,可以重新设置 ARRAYSIZE 参数。
该参数可以明显增加每次数据库访问时的检索数据量,从而提高系统性能。
建议将该参数设置为 200。
当需要删除数据时,尽量使用 TRUNCATE 语句替代 DELETE 语句。
执行 TRUNCATE 命令时,回滚段不会存放任何可被恢复的信息,所有数据不能被恢复。
因此,TRUNCATE 命令执行时间短,且资源消耗少。
在使用 Oracle 时,尽量多使用 COMMIT 命令。
Oracle培训之:sql优化--

13
在SQLPLUS 配置AUTOTRACE
AUTOTRACE 参数
SET AUTOTRACE OFF SET AUTOTRACE ON EXPLAIN SET AUTOTRACE ON STATISTICS SET AUTOTRACE ON SET AUTOTRACE TRACEONLY
解
释
不能获得AUTOTRACE报告. 这是默认的. 仅仅显示优化器执行计划的AUTOTRACE 报告 仅仅显示SQL语句执行的统计结果的 AUTOTRACE报告 包括上面两项内容的AUTOTRACE报告 与SET AUTOTRACE ON类似,所有的统计 和数据都在,但不可以打印
23
第五章:SQL重编译问题
SQL共享原理 SQL共享的三个条件 PROC程序的SQL共享 PROC程序中以下类型的语句不需进行变量 绑定 • PROC程序的CLIENT参数 • 存储过程的SQL共享 • SQL共享的数据库参数的利弊
24
• • • •
SQL共享原理
• ORACLE将执行过的SQL语句存放在内存 的共享池(shared buffer pool)中,可以被所 有的数据库用户共享 • 当你执行一个SQL语句(有时被称为一个游 标)时,如果它和之前的执行过的语句完全相 同, ORACLE就能很快获得已经被解析的语 句以及最好的 执行路径. 这个功能大大地提 高了SQL的执行性能并节省了内存的使用
查找原因的步骤(四)
• 是否为表和相关的索引搜集足够的统计数 据。对数据经常有增、删、改的表最好定 期对表和索引进行分析,可用SQL语句 “analyze table xxxx compute statistics for all indexes;”。ORACLE掌握了充分反映实 际的统计数据,才有可能做出正确的选择 • 索引列的选择性不高 (字段值重复率高)
ORACLE数据库SQL应用优化论文

ORACLE数据库的SQL应用优化摘要:sql server 2003是一种比较复杂的数据库,主要靠内部的映射关系的一种数据库,这种数据库的服务一般来说是对于复制、集成、分析、通知以及报表等相关服务的融合,此外,visual 等第三方开发工具的有效结合,在sql server 2003数据库中,sql语句的应用优化对于数据库的发展很重要,本文就是从sql应用优化着手,对于数据库的sql语句进行了分析。
关键词:oracle;sql;优化中图分类号:tp311 文献标识码:a 文章编号:1007-9599 (2011) 22-0000-01sql application optimization of oracle databaseyang qiming(tongren polytechnic,tongren 554300,china)abstract:sql server 2003 is a more complex database,mainly by the internal mapping of a database,the database service is generally for replication,integration,analysis, notification and reporting and other related services integration,in addition,visual and so the effective integration of third-party development tools in sql server 2003 database,sql statements in application optimized for the database development is very important,this is the application of optimization started from sql,the sqlstatements for database analysis.keywords:oracle;sql;optimization一、oracle数据库技术概述首先.net framework与sql server 2003有机结合的过程中,sql server利用.net平台特有的公用语言运行时(clr-common language runtime)的特性来生成数据库的相关对象,在数据库管理系统中充分利用.net代码的功能。
优化SQL对ORACLE数据库性能的提高
3科技资讯科技资讯S I N &T NOLOGY I NFO RM TI ON 2008NO .28SC I EN CE &TECH NO LOG Y I N FOR M A TI O N 信息技术大多数情况下,系统运行缓慢不是由于所有部件都饱和引起的,而是由于系统中的某个部分限制了整体的性能,这部分称为瓶颈。
通常影响ORA CL E 数据库性能指标的三个瓶颈主要是:CP U 、内存、I /O 。
数据库性能的优化主要是or a c l e 数据库参数的调整、磁盘I /O 调整、应用程序S QL语句分析及设计、网络性能调整等。
本文主要通过优化S QL 语句来提高ORACL E 数据库的性能。
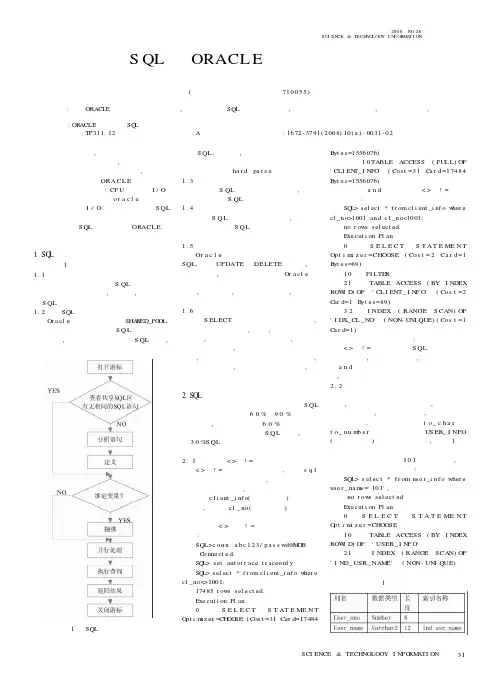
1SQ L 语句处理流程如图1所示。
1.1打开游标从上图可以看出处理S QL 语句的第一步就是要打开一个游标,事实上,一个完整的S QL 处理过程就是一个游标的生命周期。
1.2共享SQLOr a cl e 内存中有一个区叫SHA R ED _PO OL ,这个区的主要作用就是将S Q L 语句存放在这个区内,当客户发出一个新的S QL 语句,数据库引擎首先会到这个区查找是否有相同的S QL ,如果有,则避免了解析、分析索引、制定执行计划等一系列的动作。
如果没有则需要进行ha r d pa r s e 。
1.3绑定变量如果在S QL 中指定了绑定变量,需要在这个阶段给S QL 附上绑定变量的值。
1.4并行处理如果S Q L 需要进行并行处理,在这一阶段需要把整个S Q L 分割成多个并行的部分。
1.5执行查询Or a c l e 按照执行计划指定的方式执行SQL,执行UPDATE 和DE LE TE 语句时,必须将行锁定,以免其他用户修改。
Or a cl e 先从数据库缓冲区中寻找是否存在所要的数据块,如果存在,就直接读或修改,否则从物理文件中读到数据库缓冲区中。
1.6返回结果对S EL ECT 语句需要返回结果的语句,首先看是否需要排序,需要,则排序后返回给用户,然后根据内存的大小不同,可以一次取出一行数据,也可以一次取一组数据。
0racle数据库的优化探讨

0racle数据库的优化探讨摘要:Oracle数据库作为全球第一大数据库厂商,在国内外获得了广泛应用,本文对Oracle数据库性能调整和优化进行了简要分析和研究,对各种优化技术进行了深入的探讨,将SQL语句优化、Oracle内存分配调整作为论文的主要研究内容。
关键词:数据库优化随着数据库规模的扩大,用户数量的增加,数据库应用系统的响应速度下降,性能问题越来越突出。
数据库系统的性能调整与优化对于整个系统的正常运行起着至关重要的作用。
基于此,本文主要研究SQI 语句、Oracle内存分配的性能优化问题,给出了一般情况下Oracle数据库应用系统的性能优化方一法,以期推动Oracle数据库性能优化技术的发展。
1 SQL查询优化数据库系统是管理信息系统的核心,从大多数系统的应用实例来看,查询操作在各种数据库操作中占据的比重最大,查询速度的快慢直接影响数据库的推广和应用,对于大型数据库来说,这一点显得尤其重要。
由于查询操作在SQL语句中代价最大,因此优质的查询语句可以大大提高应用系统的性能。
1.1 查找有问题的SQL语句①利用SQL Trace工具分析SQL语句。
Oracle的SQL Trace工具是确定SQL语句是否被合理优化的最好方法之一。
如果发现当前会话行为异常或性能下降,则可以通过该工具获得有关系统操作性能的信息,如解析、执行和返回数据的次数、CPU时间和执行时间、物理读和逻辑读操作次数、库缓冲区命中率等。
一旦为会话激活了SQL-TRACE Oracl。
就会在udump管理区创建跟踪文件。
由于SQL Trace将这些信息以一种不可读的格式存放在跟踪文件中,因p一个字段的标签同时在主查询和where子句中的查询中出现,那么当主查询中的字段值改变之后,子查询必须重新查询一次。
对于子查询来说,查询嵌套层次越多,效率越低,因此应当尽量避免它。
如果子查询不可避免,那么要在子查询中过滤掉尽可能多的行。
在Oracle中相关子查询的执行效率特别低,引入临时表可以使其速度快100倍左右。
Oracle数据库性能优化与案例分析
Oracle数据库性能优化与案例分析
性能优化探讨
• 原因:为什么? • 慢(响应时间) • 慢(吞吐量)
性能优化探讨
• 目的:为了什么? • 快(响应时间) • 快(吞吐量)
性能优化之案例分析
• 案例之方法论 • 案例之登录访问 • 案例之资源 • 案例之锁
性能优化方法论发展
• 登录输入指标测量 • Logons:= EndSnap. logons cumulative– StartSnap. logons
cumulative。 • Logons Per Second:= Logons / TimeInterval
案例之登录访问
登录输出指标测量:
Logon Response Time:= Network Response Time * 10 + Native TCP Logon :=Network Response Time * 10 + Listener Response Time + Native IPC Logon Time 。
案例之登录访问
• 例:
•
某医院HIS业务系统的账户登录操作异常缓慢,部分情况下
甚至会出现长时间的卡壳情况,业务影响主要发生在每天早上
的上班时刻。
案例之登录访问
优化过程: • 账户登录过程一般涉及到在账户表格以及对应日志表格上的冲
突,比如Buffer busy waits或者TX lock。AWR未体现该特征。 • AWR报告显示connection management call elapsed time时间偏长
成功率:98% 高 失败率:2% 低
失败人数:500*2%=10
Oracle优化器(Optimizer)
Oracle优化器(Optimizer)是Oracle在执行SQL之前分析语句的工具。
Oracle的优化器有两种优化方式:基于规则的优化方式:Rule-Based Optimization(RBO)优化器在分析SQL语句时,所遵循的是Oracle内部预定的一些规则。
比如我们常见的,当一个where子句中的一列有索引时去走索引。
基于成本或者统计信息的优化方式(Cost-Based Optimization:CBO)CBO是在ORACLE7 引入,但到ORACLE8i 中才成熟。
ORACLE 已经声明在ORACLE9i之后的版本中,RBO将不再支持。
它是看语句的代价(Cost),这里的代价主要指Cpu和内存。
CPU Costing的计算方式现在默认为CPU+I/O两者之和.可通过DBMS_XPLAN.DISPLAY_CURSOR观察更为详细的执行计划。
优化器在判断是否用这种方式时,主要参照的是表及索引的统计信息。
统计信息给出表的大小、有少行、每行的长度等信息。
这些统计信息起初在库内是没有的,是做analyze后才出现的,很多的时侯过期统计信息会令优化器做出一个错误的执行计划,因些应及时更新这些信息。
按理,CBO应该自动收集,实际却不然,有时候在CBO情况下,还必须定期对大表进行分析。
Oracle优化器的优化模式:1) CHOOSE仅在9i及之前版本中被支持,10g已经废除。
8i及9i中为默认值。
这个值表示SQL语句既可以使用RBO优化器也可以使用CBO优化器,而决定该SQL到底使用哪个优化器的唯一因素是,所访问的对象是否存在统计信息。
如果所访问的全部对象都存在统计信息,则使用CBO 优化器优化SQL;如果只有部分对象存在统计信息,也仍然使用CBO优化器优化SQL,优化器会为不存在统计信息对象依据一些内在信息(如分配给该对象的数据块)来生成统计信息,只是这样生成的统计信息可能不准确,而导致产生不理想的执行计划;如果全部对象都无统计信息,则使用RBO来优化该SQL 语句。
数据库性能优化方法&案例分析
开发、设计、运行维护各阶段 均可能导致性能问题
案例3:神奇的Oracle内部参数
• 内部参数列表
Parameter Name _b_tree_bitmap_plans _bump_highwater_mark_count _cursor_features_enabled _db_block_hash_buckets _db_block_hash_latches _db_block_numa _enable_NUMA_optimization _enqueue_hash_chain_latches _fix_control _in_memory_undo _index_join_enabled _optim_peek_user_binds _optimizer_mjc_enabled _sort_elimination_cost_ratio _sqlexec_progression_cost _table_lookup_prefetch_size _wait_for_sync Begin value FALSE 30 10 134217728 1048576 1 FALSE 256 5705630:ON, 5765456:3 TRUE FALSE FALSE FALSE 10 0 0 FALSE End value (if different)
的优化效果 80%的性能问题可以由20%的优 化技术所解决
应用开发技术运用策略
比较项目 操作特点 响应速度 吞吐量 并发访问量 联机业务 批处理业务 日常业务操作,尤其是包含 后台操作,例如统计报表、 大量前台操作 大批量数据加载 优先级最高,要求反应速度 要求速度高、吞吐量大 非常高 小 非常高 小 大 不高 大
自底向上
数据库性能管理的全面性
oracleSQL优化培训(精华整理)PPT课件
| 0 | SELECT STATEMENT |
| 1 | 26 | 4 (25)| 00:00:01 |
| 1 | SORT AGGREGATE |
| 1 | 26 |
|
|
| 2 | NESTED LOOPS |
| 1 | 26 | 4 (25)| 00:00:01 |
| 3 | VIEW
| VW_NSO_1 | 199 | 2587 | 2 (0)| 00:00:01 |
理解表的连接
HASH JOIN:1
---------------------------------------------------------
----------
| Id | Operation
开发人员应具备的优化能力
•能写好SQL,不犯低级错误。 •能创建高效索引。 •理解应用对表中数据的读取方式。 •理解索引对性能的重要意义。 •能理解常见的执行计划。 •可进行适当的调优。 •具备优化意识,开发中能兼顾性能。
SQL编写中的低级错误
• 对列进行运算 • 对列使用函数 • 数据类型不一致导致列发生隐式转化 • 使用*查询所有字段,包含了业务不需要的字段 • 进行不必要的排序 • union 可用 union all 替换 • 使用不必要的distinct
使用多少内存?消耗多少CPU? • 若SQL的执行效率不符合预期,有能力对其进行
优化吗?
执行计划
•执行计划:优化器制定的SQL的执行步骤。 •同一个SQL,可以有多个执行计划,要选取最优的那个。 •查询优化的目标:就是让优化器为SQL尽量生成最优的执行计划,使查 询的总开销(IO、CPU、网络传输等)最小。 •set autotrace、explain plan、dbms_xplan等。 •PL/SQL developer 中 使用F5快捷键